

Wat kan een groot bedrijf als Lamoda, met een geoptimaliseerd proces en tientallen onderling verbonden services, inspireren om zijn benadering drastisch te veranderen? De motivatie kan heel divers zijn: van wettelijk vereist tot de inherente wens van programmeurs om te experimenteren.
Maar dat betekent nog lang niet dat men niet kan rekenen op extra voordelen. Wat je specifiek kunt winnen door een events-driven API op Kafka te implementeren, vertelt Sergey Zaika (). Er zullen ook zeker ervaringen en interessante ontdekkingen worden gedeeld – een experiment kan niet zonder.
Disclaimer: Dit artikel is gebaseerd op materiaal van de meetup die Sergey in november 2018 heeft gehouden op HighLoad++. De praktijkervaring van Lamoda met Kafka trok de aandacht van het publiek net zo goed als andere lezingen op het schema. Wij denken dat het een uitstekend voorbeeld is van hoe belangrijk het is om gelijkgestemden te vinden, en de organisatoren van HighLoad++ zullen zich blijven inspannen om een omgeving te creëren die deze samenwerking bevordert.
Over het proces
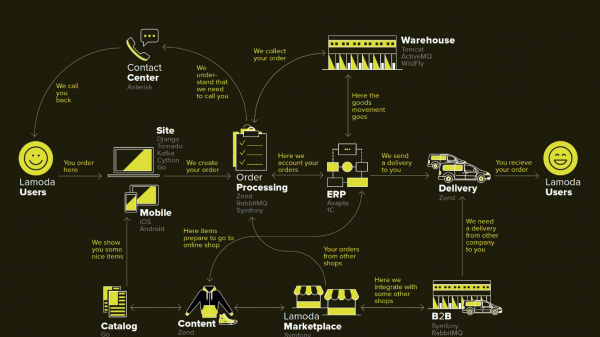
Lamoda is een groot e-commerce platform met een eigen contactcentrum, bezorgdienst (en vele partners), fotostudio, enorme magazijnen, en dit alles draait op hun eigen software. Er zijn tientallen betaalmethoden, B2B-partners die gebruik kunnen maken van een deel of al deze diensten, en die op de hoogte willen blijven van actuele informatie over hun producten. Bovendien opereert Lamoda in drie landen naast Rusland, en daar is alles net iets anders. Samengevat zijn er waarschijnlijk meer dan honderd manieren om een nieuwe bestelling te configureren die op verschillende manieren verwerkt moet worden. Dit alles wordt uitgevoerd door tientallen services die soms op een niet voor de hand liggende manier met elkaar communiceren. Daarnaast is er een centraal systeem dat verantwoordelijk is voor de bestelstatussen. We noemen het BOB, en ik werk ermee.
Refund Tool met een events-driven API
De term events-driven is inmiddels behoorlijk ingeburgerd, maar laten we verderop specifieker definiëren wat we hiermee bedoelen. Ik begin met de context waarin we de events-driven API aanpak op Kafka hebben besloten te testen.
In elke winkel, naast de bestellingen waarvoor klanten betalen, zijn er momenten waarop van de winkel wordt gevraagd om geld terug te geven, omdat het product niet geschikt was voor de klant. Dit is een relatief kort proces: we verifiëren informatie indien nodig en storten het geld terug.
Maar de terugbetaling is gecompliceerd door veranderingen in de wetgeving, en we moesten hiervoor een aparte microservice implementeren.
Onze motivatie:
- Wet FZ-54 — kort gezegd, de wet vereist dat we elke financiële transactie, of het nu een terugbetaling of een ontvangst is, binnen een behoorlijk korte SLA van enkele minuten aan de belastingdienst rapporteren. Wij, als e-commerce, voeren behoorlijk veel transacties uit. Dit betekent technisch gezien een nieuwe verantwoordelijkheid (en daardoor een nieuwe service) en aanpassingen in alle betrokken systemen.
- BOB-splitsing — een intern project van het bedrijf om BOB te ontdoen van een groot aantal niet-kernverantwoordelijkheden en de algehele complexiteit te verlagen.
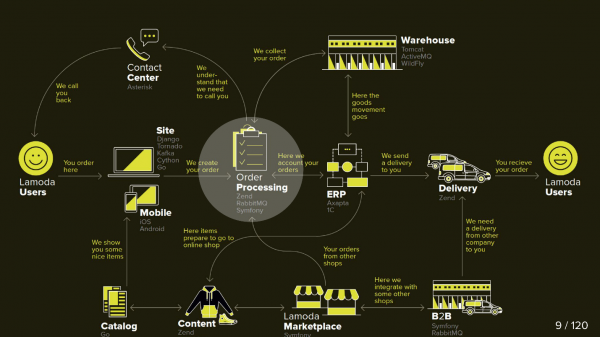
Op dit diagram zijn de belangrijkste systemen van Lamoda weergegeven. Momenteel zijn de meeste van hen eerder een sterrenstelsel van 5-10 microservices rond een krimpende monolith. Ze groeien langzaam, maar we proberen ze kleiner te maken, omdat het eng is om een afzonderlijk fragment in het midden te implementeren - we kunnen niet toestaan dat het uitvalt. Alle uitwisselingen (pijlen) moeten we reserveren en rekening houden met het feit dat een van hen mogelijk niet beschikbaar kan zijn.
In BOB zijn er ook behoorlijk veel uitwisselingen: betalingssysteem, leveringssystemen, notificaties, enz.
Technisch gezien is BOB:
- ~150k regels code + ~100k testregels;
- php7.2 + Zend 1 & Symfony Components 3;
- >100 API's & ~50 uitgaande integraties;
- 4 landen met hun eigen bedrijfslogica.
Het implementeren van BOB is duur en pijnlijk, de hoeveelheid code en de taken die het oplost zijn zodanig dat niemand het in zijn geheel in zijn hoofd kan houden. Kortom, er zijn veel redenen om het te vereenvoudigen.
Het retourproces
Oorspronkelijk zijn er twee systemen betrokken bij het proces: BOB en Payment. Nu komen er nog twee bij:
- Fiscalization Service, die de problemen met fiscalisatie en communicatie met externe diensten op zich neemt.
- Refund Tool, waarin gewoon nieuwe uitwisselingen worden geplaatst om BOB niet te overbelasten.
Nu ziet het proces er zo uit:
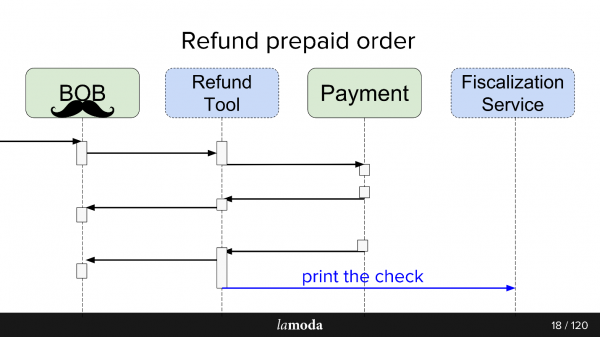
- BOB ontvangt een verzoek om geld terug te geven.
- BOB meldt dit aan Refund Tool.
- Refund Tool zegt tegen Payment: ' geef het geld terug'.
- Payment geeft het geld terug.
- Refund Tool en BOB synchroniseren hun statussen met elkaar, omdat ze dit voorlopig allebei nodig hebben. We zijn nog niet klaar om volledig over te stappen naar Refund Tool, aangezien er in BOB een gebruikersinterface is, rapporten voor de boekhouding en veel gegevens die niet zomaar verplaatst kunnen worden. We moeten dus op twee stoelen zitten.
- Het verzoek voor fiscalisatie wordt verzonden.
Uiteindelijk hebben we een soort gebeurtenisbus gemaakt op Kafka - een event-bus, waarop alles is gebaseerd. Hoera, we hebben nu een enkel punt van falen (sarcasme).
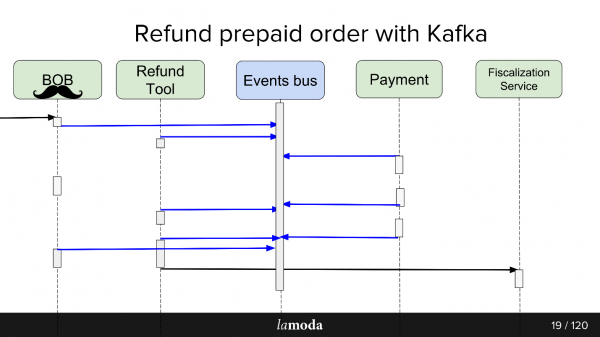
De voordelen en nadelen zijn vrij duidelijk. We hebben een bus gemaakt, wat betekent dat alle diensten nu ervan afhankelijk zijn. Dit vereenvoudigt het ontwerp, maar introduceert een enkel punt van falen in het systeem. Als Kafka uitvalt, staat het proces stil.
Wat is een events-gedreven API
Een goed antwoord op deze vraag is te vinden in de presentatie van Martin Fowler (GOTO 2017) .
Kortom, wat we hebben gedaan:
- We hebben alle asynchrone communicatie gewikkeld in events storage. In plaats van elke geïnteresseerde consument op het netwerk te informeren over een statuswijziging, schrijven we een gebeurtenis over de statuswijziging naar een gecentraliseerde opslag, en geïnteresseerde consumenten lezen alles wat daar verschijnt.
- Een gebeurtenis (event) in dit geval is een melding (notifications) dat er ergens iets is veranderd. Bijvoorbeeld, de status van een bestelling is veranderd. Een consument die geïnteresseerd is in bepaalde gegevens die aan de statuswijziging zijn gekoppeld en die niet in de melding staan, kan zelf de huidige status achterhalen.
- De maximale optie is volledige event sourcing, state transfer, waarbij de gebeurtenis alle informatie bevat die nodig is voor verwerking: van waar en naar welke status het is gegaan, hoe precies de gegevens zijn veranderd, enzovoorts. De vraag is alleen de doelmatigheid en de hoeveelheid informatie die je je kunt veroorloven om op te slaan.
Binnen de lancering van de Refund Tool hebben we de derde optie gebruikt. Dit vereenvoudigde de verwerking van gebeurtenissen, aangezien het niet nodig was om gedetailleerde informatie te extraheren. Bovendien werd het scenario uitgesloten waarbij elke nieuwe gebeurtenis een piek aan aanvullende GET-verzoeken van consumenten genereert.
De Refund Tool service is niet belast, daarom is Kafka daar meer een proefje dan een noodzaak. Ik denk niet dat, als de terugbetalingsservice een highload-project zou worden, het bedrijf daar blij mee zou zijn.
Async exchange AS IS
Voor asynchrone uitwisselingen gebruikt de PHP-afdeling doorgaans RabbitMQ. Gegevens voor een aanvraag zijn verzameld, in de wachtrij geplaatst, en de consument van dezelfde service heeft deze gelezen en verzonden (of niet verzonden). Voor de API zelf gebruikt Lamoda actief Swagger. We ontwerpen de API, beschrijven deze in Swagger, genereren client- en servercode. Ook maken we gebruik van een iets uitgebreide JSON RPC 2.0.
Er zijn plekken waar esb-bussen worden gebruikt, sommige leven op ActiveMQ, maar over het algemeen, RabbitMQ - standaard.
Asynchrone uitwisseling MOET
Bij het ontwerpen van een uitwisseling via een events-bus, is er een analogie zichtbaar. Op vergelijkbare wijze beschrijven we de toekomstige gegevensuitwisseling door de structuur van het evenement te beschrijven. Het YAML-formaat, de codegeneratie moesten we zelf doen, de generator volgens de specificatie creëert DTO's en leert klanten en servers hiermee werken. De generatie gebeurt in twee talen - golang en php. Dit houdt de bibliotheken consistent. De generator is geschreven in golang, waarvoor hij de naam gogi heeft gekregen.
Event-sourcing op Kafka - een typische zaak. Er is een oplossing van de belangrijkste enterprise versie Kafka Confluent, er is ook , een oplossing van onze 'broeders' in het domein Zalando. Onze motivatie om met vanilla Kafka te beginnen is het om de oplossing gratis te houden, totdat we definitief hebben beslist of we het overal gaan gebruiken, en om onszelf ruimte te geven voor manoeuvres en verbeteringen: we willen ondersteuning voor onze JSON RPC 2.0, generators voor twee talen en kijken wat er nog meer is.
Ironisch genoeg, zelfs in zo'n gelukkige situatie, waarin er ongeveer een soortgelijke onderneming is als Zalando, die een vergelijkbare oplossing heeft gecreëerd, kunnen we deze niet effectief gebruiken.
Architectonisch, bij de lancering ziet het patroon er als volgt uit: we lezen rechtstreeks uit Kafka, maar schrijven alleen via de events-bus. Voor het lezen van Kafka is er veel beschikbaar: brokers, load balancers en het is meer of minder klaar voor horizontale schaalvergroting, dat wilden we behouden. Voor het schrijven wilden we het via één Gateway aka Events-bus omwonden, en dit is waarom.
Events-bus
Of evenementenbus. Dit is gewoon een stateless http gateway, die een paar belangrijke rollen op zich neemt:
- Validatie van productie we controleren of de evenementen voldoen aan onze specificatie.
- Het master-systeem voor evenementen, dat wil zeggen dit is het belangrijkste en enige systeem in het bedrijf dat de vraag beantwoordt, welke gebeurtenissen met welke structuren als geldig worden beschouwd. Validatie omvat simpelweg datatype en enums voor een strikte specificatie van de inhoud.
- Hash-functie voor sharding - de structuur van het Kafka-bericht is key-value en op basis van de hash van de key wordt berekend waar dit geplaatst moet worden.
Waarom
We werken in een groot bedrijf met een gestroomlijnd proces. Waarom iets veranderen? Dit is een experiment, en we verwachten enkele voordelen te behalen.
1:n+1 uitwisselingen (één naar velen)
Met Kafka is het erg eenvoudig om nieuwe consumenten aan de API te koppelen.
Stel dat u een handleiding heeft die u actueel wilt houden in meerdere systemen tegelijk (en wellicht ook in enkele nieuwe). Vroeger creëerden we een bundle die een set-API implementeerde, en we vertelden het master-systeem de adressen van de consumenten. Nu stuurt het master-systeem updates naar een topic en iedereen die geïnteresseerd is, kan deze lezen. Er is een nieuw systeem verschenen - we hebben het ingeschreven op het topic. Ja, het is ook een bundle, maar eenvoudiger.
In het geval van de refund-tool, die in wezen een stukje BOB is, is het handig om ze via Kafka gesynchroniseerd te houden. Payment vertelt dat het geld is terugbetaald: BOB en RT hebben hiervan gehoord, hebben hun statussen gewijzigd, de Fiscalization Service is op de hoogte gesteld en heeft een bon uitgegeven.
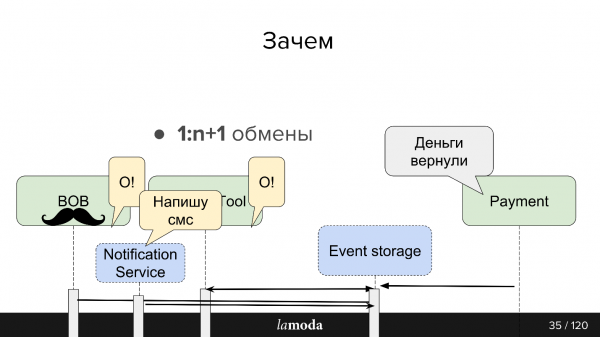
We hebben plannen om een enkele Notifications Service te maken die de klant op de hoogte houdt van nieuws over zijn bestelling/retours. Momenteel is deze verantwoordelijkheid verspreid over verschillende systemen. Het zal voldoende zijn om de Notifications Service te leren relevante informatie uit Kafka te filteren en daarop te reageren (en deze meldingen in de andere systemen uit te schakelen). Er zijn geen nieuwe directe uitwisselingen nodig.
Data-driven
Informatie tussen systemen wordt transparant - ongeacht hoe 'bloederig' uw enterprise is en hoe omvangrijk uw backlog ook moge zijn. Bij Lamoda is er een afdeling Data Analytics die gegevens van systemen verzamelt en deze in herbruikbare vorm brengt, zowel voor de business als voor slimme systemen. Kafka maakt het mogelijk om snel grote hoeveelheden gegevens aan hen te leveren en deze informatiestroom actueel te houden.
Replication log
Berichten verdwijnen niet na het lezen, zoals in RabbitMQ. Wanneer een evenement voldoende informatie bevat voor verwerking, hebben we een geschiedenis van de laatste wijzigingen van het object, en bij wensen de mogelijkheid om deze wijzigingen toe te passen.
De opslagduur van de replication log hangt af van de intensiteit van de schrijfacties naar dit topic. Kafka maakt het mogelijk om de limieten voor tijdsduur en datavolume flexibel in te stellen. Voor intensieve topics is het belangrijk dat alle consumenten de informatie lezen voordat deze verdwijnt, zelfs in het geval van een korte onderbreking. Gewoonlijk kunnen we gegevens voor enkele dagen, wat voldoende is voor ondersteuning.
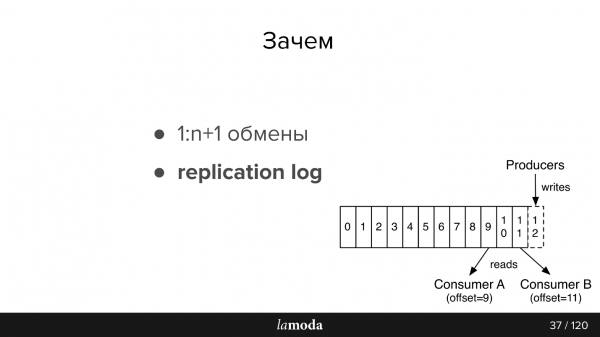
Verder een beetje een samenvatting van de documentatie, voor degenen die niet bekend zijn met Kafka (de afbeelding is ook uit de documentatie)
In AMQP zijn er wachtrijen: we schrijven berichten in de wachtrij voor de consument. Over het algemeen wordt één wachtrij beheerd door één systeem met dezelfde bedrijfslogica. Als meerdere systemen op de hoogte moeten worden gesteld, kan de applicatie worden geleerd om naar meerdere wachtrijen te schrijven of kan er een exchange worden ingesteld met een fanout-mechanisme dat ze kloont.
In Kafka is er een vergelijkbare abstractie topic, waarin je berichten schrijft, maar ze verdwijnen niet na het lezen. Standaard krijg je bij aansluiting op Kafka alle berichten, en er is de mogelijkheid om de plek waar je bent gebleven te bewaren. Dit betekent dat je sequentieel leest, je kunt een bericht niet als gelezen markeren, maar het id opslaan waar je later weer verder kunt lezen. Het id waar je gebleven bent, wordt offset (verschuiving) genoemd, en het mechanisme is commit offset.
Bijgevolg kan verschillende logica worden geïmplementeerd. Bijvoorbeeld, in onze BOB zijn er 4 instanties voor verschillende landen - Lamoda is beschikbaar in Rusland, Kazachstan, Oekraïne, en Wit-Rusland. Omdat ze apart worden gedeployd, hebben ze iets andere configuraties en hun eigen bedrijfslogica. We geven in het bericht aan naar welk land het betrekking heeft. Elke BOB-consument in elk land leest met verschillende groupId's, en als het bericht niet voor hem is, negeren ze het, wat betekent dat ze direct offset +1 committen. Als dezelfde topic gelezen wordt door onze Payment Service, dan doet hij dit met een aparte groep, waardoor de offset's niet overlappen.
Vereisten voor evenementen:
- Volledigheid van gegevens. We zouden willen dat het evenement voldoende gegevens bevat om het te kunnen verwerken.
- Integriteit. We delegeren de Events-bus de controle om ervoor te zorgen dat het evenement consistent is en hij het kan verwerken.
- Volgorde is belangrijk. In het geval van retouren moeten we met de geschiedenis werken. Bij notificaties is volgorde niet belangrijk, als het homogeen is, zal de e-mail hetzelfde zijn, ongeacht welk order als eerste is aangekomen. In het geval van een retour is er een duidelijk proces, als de volgorde wordt gewijzigd, zullen er uitzonderingen optreden, de terugbetaling zal niet worden aangemaakt of verwerkt - we komen in een andere status terecht.
- Consistentie. Wij hebben opslagruimte en nu creëren we events in plaats van API's. We hebben een manier nodig om snel en goedkoop informatie over nieuwe events en veranderingen in bestaande events naar onze services te sturen. Dit wordt bereikt via een gezamenlijke specificatie in een aparte Git-repository en codegeneratoren. Daarom zijn de klanten en servers in verschillende services bij ons op elkaar afgestemd.
Kafka bij Lamoda
Wij hebben drie Kafka-installaties:
- Logs;
- R&D;
- Events-bus.
Vandaag spreken we alleen over het laatste punt. In de events-bus hebben we niet erg grote installaties - 3 brokers (servers) en in totaal 27 topics. Gewoonlijk is één topic één proces. Maar dit is een delicaat onderwerp, en daar zullen we zo op ingaan.
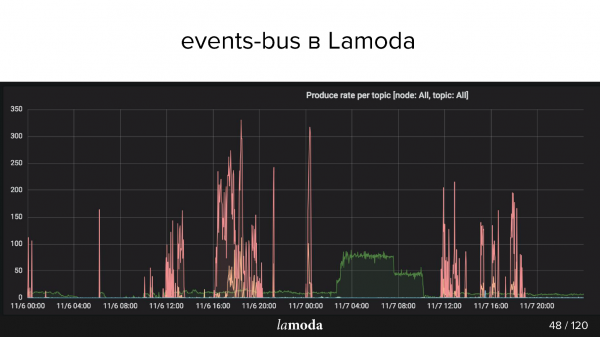
Hierboven is een grafiek van rps. Het process refunds is gemarkeerd met een turquoise lijn (ja, die op de x-as), en de roze lijn is het content-update proces.
De catalogus van Lamoda bevat miljoenen producten en de gegevens worden constant bijgewerkt. Sommige collecties raken uit de mode, daarbij komen nieuwe uit, en er verschijnen voortdurend nieuwe modellen in de catalogus. We proberen te voorspellen wat onze klanten morgen interessant zullen vinden, en daarom kopen we constant nieuwe dingen in, fotograferen ze en werken we de etalage bij.
De roze pieken zijn productupdates, dat zijn veranderingen aan producten. Het is zichtbaar dat de jongens aan het fotograferen waren, toen plotseling! - ze hebben een stapel events geüpload.
Lamoda Events use cases
De gebouwde architectuur gebruiken we voor de volgende operaties:
- Statussen van retouren volgen: call-to-action en tracking van statussen van alle betrokken systemen. Betaling, statussen, fiscalisatie, notificaties. Hier hebben we een aanpak uitgeprobeerd, tools ontwikkeld, alle bugs verzameld, documentatie geschreven en collega’s verteld hoe dit te gebruiken.
- Productkaartvernieuwing: configuratie, metadata, kenmerken. Eén systeem leest (datgene dat weergeeft), terwijl meerdere systemen schrijven.
- Email, push en sms: bestelling is verzameld, bestelling is aangekomen, retour is geaccepteerd, enz., veel van hen.
- Voorraad, voorraadupdate — kwantitatieve update van artikelen, gewoon cijfers: binnenkomst op de voorraad, retour. Het is noodzakelijk dat alle systemen die verband houden met productreserveringen werken met de meest actuele gegevens. Momenteel is het systeem voor voorraadupdates behoorlijk complex, Kafka zal het vereenvoudigen.
- Data-analyse (R&D-afdeling), ML-tools, analytics, statistieken. We willen dat de informatie transparant is - hiervoor is Kafka goed geschikt.
De nu interessantere sectie over de gemaakte fouten en interessante ontdekkingen die in zes maanden zijn gedaan.
Ontwerpproblemen
Stel dat we iets nieuws willen maken - bijvoorbeeld, het hele afleverproces naar Kafka willen overzetten. Een deel van het proces is momenteel geïmplementeerd in Order Processing in BOB. Achter de overdracht van de bestelling naar de bezorgdienst, het verplaatsen naar het tussenopslag en dergelijke, staat een statusmodel. Er is een hele monolith, zelfs twee, plus een hoop API's gewijd aan de bezorging. Ze weten veel meer over de bezorging.
Het lijkt dat dit vergelijkbare gebieden zijn, maar de statussen voor Order Processing in BOB en voor het bezorgsysteem verschillen. Sommige koeriersdiensten sturen bijvoorbeeld geen tussenliggende statussen, maar alleen de finale: 'geleverd' of 'verloren'. Anderen daarentegen rapporteren zeer gedetailleerd over de verplaatsing van goederen. Iedereen heeft zijn eigen validatieregels: voor sommigen is een e-mail geldig, wat betekent dat deze wordt verwerkt; voor anderen is het niet geldig, maar de bestelling zal toch worden verwerkt, omdat er een telefoonnummer is voor contact, en weer anderen zullen zeggen dat zo'n bestelling helemaal niet zal worden verwerkt.
Datastroom
In het geval van Kafka rijst de vraag naar het organiseren van de datastroom. Deze taak is verbonden met het kiezen van een strategie op verschillende punten, laten we ze allemaal doornemen.
In één topic of in verschillende?
We hebben een specificatie voor het evenement. In BOB schrijven we dat deze bestelling bezorgd moet worden, en we geven aan: bestelnummer, inhoud, enkele SKU's en barcodes, enz. Wanneer het product op het opslagpunt aankomt, kan de bezorging statussen, timestamps en alles wat nodig is ontvangen. Maar verder willen we in BOB updates over deze gegevens ontvangen. We krijgen een omgekeerd proces van het ophalen van gegevens uit de bezorging. Is dit hetzelfde evenement? Of is dit een aparte transactie die een aparte topic waard is?
Ze zullen waarschijnlijk sterk op elkaar lijken, en de verleiding om één topic te maken is niet ongegrond, omdat een aparte topic aparte consumenten, aparte configuraties, en een aparte generatie van dat alles met zich meebrengt. Maar dat is niet zeker.
Nieuw veld of nieuw evenement?
Maar als we dezelfde gebeurtenissen gebruiken, ontstaat er een ander probleem. Niet alle leveringssystemen kunnen een DTO genereren die door BOB kan worden gebruikt. We sturen ze id's, maar ze bewaren deze niet, omdat ze niet nodig zijn, en vanuit het perspectief van het starten van het event-bus proces is dit veld verplicht.
Als we een regel introduceren voor de event-bus dat dit veld verplicht is, zijn we gedwongen extra validatieregels in BOB of in de handler van de startgebeurtenis te plaatsen. Validatie verspreidt zich door de service — dat is niet erg handig.
Een ander probleem is de verleiding van incrementele ontwikkeling. Er wordt ons verteld dat we iets aan de gebeurtenis moeten toevoegen, en misschien, als we goed nadenken, had dit een aparte gebeurtenis moeten zijn. Maar in onze schemata is een aparte gebeurtenis een apart topic. Een apart topic is het hele proces dat ik hierboven heb beschreven. De ontwikkelaar voelt de verleiding om gewoon nog een veld in het JSON-schema toe te voegen en te regenereren.
In het geval van refunds zijn we in zes maanden bij een gebeurtenissenstroom aangekomen. We hadden één meta-gebeurtenis die 'refund update' heet, waarin een veld type zat dat beschrijft waar die update eigenlijk over gaat. Daaruit hadden we 'geweldige' schakelaars met validators die aangaven hoe deze gebeurtenis met dit type gevalideerd moet worden.
Versiebeheer van gebeurtenissen
Voor de validatie van berichten in Kafka kan je gebruik maken van , maar we moesten dit vanaf het begin integreren en Confluent gebruiken. In ons geval met versiebeheer moeten we voorzichtig zijn. Het zal niet altijd mogelijk zijn om berichten uit de replicatielog opnieuw te lezen, omdat het model 'is vertrokken'. In wezen doe je er goed aan om versies te bouwen zodat het model achterwaarts compatibel is: bijvoorbeeld een veld tijdelijk optioneel maken. Als de verschillen te groot zijn, beginnen we te schrijven naar een nieuw topic, en migreren we de klanten wanneer ze de oude hebben gelezen.
Garantie van leesvolgorde van partitions
Topics binnen Kafka zijn opgedeeld in partitions. Dit is niet erg belangrijk terwijl we entiteiten en uitwisselingen ontwerpen, maar het is belangrijk wanneer we beslissen hoe dit geconsumeerd en geschaald kan worden.
In de meeste gevallen schrijf je één topic naar Kafka. Standaard wordt er één partition gebruikt en komen alle berichten van dat topic daarin terecht. De consumer leest deze berichten dan overeenkomstig in volgorde. Stel nu dat je het systeem wilt uitbreiden zodat twee verschillende consumers de berichten kunnen lezen. Als je bijvoorbeeld een sms verstuurt, kun je Kafka vragen om een extra partition te maken, en Kafka begint de berichten over twee delen te verdelen – de helft gaat daarheen, de helft hierheen.
Hoe verdeelt Kafka ze? Elk bericht heeft een body (waar we de JSON opslaan) en er is een key. Je kunt een hashfunctie aan deze key toevoegen, die bepaalt in welke partition het bericht terechtkomt.
In ons geval met refunds is dit belangrijk; als we twee partitions nemen, is er een kans dat de parallelle consumer het tweede evenement eerder verwerkt dan het eerste, wat problematisch kan zijn. De hashfunctie garandeert dat berichten met dezelfde key in dezelfde partition belanden.
Events vs commands
Dit is nog een probleem waarmee we geconfronteerd zijn. Een event is een gebeurtenis: we zeggen dat er ergens iets is gebeurd (something_happened), bijvoorbeeld, een item is geannuleerd of er is een refund gedaan. Als er iemand naar deze gebeurtenissen luistert, dan zal de entiteit refund worden aangemaakt bij "item geannuleerd", en "er is een refund gedaan" zal ergens in de setups worden geregistreerd.
Maar meestal, wanneer je evenementen ontwerpt, wil je ze niet voor niets schrijven – je rekent erop dat er iemand zal zijn die ze leest. Er is een grote verleiding om niet something_happened (item_canceled, refund_refunded) te schrijven, maar something_should_be_done. Bijvoorbeeld, item is klaar voor retour.
Aan de ene kant geeft dit aan hoe het evenement gebruikt zal worden. Aan de andere kant lijkt het veel minder op een normale naam voor een evenement. Daarnaast is het een korte stap naar een commando do_something. Maar je hebt geen garantie dat iemand dat evenement heeft gelezen; en als iemand het heeft gelezen, dan heeft hij het succesvol gedaan; en als hij het succesvol heeft gedaan, dan heeft hij iets gedaan, en dat iets is succesvol verlopen. Op het moment dat het evenement do_something wordt, is feedback nodig, en dat is een probleem.
Bij asynchrone communicatie in RabbitMQ, wanneer je een bericht hebt gelezen en naar http bent gegaan, heb je een response – tenminste, dat het bericht is ontvangen. Wanneer je naar Kafka schrijft, krijg je een bericht dat je naar Kafka hebt geschreven, maar je weet niets over hoe het is verwerkt.
Daarom moesten we in ons geval een tegengebeurtenis invoeren en monitoring instellen op het feit dat als er zoveel gebeurtenissen zijn gegenereerd, er na zoveel tijd evenveel tegengebeurtenissen moeten komen. Als dit niet gebeurde, leek het alsof er iets misging. Bijvoorbeeld, als we de gebeurtenis «item_ready_to_refund» hebben verzonden, verwachten we dat de refund wordt aangemaakt, het geld aan de klant wordt teruggestort en we de gebeurtenis «money_refunded» ontvangen. Maar dat is niet zeker, daarom is monitoring nodig.
Nuances
Er is een vrij voor de hand liggend probleem: als je de berichten in een topic sequentieel leest en hebt een slechte bericht, dan crasht de consumer en ga je niet verder. Je moet alle consumenten stoppen, de offset verder vastleggen om weer verder te kunnen lezen.
We wisten dit, we hadden er rekening mee gehouden, en toch gebeurde het. En het gebeurde omdat de gebeurtenis geldig was vanuit het oogpunt van de events-bus, de gebeurtenis was geldig vanuit het oogpunt van de applicatievalidator, maar het was niet geldig vanuit het oogpunt van PostgreSQL, omdat we in één systeem MySQL met UNSIGNED INT hadden, terwijl in het vers geschreven systeem simpelweg INT in PostgreSQL stond. Het formaat was iets kleiner en de Id paste niet. Symfony crashed met een uitzondering. We vingen natuurlijk de uitzondering op omdat we daarop voorbereid waren, en we hadden het plan om deze offset vast te leggen, maar daarvoor wilden we het probleemcounter verhogen, aangezien het bericht niet succesvol was verwerkt. De tellers in dit project staan ook in de database, terwijl Symfony al het contact met de database had gesloten en de tweede uitzondering het hele proces doodde zonder kans om de offset vast te leggen.
Een tijdje heeft de service stilgelegen - gelukkig is dat met Kafka niet zo erg, want berichten blijven bestaan. Wanneer het werk weer wordt hervat, kunnen ze worden gelezen. Dat is handig.
Kafka heeft de mogelijkheid om een willekeurige offset via tooling in te stellen. Maar om dit te doen, moet je alle consumenten stoppen - in ons geval moet je een aparte release voorbereiden waarin er geen consumenten zijn, redeployments. Dan kan je via tooling de offset in Kafka verschuiven en zal het bericht doorgaan.
Een andere nuance - replication log vs rdkafka.so — is related to the specifics of our project. We use PHP, and in PHP, as a rule, all libraries communicate with Kafka through the rdkafka.so repository, and then there is some wrapper. Perhaps these are our personal difficulties, but it turned out that simply rereading a previously read piece is not so easy. In general, there were software issues.
Returning to the peculiarities of working with partitions, it is directly written in the documentation consumers >= topic partitions. But I found out about this much later than I would have liked. If you want to scale and have two consumers, you need at least two partitions. That is, if you had one partition with 20,000 messages accumulated, and you made a fresh one, the number of messages will not equal out evenly anytime soon. Therefore, to have two parallel consumers, you need to deal with partitions.
Monitoring
I think, based on how we monitor, it will become even clearer what issues exist in the current approach.
For example, we count how many products in the database recently changed status, and accordingly, there should have been events based on these changes, and we send this number to our monitoring system. Then from Kafka, we receive a second number, how many events were actually recorded. Obviously, the difference between these two numbers should always be zero.
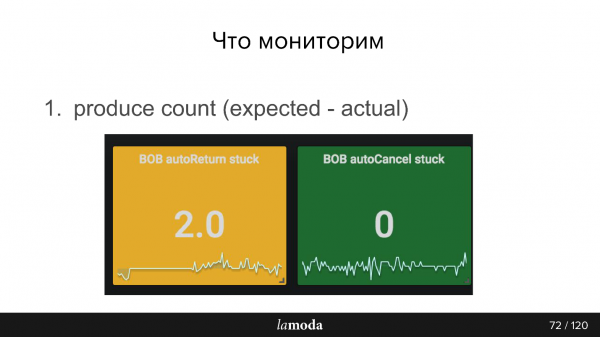
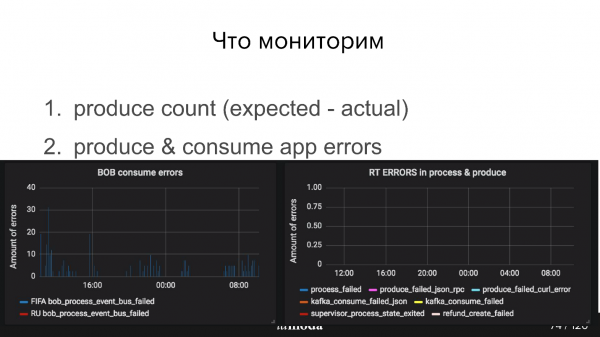
In addition, we need to monitor how things are going with the producer, whether the events-bus accepted the messages, and how the consumer is doing. For example, in the graphs below, everything is fine with the Refund Tool, but there are clearly some issues with BOB (the blue peaks).
I have already mentioned consumer-group lag. Roughly speaking, this is the number of unread messages. Overall, our consumers work quickly, so the lag is usually 0, but there can sometimes be a brief peak. Kafka can handle this out of the box, but you need to set a certain interval.
There is a project , which will give you more information about Kafka. It simply provides status on the consumer-group via API, showing how that group is doing. In addition to OK and Failed, there is a warning, and you can find out that your consumers are struggling to keep up with the production rate—they can't read what's being written fast enough. The system is quite smart and easy to use.
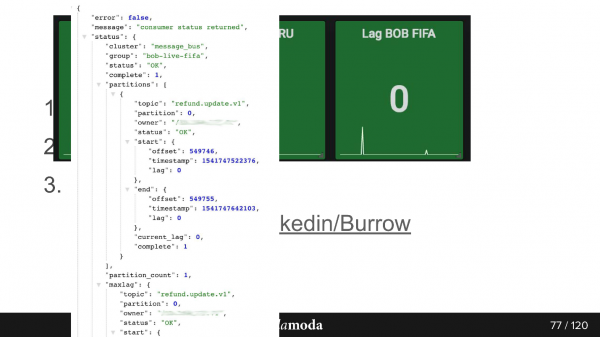
This is what the API response looks like. Here, the group bob-live-fifa, partition refund.update.v1, status OK, lag 0 — the last final offset is this.
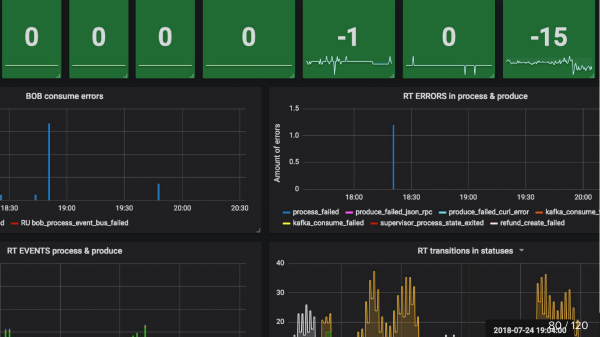
Monitoring updated_at SLA (stuck) Ik heb het al genoemd. Bijvoorbeeld, het product is in de status gegaan dat het klaar is voor retour. We zetten een Cron in die zegt dat als dit object binnen 5 minuten niet in refund is gegaan (we retourneren het geld via betalingssystemen zeer snel), dan is er zeker iets misgegaan, en is dit zeker een geval voor support. Daarom nemen we gewoon de Cron die zulke dingen leest, en als ze groter zijn dan 0, dan stuurt het een alert.
Samenvattend, het gebruik van evenementen is handig wanneer:
- informatie nodig is voor meerdere systemen;
- het resultaat van de verwerking niet belangrijk is;
- er weinig evenementen zijn of de evenementen klein zijn.
De titel van het artikel lijkt wel een vrij specifieke onderwerp te zijn - de asynchrone API op Kafka, maar in verband daarmee wil ik meteen veel aanraden.
Ten eerste, de volgende we hoeven niet tot november te wachten, want de St. Petersburg versie zal al in april zijn, en in juni zullen we praten over hoge belasting in Novosibirsk.
Ten tweede, de auteur van de presentatie, Sergey Zaika, maakt deel uit van het Programmacomité van onze nieuwe conferentie over kennismanagement . De conferentie is een eendaagse, vindt plaats op 26 april, maar het programma is erg vol.
En ook in mei zal er en (met DevOpsConf als onderdeel) - daar kan je nog steeds je eigen onderwerp voorstellen, je ervaring delen en klagen over je gemaakte fouten.
Bron: habr.com
