

Bij Sitimobil gebruiken we een MySQL-database als de belangrijkste opslagplaats voor permanente gegevens. We hebben verschillende databaseclustert voor diverse diensten en doeleinden.
De constante beschikbaarheid van de master is een kritieke indicator voor de werking van het gehele systeem en zijn onderdelen. Automatisch herstellen van de cluster in geval van een falende master vermindert aanzienlijk de responstijd op incidenten en de downtime van het systeem. In dit artikel bespreek ik het schema voor hoge beschikbaarheid (HA) van de MySQL-cluster op basis van en virtuele IP-adressen (VIP).
HA-oplossing op basis van VIP
Eerst geef ik een beknopte uitleg over wat ons opslag systeem inhoudt.
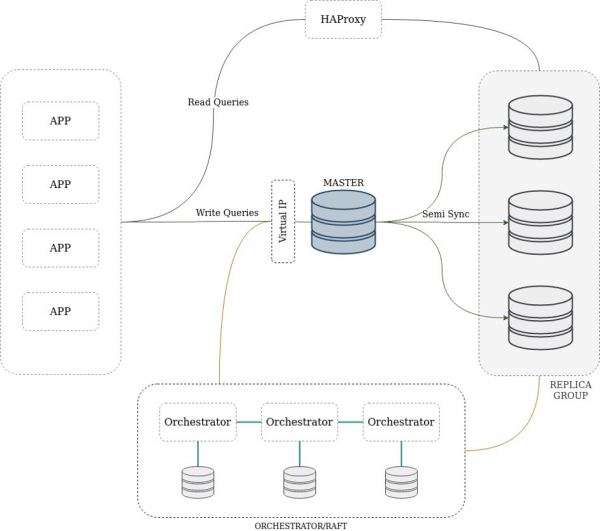
Wij gebruiken een klassieke replicatieschema met één master die schrijfbaar is en meerdere replicas die alleen voor lezen worden gebruikt. De cluster kan een tussen-master bevatten - een knooppunt dat tegelijkertijd een replica en een master voor anderen is. Klanten benaderen de replicas via HAProxy, wat een gelijkmatige verdeling van de belasting mogelijk maakt en gemakkelijk schaalbaar is. Het gebruik van HAProxy is historisch verklaarbaar, en momenteel zijn we bezig met de migratie naar ProxySQL.
Replicatie vindt plaats in een half-synchronisatiemodus op basis van GTID. Dit betekent dat ten minste één replica de transactie moet registreren in het logboek voordat deze als succesvol wordt beschouwd. Deze replicatiemodus biedt een optimale balans tussen prestaties en gegevensintegriteit in geval van uitval van de master. In principe worden alle wijzigingen van de master naar de replicas overgebracht met behulp van Row Based Replication (RBR), maar sommige knooppunten kunnen een mixed binlog format.
De orchestrator actualiseert periodiek de status van de cluster topologie, analyseert de verkregen informatie en kan bij problemen de procedure voor automatisch herstel starten. De procedure zelf wordt beheerd door de ontwikkelaar, omdat deze op verschillende manieren kan worden geïmplementeerd: op basis van VIP, DNS, met behulp van service discovery of op maat gemaakte mechanismen.
Een van de eenvoudige manieren om de master te herstellen in geval van een falen is het gebruik van zwevende VIP-adressen.
Wat u over deze oplossing moet weten voordat u verder gaat:
- VIP is een IP-adres dat niet aan een specifieke fysieke netwerkinterface is gekoppeld. Wanneer een knooppunt uitvalt of tijdens gepland onderhoud kunnen we de VIP naar een andere bron overschakelen met minimale downtime.
- Het vrijgeven en toewijzen van een virtueel IP-adres zijn goedkope en snelle operaties.
- Voor het gebruik van VIP is toegang tot de server via SSH vereist, of het gebruik van speciale hulpprogramma's, zoals
keepalived.
Laten we mogelijke problemen met onze master bespreken en bekijken hoe het mechanisme voor automatische herstel zou moeten functioneren.
Er is geen netwerkverbinding meer met de master, of er is een probleem op het niveau van de hardware, en de server is niet toegankelijk.
- De orchestrator werkt de topologie van het cluster bij, elke replica meldt de onbereikbaarheid van de master. De orchestrator start het proces van het kiezen van een replica die geschikt is om de rol van nieuwe master op zich te nemen en begint met herstel.
- We proberen de VIP van de oude master te verwijderen - zonder succes.
- De replica schakelt over naar de rol van master. De topologie wordt opnieuw opgebouwd.
- We voegen een nieuwe netwerkinterface met VIP toe. Aangezien we de VIP niet konden verwijderen, starten we op de achtergrond periodiek een verzoek. gratuitous ARP. Dit type verzoek/antwoord maakt het mogelijk om de tabel van IP- en MAC-adressen op de aangesloten switches bij te werken, waardoor we onze VIP verhuizen. Dit minimaliseert de kans op
split brainbij het herstel van de oude master. - Alle nieuwe verbindingen worden onmiddellijk omgeleid naar de nieuwe master. Oude verbindingen eindigen zonder succes, en er worden herhaalde oproepen naar de database op applicatieniveau gedaan.
De server werkt normaal, er is een storing op het niveau van de DBMS.
Het algoritme is vergelijkbaar met het vorige geval: bijwerken van de topologie en starten van het herstelproces. Aangezien de server toegankelijk is, geven we de VIP succesvol vrij op de oude master, verplaatsen we deze naar de nieuwe en sturen we een paar ARP-verzoeken. Een mogelijke terugkeer van de oude master mag de opnieuw gebouwde cluster en de werking van de applicatie niet beïnvloeden.
Andere problemen
Uitval van replicas of tussenliggende masters leidt niet tot automatische acties en vereist handmatig ingrijpen.
Een virtuele netwerkinterface wordt altijd tijdelijk toegevoegd, dat wil zeggen dat na een herstart van de server VIP automatisch niet meer wordt toegewezen. Elke database-instantie start standaard in alleen-lezen modus; de orkestrator wisselt automatisch de nieuwe master naar schrijfmodus en probeert het in te stellen alleen lezen op de oude master. Deze acties zijn gericht op het verminderen van de waarschijnlijkheid split brain.
Tijdens het herstel kunnen er problemen ontstaan waarvan het ook belangrijk is om via de UI van de orkestrator naast de standaard monitoringtools op de hoogte te stellen. We hebben de REST API uitgebreid met deze mogelijkheid ( is momenteel in behandeling).
Het algemene schema van de HA-oplossing wordt hieronder gepresenteerd.
Keuze van de nieuwe master
De orkestrator is slim genoeg en probeert te kiezen als nieuwe master op basis van de volgende criteria:
- het achterlopen van de replica ten opzichte van de master;
- de versie van MySQL van de master en de replica;
- het type replicatie (RBR, SBR of gemengd);
- de locatie in dezelfde of verschillende datacenters;
- aanwezigheid
errant GTID— transacties die op de replica zijn uitgevoerd en niet op de master aanwezig zijn; - gebruikersregels voor selectie worden ook in aanmerking genomen.
Niet elke replica is een ideale kandidaat voor de rol van master. Bijvoorbeeld, de replica kan worden gebruikt voor gegevensback-up of de server heeft een zwakkere hardwareconfiguratie. De orkestrator handmatige regels waarmee je je voorkeuren voor het kiezen van kandidaten kunt instellen van de meest voorkeurwaardige tot genegeerde.
Reactietijd en herstel
In geval van een incident is het belangrijk de stilstandtijd van het systeem te minimaliseren; daarom bekijken we de MySQL-instellingen die van invloed zijn op de opbouw en vernieuwing van de topologie van het cluster door de orkestrator:
- — aantal seconden dat de replica wacht op nieuwe gegevens of heartbeat-signalen van de master voordat de verbinding als verloren wordt beschouwd en er een reconnect plaatsvindt. Hoe lager de waarde, hoe sneller de replica kan vaststellen dat de verbinding met de master is verbroken. We stellen deze waarde in op 5 seconden.
- — het aantal seconden tussen de herverbinding pogingen. Bij netwerkproblemen zal een lage waarde van deze parameter een snelle herverbinding mogelijk maken en de start van het clusterherstelproces voorkomen. De aanbevolen waarde is 1 seconde.
MASTER_RETRY_COUNT— het maximum aantal herverbinding pogingen.MASTER_HEARTBEAT_PERIOD— het aantal seconden waarna de master een heartbeat-signaal verzendt. Standaard staat dit op de helft van de waardeslave_net_timeout.
Orkestratorparameters:
DelayMasterPromotionIfSQLThreadNotUpToDate— indien gelijk aantrue, zal de rol van de master niet worden toegepast op de replica-kandidaat totdat de SQL-thread van de replica alle niet-toegepaste transacties uit de Relay Log heeft voltooid. We gebruiken deze optie om transacties niet te verliezen wanneer alle replica-kandidaten achterlopen.InstancePollSeconds— de frequentie van het opbouwen en bijwerken van de topologie.RecoveryPollSeconds— de frequentie van het analyseren van de topologie. In geval van een probleem met de detectie wordt de topologieherstelstart. Dit is, gelijk aan 1 seconde.
Elke clusterknoop wordt eenmaal in InstancePollSeconds seconden door de orkestrator bevraagd. Bij detectie van een probleem wordt de status van het cluster gedwongen, waarna een definitieve beslissing over het uitvoeren van herstel wordt genomen. Door te experimenteren met verschillende parameters van de DB en de orkestrator, hebben we de reactietijd en herstelduur tot 30 seconden weten te verlagen.
Teststand
We zijn gestart met het testen van het HA-schema door een lokale te ontwikkelen en deze vervolgens in test- en productieomgevingen in te voeren. De lokale opstelling is volledig geautomatiseerd op basis van Docker en stelt ons in staat om te experimenteren met de configuratie van de orkestrator en het netwerk, de cluster van 2-3 servers tot tientallen uit te breiden en oefeningen uit te voeren in een veilige omgeving.
Tijdens de oefeningen kiezen we een van de methoden om een probleem te simuleren: de master abrupt afsluiten met behulp van kill -9, het proces soepel afsluiten en de server stoppen (docker-compose stop), netwerkproblemen simuleren met behulp van iptables -j REJECT of iptables -j DROP. We verwachten de volgende resultaten:
- de orkestrator zal problemen met de master detecteren en de topologie binnen 10 seconden bijwerken;
- automatisch het herstelproces starten: de netwerkinstellingen wijzigen, de rol van de master overdragen aan de replica, de topologie opnieuw opbouwen;
- de nieuwe master zal beschikbaar zijn voor schrijven, en levende replicas gaan niet verloren tijdens de herstructurering;
- gegevens beginnen te worden geschreven naar de nieuwe master en te worden gerepliceerd;
- de totale hersteltijd zal niet meer dan 30 seconden bedragen.
Zoals u weet, kan het systeem zich anders gedragen in test- en productieomgevingen vanwege de verschillende configuraties van hardware en netwerken, verschillen in synthetische en werkelijke belasting, enz. Daarom voeren we af en toe oefeningen in echte omstandigheden uit om te controleren hoe het systeem zich gedraagt bij het verlies van netwerkconnectiviteit of de degradatie van afzonderlijke componenten. In de toekomst willen we een volledig identieke infrastructuur voor beide omgevingen opbouwen en het testen ervan automatiseren.
Conclusies
De operationele beschikbaarheid van de primaire opslagnode is een van de belangrijkste taken van het SRE- en exploitatie-team. De implementatie van een orchestrator en een HA-oplossing op basis van VIP heeft de volgende resultaten opgeleverd:
- betrouwbare detectie van problemen met de cluster-topologie;
- automatische en snelle reactie op incidenten die verband houden met de master, wat de downtime van het systeem vermindert.
Echter, de oplossing heeft zijn beperkingen en nadelen:
- het schalen van het HA-schema naar meerdere datacenters vereist een uniforme L2-netwerkverbinding tussen deze datacenters;
- voordat we VIP aan de nieuwe master toewijzen, moeten we deze vrijgeven op de oude. Dit proces is sequentieel, wat de hersteltijd vergroot;
- het vrijgeven van VIP vereist SSH-toegang tot de server, of een andere manier om externe procedures aan te roepen. Aangezien de server of database problemen ondervindt die het herstelproces hebben veroorzaakt, kunnen we niet zeker zijn dat het vrijgeven van VIP succesvol zal zijn. Dit kan leiden tot de situatie van twee servers met hetzelfde virtuele IP-adres en problemen.
split brain.
Om dit te voorkomen split brain, kan de methode worden gebruikt ("Shoot The Other Node In The Head"), die de probleemnode volledig isoleert of uitschakelt. Er zijn ook andere manieren om hoge beschikbaarheid van de cluster te implementeren: een combinatie van VIP en DNS, service-detectie en proxy-services, synchrone replicatie en andere methoden, die elk hun voor- en nadelen hebben.
Ik heb ons beleid voor het creëren van een storingsbestendige MySQL-cluster toegelicht. Het is eenvoudig te implementeren en biedt een acceptabel betrouwbaarheidsniveau onder de huidige omstandigheden. Naarmate het gehele systeem en de infrastructuur in het bijzonder zich ontwikkelen, zal deze aanpak ongetwijfeld evolueren.
Bron: habr.com
