

Ik nodig u uit om de transcriptie van de presentatie van Alexey Lesovskiy van Data Egret "De basisprincipes van PostgreSQL-monitoring" te bekijken.
In deze presentatie zal Alexey Lesovskiy de belangrijkste punten van PostgreSQL-statistieken bespreken, wat ze betekenen en waarom ze in de monitoring aanwezig moeten zijn; welke grafieken in de monitoring moeten zitten, hoe deze toe te voegen en hoe ze te interpreteren. De presentatie zal nuttig zijn voor databasebeheerders, systeembeheerders en ontwikkelaars die geïnteresseerd zijn in het oplossen van problemen met Postgres.
Mijn naam is Alexey Lesovskiy, ik vertegenwoordig het bedrijf Data Egret.
Even iets over mezelf. Ik begon ooit als systeembeheerder.
Ik heb allerlei verschillende Linux-systemen beheerd en deed verschillende dingen gerelateerd aan Linux, zoals virtualisatie, monitoring, en werkte met proxy's, enzovoort. Maar op een gegeven moment begon ik me meer met databases bezig te houden, met name PostgreSQL. Ik vond het erg leuk. En op een gegeven moment begon ik het merendeel van mijn werk met PostgreSQL door te brengen. Zo werd ik geleidelijk aan PostgreSQL DBA.
Gedurende mijn hele carrière heb ik altijd interesse gehad in statistiek, monitoring en telemetrie. En terwijl ik systeembeheerder was, ben ik me intensief gaan bezig houden met Zabbix. En ik heb een kleine set scripts geschreven zoals . Dit was vrij populair in zijn tijd. En daarmee kon je heel verschillende belangrijke dingen monitoren, niet alleen Linux, maar ook andere componenten.
Momenteel ben ik al bezig met PostgreSQL. Ik schrijf iets anders dat het mogelijk maakt om met PostgreSQL-statistieken te werken. Het heet (artikel op Habr — ).
Een korte inleiding. Wat voor situaties hebben onze klanten, onze cliënten? Er doet zich een storing voor die verband houdt met de database. En wanneer de database is hersteld, komt de afdelingshoofd of de ontwikkelingsleider en zegt: "Vrienden, we moeten de database in de gaten houden, want er is iets verkeerd gegaan en we moeten ervoor zorgen dat zoiets in de toekomst niet meer gebeurt". En hier begint het interessante proces van het kiezen van een monitoringssysteem of het aanpassen van een bestaand monitoringssysteem zodat we onze database - PostgreSQL, MySQL of andere - kunnen monitoren. En collega's beginnen te zeggen: "Ik heb gehoord dat er die database bestaat. Laten we die gebruiken". Collega's gaan met elkaar in discussie. En uiteindelijk kiezen we een database, maar de monitoring van PostgreSQL is daarin behoorlijk slecht vertegenwoordigd en we moeten altijd iets aanpassen. We moeten repositories van GitHub pakken, deze klonen, scripts aanpassen, en het fine-tunen. En uiteindelijk resulteert dit in handmatig werk.
Daarom zal ik in deze presentatie proberen jullie enig inzicht te geven in hoe je monitoring kiest, niet alleen voor PostgreSQL, maar voor databases in het algemeen. En jullie de kennis te verschaffen die jullie in staat stelt om je monitoring te verbeteren, zodat je er echt voordeel uit kunt halen, zodat je je database efficiënt kunt monitoren en tijdig kunt waarschuwen voor mogelijke storingen die zich kunnen voordoen.
En de ideeën die in deze presentatie worden gepresenteerd, kunnen rechtstreeks worden aangepast aan elke database, of het nu relationele databases of noSQL-databases zijn. Daarom is het niet alleen PostgreSQL, maar er zullen ook veel recepten zijn voor hoe je dit voor PostgreSQL kunt doen. Er zullen voorbeelden zijn van queries, voorbeelden van entiteiten die beschikbaar zijn in PostgreSQL voor monitoring. En als jouw RDBMS soortgelijke functionaliteiten heeft die je in de monitoring kunt opnemen, kun je ze ook aanpassen en toevoegen, en dat zal goed zijn.
 In de presentatie zal ik niet
bespreken hoe je metrics kunt verzamelen en opslaan. Ik zal niets zeggen over het na-verwerken van gegevens en hoe je die aan de gebruiker kunt presenteren. En ik zal ook niets zeggen over het alarmeren.
Maar gedurende het verhaal zal ik verschillende screenshots van bestaande monitoringen tonen en deze op een bepaalde manier bekritiseren. Desondanks zal ik proberen geen merknamen te noemen om geen reclame of negatieve reclame voor deze producten te maken. Daarom blijven alle overeenkomsten toevallig en aan uw verbeelding overgelaten.
Laten we eerst uitzoeken wat monitoring is. Monitoring is een zeer belangrijk hulpmiddel dat je nodig hebt. Iedereen begrijpt dat. Maar tegelijkertijd is monitoring geen businessproduct en heeft het geen directe invloed op de winst van een bedrijf, daarom wordt er altijd pas aandacht aan monitoring besteed als er tijd over is. Als we tijd hebben, dan doen we aan monitoring; als we geen tijd hebben, dan is dat OK, zetten we het op de backlog en komen we ooit terug naar deze taken.
Daarom is het uit onze praktijk zo dat wanneer wij bij klanten komen, monitoring vaak onderontwikkeld is en geen interessante zaken bevat die ons helpen ons werk met de database beter te doen. Daarom moet monitoring altijd verder worden ontwikkeld.
Databases zijn complexe systemen die ook gemonitord moeten worden, omdat databases informatieopslagplaatsen zijn. En informatie is zeer belangrijk voor een bedrijf; die mag je op geen enkele manier verliezen. Maar tegelijkertijd zijn databases zeer complexe stukken software. Ze bestaan uit een groot aantal componenten. En veel van deze componenten moeten gemonitord worden.
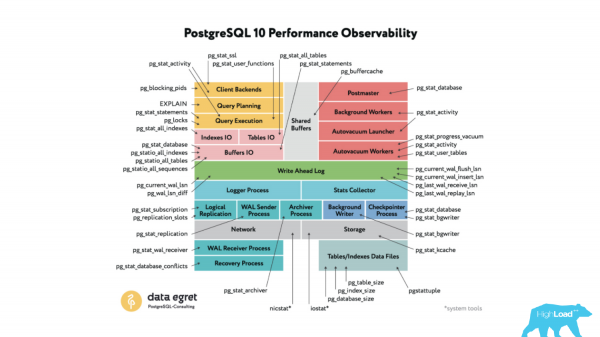 Als we specifiek over PostgreSQL praten, kan het worden voorgesteld als een schema dat bestaat uit een groot aantal componenten. Deze componenten interageren met elkaar. En tegelijkertijd heeft PostgreSQL een zogenaamde Stats Collector-sub-systeem, dat het mogelijk maakt om statistieken over het functioneren van deze subsystemen te verzamelen en een interface te bieden aan de administrator of gebruiker, zodat hij deze statistieken kan bekijken.
Deze statistieken worden gepresenteerd in de vorm van een bepaalde set functies en views. Ze kunnen ook tabellen worden genoemd. Dat wil zeggen, met behulp van een gewone psql-client kun je verbinding maken met de database, een SELECT-query uitvoeren op deze functies en views en al specifieke cijfers over het functioneren van de PostgreSQL-subsystemen verkrijgen.
Je kunt deze cijfers toevoegen aan je favoriete monitoringssysteem, grafieken tekenen, functies toevoegen en analyses op lange termijn verkrijgen.
In dit rapport zal ik echter niet alle functies volledig bespreken, omdat dit de hele dag kan duren. Ik zal me richten op slechts twee tot vier aspecten en uitleggen hoe ze helpen bij het verbeteren van de monitoring.
Als we het over database-monitoring hebben, wat moeten we dan monitoren? In de eerste plaats moet de beschikbaarheid worden gemonitord, omdat de database een service is die toegang tot gegevens biedt aan klanten, en we moeten de beschikbaarheid monitoren, evenals enkele kwalitatieve en kwantitatieve kenmerken ervan.
Daarnaast moeten we de klanten monitoren die verbinding maken met onze database, omdat ze zowel reguliere klanten als schadelijke klanten kunnen zijn die de database kunnen schaden. Ook hun activiteiten moeten worden gemonitord en gevolgd.
Wanneer klanten verbinding maken met de database, is het duidelijk dat ze beginnen te werken met onze gegevens, dus moeten we ook monitoren hoe klanten met de gegevens werken: met welke tabellen ze werken, en in mindere mate met welke indexen. Dat wil zeggen, we moeten de werklast (workload) evalueren die door onze klanten wordt gecreëerd.
De werklast bestaat natuurlijk ook uit verzoeken. Applicaties maken verbinding met de database en benaderen gegevens via verzoeken, dus het is belangrijk om te evalueren welke verzoeken we in de database hebben, hun geschiktheid te volgen, ervoor te zorgen dat ze niet verkeerd zijn geschreven, en dat sommige opties herschreven moeten worden om sneller en efficiënter te werken.
En aangezien we het over databases hebben, zijn databases altijd bezig met achtergrondprocessen. Achtergrondprocessen zorgen ervoor dat de prestaties van de database op een goed niveau blijven, dus hebben ze een bepaalde hoeveelheid middelen nodig voor hun werking. Tegelijkertijd kunnen ze samenkomen met de middelen van klantverzoeken, waardoor een hoge belasting van achtergrondprocessen rechtstreeks invloed kan hebben op de prestaties van klantverzoeken. Daarom moeten ze ook worden gemonitord en geanalyseerd om te zorgen dat er geen onbalans is in termen van achtergrondprocessen.
En de monitoring van databases blijft in de systeemmetriek. Maar gezien het feit dat onze gehele infrastructuur grotendeels naar de cloud verhuist, komen de systeemmetriek van een afzonderlijke host altijd op de tweede plaats. Maar in databases blijven ze nog steeds relevant en moet je de systeemmetriek natuurlijk ook monitoren.
Met systeemmetriek is het meer of minder goed, alle moderne monitoringsystemen ondersteunen deze metriek al, maar over het algemeen ontbreken er toch enkele componenten, en moeten we sommige dingen toevoegen. Hier zal ik ook op ingaan, er komen een paar dia's over.
Het eerste punt van het plan is beschikbaarheid. Wat is beschikbaarheid? Beschikbaarheid is naar mijn mening het vermogen van de database om verbindingen te onderhouden, dat wil zeggen, de database is actief en accepteert verbindingen van klanten als een service. En deze beschikbaarheid kan worden geëvalueerd aan de hand van bepaalde kenmerken. Deze kenmerken kunnen heel handig op dashboards worden gepresenteerd.
Iedereen weet wat dashboards zijn. Dit is wanneer je een blik op het scherm werpt waarop de benodigde informatie is samengevoegd. En je kunt meteen bepalen of er een probleem is met de database of niet.
Daarom moeten de beschikbaarheid van de database en andere belangrijke kenmerken altijd op de dashboards worden weergegeven, zodat deze informatie binnen handbereik is en altijd bij je is. Sommige aanvullende details, die helpen bij het onderzoeken van incidenten of noodsituaties, moeten op secundaire dashboards worden weergegeven of verborgen in drilldown-links die leiden naar externe monitoringsystemen.
Een voorbeeld van een bekend monitoringsysteem. Dit is een heel gaaf monitorsysteem. Het verzamelt heel veel gegevens, maar vanuit mijn perspectief heeft het een vreemde opvatting van dashboards. Er is een link 'dashboard aanmaken'. Maar wanneer je een dashboard aanmaakt, maak je een soort lijst met twee kolommen, een soort lijst met grafieken. En wanneer je iets wilt bekijken, begin je met de muis te klikken, door te scrollen en de juiste grafiek te zoeken. Dit kost tijd, dat wil zeggen, er zijn geen echte dashboards. Er zijn slechts lijsten met grafieken.
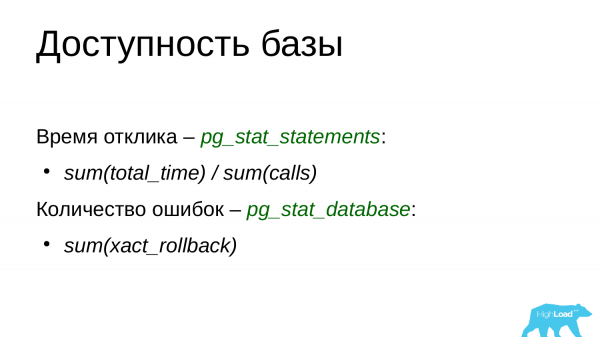
Wat moet er aan deze dashboards worden toegevoegd? We kunnen beginnen met een kenmerk zoals de responstijd. In PostgreSQL is er een weergave genaamd pg_stat_statements. Standaard is deze uitgeschakeld, maar dit is een van de belangrijke systeemweergaven die altijd ingeschakeld en gebruikt moet worden. Het slaat informatie op over alle uitgevoerde queries in de database.
We kunnen daar vanuit gaan dat we de totale uitvoeringstijd van alle queries kunnen nemen en deze delen door het aantal queries met behulp van de hierboven genoemde velden. Maar dit is een gemiddelde temperatuur in de ziekenhuizen. We kunnen ons ook baseren op andere velden: de minimale, maximale en mediane uitvoeringstijd van queries. We kunnen zelfs percentielen opstellen, PostgreSQL heeft de bijbehorende functies hiervoor. En we kunnen enkele cijfers krijgen die de responstijd van onze database kenmerken op basis van reeds uitgevoerde queries, dat wil zeggen, we voeren geen nepprobleem ‘select 1’ uit en kijken naar de responstijd, maar we analyseren de responstijden van reeds uitgevoerde queries en tekenen deze ofwel als een afzonderlijk cijfer ofwel op een grafiek.
Het is ook belangrijk om het aantal fouten bij te houden dat momenteel door het systeem wordt gegenereerd. En daarvoor kan de weergave pg_stat_database worden gebruikt. We richten ons op het veld xact_rollback. Dit veld toont niet alleen het aantal rollbacks die plaatsvinden in de database, maar houdt ook rekening met het aantal fouten. Voor eenvoudig begrip kunnen we dit cijfer op ons dashboard weergeven en kijken hoeveel fouten we momenteel hebben. Als er veel fouten zijn, is dat al een goede reden om in de logs te kijken en te zien welke fouten er zijn en waarom ze optreden, en verder dan dat kunnen we onderzoeken en ze oplossen.
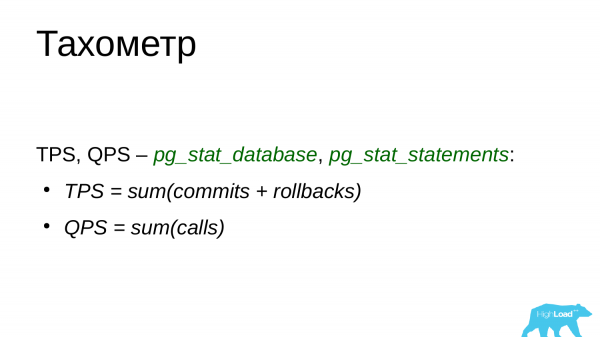
Je kunt ook iets toevoegen zoals een tachometer. Dit is het aantal transacties per seconde en het aantal queries per seconde. Je kunt deze cijfers beschouwen als de huidige prestaties van je database en observeren of er pieken zijn in het aantal queries, pieken in het aantal transacties of, omgekeerd, dat de database niet voldoende belast is omdat een bepaalde backend is uitgevallen. Dit cijfer is belangrijk om altijd in de gaten te houden, en te onthouden dat voor ons project een bepaalde prestatie normaal is, terwijl hogere of lagere waarden problematisch en onduidelijk zijn, wat betekent dat we moeten kijken waarom zulke cijfers optreden.
Om het aantal transacties te beoordelen, kunnen we opnieuw kijken naar de weergave pg_stat_database. We kunnen het aantal commits en het aantal rollbacks optellen om het aantal transacties per seconde te krijgen.
Iedereen begrijpt dat in één transactie meerdere aanvragen kunnen zijn, toch? Daarom zijn TPS en QPS een beetje verschillend.
Het aantal aanvragen per seconde kan worden verkregen via pg_stat_statements en simpelweg de som van alle uitgevoerde aanvragen worden berekend. Het is duidelijk dat we de huidige waarde vergelijken met de vorige, hiervan aftrekken, de delta krijgen en het aantal bepalen.
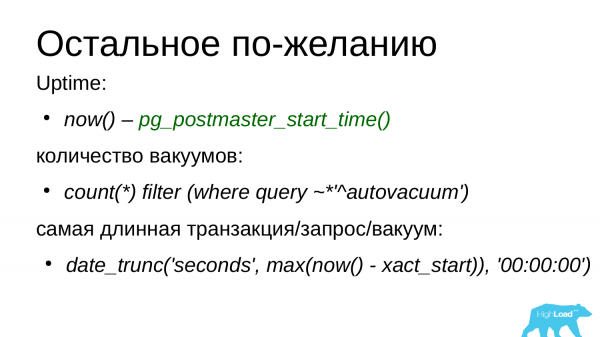
Er kunnen ook extra metriek worden toegevoegd die helpen bij het evalueren van de beschikbaarheid van onze database en om te controleren of er geen downtime is geweest.
Een van deze metrics is uptime. Maar uptime in PostgreSQL is een beetje een lastig onderwerp. Ik zal uitleggen waarom. Wanneer PostgreSQL wordt gestart, begint de uptime te tellen. Maar als op een bepaald moment, bijvoorbeeld 's nachts, een taak wordt uitgevoerd en de OOM-killer gedwongen een kindproces van PostgreSQL beëindigt, dan sluit PostgreSQL alle klantverbindingen, reset het shardgeheugen en begint het met herstel vanaf het laatste controlepunt. En zolang dit herstel duurt, accepteert de database geen verbindingen, dat wil zeggen dat deze situatie kan worden beschouwd als downtime. Maar tegelijkertijd wordt de uptime-teller niet gereset, omdat deze de tijd vanaf het eerste moment dat de postmaster is gestart, telt. Daarom kunnen dergelijke situaties worden gemist.
Ook moet het aantal vacuümwerkers worden gemonitord. Weet iedereen wat autovacuum in PostgreSQL is? Het is een interessante subsysteem in PostgreSQL. Er zijn veel artikelen over geschreven, veel presentaties gemaakt. Veel discussies over vacuüm, over hoe het moet werken. Velen beschouwen het als een onvermijdelijk kwaad. En dat is het ook. Het is een soort analoog van een garbage collector dat verouderde versies van rijen schoonmaakt die door geen enkele transactie nodig zijn en ruimte vrijmaakt in tabellen en indexen voor nieuwe rijen.
Waarom moet het worden gemonitord? Omdat vacuüm soms veel pijn doet. Het verbruikt een groot aantal middelen en klantaanvragen lijden daaronder.
En u moet dit monitoren via de view pg_stat_activity, waarover ik in de volgende sectie zal spreken. Deze view toont de huidige activiteit in de database. En via deze activiteit kunnen we het aantal vacuumprocessen dat momenteel actief is bijhouden. We kunnen de vacuumprocessen volgen en zien dat als we het limiet overschrijden, dit een reden is om in de instellingen van PostgreSQL te kijken en de werking van de vacuum te optimaliseren.
Een andere eigenschap van PostgreSQL is dat het zeer gevoelig is voor lange transacties. Vooral voor transacties die lang stilzitten en niets doen. Dit zijn de zogenaamde stat idle-in-transaction. Zo'n transactie houdt sloten vast, wat het werken van de vacuum belemmert. En als gevolg daarvan worden de tabellen opgeblazen, ze nemen in grootte toe. En de queries die met deze tabellen werken, beginnen trager te werken, omdat ze alle oude versies van rijen van het geheugen naar de schijf en terug moeten slepen. Daarom moet de duur van de langste transacties en de langste vacuumquery's ook gemonitord worden. En als we processen zien die al heel lang draaien, meer dan 10-20-30 minuten voor een OLTP-lading, dan moeten we hier aandacht aan besteden en deze geforceerd beëindigen, of de applicatie optimaliseren zodat ze niet zo lang worden aangeroepen en blijven hangen. Voor analytische ladingen zijn 10-20-30 minuten normaal; soms zijn ze zelfs nog langer.
Vervolgens hebben we de optie van verbonden klanten. Wanneer we het dashboard hebben opgesteld en de belangrijkste beschikbaarheidsstatistieken hebben weergegeven, kunnen we ook extra informatie over de verbonden klanten toevoegen.
Informatie over de verbonden klanten is belangrijk, omdat klanten vanuit het perspectief van PostgreSQL verschillend kunnen zijn. Er zijn goede klanten en slechte klanten.
Een eenvoudig voorbeeld. Met klant bedoel ik een applicatie. De applicatie maakt verbinding met de database en begint meteen zijn verzoeken te verzenden, de database verwerkt deze en voert ze uit, en de resultaten worden teruggestuurd naar de klant. Dit zijn goede en correcte klanten.
Er zijn situaties waarin een klant verbinding maakt, de connectie vasthoudt, maar tegelijkertijd niets doet. Hij bevindt zich in een idle-status.
Maar er zijn ook slechte klanten. Neem bijvoorbeeld diezelfde klant die zich heeft aangemeld, een transactie heeft geopend, iets in de database heeft gedaan en vervolgens in de code is gegaan, laten we zeggen, om een extern bron te benaderen of om daar gegevensverwerking te doen. Maar hij heeft de transactie niet gesloten. En de transactie blijft open in de database en houdt een vergrendeling op de rij vast. Dit is een slechte situatie. Als de applicatie op enige wijze een uitzondering (Exception) tegenkomt, kan de transactie lange tijd open blijven. Dit heeft direct invloed op de prestaties van PostgreSQL. PostgreSQL zal langzamer werken. Daarom is het belangrijk om dergelijke klanten tijdig te monitoren en hun sessies geforceerd te beëindigen. Je moet je applicatie optimaliseren om dergelijke situaties te voorkomen.
Andere slechte klanten zijn de wachtende klanten. Maar zij worden slecht door omstandigheden. Neem bijvoorbeeld een eenvoudige inactieve transactie: hij kan een transactie openen, sommige rijen vergrendelen, en dan kan de transactie ergens in de code falen, waardoor hij open blijft staan. Een andere klant komt binnen, vraagt naar dezelfde gegevens, maar stuit op een vergrendeling, omdat die openstaande transactie al een vergrendeling op bepaalde benodigde rijen houdt. En de tweede transactie zal wachten totdat de eerste transactie is voltooid of handmatig door de beheerder is gesloten. Op deze manier kunnen wachtende transacties zich ophopen en de verbindinglimieten van de database overschrijden. En wanneer de limiet is overschreden, kan de applicatie niet meer met de database werken. Dit is al een noodsituatie voor het project. Daarom moeten slechte klanten worden gemonitord en moet er tijdig op hen worden gereageerd.
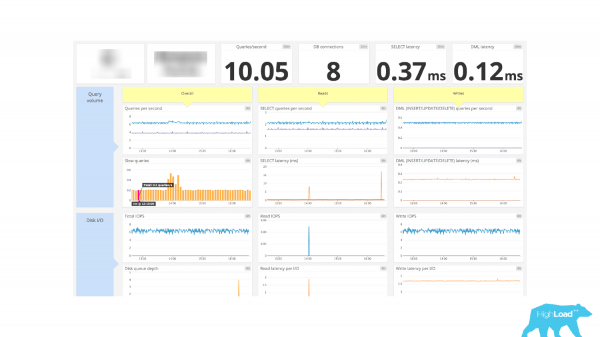
Een ander voorbeeld van monitoring. En hier is het al een behoorlijke dashboard. Er is informatie over de verbindingen bovenaan. DB-verbinding – 8 stuks. En dat is alles. We hebben geen informatie over welke klanten actief zijn, welke klanten gewoon idle zijn en niets doen. Er is geen informatie over openstaande transacties en sobre wachtende verbindingen, dat wil zeggen, het is een getal dat het aantal verbindingen aangeeft en verder is het gokken.
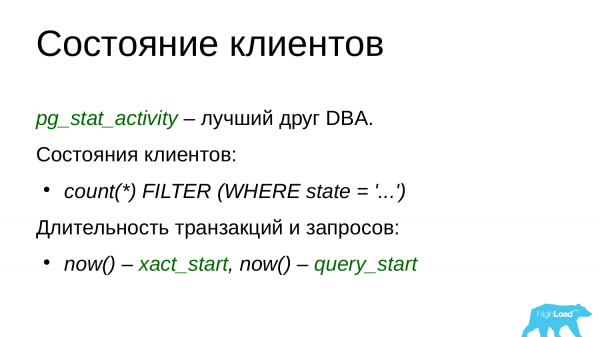
Om deze informatie aan de monitoring toe te voegen, moet je de systeemweergave pg_stat_activity raadplegen. Als je veel tijd in PostgreSQL doorbrengt, is dit een zeer nuttige weergave die je vriend moet worden, omdat het de huidige activiteit in PostgreSQL laat zien, dat wil zeggen, wat er gebeurt. Voor elk proces is er een aparte regel die informatie over dat proces toont: van welk host de verbinding is gemaakt, onder welke gebruiker, onder welke naam, wanneer de transactie is gestart, welke aanvraag momenteel wordt uitgevoerd, welke aanvraag als laatst werd uitgevoerd. En, afhankelijk daarvan, kunnen we de status van de client inschatten op basis van het veld stat. In feite kunnen we een groepering maken op basis van dit veld en de stats die momenteel in de database aanwezig zijn en het aantal connecties met deze stat in de database verkrijgen. De verkregen cijfers kunnen we vervolgens naar onze monitoring sturen en grafieken op basis daarvan tekenen.
Het is ook belangrijk om de duur van de transactie te evalueren. Ik heb al gezegd dat het belangrijk is om de duur van vacuums te beoordelen, maar transacties worden op dezelfde manier geëvalueerd. Er zijn de velden xact_start en query_start. Deze geven in feite de starttijd van de transactie en de starttijd van de aanvraag weer. We nemen de functie now(), die het huidige tijdstip toont, en trekken de timestamp van de transactie en het verzoek af. Zo krijgen we de duur van de transactie en de duur van het verzoek.
Als we lange transacties zien, moeten we deze afsluiten. Voor OLTP-belasting zijn lange transacties meer dan 1-2-3 minuten.. Voor OLAP-belasting zijn lange transacties normaal, maar als ze langer dan twee uur duren, is dat ook een teken dat er ergens een scheefgroei is.
Wanneer klanten verbinding maken met de database, beginnen ze met onze gegevens te werken. Ze raadplegen tabellen, ze raadplegen indexen om gegevens uit de tabel te halen. Het is belangrijk om te evalueren hoe klanten met deze gegevens werken.
Dit is nodig om onze workload te evalueren en een idee te krijgen van welke tabellen het meest 'heet' zijn. Bijvoorbeeld, dit is belangrijk in situaties waarin we 'hete' tabellen op een snelle SSD-opslag willen plaatsen. Archive tabellen die we al lange tijd niet gebruiken, kunnen bijvoorbeeld op een 'koude' archiefopslag, op SATA-schijven, worden geplaatst en daar blijven, met toegang naar behoefte.
Het is ook nuttig voor het opsporen van anomalieën na verschillende releases en deployments. Stel, een project introduceert een nieuwe functie. Bijvoorbeeld, er is nieuwe functionaliteit toegevoegd voor databasebeheer. En als we gebruiksgrafieken van tabellen opstellen, kunnen we deze anomalieën gemakkelijk op die grafieken ontdekken. Bijvoorbeeld, pieken in updates of pieken in deletes. Dit zal heel goed zichtbaar zijn.
Bovendien kunnen anomalieën in 'vervormde' statistieken worden ontdekt. Wat betekent dit? PostgreSQL heeft een zeer sterke en goede query planner. En ontwikkelaars besteden veel tijd aan de ontwikkeling ervan. Hoe werkt dit? Om goede plannen te maken, verzamelt PostgreSQL periodiek statistieken over de gegevensverdeling in tabellen. Dit zijn de meest voorkomende waarden: het aantal unieke waarden, informatie over NULL in de tabel, en heel veel informatie.
Op basis van deze statistieken bouwt de planner verschillende query's, kiest de meest optimale en gebruikt dit uitvoeringsplan voor de uitvoering van de query zelf en voor het retourneren van gegevens.
Soms raakt de statistiek 'vervormd'. De kwaliteit en hoeveelheid van gegevens in de tabel zijn op een bepaalde manier veranderd, maar de statistiek is niet verzameld. En de gegenereerde plannen kunnen niet optimaal blijken te zijn. En als onze plannen onoptimale monitoringseigenschappen vertonen, kunnen we deze anomalieën zien. Bijvoorbeeld, als de gegevens significant zijn veranderd en samen met de index een sequentiële doorloop door de tabel is gaan gebruiken, dat wil zeggen, als de query slechts 100 rijen moet retourneren (met een limit van 100), wordt er een volledige doorloop uitgevoerd. Dit heeft altijd een negatieve invloed op de prestaties.
En we kunnen dit in de monitoring zien. We kunnen dit verzoek bekijken, een explain ervoor uitvoeren, statistieken verzamelen, een nieuwe extra index opbouwen. En al reageren op dit probleem. Daarom is het belangrijk.
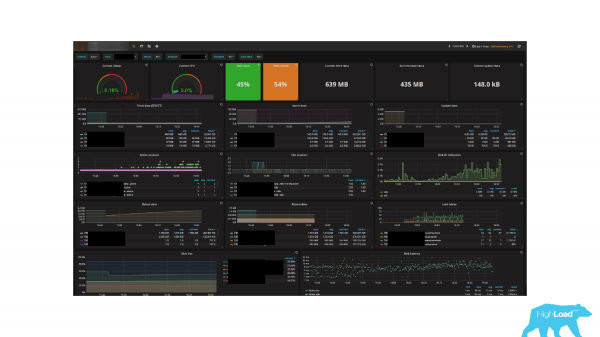
Een ander voorbeeld van monitoring. Ik denk dat velen dit zullen herkennen, omdat het erg populair is. Wie het in hun projecten gebruikt. ? А кто использует этот продукт совместно с Prometheus? Дело в том, что в стандартном репозитории этого мониторинга есть дашборд для работы с PostgreSQL – Prometheus. Maar er is één nadeel.
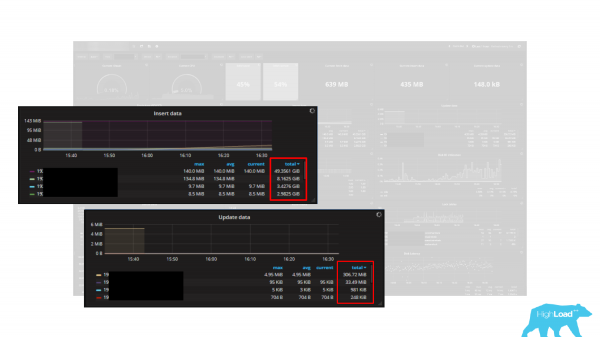
Er zijn verschillende grafieken. En als eenheid zijn bytes aangegeven, dat wil zeggen, er zijn 5 grafieken. Dit zijn Insert data, Update data, Delete data, Fetch data en Return data. Als eenheid van meting zijn bytes aangegeven. Maar het probleem is dat de statistieken in PostgreSQL gegevens in tuples teruggeven (rijen). En, bijgevolg, deze grafieken zijn een zeer goede manier om uw workload meerdere keren, in sommige gevallen tientallen keren, te verlagen, omdat een tuple geen byte is, een tuple is een rij, dat is veel bytes en het is altijd van variabele lengte. Dat wil zeggen, het berekenen van de workload in bytes met behulp van tuples is een onmogelijke of zeer complexe taak. Daarom is het altijd belangrijk om te begrijpen dat wanneer u een dashboard of ingebouwde monitoring gebruikt, het correct werkt en u de juiste gegevens teruggeeft.
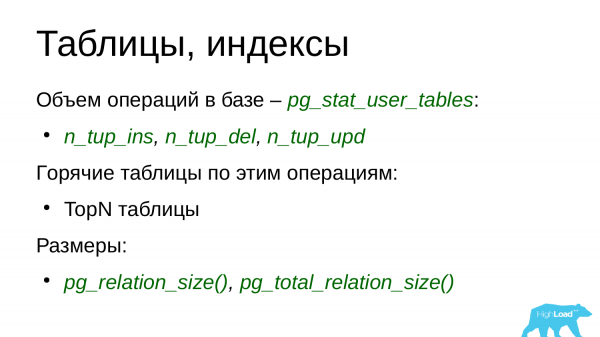
Hoe kunt u statistieken over deze tabellen krijgen? Hiervoor heeft PostgreSQL een reeks views. En de belangrijkste view is . User_tables – dit betekent dat de tabellen zijn gemaakt namens de gebruiker. In tegenstelling tot de systeemviews die door PostgreSQL zelf worden gebruikt. En er is een samenvattende tabel Alltables die zowel systeem- als gebruikersgegevens omvat. U kunt zich baseren op een van hen, afhankelijk van wat u het leukst vindt.
Op basis van de bovengenoemde velden kunt u het aantal inserts, updates en deletes inschatten. Het voorbeelddashboard dat ik heb gebruikt, maakt gebruik van deze velden om de kenmerken van de workload te beoordelen. Daarom kunnen we ons ook op hen baseren. Maar het is belangrijk te onthouden dat dit tuples zijn en geen bytes, daarom kunnen we dit niet gewoon in bytes omzetten.
Op basis van deze gegevens kunnen we zogenaamde TopN-tabellen opstellen. Bijvoorbeeld, Top-5, Top-10. En we kunnen de 'warme' tabellen volgen die meer worden gebruikt dan andere. Bijvoorbeeld, de 5 'warme' tabellen voor invoer. En op basis van deze TopN-tabellen beoordelen we onze workload en kunnen we pieken in de workload inschatten na verschillende releases, updates en deployments.
Het is ook belangrijk om de grootte van de tabellen te evalueren, omdat ontwikkelaars soms nieuwe functies uitrollen en onze tabellen beginnen te groeien in omvang, omdat ze besluiten om extra gegevens toe te voegen zonder rekening te houden met de impact op de databasematen. Dergelijke gevallen zijn vaak verrassingen voor ons.
En nu een kleine vraag voor u. Welke vraag komt in u op wanneer u een belasting op de database-server opmerkt? Wat is de volgende vraag die u zich stelt?
Maar eigenlijk is de volgende vraag: welke query's veroorzaken de belasting? Het is niet interessant om naar de processen te kijken die de belasting veroorzaken. Het is duidelijk dat als er een host met een database is, de database actief is en dat alleen databases daar gebruik van zullen maken. Als we Top openen, zullen we een lijst van processen in PostgreSQL zien die iets doen. Maar uit Top is het niet duidelijk wat ze precies doen.
Daarom moeten we de query's identificeren die de grootste belasting veroorzaken, want het tunen van query's levert over het algemeen meer winst op dan het tunen van de configuratie van PostgreSQL of het besturingssysteem, of zelfs het tunen van de hardware. Naar mijn schatting is dat ongeveer 80-85-90%. En dit gaat veel sneller. Het is sneller om een query te corrigeren dan om de configuratie aan te passen, een herstart te plannen, vooral als de database niet opnieuw kan worden opgestart, of om hardware toe te voegen. Het is eenvoudiger om een query ergens wat te herschrijven of een index toe te voegen om al betere resultaten uit die query te halen.
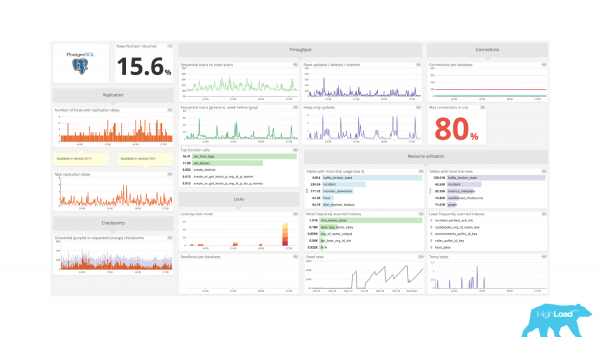
Daarom is het noodzakelijk om de query's en hun geschiktheid te monitoren. Laten we een ander voorbeeld van monitoring bekijken. En ook hier lijkt de monitoring goed. Er is informatie over replicatie, er is informatie over de doorvoersnelheid, blokkeringen, resource-utilisatie. Alles prima, maar er is geen informatie over de query's. Het is niet duidelijk welke query's worden uitgevoerd in onze database, hoe lang ze duren en hoeveel van deze query's er zijn. We moeten deze informatie altijd hebben in de monitoring.
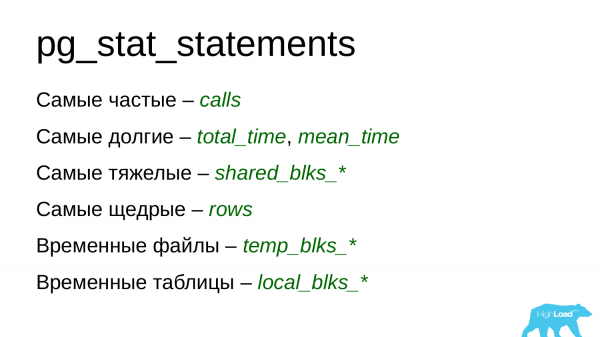
En om deze informatie te verkrijgen, kunnen we de module pg_stat_statements gebruiken. Hierop kunnen de meest uiteenlopende grafieken worden gebaseerd. Zo kunnen we informatie krijgen over de meest voorkomende queries, dat wil zeggen de queries die het vaakst worden uitgevoerd. Ja, na deploys is het ook zeer nuttig om hiernaar te kijken en te begrijpen of er een piek in het aantal queries is.
We kunnen de langste queries monitoren, dat wil zeggen de queries die het langst duren. Ze belasten de processor en verbruiken I/O. Dit kunnen we ook evalueren aan de hand van de velden total_time, mean_time, blk_write_time en blk_read_time.
We kunnen de zwaarste queries qua middelen gebruiken, die lezen van de schijf, die met geheugen werken of die, omgekeerd, een schrijflast creëren.
We kunnen de meest genereuze queries evalueren. Dit zijn de queries die een groot aantal rijen teruggeven. Bijvoorbeeld, dit kan een query zijn waarin men vergeten is een limiet in te stellen. En deze geeft gewoon de volledige inhoud van de tabel of de gevraagde tabellen terug.
En we kunnen ook queries monitoren die tijdelijke bestanden of tijdelijke tabellen gebruiken.
En we hebben achtergrondprocessen. Achtergrondprocessen zijn in de eerste plaats checkpunten, ook wel controlepunten genoemd, autovacuum en replicatie.
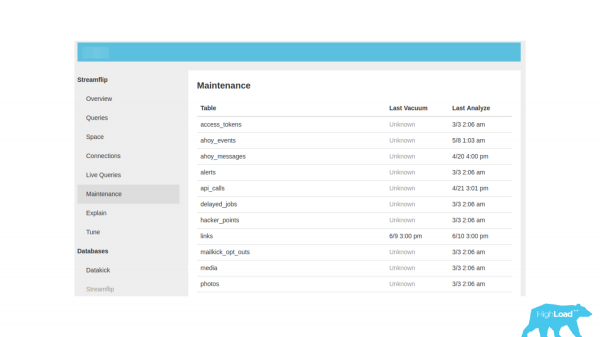
Een ander voorbeeld van monitoring. Aan de linkerkant is er een tabblad Onderhoud, we gaan daarheen en hopen iets nuttigs te zien. Maar hier is alleen de werktijd van de vacuum- en statistiekverzamelingen, verder niets. Dit is erg beperkte informatie, daarom moeten we altijd informatie hebben over de werking van de achtergrondprocessen in onze database en of er zich geen problemen voordoen door hun werking.
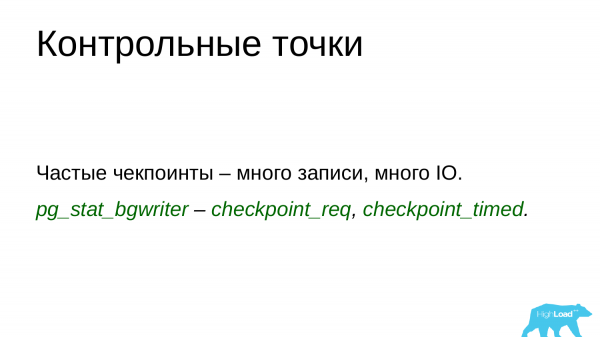
Wanneer we naar controlepunten kijken, moeten we ons ervan bewust zijn dat controlepunten 'vuile' pagina's uit het shard-geheugen naar de schijf wegschrijven, en dan een controlepunt creëren. En dit controlepunt kan vervolgens worden gebruikt als een soort plaats voor herstel, mocht PostgreSQL plotseling ongepland worden afgesloten.
Om alle 'vuile' pagina's op de schijf te resetten, moet er een bepaalde hoeveelheid schrijven plaatsvinden. En meestal is dat op systemen met veel geheugen - dat is heel veel. En als we checkpoints heel vaak binnen een korte periode maken, zal de schijfsnelheid aanzienlijk verminderen. Klantverzoeken zullen lijden onder een tekort aan middelen. Ze zullen concurreren om bronnen en zullen tekortkomen in prestaties.
Via pg_stat_bgwriter kunnen we, aan de hand van de opgegeven velden, het aantal voorkomende checkpoints monitoren. En als we in een bepaalde tijdsperiode (bijvoorbeeld 10-15-20 minuten, een half uur) veel checkpoints hebben, bijvoorbeeld 3-4-5, dan kan dat al een probleem zijn. Dan moeten we in de database kijken en de configuratie bekijken om te begrijpen wat zo’n overvloed aan checkpoints veroorzaakt. Misschien is er een grote schrijfactie aan de gang. Aan de hand van de werklast kunnen we al inschatten, omdat we grafieken van de werklast al hebben toegevoegd. We kunnen de parameters voor checkpoints optimaliseren en ervoor zorgen dat ze de prestatie van aanvragen niet sterk beïnvloeden.
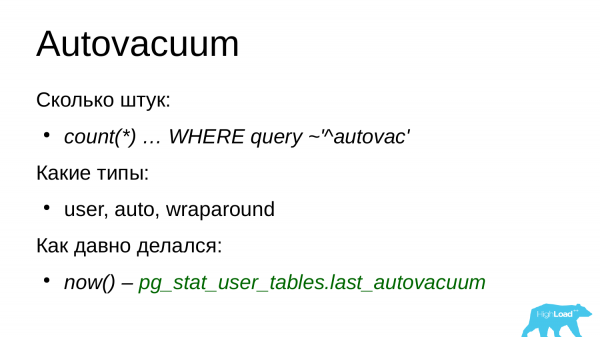
Ik kom weer terug op de autovacuum, omdat dit zo'n ding is, zoals ik al zei, dat de prestaties van zowel de schijven als de aanvragen aanzienlijk kan beïnvloeden. Het is dus altijd belangrijk om het aantal autovacuum te evalueren.
Het aantal autovacuum-werkers in de database is beperkt. Standaard zijn er drie, dus als er continu drie werkers in de database draaien, betekent dit dat de autovacuum niet goed is ingesteld, en dat er limieten moeten worden verhoogd en de autovacuum-instellingen moeten worden herzien.
Het is belangrijk om te beoordelen welke vacuumwerkers actief zijn. Ofwel is het gestart door een gebruiker, waarbij de DBA handmatig een vacuum heeft gestart, wat een belasting heeft gecreëerd. We hebben dan een probleem. Of het aantal vacuums dat de transactie-teller vermindert. Voor sommige versies van PostgreSQL zijn dit zeer zware vacuums. Ze kunnen eenvoudigweg de prestaties verminderen, omdat ze de hele tabel doornemen en alle blokken in die tabel scannen.
En natuurlijk de duur van de vacuumprocessen. Als we lange vacuumprocessen hebben die zeer lange tijd draaien, betekent dit dat we opnieuw moeten kijken naar de configuratie van het vacuum en mogelijk de instellingen moeten herzien. Omdat er een situatie kan ontstaan waarin het vacuum lange tijd aan een tabel werkt (3-4 uur), maar gedurende de werking van het vacuum zich weer een grote hoeveelheid dode rijen in de tabel heeft verzameld. En zodra het vacuum klaar is, moet het deze tabel opnieuw vacuumen. En we komen in een situatie van een eindeloos vacuum. In dat geval is het vacuum niet in staat om zijn taak uit te voeren, en beginnen de tabellen geleidelijk aan te groeien in grootte, terwijl het volume aan nuttige gegevens gelijk blijft. Daarom bekijken we bij lange vacuumprocessen altijd de configuratie en proberen we deze te optimaliseren, zonder dat de prestaties van klantverzoeken daaronder lijden.
Tegenwoordig is er bijna geen enkel PostgreSQL-installatie zonder streaming replicatie. Replicatie is het proces van het overdragen van gegevens van de master naar de replica.
Replicatie in PostgreSQL is opgezet via het transactie-log. De master genereert een transactie-log. Het transactie-log wordt via een netwerkverbinding naar de replica verzonden en daar opnieuw afgespeeld. Heel eenvoudig.
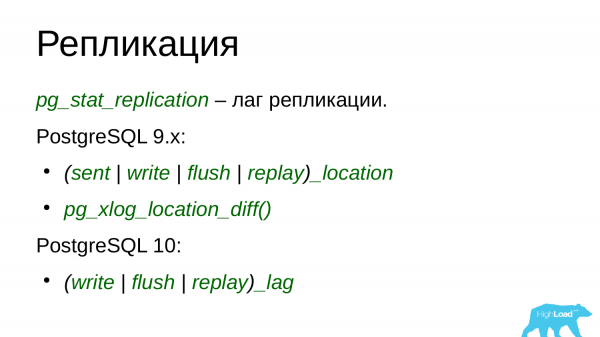
Voor het monitoren van de replicatie-lag wordt de weergave pg_stat_replication gebruikt. Maar daarmee is niet alles eenvoudig. In versie 10 heeft de weergave enkele wijzigingen ondergaan. Ten eerste zijn sommige velden hernoemd. En er zijn nieuwe velden toegevoegd. In versie 10 zijn er velden die het mogelijk maken om de replicatie-lag in seconden te beoordelen. Dat is erg handig. Voor versie 10 was het mogelijk om de replicatie-lag in bytes te beoordelen. Deze mogelijkheid is ook in versie 10 gebleven, dus je kunt kiezen wat handiger voor je is - de lag in bytes of in seconden beoordelen. Veel mensen doen beide.
Toch is het nodig om de positie van het log in de transactie te kennen om de replicatie-lag te kunnen beoordelen. Deze posities van het transactie-log zijn precies beschikbaar in de weergave pg_stat_replication. Voor eenvoudig gebruik kunnen we met de functie pg_xlog_location_diff() twee punten in het transactie-log nemen. We kunnen de delta tussen deze punten berekenen en de replicatie-lag in bytes krijgen. Dat is erg handig en eenvoudig.
In versie 10 is deze functie hernoemd naar pg_wal_lsn_diff(). Over het algemeen is in alle functies, views en hulpprogramma's waar het woord "xlog" voorkwam, het vervangen door "wal". Dit geldt zowel voor views als functies. Dit is een dergelijke vernieuwing.
Bovendien zijn er in versie 10 regels toegevoegd die specifiek de lag weergeven. Dit zijn write lag, flush lag en replay lag. Dit zijn belangrijke dingen om te monitoren. Als we zien dat er een replicatie lag is, moeten we onderzoeken waarom dit is ontstaan, waar het vandaan komt en het probleem verhelpen.
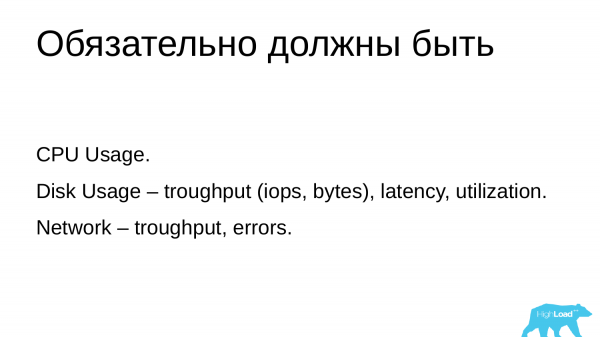
Met de systeemprestaties is bijna alles in orde. Wanneer monitoring opstart, begint het met systeemprestaties. Dit omvat CPU-gebruik, geheugengebruik, swap, netwerk en schijf. Desondanks zijn veel parameters daar standaard niet aanwezig.
Als het proces-gebruik in orde is, zijn er problemen met het schijfgebruik. Over het algemeen voegen ontwikkelaars van monitoringinformatie informatie over de doorvoer toe. Dit kan in IOPS of bytes zijn. Maar ze vergeten latentie en het gebruik van schijfapparaten. Dit zijn belangrijkere parameters die toelaten te beoordelen hoe druk de schijven zijn en hoezeer ze vertraging veroorzaken. Als we hoge latentie hebben, betekent dit dat er problemen zijn met de schijven. Als we hoge benutting hebben, betekent dit dat de schijven het niet aankunnen. Dit zijn kwalitatief betere kenmerken dan de doorvoer.
Hoewel deze statistieken ook uit het bestandssysteem /proc kunnen worden gehaald, zoals dat gebeurt voor CPU-gebruik. Waarom deze informatie niet in de monitoring wordt opgenomen, weet ik niet. Desondanks is het belangrijk om dit in uw monitoring te hebben.
Hetzelfde geldt voor netwerkinterfaces. Er is informatie over de netwerkdoorvoer in pakketten en bytes, maar er is geen informatie over latentie en geen informatie over gebruik, hoewel dat ook nuttige informatie is.
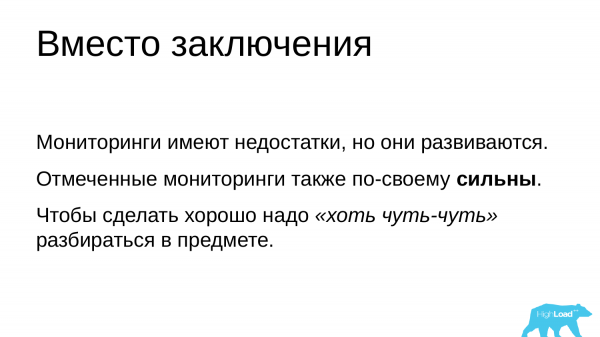
Alle monitoringsystemen hebben tekortkomingen. En welke monitoring u ook kiest, het zal altijd niet aan bepaalde criteria voldoen. Desondanks ontwikkelen ze zich, worden nieuwe functies en nieuwe dingen toegevoegd, dus kies iets en pas het aan.
En om verder te gaan verbeteren, moet u altijd begrijpen wat de statistieken betekenen die worden weergegeven en hoe u ze kunt gebruiken om problemen op te lossen.
En een paar belangrijke punten:
- Het is altijd belangrijk om de beschikbaarheid te monitoren, dashboards te hebben zodat u snel kunt beoordelen of alles in orde is met uw database.
- U moet altijd een beeld hebben van welke klanten met uw database werken, zodat u slechte klanten kunt filteren en ze kunt uitsluiten.
- Het is belangrijk om te beoordelen hoe deze klanten met de gegevens omgaan. U moet een beeld hebben van uw werklast.
- Het is belangrijk om te evalueren hoe deze werklast wordt gevormd, met welke verzoeken. U kunt de verzoeken beoordelen, optimaliseren, refactoren en indexen voor hen opstellen. Dit is van groot belang.
- Achtergrondprocessen kunnen een negatieve invloed hebben op klantverzoeken, daarom is het belangrijk om te monitoren dat ze niet te veel middelen gebruiken.
- Systeemprestaties stellen u in staat om plannen te maken voor schaalvergroting, voor het verhogen van de capaciteit van uw servers, daarom is het ook belangrijk om deze te volgen en te evalueren.
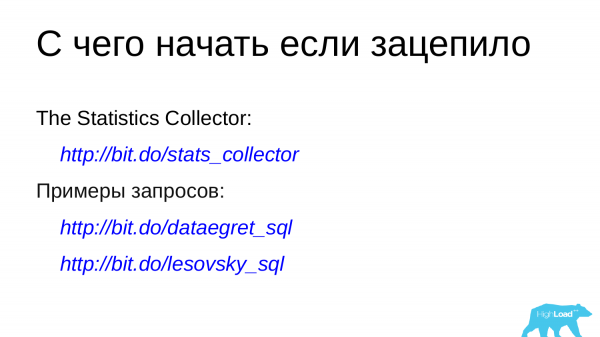
Als u geïnteresseerd bent in dit onderwerp, kunt u de volgende links bekijken.
— dit is de officiële documentatie van de statistiekverzamelaars. Hierin staan beschrijvingen van alle statistische views en van alle velden. U kunt ze lezen, begrijpen en analyseren. Op basis daarvan kunt u uw grafieken opstellen en aan uw monitoring toevoegen.
Voorbeelden van verzoeken:
Dit is onze bedrijfsrepository en mijn persoonlijke repository. Hierin staan voorbeelden van verzoeken. Er zijn geen verzoeken van het type select * from iets. Er staan al kant-en-klare verzoeken in met joins, met het gebruik van interessante functies die het mogelijk maken om rauwe cijfers om te zetten in leesbare, bruikbare waarden, dat wil zeggen, bytes, tijd. U kunt ze bekijken, analyseren, ze toevoegen aan uw monitoring en op basis daarvan uw monitoring opstellen.
Vragen
Vraag: U zei dat u geen merken zou promoten, maar ik ben toch benieuwd – welke dashboards gebruikt u in uw projecten?
Antwoord: Dat verschilt. Soms komen we bij een klant en heeft hij al zijn eigen monitoring. En we adviseren de klant over wat er aan zijn monitoring moet worden toegevoegd. De situatie met Zabbiх is het slechtst. Want die hebben geen mogelijkheid om TopN-grafieken te maken. Wij zelf gebruiken , omdat we deze jongens hebben geadviseerd over monitoring. Ze hebben monitoring voor PostgreSQL gemaakt op basis van onze specificaties. Ik schrijf mijn eigen pet-project, dat gegevens verzamelt via Prometheus en ze visualiseert in Ik ben bezig met het maken van mijn eigen exporter in Prometheus en daarna alles weergeven in Grafana.
Vraag: Zijn er alternatieven voor AWR-rapporten of ... aggregatie? Weet je iets dergelijks?
Antwoord: Ja, ik weet wat AWR is, het is een geweldige tool. Op dit moment zijn er verschillende implementaties die ongeveer hetzelfde model volgen. Met een bepaalde tijdsintervallen worden er baselines geschreven naar dezelfde PostgreSQL of naar een aparte opslag. Je kunt ze online vinden, ze bestaan. Een van de ontwikkelaars van zo'n tool is actief op het forum sql.ru in de PostgreSQL-thread. Je kunt hem daar bereiken. Ja, zulke dingen bestaan en kunnen worden gebruikt. Bovendien, in mijn schrijf ik ook een project dat hetzelfde doet.
P.S.1 Als je postgres_exporter gebruikt, welke dashboard gebruik je dan? Er zijn er verschillende. Ze zijn inmiddels verouderd. Misschien kan de community een bijgewerkt sjabloon maken?
P.S.2 Ik heb pganalyze verwijderd, omdat het een propriëtaire SaaS-oplossing is die zich richt op prestatiemonitoring en geautomatiseerde tuningvoorstellen.
Alleen geregistreerde gebruikers kunnen deelnemen aan de enquête. , alstublieft.
Wat beschouw je als de beste self-hosted monitoring voor PostgreSQL (met dashboard)?
30,0%Zabbix + plug-ins van Alexey Lesovsky of zabbix 4.4 of libzbxpgsql + zabbix libzbxpgsql + zabbix3
0,0%https://github.com/lesovsky/pgcenter0
0,0%https://github.com/pg-monz/pg_monz0
20,0%https://github.com/cybertec-postgresql/pgwatch22
20,0%https://github.com/postgrespro/mamonsu2
0,0%https://www.percona.com/doc/percona-monitoring-and-management/conf-postgres.html0
10,0%pganalyze is een propriëtaire SaaS — kan ik niet verwijderen
10,0%https://github.com/powa-team/powa1
0,0%https://github.com/darold/pgbadger0
0,0%https://github.com/darold/pgcluu0
0,0%https://github.com/zalando/PGObserver0
10,0%https://github.com/spotify/postgresql-metrics1
Er hebben 10 gebruikers gestemd. 26 gebruikers hebben zich onthouden.
Bron: habr.com
