

Hallo vrienden. Voor we naar het tweede deel van de meivakantie gaan, delen we een materiaal met jullie dat we hebben vertaald ter voorbereiding op de lancering van een nieuwe stroom in de cursus. .
Applicatieontwikkelaars besteden veel tijd aan het vergelijken van verschillende operationele databases om de juiste te kiezen die het beste past bij de verwachte werklast. De behoeften kunnen onder andere vereenvoudigd datamodellering, transactionele garanties, lees-/schrijfsnelheid, horizontale schaalbaarheid en fouttolerantie omvatten. Traditioneel begint de keuze met de categorie database, SQL of NoSQL, aangezien elke categorie een duidelijk pakket aan compromissen biedt. Hoge prestaties in termen van lage latentie en hoge doorvoer worden doorgaans gezien als een ononderhandelbare vereiste en zijn daarom essentieel voor elke database in de selectie.
Het doel van dit artikel is om applicatieontwikkelaars te helpen de juiste keuze te maken tussen SQL en NoSQL in de context van datamodellering. We zullen één SQL-database behandelen, namelijk PostgreSQL, en twee NoSQL-databases – Cassandra en MongoDB – om de basisprincipes van databaseontwerp te bespreken, zoals het aanmaken van tabellen, het invullen ervan, gegevens uit tabellen lezen en die gegevens verwijderen. In het volgende artikel zullen we zeker ingaan op indexen, transacties, JOINs, TTL-richtlijnen en databaseontwerp op basis van JSON.
Wat is het verschil tussen SQL en NoSQL?
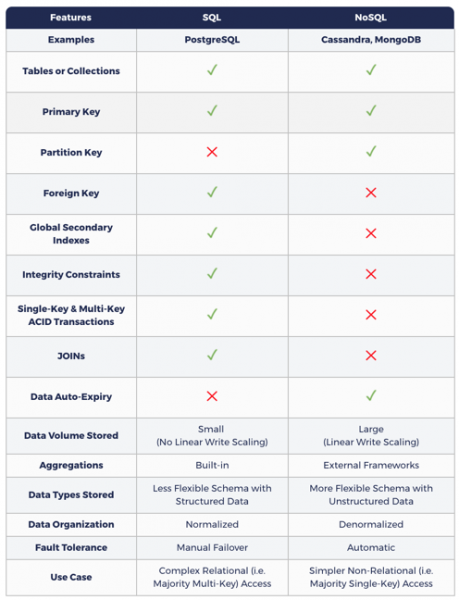
SQL-databases verhogen de flexibiliteit van de applicatie dankzij transactionele ACID-garanties en door de mogelijkheid om gegevens op onverwachte manieren te queryen met JOIN op bestaande genormaliseerde modellen van relationele databases.
Gezien hun monolithische/één-node-architectuur en het gebruik van een master-slave replicatiemodel voor redundantie, missen traditionele SQL-databases twee belangrijke functies: lineaire schrijfschaalbaarheid (d.w.z. automatische splitsing over meerdere nodes) en automatische/dataverlies op nul. Dit betekent dat de hoeveelheid binnenkomende gegevens de maximale opnamecapaciteit van één node niet mag overschrijden. Bovendien moet rekening worden gehouden met een tijdelijke gegevensverliezen bij failover (in een architectuur zonder resource-splitsing). Hier moet worden opgemerkt dat recente commits nog niet zijn weerspiegeld in de slave-kopie. Downtime-vrije updates zijn ook moeilijk te bereiken in SQL-databases.
NoSQL-databases zijn van nature meestal gedistribueerd, wat betekent dat gegevens in secties worden verdeeld en over meerdere nodes worden verspreid. Ze vereisen denormalisatie. Dit houdt in dat ingevoerde gegevens ook meerdere keren moeten worden gekopieerd om te voldoen aan specifieke queries die je verzendt. Het algemene doel is om hoge prestaties te behalen door het aantal shards dat beschikbaar is bij het lezen te verminderen. Hieruit volgt de stelling dat NoSQL je dwingt om je queries te modelleren, terwijl SQL je dwingt om je gegevens te modelleren.
NoSQL legt de nadruk op het bereiken van hoge prestaties in een gedistribueerd cluster, wat de belangrijkste rechtvaardiging is voor veel ontwerpcompromissen in databases, waaronder het verlies van ACID-transactiek garanties, JOINs en consistente globale secundaire indexen.
Er is de mening dat, hoewel NoSQL-databases lineaire schrijfschaalbaarheid en hoge fouttolerantie bieden, het verlies van transactiegemakken ze ongeschikt maakt voor kritieke gegevens.
De volgende tabel toont aan hoe datamodellering in NoSQL verschilt van SQL.
SQL en NoSQL: Waarom zijn ze beide nodig?
Op echte toepassingen met een groot aantal gebruikers, zoals Amazon.com, Netflix, Uber en Airbnb, rust het uitvoeren van complexe, diverse taken. Bijvoorbeeld, een e-commerce toepassing zoals Amazon.com moet lichte, zeer kritische gegevens opslaan, zoals informatie over gebruikers, producten, orders, facturen, naast zwaardere, maar minder gevoelige gegevens zoals productbeoordelingen, klantenserviceberichten, gebruikersactiviteit, reviews en aanbevelingen van gebruikers. Natuurlijk vertrouwen deze toepassingen op ten minste één SQL-database, samen met minimaal één NoSQL-database. In interregionale en mondiale systemen fungeert de NoSQL-database als een geo-distribueerde cache voor gegevens die in een vertrouwde bron worden opgeslagen, een SQL-database die in één regio werkt.
Hoe combineert YugaByte DB SQL en NoSQL?
Gebouwd op een log-georiënteerde hybride opslag-engine voor autoscharding, sharding-gedistribueerde consensusreplicatie en gedistribueerde ACID-transacties (geïnspireerd door Google Spanner), is YugaByte DB de eerste open-source database ter wereld die tegelijkertijd compatibel is met NoSQL (Cassandra & Redis) en SQL (PostgreSQL). Zoals te zien is in de onderstaande tabel, voegt YCQL, de API van YugaByte DB die compatibel is met Cassandra, het concept van enkele en meervoudige ACID-transacties en wereldwijde secundaire indexen toe aan de NoSQL API, waardoor het tijdperk van transactionele NoSQL-databases wordt geopend. Daarnaast voegt YCQL, de API van YugaByte DB die compatibel is met PostgreSQL, het concept van lineaire schaalbaarheid van schrijfoperaties en automatische fouttolerantie toe aan de SQL API, waarmee gedistribueerde SQL-databases aan de wereld worden gepresenteerd. Aangezien de database YugaByte DB in wezen transactioneel is, kan de NoSQL API nu worden gebruikt in de context van kritieke gegevens.
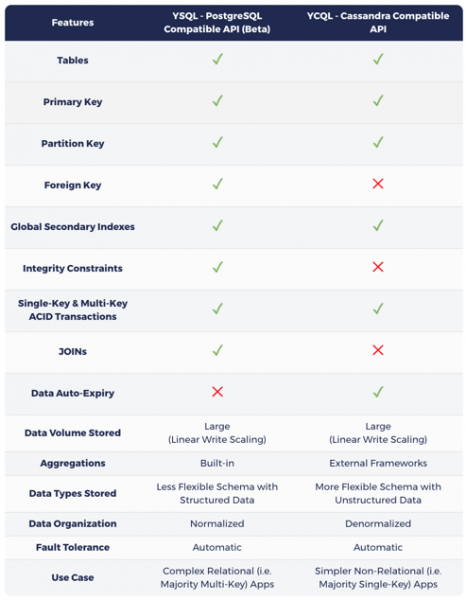
Zoals eerder vermeld in het artikel , de keuze tussen SQL of NoSQL in YugaByte DB hangt volledig af van de kenmerken van de onderliggende werklast:
- Als de onderliggende werklast voornamelijk meervoudige JOIN-operaties omvat, begrijp dan bij het kiezen van YSQL dat uw sleutels over meerdere knooppunten kunnen worden verdeeld, wat kan leiden tot hogere latenties en/of lagere doorvoersnelheden dan in NoSQL.
- Anders, kies een van de twee NoSQL API's, houd er rekening mee dat je betere prestaties krijgt van queries die van één node tegelijk worden bediend. YugaByte DB kan dienen als de enige operationele database voor echte complexe applicaties waar meerdere werkbelastingen tegelijk beheerd moeten worden.
In het volgende gedeelte van het data-modellaboratorium zijn de API's van de YugaByte DB databases compatibel met PostgreSQL en Cassandra, in tegenstelling tot de oorspronkelijke databases. Deze benadering benadrukt de eenvoud van interactie met twee verschillende API's (op twee verschillende poorten) van dezelfde databasecluster in plaats van het gebruik van volledig onafhankelijke clusters van twee verschillende databases.
In de volgende secties zullen we het data-modellaboratorium verkennen om het verschil en enkele overeenkomsten van de onderzochte databases te illustreren.
Data-modellaboratorium
Database-installatie
Gezien de focus op het ontwerpen van datamodellen (en niet op complexe uitrolarchitecturen), zullen we de databases in Docker-containers op de lokale computer installeren en vervolgens ermee interageren via de bijbehorende commandoregelomgevingen.
Compatibel met PostgreSQL & Cassandra, de YugaByte DB database
mkdir ~/yugabyte && cd ~/yugabyte
wget https://downloads.yugabyte.com/yb-docker-ctl && chmod +x yb-docker-ctl
docker pull yugabytedb/yugabyte
./yb-docker-ctl create --enable_postgres
MongoDB
docker run --name my-mongo -d mongo:latestToegang via de commandoregel
Laten we verbinding maken met de databases met behulp van de commandoregelomgeving voor de bijbehorende API's.
PostgreSQL
— is de commandoregelomgeving voor interactie met PostgreSQL. Voor gebruiksgemak komt YugaByte DB met psql direct in de bin-map.
docker exec -it yb-postgres-n1 /home/yugabyte/postgres/bin/psql -p 5433 -U postgresCassandra
— is de commandoregelomgeving voor interactie met Cassandra en zijn compatibele databases via CQL (Cassandra Query Language). Voor gebruiksgemak komt YugaByte DB met cqlsh in de catalogus bin.
Let op dat CQL geïnspireerd is door SQL en vergelijkbare concepten van tabellen, rijen, kolommen en indexen heeft. Als een NoSQL-taal voegt het echter een bepaalde reeks beperkingen toe, waarvan de meeste we ook in andere artikelen zullen behandelen.
docker exec -it yb-tserver-n1 /home/yugabyte/bin/cqlshMongoDB
– is een commandoregelinterface om met MongoDB te communiceren. Deze is te vinden in de bin-map van de MongoDB-installatie.
docker exec -it my-mongo bash
cd bin
mongo
Tabel aanmaken
Nu kunnen we met de database communiceren om verschillende bewerkingen uit te voeren via de commandoregel. Laten we beginnen met het aanmaken van een tabel die informatie over nummers van verschillende artiesten opslaat. Deze nummers kunnen deel uitmaken van een album. Optionele attributen voor een nummer zijn het jaar van uitgave, prijs, genre en beoordeling. We moeten rekening houden met extra attributen die in de toekomst nodig kunnen zijn, via het veld "tags". Dit kan semi-gestructureerde gegevens opslaan in de vorm van sleutel-waardeparen.
PostgreSQL
CREATE TABLE Music (
    Artist VARCHAR(20) NOT NULL,
    SongTitle VARCHAR(30) NOT NULL,
    AlbumTitle VARCHAR(25),
    Year INT,
    Price FLOAT,
    Genre VARCHAR(10),
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
Cassandra
Het aanmaken van een tabel in Cassandra lijkt sterk op PostgreSQL. Een van de belangrijkste verschillen is het ontbreken van integriteitsbeperkingen (zoals NOT NULL), maar dit valt onder de verantwoordelijkheid van de applicatie en niet van de NoSQL-database.. De primaire sleutel bestaat uit de partitie-sleutel (de kolom Artist in het onderstaande voorbeeld) en een set van clusteringkolommen (de kolom SongTitle in het onderstaande voorbeeld). De partitie-sleutel bepaalt in welke partitie/shard de rij moet worden geplaatst, terwijl de clusteringkolommen aangeven hoe de gegevens binnen de huidige shard moeten worden georganiseerd.
CREATE KEYSPACE myapp;
USE myapp;
CREATE TABLE Music (
    Artist TEXT,
    SongTitle TEXT,
    AlbumTitle TEXT,
    Year INT,
    Price FLOAT,
    Genre TEXT,
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
MongoDB
MongoDB organiseert gegevens in databases (Database) (vergelijkbaar met Keyspace in Cassandra), waar er collecties (Collections) zijn (vergelijkbaar met tabellen), waarin documenten (Documents) liggen (vergelijkbaar met rijen in een tabel). In MongoDB is het in principe niet nodig om een initiële schema-definitie op te stellen. Het commando "use database", zoals hieronder weergegeven, maakt een database-exemplaar aan bij de eerste oproep en verandert de context naar de zojuist aangemaakte database. Zelfs collecties hoeven niet expliciet te worden aangemaakt, ze worden automatisch aangemaakt bij het toevoegen van het eerste document aan een nieuwe collectie. Houd er rekening mee dat MongoDB standaard de testdatabase gebruikt, dus elke actie op het niveau van collecties zonder een specifieke database op te geven, zal standaard in die database worden uitgevoerd.
use myNewDatabase;Verkrijgen van informatie over de tabel
PostgreSQL
d Muziek
Tabel "public.music"
    Kolom     |         Type          | Collatie | Nullbaar | Standaard
--------------+-----------------------+-----------+----------+--------
 artiest      | karakter variërend(20) |           | niet null |
 nummertitel  | karakter variërend(30) |           | niet null |
 albumtitel   | karakter variërend(25) |           |          |
 jaar         | integer               |           |          |
 prijs        | dubbele precisie      |           |          |
 genre        | karakter variërend(10) |           |          |
 criticrating | dubbele precisie      |           |          |
 tags         | tekst                 |           |          |
Index:
    "music_pkey" PRIMAIRE SLEUTEL, btree (artiest, nummertitel)
Cassandra
BESCHRIJF TABEL MUZIEK;
CREËER TABEL myapp.music (
    artiest tekst,
    nummertitel tekst,
    albumtitel tekst,
    jaar int,
    prijs float,
    genre tekst,
    tags tekst,
    PRIMAIRE SLEUTEL (artiest, nummertitel)
) MET CLUSTERINGSVOLG VOLGENS (nummertitel ASC)
    EN standaard_tijd_tot_leven = 0
    EN transacties = {'enabled': 'false'};
MongoDB
gebruik myNewDatabase;
toon collecties;
Gegevens invoeren in de tabel
PostgreSQL
INSERT INTO Muziek
    (Artiest, NummerTitel, AlbumTitel,
    Jaar, Prijs, Genre, CriticRating,
    Tags)
WAARDEN(
    'No One You Know', 'Call Me Today', 'Somewhat Famous',
    2015, 2.14, 'Country', 7.8,
    '{"Componisten": ["Smith", "Jones", "Davis"],"LengteInSeconden": 214}'
);
INSERT INTO Muziek
    (Artiest, NummerTitel, AlbumTitel,
    Prijs, Genre, CriticRating)
WAARDEN(
    'No One You Know', 'My Dog Spot', 'Hey Now',
    1.98, 'Country', 8.4
);
INSERT INTO Muziek
    (Artiest, NummerTitel, AlbumTitel,
    Prijs, Genre)
WAARDEN(
    'The Acme Band', 'Look Out, World', 'The Buck Starts Here',
    0.99, 'Rock'
);
INSERT INTO Muziek
    (Artiest, NummerTitel, AlbumTitel,
    Prijs, Genre,
    Tags)
WAARDEN(
    'The Acme Band', 'Still In Love', 'The Buck Starts Here',
    2.47, 'Rock',
    '{"radioStationsPlaying": ["KHCR", "KBQX", "WTNR", "WJJH"], "tourDates": { "Seattle": "20150625", "Cleveland": "20150630"}, "rotation": Heavy}'
);
Cassandra
Over het algemeen lijkt de expressie INSERT in Cassandra erg op de overeenkomstige in PostgreSQL. Echter, er is één groot verschil in semantiek. In Cassandra INSERT is het feitelijk een operatie UPSERT, waarbij de laatste waarden aan de rij worden toegevoegd als de rij al bestaat.
Gegevensinvoer gebeurt op een vergelijkbare manier als in PostgreSQL
INSERTboven
.
MongoDB
Hoewel MongoDB een NoSQL-database is, vergelijkbaar met Cassandra, heeft de gegevensinvoering er niets mee te maken met het semantische gedrag in Cassandra. In MongoDB heeft geen mogelijkheden UPSERT, wat het meer op PostgreSQL doet lijken. Het standaard toevoegen van gegevens zonder _idspecified leidt tot het toevoegen van een nieuw document aan de collectie.
db.music.insert( {
 artist: "Geen Niemand Die Je Kent",
 songTitle: "Bel Me Vandaag",
 albumTitle: "Enigszins Beroemd",
 year: 2015,
 price: 2.14,
 genre: "Country",
 tags: {
 Componisten: ["Smith", "Jones", "Davis"],
 LengthInSeconds: 214
 }
 }
 );
 db.music.insert( {
 artist: "Geen Niemand Die Je Kent",
 songTitle: "Mijn Hond Spot",
 albumTitle: "Hey Nu",
 price: 1.98,
 genre: "Country",
 criticRating: 8.4
 }
 );
 db.music.insert( {
 artist: "The Acme Band",
 songTitle: "Kijk Uit, Wereld",
 albumTitle:"De Dollar Begint Hier",
 price: 0.99,
 genre: "Rock"
 }
 );
 db.music.insert( {
 artist: "The Acme Band",
 songTitle: "Nog Steeds Verliefd",
 albumTitle:"De Dollar Begint Hier",
 price: 2.47,
 genre: "Rock",
 tags: {
 radioStationsPlaying:["KHCR", "KBQX", "WTNR", "WJJH"],
 tourDates: {
 Seattle: "20150625",
 Cleveland: "20150630"
 },
 rotation: "Zwaar"
 }
 }
 );
Tabelquery
Misschien is het grootste verschil tussen SQL en NoSQL vanuit het perspectief van queryvorming het gebruik van formuleringen FROM en WAAR. SQL staat toe dat na de expressie FROM meerdere tabellen kunnen worden gekozen, en de expressie met WAAR kan van welke complexiteit dan ook zijn (inclusief operaties JOIN tussen tabellen). Echter, NoSQL heeft de neiging om strenge beperkingen op te leggen aan FROM, en werkt alleen met één opgegeven tabel, terwijl in WAAR, er moet altijd een primaire sleutel worden opgegeven. Dit heeft te maken met de streven naar het verbeteren van de prestaties van NoSQL, waar we het eerder over hadden. Dit streven leidt tot een aanzienlijke vermindering van elke inter-tabellen en inter-sleutel interactie. Dit kan resulteren in grote vertragingen in de knooppuntcommunicatie bij het beantwoorden van een query, en moet daarom in principe worden vermeden. Bijvoorbeeld, Cassandra vereist dat queries worden beperkt tot bepaalde operatoren (alleen toegestaan =, IN, , =>, <=) op partitiesleutels, behalve in het geval van het verzoek van een secundaire index (hier is alleen de operator = toegestaan).
PostgreSQL
Hieronder volgen drie voorbeelden van queries die gemakkelijk kunnen worden uitgevoerd door een SQL-database.
- Haal alle nummers van de artiest op;
- Haal alle nummers van de artiest op die overeenkomen met het eerste deel van de titel;
- Haal alle nummers van de artiest op die een bepaald woord in de titel hebben en een prijs van minder dan 1,00 hebben.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE 'Call%';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE '%Today%'
AND Price > 1.00;
Cassandra
Van de bovenstaande queries zal alleen de eerste werken in Cassandra zonder wijzigingen, aangezien de operator LIKE niet kan worden toegepast op clustering kolommen zoals SongTitle. In dit geval zijn alleen de operatoren toegestaan = en IN.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle IN ('Call Me Today', 'My Dog Spot')
AND Price > 1.00;
MongoDB
Zoals in de vorige voorbeelden te zien is, is de primaire methode voor het maken van queries in MongoDB . Deze methode bevat expliciet de naam van de collectie (music in het onderstaande voorbeeld), waardoor query’s over meerdere collecties verboden zijn.
db.music.find( {
  artist: "No One You Know"
 }
);
db.music.find( {
  artist: "No One You Know",
  songTitle: /Call/
 }
);
Lees alle rijen van de tabel
Alle rijen lezen is gewoon een specifieke gevallen van het querypatroon dat we eerder hebben besproken.
PostgreSQL
SELECT *
FROM Music;
Cassandra
Evenzo het voorbeeld in PostgreSQL hierboven.
MongoDB
db.music.find( {} );Bewerk gegevens in de tabel
PostgreSQL
PostgreSQL biedt de instructie UPDATE voor het wijzigen van gegevens. Het heeft geen mogelijkheden UPSERT, dus het uitvoeren van deze instructie zal resulteren in een fout als de rijen niet meer in de database aanwezig zijn.
UPDATE Music
SET Genre = 'Disco'
WHERE Artist = 'The Acme Band' AND SongTitle = 'Still In Love';
Cassandra
In Cassandra is er UPDATE een analoge functie aan PostgreSQL. UPDATE heeft dezelfde semantiek UPSERT, vergelijkbaar met INSERT.
Evenzo het voorbeeld in PostgreSQL hierboven.
MongoDB
Operatie In MongoDB kan een bestaand document volledig worden bijgewerkt of kunnen alleen bepaalde velden worden bijgewerkt. Standaard wordt slechts één document bijgewerkt zonder semantiek. UPSERT. Het bijwerken van meerdere documenten werkt op een vergelijkbare manier. UPSERT Dit kan worden toegepast door extra vlaggen voor de operatie in te stellen. Zoals in het onderstaande voorbeeld wordt het genre van een specifieke artiest bijgewerkt op basis van zijn nummer.
db.music.update(
  {"artist": "The Acme Band"},
  {
    $set: {
      "genre": "Disco"
    }
  },
  {"multi": true, "upsert": true}
);
Gegevens uit de tabel verwijderen
PostgreSQL
DELETE FROM Music
WHERE Artist = 'The Acme Band' AND SongTitle = 'Look Out, World';
Cassandra
Evenzo het voorbeeld in PostgreSQL hierboven.
MongoDB
In MongoDB zijn er twee types operaties voor het verwijderen van documenten — en . Beide typen verwijderen documenten, maar geven verschillende resultaten terug.
db.music.deleteMany( {
        artist: "The Acme Band"
    }
);
Een tabel verwijderen
PostgreSQL
DROP TABLE Music;Cassandra
Evenzo het voorbeeld in PostgreSQL hierboven.
MongoDB
db.music.drop();Conclusie
De discussies over de keuze tussen SQL en NoSQL woeden al meer dan 10 jaar. Er zijn twee hoofdaspecten van deze discussie: de architectuur van de kerndatabase (monolithisch, transactioneel SQL versus gedistribueerd, niet-transactioneel NoSQL) en de benadering van databaseontwerp (gegevensmodellering in SQL versus het modelleren van uw query's in NoSQL).
Met een gedistribueerde transactionele database zoals YugaByte DB kunnen de debatten over databasearchitectuur gemakkelijk worden opgelost. Naarmate de datavolumes groter worden dan wat in één node kan worden weggeschreven, wordt een volledig gedistribueerde architectuur die lineaire schaalbaarheid van schrijfoperaties met automatische sharding/herbalancering ondersteunt noodzakelijk.
Bovendien, zoals vermeld in een van de artikelen , worden transactionele, strikt gecoördineerde architecturen nu breder toegepast voor betere flexibiliteit in ontwikkeling dan niet-transactionele, uiteindelijk gecoördineerde architecturen.
Als we terugkijken op de discussie over databaseontwerp, is het eerlijk te zeggen dat beide ontwerpen (SQL en NoSQL) noodzakelijk zijn voor elke complexe applicatie in de echte wereld. De SQL-benadering van 'datamodeling' stelt ontwikkelaars in staat om beter te voldoen aan veranderende bedrijfsvereisten, terwijl de NoSQL-aanpak van 'querymodeling' dezelfde ontwikkelaars in staat stelt om met grotere hoeveelheden gegevens om te gaan met lage latentie en hoge doorvoersnelheid. Daarom biedt YugaByte DB zowel SQL- als NoSQL-API's in een gemeenschappelijke kernel, in plaats van een van de twee benaderingen te promoten. Bovendien, door compatibiliteit te bieden met populaire database-talen, waaronder PostgreSQL en Cassandra, zorgt YugaByte DB ervoor dat ontwikkelaars geen andere taal hoeven te leren om te werken met de gedistribueerde databasekern met sterke consistentie.
In dit artikel hebben we onderzocht hoe de basisprincipes van databaseontwerp verschillen tussen PostgreSQL, Cassandra en MongoDB. In de volgende artikelen zullen we ons verdiepen in geavanceerde ontwerconcepten zoals indexen, transacties, JOIN's, TTL-directieven en JSON-documenten.
We wensen je een geweldig restant van het weekend en nodigen je uit voor , dat op 14 mei al zal plaatsvinden.
Bron: habr.com
