

Inleiding
 «Je moet op volle snelheid rennen om alleen maar op dezelfde plek te blijven,
en om ergens te komen, moet je minstens twee keer zo snel rennen!»
(c) Alice in Wonderland
Enige tijd geleden werd mij gevraagd om een lezing te geven aan onze analisten over het ontwerpen van datamodellen, want door lange tijd aan projecten te werken (soms meerdere jaren), verliezen we de ontwikkelingen in de wereld van IT-technologieën uit het oog. In ons bedrijf (zoals het toevallig is) worden op veel projecten geen NoSQL-databases gebruikt (althans nog niet), daarom heb ik in mijn lezing hier extra aandacht aan besteed met het voorbeeld van HBase en heb ik geprobeerd de presentatie van het materiaal te richten op degenen die er nog nooit mee hebben gewerkt. In het bijzonder illustreerde ik enkele kenmerken van het ontwerpen van datamodellen aan de hand van een voorbeeld dat ik enkele jaren geleden las . Tijdens het bespreken van de voorbeelden vergeleek ik verschillende oplossingen voor dezelfde taak, om de belangrijkste ideeën beter over te brengen aan de luisteraars.
Onlangs, ‘uit verveling’, stelde ik mezelf de vraag (de lange meivakantie in quarantainemodus leent zich hier bijzonder goed voor), in hoeverre theoretische uitspraken overeenkomen met de praktijk? Eigenlijk is zo het idee voor dit artikel ontstaan. Een ontwikkelaar, die al enige tijd met NoSQL werkt, zal mogelijk niets nieuws uit deze tekst halen (en kan dus meteen halverwege het artikel doorscrollen). Maar voor analisten, die nog niet intensief met NoSQL hebben gewerkt, denk ik dat het nuttig zal zijn om basisinzichten te krijgen in de kenmerken van het ontwerpen van datamodellen voor HBase.
Analyse van het voorbeeld
Naar mijn mening moet je goed overwegen en afwegen wat de voor- en nadelen zijn voordat je begint met het gebruiken van NoSQL-databases. Vaak kan de taak ook opgelost worden met traditionele relationele databases. Daarom is het beter om NoSQL niet te gebruiken zonder goede redenen. Als er echter besloten is om een NoSQL-database te gebruiken, moet je in gedachten houden dat de ontwerpproblemen hier iets anders zijn. Vooral sommige van deze problemen kunnen ongebruikelijk zijn voor degenen die eerder alleen met relationele databases hebben gewerkt (volgens mijn waarnemingen). In de 'relationele' wereld gaan we gewoonlijk uit van het modelleren van het domein, en voeren we vervolgens, indien nodig, denormalisatie uit. In NoSQL moeten we onmiddellijk rekening houden met de verwachte scenario's voor het werken met gegevens en de gegevens aanvankelijk denormaliseren. Daarnaast zijn er nog een aantal andere verschillen, waarover hieronder meer zal worden geschreven.
Laten we kijken naar de volgende 'synthetische' taak, waarmee we verder zullen werken:
Het is noodzakelijk om de structuur op te zetten voor het opslaan van een lijst met vrienden van gebruikers in een bepaalde abstracte sociale netwerksite. Voor het gemak nemen we aan dat alle verbindingen eenrichtings zijn (zoals in Instagram, en niet zoals in LinkedIn). De structuur moet efficiënt het volgende mogelijk maken:
- Beantwoorden of gebruiker A gebruiker B leest (leessjabloon)
- Het mogelijk maken om verbindingen toe te voegen / te verwijderen in het geval dat gebruiker A zich abonneert of afmeldt van gebruiker B (wijzigingssjabloon)
Er zijn natuurlijk talloze manieren om de taak op te lossen. In een gebruikelijke relationele database zouden we waarschijnlijk gewoon een tabel met verbindingen maken (mogelijk getypeerd, als bijvoorbeeld een gebruikersgroep vereist is: familie, werk, enzovoort, waartoe deze 'vriend' behoort), en om de toegangssnelheid te optimaliseren zouden we indexen / partitionering toevoegen. Het eindresultaat zou er waarschijnlijk ongeveer zo uitzien:
user_id
friend_id
Vasya
Petya
Vasya
Olya
hier en verder zal ik voor de duidelijkheid en beter begrip in plaats van ID's namen gebruiken
In het geval van HBase weten we dat:
- efficiënte zoekopdrachten, zonder dat een volledige tabelscan nodig is, alleen mogelijk zijn op basis van de sleutel
- Eigenlijk is het daarom een slecht idee om gebruikelijke SQL-queries naar dergelijke databases te schrijven; technisch gezien kun je vanuit dezelfde Impala een SQL-query met joins en andere logica naar HBase sturen, maar hoe efficiënt zal dat zijn...
Daarom zijn we gedwongen om de gebruikers-ID als sleutel te gebruiken. De eerste gedachte over 'waar en hoe de ID van vrienden op te slaan?' kan zijn om ze in kolommen op te slaan. Deze voor de hand liggende en 'naïeve' optie zou er ongeveer zo uitzien (laten we het noemen Optie 1 (standaard), zodat we er later naar kunnen verwijzen):
RowKey
Kolommen
Vasya
1: Petya
2: Olya
3: Dasha
Petya
1: Masha
2: Vasya
Hier komt elke rij overeen met één gebruiker van het netwerk. De kolommen hebben namen: 1, 2, … — afhankelijk van het aantal vrienden, en in de kolommen worden de ID's van vrienden opgeslagen. Het is belangrijk op te merken dat elke rij een verschillende hoeveelheid kolommen zal hebben. In het voorbeeld hierboven heeft één rij drie kolommen (1, 2 en 3), terwijl de tweede slechts twee (1 en 2) heeft – hier hebben we gebruik gemaakt van twee eigenschappen van HBase die niet aanwezig zijn in relationele databases:
- de mogelijkheid om dynamisch samenstelling van kolommen te wijzigen (voeg een vriend toe -> voeg een kolom toe, verwijder een vriend -> verwijder een kolom)
- verschillende rijen kunnen een verschillende samenstelling van kolommen hebben
Laten we onze structuur controleren op overeenstemming met de vereisten van de taak:
- Gegevens lezen: om te begrijpen of Vasya Olya volgt, moeten we de hele rij uitlezen op basis van de RowKey = 'Vasya' en de kolomwaarden doorlopen totdat we Olya daar tegenkomen. Of we doorlopen de waarden van alle kolommen, 'komen Olya niet tegen' en retourneren het antwoord False;
- Datawijziging: vriend toevoegen: voor deze taak moeten we ook uitlezen de hele rij uitlezen op basis van de RowKey = 'Vasya', om het totale aantal vrienden te tellen. Dit totaal aantal vrienden hebben we nodig om het kolomnummer te bepalen waarvoor we de ID van de nieuwe vriend moeten opslaan.
- Datawijziging: vriend verwijderen:
- We moeten uitlezen de hele rij uitlezen op basis van de RowKey = 'Vasya' en de kolommen doorlopen om de kolom te vinden waarin de verwijderde vriend is opgeslagen;
- Daarna moeten we, na het verwijderen van de vriend, alle gegevens met één kolom verschuiven om te voorkomen dat we 'gaten' in hun nummering krijgen.
Laten we nu evalueren hoe efficiënt de algoritmes zijn die we aan de kant van de 'hypothetische applicatie' moeten implementeren, gebruikmakend van Laten we de grootte van ons hypothetische sociale netwerk aanduiden als n. Dan kan het maximale aantal vrienden van een gebruiker (n-1) zijn. We kunnen deze (-1) verder verwaarlozen voor onze doeleinden, aangezien het binnen het gebruik van O-symbologie onverstandig is.
- Gegevens lezen: het is noodzakelijk om de hele rij uit te lezen en in principe al zijn kolommen door te nemen. Daarom zal de bovenste schatting van de kosten ongeveer O(n) zijn.
- Datawijziging: vriend toevoegen: om het aantal vrienden te bepalen, moeten we alle kolommen van de rij doorlopen, waarna we een nieuwe kolom invoegen => O(n)
- Datawijziging: vriend verwijderen:
- Evenzo zoals bij het toevoegen – we moeten in principe alle kolommen doorlopen => O(n)
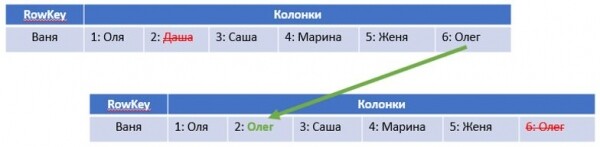
- Na het verwijderen van kolommen moeten we deze ‘verhuizen’. Als we dit 'direct' uitvoeren, zijn er in principe nog tot (n-1) bewerkingen nodig. Maar hier en verder in het praktische gedeelte zullen we een andere aanpak toepassen die een 'pseudo-verschuiving' implementeert in een vast aantal bewerkingen – dat wil zeggen, deze zal constante tijd kosten ongeacht n. Deze constante tijd (precies O(2)) kan vergeleken met O(n) verwaarloosd worden. De aanpak is geïllustreerd in de afbeelding hieronder: we kopiëren simpelweg de gegevens van de 'laatste' kolom naar degene waarvan we gegevens moeten verwijderen, waarna we de laatste kolom verwijderen:

In totaal hebben we in alle scenario's een asymptotische rekenschapcomplexiteit van O(n) gekregen.
Je hebt waarschijnlijk al opgemerkt dat we bijna altijd de hele rij uit de database moeten lezen, en in twee van de drie gevallen alleen om alle kolommen door te nemen en het totale aantal vrienden te tellen. Daarom kunnen we als een poging tot optimalisatie een kolom 'count' toevoegen, waarin het totale aantal vrienden van elke gebruiker in het netwerk wordt opgeslagen. In dit geval kunnen we niet de hele rij lezen om het totale aantal vrienden te tellen, maar alleen één kolom 'count'. Het belangrijkste is om 'count' bij te werken bij manipulatie van gegevens. Zo krijgen we een verbeterde Optie 2 (count):
RowKey
Kolommen
Vasya
1: Petya
2: Olya
3: Dasha
count: 3
Petya
1: Masha
2: Vasya
count: 2
In vergelijking met de eerste optie:
- Gegevens lezen: om het antwoord op de vraag 'Leest Vasya Olya?' te krijgen, is er niets veranderd => O(n)
- Datawijziging: vriend toevoegen: We hebben het invoegen van een nieuwe vriend vereenvoudigd, omdat we nu niet de hele rij hoeven door te lezen en de kolommen te doorlopen, maar alleen de waarde van de kolom «count» kunnen krijgen en zo direct het kolomnummer voor het invoegen van een nieuwe vriend kunnen bepalen. Dit leidt tot een reductie van de rekencomplexiteit tot O(1)
- Datawijziging: vriend verwijderen: Bij het verwijderen van een vriend kunnen we ook gebruik maken van deze kolom om het aantal input-outputoperaties te verminderen bij het «verschuiven» van gegevens naar links met één cel. Maar de noodzaak om door de kolommen te lopen om degene te vinden die we willen verwijderen blijft toch bestaan, dus => O(n)
- Aan de andere kant moeten we nu bij het bijwerken van de gegevens elke keer ook de kolom «count» bijwerken, maar dit kost constante tijd, wat in het kader van O-notatie verwaarloosbaar is.
Over het algemeen lijkt optie 2 iets optimaler, maar het is eerder «evolutie in plaats van revolutie». Voor een echte «revolutie» hebben we nodig: Optie 3 (col).
We draaien alles «op zijn kop»: wijs de naam van de kolom als gebruikersidentificator toe! Wat er in de kolom wordt opgeslagen, is voor ons al niet meer van belang, laten we gewoon het getal 1 gebruiken (in feite kan daar nuttig iets als de groep «familie/vrienden/enz.» worden opgeslagen). Deze benadering kan een onvoorbereide «burger» verrassen die hiervoor geen ervaring heeft met NoSQL-databases, maar het stelt ons in staat om het potentieel van HBase voor deze taak veel effectiever te benutten:
RowKey
Kolommen
Vasya
Petr: 1
Olya: 1
Dasha: 1
Petya
Masha: 1
Vasya: 1
Hier verkrijgen we meteen verschillende voordelen. Om deze te begrijpen, analyseren we de nieuwe structuur en evalueren we de rekencomplexiteit:
- Gegevens lezen: om de vraag te beantwoorden of Vasya Olya volgt, is het voldoende om één kolom «Olya» te lezen: als deze er is, is het antwoord True, als deze er niet is, is het False => O(1)
- Datawijziging: vriend toevoegen: Vriend toevoegen: het is voldoende om gewoon een nieuwe kolom «vriend ID» toe te voegen => O(1)
- Datawijziging: vriend verwijderen: het is voldoende om gewoon de kolom «vriend ID» te verwijderen => O(1)
Zoals we zien, is een aanzienlijk voordeel van dit opslagmodel dat we in al onze noodzakelijke scenario's alleen met één kolom werken, waardoor we het lezen van de gehele rij uit de database en zeker het doorlopen van alle kolommen van die rij kunnen vermijden. Hier kunnen we mee stoppen, maar...
Je kunt je ook gemeenschappelijk moeilijkheden voor performanceoptimalisatie en vermindering van invoer- en uitvoeroperaties bij het aanspreken van de database aan het hoofd bieden. Wat als we alle contacten-informatie direct in de sleutel van de rij zouden opslaan? Dus de sleutel als een samengestelde sleutel van het type userID.friendID? In dat geval hoeven we eigenlijk helemaal geen kolommen van de rij te lezen.Optie 4(row)):
RowKey
Kolommen
Vasya.Petya
Petr: 1
Vasya.Olya
Olya: 1
Vasya.Dasha
Dasha: 1
Petya.Masha
Masha: 1
Petya.Vasya
Vasya: 1
Het is duidelijk dat de evaluatie van alle scenario's voor gegevensmanipulaties in deze structuur, net zoals in de vorige optie, O(1) zal zijn. Het verschil met optie 3 zal uitsluitend liggen in de efficiëntie van de invoer- en uitvoeroperaties in de database.
En dan de laatste 'strikje'. Het is gemakkelijk op te merken dat in optie 4 onze rij-sleutel een variabele lengte zal hebben, wat mogelijk de prestaties kan beïnvloeden (hier herinneren we ons dat HBase gegevens opslaat als een byte-array en de rijen in tabellen zijn gesorteerd op de sleutel). Bovendien hebben we een scheidingsteken dat in sommige scenario's mogelijk moet worden verwerkt. Om deze invloed uit te sluiten, kunnen we hashes van userID en friendID gebruiken, en aangezien beide hashes een vaste lengte hebben, kunnen we ze eenvoudig aan elkaar plakken zonder scheidingsteken. Dan zullen de gegevens in de tabel eruitzien alsOptie 5(hash)):
RowKey
Kolommen
dc084ef00e94aef49be885f9b01f51c01918fa783851db0dc1f72f83d33a5994
Petr: 1
dc084ef00e94aef49be885f9b01f51c0f06b7714b5ba522c3cf51328b66fe28a
Olya: 1
dc084ef00e94aef49be885f9b01f51c00d2c2e5d69df6b238754f650d56c896a
Dasha: 1
1918fa783851db0dc1f72f83d33a59949ee3309645bd2c0775899fca14f311e1
Masha: 1
1918fa783851db0dc1f72f83d33a5994dc084ef00e94aef49be885f9b01f51c0
Vasya: 1
Het is duidelijk dat de algorithmische complexiteit van het werken met deze structuur volgens de scenario's die we hebben besproken, dezelfde zal zijn als die van optie 4 – dat is O(1).
Als resultaat zullen we al onze evaluaties van computationale complexiteit in één tabel samenvoegen:
Een vriend toevoegen
Vriend controleren
Vriend verwijderen
Optie 1 (standaard)
O(n)
O(n)
O(n)
Optie 2 (count)
O(1)
O(n)
O(n)
Optie 3 (column)
O(1)
O(1)
O(1)
Optie 4 (row)
O(1)
O(1)
O(1)
Optie 5 (hash)
O(1)
O(1)
O(1)
Zoals te zien is, lijken de opties 3-5 het meest aantrekkelijk en bieden theoretisch de uitvoering van alle noodzakelijke datascenario's binnen constante tijd. In de voorwaarden van onze taak is er geen duidelijke vereiste voor het verkrijgen van een lijst van alle vrienden van de gebruiker, maar in de praktische projectactiviteiten is het voor ons als goede analisten nuttig om te 'anticiperen' dat een dergelijke taak kan ontstaan en 'voorzorgsmaatregelen' te treffen. Daarom heb ik een voorkeur voor optie 3. Het is echter goed mogelijk dat in een echt project dit verzoek al op andere manieren is opgelost, dus zonder een algemeen beeld van de hele opdracht is het beter om geen definitieve conclusies te trekken.
Voorbereiding van het experiment
De bovenstaande theoretische overpeinzingen willen we graag in de praktijk toetsen – dat was het doel van het idee dat ontstond tijdens een lange weekend. Hiertoe is het noodzakelijk om de snelheid van ons 'hypothetische applicatie' te evalueren in alle beschreven gebruiksscenario's van de database, evenals de toename van deze tijd met de groei van de omvang van het sociale netwerk (n). De doelvariabele die ons interesseert en die we tijdens het experiment zullen meten, is de tijd die de 'hypothetische applicatie' verbruikt voor het uitvoeren van één 'bedrijfsoperatie'. Onder 'bedrijfsoperatie' verstaan we een van de volgende:
- Toevoegen van één nieuwe vriend
- Controleren of gebruiker A een vriend is van gebruiker B
- Verwijderen van één vriend
Dus, rekening houdend met de in de oorspronkelijke opdracht aangegeven vereisten, ziet het scenario voor de test er als volgt uit:
- Gegevensregistratie. Genereer willekeurig een initiële netwerkgrootte van n. Om dichter bij de 'echte wereld' te komen, is het aantal vrienden van elke gebruiker ook een willekeurige variabele. Meet de tijd die onze 'hypothetische applicatie' nodig heeft om alle gegenereerde gegevens in HBase te schrijven. Vervolgens delen we de verkregen tijd door het totale aantal toegevoegde vrienden – zo verkrijgen we de gemiddelde tijd voor één 'bedrijfsoperatie'.
- Gegevens lezen. Voor elke gebruiker een lijst met "identiteiten" opstellen waarvoor moet worden nagegaan of de gebruiker ze volgt of niet. De lengte van de lijst is ongeveer het aantal vrienden van de gebruiker, waarbij voor de helft van de gecontroleerde vrienden het antwoord "Ja" moet zijn en voor de andere helft "Nee". De controle wordt uitgevoerd in een zodanige volgorde dat de antwoorden "Ja" en "Nee" elkaar afwisselen (dat wil zeggen, in elk tweede geval moeten we alle kolommen van de rij voor opties 1 en 2 doorlopen). De totale controle-tijd wordt vervolgens gedeeld door het aantal gecontroleerde vrienden om de gemiddelde tijd voor het controleren van één onderwerp te krijgen.
- Gegevens verwijderen. Alle vrienden van de gebruiker verwijderen. De volgorde van verwijdering is willekeurig (dat wil zeggen; we "schudden" de oorspronkelijke lijst die voor het registreren van gegevens is gebruikt). De totale controle-tijd wordt vervolgens gedeeld door het aantal te verwijderen vrienden om de gemiddelde tijd voor één controle te krijgen.
De scenario's moeten voor elk van de 5 varianten van datamodellen en voor verschillende groottes van het sociale netwerk worden doorlopen, om te zien hoe de tijd verandert met de groei ervan. Binnen één n verbindingen in het netwerk moeten de lijst met gebruikers voor controle natuurlijk identiek zijn voor alle 5 varianten.
Voor een beter begrip geef ik hieronder een voorbeeld van de gegenereerde gegevens voor n= 5. De geschreven "generator" geeft drie woordenboeken van ID's als output:
- de eerste - voor invoegen
- de tweede - voor controle
- de derde - voor verwijdering
{0: [1], 1: [4, 5, 3, 2, 1], 2: [1, 2], 3: [2, 4, 1, 5, 3], 4: [2, 1]} # in totaal 15 vrienden

{0: [1, 10800], 1: [5, 10800, 2, 10801, 4, 10802], 2: [1, 10800], 3: [3, 10800, 1, 10801, 5, 10802], 4: [2, 10800]} # in totaal 18 gecontroleerde onderwerpen

{0: [1], 1: [1, 3, 2, 5, 4], 2: [1, 2], 3: [4, 1, 2, 3, 5], 4: [1, 2]} # in totaal 15 vrienden
Zoals je kunt zien, zijn alle ID's groter dan 10.000 in het woordenboek voor controle diegenen die van tevoren een False antwoord zullen geven. Invoegen, controleren en verwijderen van "vrienden" gebeurt precies in de volgorde zoals in het woordenboek aangegeven.
Het experiment werd uitgevoerd op een laptop met Windows 10, waar in één docker-container een HBase-database draaide en in een andere Python met Jupyter Notebook. Docker had 2 CPU-kernen en 2 GB RAM toegewezen gekregen. De gehele logica, zowel de emulatie van het werk van een "hypothetische applicatie" als de "wrapper" voor het genereren van testgegevens en het meten van tijd, was geschreven in Python. Voor het werken met HBase werd de bibliotheek gebruikt , voor het berekenen van hashes (MD5) voor optie 5 - hashlib
Met inachtneming van de rekenkracht van de specifieke laptop is experimenteel gekozen voor een start voor n = 10, 30, … 170 - wanneer de totale tijd van de volledige testcyclus (alle scenario's voor alle opties voor alle n) nog redelijk en binnen de tijd van een thee-ervaring (gemiddeld 15 minuten) viel.
Hier moet opgemerkt worden dat we in dit experiment in de eerste plaats de absolute prestatiewaarden niet evalueren. Zelfs een relatieve vergelijking tussen twee verschillende opties kan niet geheel correct zijn. Momenteel zijn we geïnteresseerd in de aard van de tijdsverandering afhankelijk van n, omdat het met de eerder vermelde configuratie van de 'teststand' moeilijk is om tijdschattingen 'schoon' te krijgen zonder invloed van willekeurige en andere factoren (en die taak was ook niet gesteld).
Resultaat van het experiment
De eerste test - hoe de tijd verandert die nodig is voor het invullen van de vriendenlijst. Resultaat - in de onderstaande grafiek.
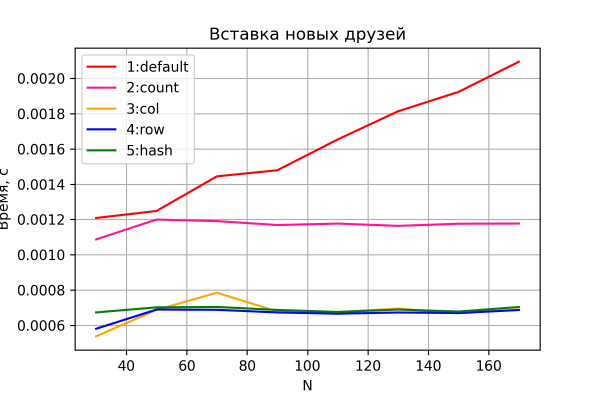
Opties 3-5 laten verwacht een nagenoeg constante tijd voor de 'business-operatie' zien, die niet afhankelijk is van de groei van de netwerkgrootte en onverdistinguishbare verschillen in prestaties.
Optie 2 toont ook een constante, maar iets slechtere prestatie, bijna precies 2 keer minder dan opties 3-5. Dit is bemoedigend omdat het in overeenstemming is met de theorie - in deze optie is het aantal in- en uitvoerbewerkingen in/out van HBase precies 2 keer hoger. Dit kan indirect bewijs zijn dat onze teststand in principe een goede nauwkeurigheid biedt.
Optie 1 blijkt ook de langzaamste te zijn en vertoont een lineaire toename van de tijd, afhankelijk van de grootte van het netwerk bij het toevoegen van een vriend.
Laten we nu naar de resultaten van de tweede test kijken.
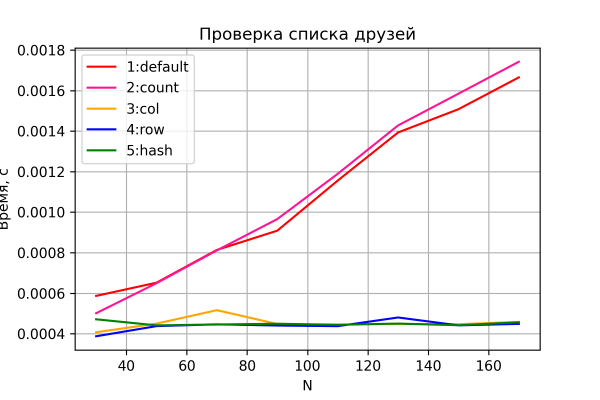
De opties 3-5 gedragen zich opnieuw zoals verwacht - constante tijd, onafhankelijk van de netwerkgrootte. De opties 1 en 2 tonen een lineaire toename in tijd naarmate de netwerkgrootte toeneemt en vertonen vergelijkbare prestaties. Daarbij blijkt optie 2 iets langzamer - waarschijnlijk vanwege de noodzaak om de extra kolom 'aantal' te lezen en te verwerken, wat met groeiende n steeds merkbaarder wordt. Maar ik blijf toch liever voorzichtig met conclusies, aangezien de nauwkeurigheid van deze vergelijking relatief laag is. Bovendien varieerden de verhoudingen (welke optie, 1 of 2, sneller was) van run tot run (terwijl de aard van de afhankelijkheid behouden bleef en 'neus aan neus' ging).
En de laatste grafiek - het resultaat van de test voor het verwijderen.
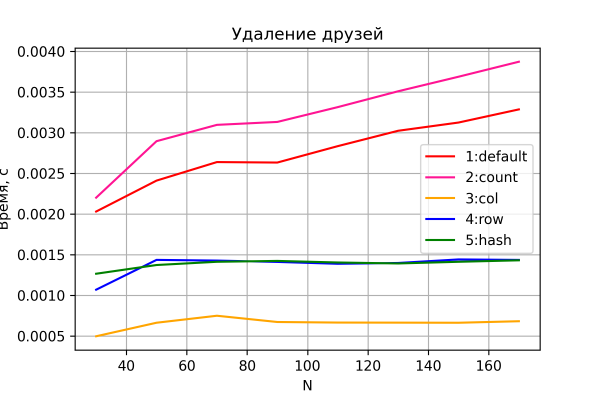
Hier weer geen verrassingen. De opties 3-5 verwijderen in constante tijd.
Wat interessant is, is dat de opties 4 en 5, in tegenstelling tot de voorgaande scenario's, merkbaar iets slechtere prestaties vertonen dan optie 3. Het lijkt erop dat de operatie om een rij te verwijderen meer kosten met zich meebrengt dan de operatie om een kolom te verwijderen, wat op zich logisch is.
De opties 1 en 2 tonen zoals verwacht een lineaire toename in tijd. Daarbij is optie 2 constant langzamer dan optie 1 - vanwege de extra invoer/uitvoeroperatie voor het 'onderhouden' van de kolom aantal.
Algemene conclusies van het experiment:
- De opties 3-5 tonen een hogere efficiëntie, omdat ze profiteren van de voordelen van HBase; hun prestaties verschillen onderling met een constante en zijn niet afhankelijk van de netwerkgrootte.
- Het verschil tussen de opties 4 en 5 werd niet vastgesteld. Maar dat betekent niet dat optie 5 niet moet worden gebruikt. Het is goed mogelijk dat het gebruikte experimentele scenario, rekening houdend met de specificaties van de testopstelling, dit niet heeft kunnen onthullen.
- De aard van de toename in tijd die nodig is voor het uitvoeren van 'bedrijfsoperaties' met gegevens bevestigde in grote lijnen de eerder verkregen theoretische bevindingen voor alle opties.
Epilog
Uitgevoerde ruwe experimenten moeten niet als absolute waarheid worden beschouwd. Er zijn veel factoren die niet zijn meegenomen en die vervormingen in de resultaten hebben veroorzaakt (vooral zijn deze fluctuaties goed zichtbaar op de grafieken bij een kleine netwerkgrootte). Bijvoorbeeld, de snelheid van Thrift, dat wordt gebruikt door HappyBase, de hoeveelheid en manier van implementatie van de logica die ik in Python heb geschreven (ik durf niet te beweren dat de code optimaal was geschreven en alle mogelijkheden van de componenten efficiënt heeft gebruikt), mogelijk cache-kenmerken van HBase, achtergrondactiviteit van Windows 10 op mijn laptop, enzovoort. Over het algemeen kan worden gesteld dat alle theoretische afleidingen experimenteel hun haalbaarheid hebben aangetoond. Of om ze op zijn minst niet met een dergelijke 'ruwe aanval' te weerleggen, is niet gelukt.
Tot slot - aanbevelingen voor iedereen die net begint met het ontwerpen van datamodellen in HBase: abstraheer je van eerdere ervaringen met relationele databases en houd de 'geboden' in gedachten:
- Bij het ontwerpen starten we vanuit de taak en de sjablonen voor gegevensmanipulatie, en niet vanuit het domeinmodel.
- Effectieve toegang (zonder full table scan) – alleen op sleutel.
- Denormalisatie.
- Verschillende rijen kunnen verschillende kolommen bevatten.
- Dynamische samenstelling van kolommen.
Bron: habr.com
