

In Linux zijn er veel hulpmiddelen voor het debuggen van de kernel en applicaties. De meeste hiervan hebben een negatieve invloed op de prestaties van applicaties en kunnen niet in productie worden gebruikt.
Een paar jaar geleden werd — eBPF. Het maakt het mogelijk om de kernel en gebruikersapplicaties te traceren met een lage overhead en zonder de noodzaak om programma's opnieuw te compileren of externe modules in de kernel te laden.
Er zijn nu veel toegepaste tools die eBPF gebruiken, en in dit artikel zullen we bekijken hoe we onze eigen profileringsutility kunnen schrijven op basis van de . Het artikel is gebaseerd op werkelijke gebeurtenissen. We zullen de weg volgen van het ontstaan van het probleem tot de oplossing, om te laten zien hoe bestaande tools in specifieke situaties kunnen worden gebruikt.
Ceph Is Slow
Een nieuwe host is aan de Ceph-cluster toegevoegd. Na de migratie van een deel van de gegevens naar deze host, merkten we op dat de snelheid van verwerken van schrijfacties veel lager was dan op andere servers.
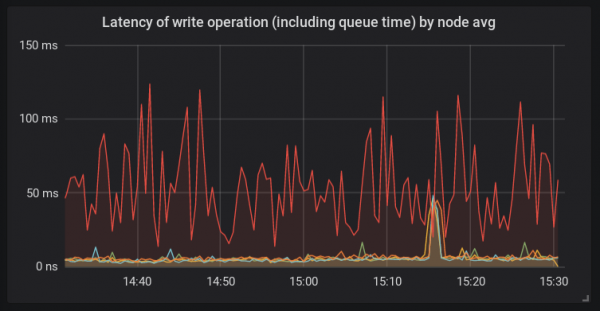
In tegenstelling tot andere platforms werd op deze host bcache en een nieuwe kernel van linux 4.15 gebruikt. Deze hostconfiguratie werd hier voor het eerst gebruikt. Op dat moment was het duidelijk dat de oorzaak van het probleem theoretisch van alles kon zijn.
Investigating the Host
Laten we beginnen met te kijken naar wat er binnen het ceph-osd proces gebeurt. Hiervoor gebruiken we en (waarover meer te lezen is ):
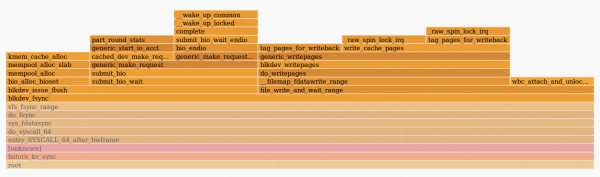
De afbeelding laat ons zien dat de functie fdatasync() veel tijd heeft besteed aan het verzenden van een aanvraag in de functie generic_make_request(). Dit betekent dat de oorzaak van de problemen waarschijnlijk ergens buiten de osd-daemon ligt. Dit kan de kernel of de schijven zijn. De iostat output toonde hoge vertragingen in de verwerking van aanvragen door bcache-schijven.
Bij het controleren van de host ontdekten we dat de systemd-udevd daemon een groot aantal CPU-tijd verbruikte - ongeveer 20% op verschillende cores. Dit is vreemd gedrag, dus we moeten de oorzaak ervan achterhalen. Aangezien Systemd-udevd met ueventen werkt, besloten we ze te bekijken via udevadm monitor. Blijkbaar werd er een groot aantal change-gebeurtenissen gegenereerd voor elk blokapparaat in het systeem. Dit is behoorlijk ongebruikelijk, dus we moeten uitzoeken wat al deze evenementen genereert.
Using the BCC Toolkit
Zoals we al hebben vastgesteld, besteedt de kernel (en de ceph-daemon in de systeemaanroep) veel tijd in generic_make_request(). Laten we proberen de snelheid van deze functie te meten. In is er al een geweldige tool — funclatencyWe zullen de demon traceren op basis van zijn PID met een interval van 1 seconde tussen de informatie-uitvoeringen en de resultaten in milliseconden weergeven.
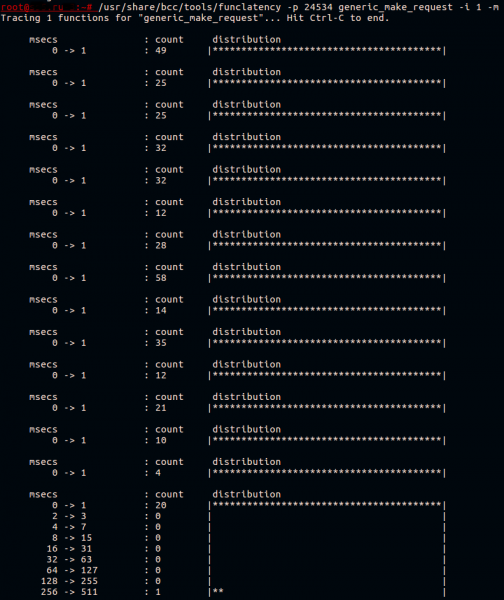
Normaal gesproken werkt deze functie snel. Alles wat het doet, is het verzoek in de wachtrij van de stuurprogramma's plaatsen.
Bcache is een complex apparaat dat eigenlijk uit drie schijven bestaat:
- backing device (de cachebare schijf), in dit geval een langzame HDD;
- caching device (de cache-schijf), hier is dat een partitie van het NVMe-apparaat;
- een virtueel apparaat bcache waarmee de applicatie werkt.
We weten dat de overdracht van verzoeken vertraagt, maar voor welk van deze apparaten? We zullen dit iets later uitzoeken.
Op dit moment weten we dat de uevent's waarschijnlijk problemen veroorzaken. Het is niet zo eenvoudig om te vinden wat hun generatie veroorzaakt. Laten we aannemen dat dit een softwareprogramma is dat periodiek wordt gestart. Laten we kijken welke software op het systeem wordt uitgevoerd via het script execsnoop uit dezelfde . Laten we het starten en de uitvoer naar een bestand sturen.
Bijvoorbeeld zo:
/usr/share/bcc/tools/execsnoop | tee ./execdump
We zullen hier de volledige uitvoer van execsnoop niet geven, maar één regel die ons interesseert, zag er als volgt uit:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\\^ ([0-9]*) C.*\\1/'
De derde kolom is de PPID (parent PID) van het proces. Het proces met PID 5802 bleek een van de threads van ons monitoringsysteem te zijn. Bij het controleren van de configuratie van het monitoringsysteem werden verkeerd ingestelde parameters gevonden. De temperatuur van de HBA-adapter werd elke 30 seconden gemeten, wat veel vaker was dan nodig. Na het wijzigen van het controle-interval naar een langere tijd, ontdekten we dat de vertraging in de verwerking van verzoeken op deze host niet meer opviel ten opzichte van de andere hosts.
Maar het is nog steeds onduidelijk waarom het bcache-apparaat zo traag was. We hebben een testplatform met een identieke configuratie voorbereid en geprobeerd het probleem te reproduceren door fio op bcache te draaien, terwijl we periodiek udevadm trigger uitvoerden om uevents te genereren.
Schrijven van op BCC-gebaseerde tools
Laten we proberen een eenvoudige tool te schrijven voor het traceren en weergeven van de traagste oproepen op het scherm. generic_make_request()We zijn ook geïnteresseerd in de naam van de schijf waarvoor deze functie werd aangeroepen.
Het plan is eenvoudig:
- Registreren kprobe en een werkende opdracht krijgen. generic_make_request():
- We slaan de naam van de schijf die beschikbaar is via de functieparameter op in het geheugen;
- We slaan de tijdstempel op.
- Registreren kretprobe bij terugkeer uit generic_make_request():
- We verkrijgen de huidige tijdstempel;
- We zoeken de opgeslagen tijdstempel en vergelijken deze met de huidige;
- Als het resultaat groter is dan het opgegeven, vinden we de opgeslagen schijfnaam en geven deze weer in de terminal.
Kprobes en kretprobes gebruiken een mechanisme van breakpoints om de code van functies in real-time te wijzigen. Je kunt lezen en artikel over dit onderwerp. Als je kijkt naar de code van verschillende hulpprogramma's in , dan zie je dat ze een identieke structuur hebben. In dit artikel zullen we de parsing van de scriptargumenten overslaan en naar het BPF-programma zelf gaan.
De eBPF-tekst binnen een python-script ziet er als volgt uit:
bpf_text = """ # Hier komt de bpf-programmacode """
Voor de gegevensuitwisseling tussen functies gebruiken eBPF-programma's . Dat zullen we ook doen. We zullen de PID van het proces als sleutel gebruiken, en als waarde definiëren we de structuur:
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Hier registreren we een hash-tabel die heet Het commando geeft een lijst van onze huidige partities weer. In mijn geval één partitie van 30 GB en nog 20 GB in vrije ruimte, als ik dat zo mag zeggen., met een sleutel van het type u64 en een waarde van het type struct data_t. De tabel zal beschikbaar zijn in de context van ons BPF-programma. De macro BPF_PERF_OUTPUT registreert een andere tabel, genaamd events, die wordt gebruikt voor naar de gebruikersruimte.
Bij het meten van vertragingen tussen het aanroepen van een functie en het terugkeren daarvan, of tussen aanroepen van verschillende functies, moet men rekening houden met het feit dat de verkregen gegevens tot dezelfde context moeten behoren. Met andere woorden, men moet rekening houden met mogelijke gelijktijdige uitvoering van functies. We hebben de mogelijkheid om de vertraging te meten tussen het aanroepen van een functie in de context van één proces en het terugkeren van die functie in de context van een ander proces, maar dat is waarschijnlijk nutteloos. Een goed voorbeeld hiervan is de , waarin de sleutel van de hashtabel een pointer is naar struct request, die één schijfverzoek weergeeft.
Daarna moeten we de code schrijven die wordt uitgevoerd bij het aanroepen van de onderzochte functie:
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Hier wordt als tweede argument het eerste argument van de aangeroepen functie ingevuld . Daarna krijgen we de PID van het proces, in de context waarvan we werken, en de huidige tijdstempel in nanoseconden. We schrijven dit allemaal in de pas gealloceerde struct data_t data. De schijfnaam krijgen we uit de structuur bio, die wordt doorgegeven bij het aanroepen generic_make_request(), en we behouden het in dezelfde structuur data. De laatste stap is het toevoegen van een record aan de eerder genoemde hash-tabel.
De volgende functie wordt aangeroepen bij terugkeer uit generic_make_request():
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts)/1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Deze functie is vergelijkbaar met de vorige: we halen de PID van het proces en de tijdstempel op, maar we reserveren geen geheugen voor een nieuwe data-structuur. In plaats daarvan zoeken we in de hash-tabel naar een bestaande structuur met de sleutel == de huidige PID. Als de structuur wordt gevonden, halen we de naam van het actieve proces op en voegen we deze toe.
De binaire verschuiving die we hier gebruiken, is nodig om de thread GID te verkrijgen, dat wil zeggen de PID van het hoofdproces dat de thread heeft gestart in de context waarin we werken. De functie die we aanroepen, geeft zowel de thread GID als de PID in één 64-bits waarde terug.
Bij het afdrukken in de terminal zijn we nu niet geïnteresseerd in de thread, maar in het hoofdproces. Na het vergelijken van de verkregen vertraging met de opgegeven drempel, geven we onze structuur data door aan de gebruikersruimte via de tabel events, waarna we het record uit Het commando geeft een lijst van onze huidige partities weer. In mijn geval één partitie van 30 GB en nog 20 GB in vrije ruimte, als ik dat zo mag zeggen..
In het Python-script dat deze code zal laden, moeten we MIN_US en FACTOR vervangen door de drempels voor vertraging en tijdseenheden die we via argumenten doorgeven:
bpf_text = bpf_text.replace('MIN_US',str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR','data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR','')
	label = "usec"
Nu moeten we het BPF-programma voorbereiden met behulp van en probes registreren:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request",fn_name="start")
b.attach_kretprobe(event="generic_make_request",fn_name="stop")
Daarnaast moeten we definiëren struct data_t in ons script, anders kan er niets worden gelezen:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk",ct.c_char * DISK_NAME_LEN)]
De laatste stap is het afdrukken van gegevens naar de terminal:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# format output
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
Het script is beschikbaar op . Laten we het proberen uit te voeren op een testplatform waar fio draait dat schrijft naar bcache, en roep udevadm monitor aan:
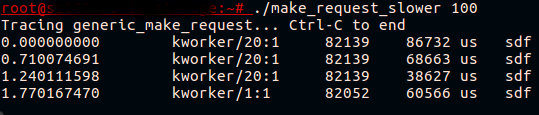
Eindelijk! Nu zien we dat wat eruitzag als een veroorzaker van vertraging voor het bcache-apparaat, in feite een trage aanroep is generic_make_request() voor de gecachte schijf.
Duik in de Kernel
Wat vertraagt precies tijdens het verwerken van een verzoek? We zien dat de vertraging al vóór het beginnen van de accountancy van het verzoek optreedt, dat wil zeggen, de registratie van het specifieke verzoek voor verdere statistische weergave (in /proc/diskstats of iostat) is nog niet begonnen. Dit is gemakkelijk te controleren door iostat te starten tijdens het reproduceren van het probleem, of , dat is gebaseerd op het begin en het einde van de accountancy van verzoeken. Geen van deze tools zal problemen tonen voor verzoeken naar de gecachte schijf.
Als we naar de functie kijken generic_make_request(), zullen we zien dat er vóór het begin van de accountancy van het verzoek nog twee functies worden aangeroepen. De eerste is generic_make_request_checks(), die de legitimiteit van het verzoek controleert met betrekking tot de schijfinstellingen. De tweede is , waarin er een interessante aanroep is :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
Hier wacht de kernel op het ontdooien van de wachtrij. Laten we de vertraging meten blk_queue_enter():
~# /usr/share/bcc/tools/funclatency  blk_queue_enter -i 1 -m
Functies van "blk_queue_enter" traceren... Druk op Ctrl-C om te beëindigen.

 	msecs           	: count 	distributie
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: count 	distributie
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: count 	distributie
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Het lijkt erop dat we dicht bij de oplossing komen. De functies die worden gebruikt voor het "bevriezen/ontdooien" van de wachtrij zijn en . Ze worden gebruikt wanneer het nodig is om de instellingen van de verzoekwachtrij te wijzigen, wat potentieel gevaarlijk is voor de verzoeken die zich in deze wachtrij bevinden. Wanneer blk_mq_freeze_queue() wordt aangeroepen door de functie wordt de teller q->mq_freeze_depth. Nadat de kernel wacht op het legen van de wachtrij in .
De wachttijd voor het legen van deze wachtrij is gelijk aan de schijfvertraging, aangezien de kernel wacht op de voltooiing van alle in de wachtrij geplaatste bewerkingen. Zodra de wachtrij leeg is, worden de configuratiewijzigingen toegepast. Daarna wordt , die de teller vermindert freeze_depth.
Nu weten we voldoende om de situatie te corrigeren. Het commando udevadm trigger leidt tot het toepassen van instellingen voor het blokapparaat. Deze instellingen zijn beschreven in de udev-regels. We kunnen ontdekken welke specifieke instellingen de wachtrij "bevriezen" door ze te proberen te wijzigen via sysfs of door de bronscode van de kernel te bekijken. Ook kunnen we de BCC-tool proberen , die stack traces van de kernel en gebruikersruimte naar de terminal zal afdrukken voor elke aanroep van blk_freeze_queue, bijvoorbeeld:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[onbekend]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[onbekend]
Udev-regels wijzigen vrij zelden en meestal gebeurt dit onder controle. We zien dus dat zelfs het toepassen van al ingestelde waarden een piek in de vertraging van de aanroep van de aanvraag naar de schijf veroorzaakt. Natuurlijk is het geen goede praktijk om udev-gebeurtenissen te genereren wanneer er geen wijzigingen in de schijfconfiguratie zijn (bijvoorbeeld wanneer een apparaat niet wordt aangesloten/afgekoppeld). Toch kunnen we de kernel helpen om geen nutteloze taken uit te voeren en de wachtrij van aanvragen niet te "bevriezen" als dat niet nodig is. corrigeren de situatie.
Conclusie
eBPF is een zeer flexibele en krachtige tool. In dit artikel hebben we een praktische case besproken en een klein deel aangetoond van wat mogelijk is te doen. Als je geïnteresseerd bent in de ontwikkeling van BCC-tools, kijk dan naar de , die de basisprincipes goed beschrijft.
Er zijn ook andere interessante tools voor debugging en profiling, gebaseerd op eBPF. Een daarvan is , waarmee krachtige one-liners en kleine programma's in een awk-achtige taal kunnen worden geschreven. Een andere is , die het mogelijk maakt om low-level hoge-resolutie metrics rechtstreeks naar uw Prometheus-server te verzamelen, met de mogelijkheid om later mooie visualisaties en zelfs meldingen te ontvangen.
Bron: habr.com
