

In dit artikel leg ik uit hoe we het probleem van de redundantie van PostgreSQL hebben aangepakt, waarom dit voor ons belangrijk is en wat het uiteindelijke resultaat is.
We hebben een high-traffic service: 2,5 miljoen gebruikers over de hele wereld, meer dan 50K actieve gebruikers per dag. De servers bevinden zich in Amazone in één regio in Ierland: er draaien voortdurend meer dan 100 verschillende servers, waarvan bijna 50 met databases.
De gehele backend is een groot monolithisch stateful-applicatie op Java, die een constante websocketverbinding met de cliënt onderhoudt. Wanneer meerdere gebruikers tegelijkertijd aan hetzelfde bord werken, zien ze allemaal veranderingen in real-time, omdat we elke wijziging in de database vastleggen. We hebben ongeveer 10K verzoeken per seconde naar onze databases. Bij piekbelasting schrijven we in Redis 80-100K verzoeken per seconde.
Waarom we zijn overgestapt van Redis naar PostgreSQL
Aanvankelijk werkte onze service met Redis, een key-value opslag die alle gegevens in het geheugen opslaat. de server.
Voordelen van Redis:
- Hoge responssnelheid, omdat alles in het geheugen is opgeslagen;
- Gemak van back-up en replicatie.
Nadelen van Redis voor ons:
- Geen echte transacties. We probeerden ze op het niveau van onze applicatie te simuleren. Helaas werkte dit niet altijd goed en vereiste het het schrijven van zeer complexe code.
- De gegevenshoeveelheid is beperkt door de hoeveelheid geheugen. Wanneer de hoeveelheid gegevens toeneemt, zal het geheugen toenemen en uiteindelijk stuiten we op de eigenschappen van de gekozen instance, wat in AWS vereist dat we onze service stoppen om het type instance te wijzigen.
- We moeten voortdurend een laag latency-niveau handhaven, omdat we een zeer hoog aantal verzoeken hebben. Het optimale latency-niveau voor ons is 17-20 ms. Bij een niveau van 30-40 ms ontvangen we lange reacties op verzoeken van onze applicatie en vervalt de service. Helaas gebeurde dit in september 2018, toen een van de instances met Redis om de een of andere reden een latency kreeg die twee keer zo hoog was als normaal. Om het probleem op te lossen, hebben we de service halverwege de werkdag stopgezet voor niet-geplande onderhoudswerkzaamheden en hebben we de probleem-instance van Redis vervangen.
- Het is gemakkelijk om inconsistentie in gegevens te krijgen, zelfs bij kleine fouten in de code, en daarna veel tijd te besteden aan het schrijven van code om deze gegevens te corrigeren.
We considered the downsides and realized we needed to switch to something more convenient, with normal transactions and less dependence on latency. We conducted research, analyzed many options, and chose PostgreSQL.
We've been migrating to the new database for 1.5 years and have only moved a small part of the data, so we are currently working simultaneously with Redis and PostgreSQL. More details about the migration stages and data switching between databases are outlined in my colleague's article.
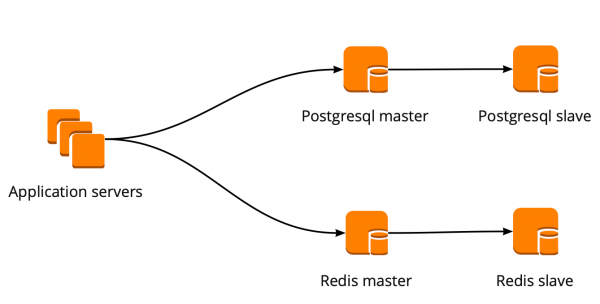
When we first started migrating, our application interacted directly with the database and accessed both the Redis master and PostgreSQL. The PostgreSQL cluster consisted of a master and a replica with asynchronous replication. This is how the database operation scheme looked:
Implementing PgBouncer
While we were migrating, the product also evolved: the number of users and the servers working with PostgreSQL increased, and we found ourselves running out of connections. PostgreSQL creates a separate process for each connection, consuming resources. Increasing the number of connections can only go so far; otherwise, there is a risk of suboptimal database performance. The ideal solution in such a situation would be to choose a connection manager that sits in front of the database.
We had two options for the connection manager: Pgpool and PgBouncer. However, the former does not support transactional mode with the database, so we chose PgBouncer.
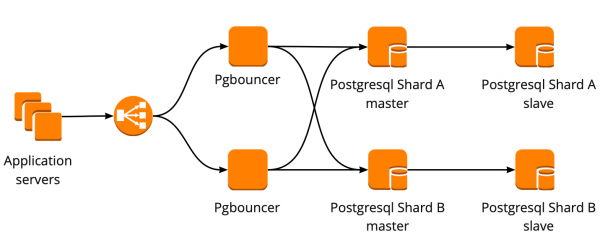
We configured the following operational scheme: our application connects to one PgBouncer, behind which are the PostgreSQL masters, and behind each master is one replica with asynchronous replication.
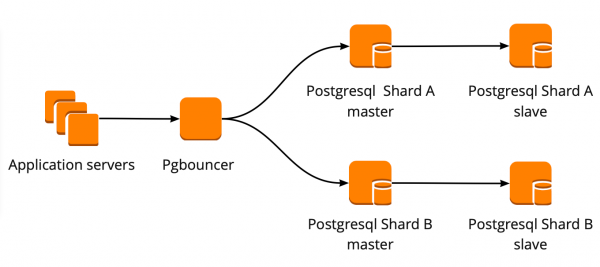
At the same time, we could not store the entire volume of data in PostgreSQL and speed was crucial for us, so we began sharding PostgreSQL at the application level. The scheme described above is relatively convenient for this: when adding a new shard, it is sufficient to update the PgBouncer configuration, and the application can immediately work with the new shard.
Fault tolerance of PgBouncer
Dit schema werkte totdat de enige PgBouncer-instantie uitviel. We bevinden ons in AWS, waar alle instanties draaien op hardware die periodiek uitvalt. In dergelijke gevallen verhuist de instantie gewoon naar nieuwe hardware en werkt weer. Dit gebeurde ook met PgBouncer, maar het werd niet beschikbaar. Het resultaat van deze uitval was dat onze dienst gedurende 25 minuten niet bereikbaar was. AWS adviseert voor dergelijke situaties om redundantie aan de gebruikerszijde te gebruiken, wat op dat moment niet bij ons was geïmplementeerd.
Hierna begonnen we serieus na te denken over de redundantie van PgBouncer en PostgreSQL-clusters, omdat een dergelijke situatie zich met elke instantie in ons AWS-account kon herhalen.
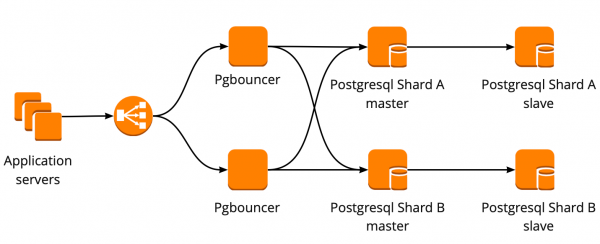
We hebben het redundantiemodel van PgBouncer als volgt opgebouwd: alle applicatieservers maken verbinding met een Network Load Balancer, achter welke twee PgBouncer-instanties staan. Elke PgBouncer kijkt naar dezelfde master PostgreSQL van elke shard. In het geval van een herhaling van de uitvalsituatie van AWS, wordt al het verkeer omgeleid via een andere PgBouncer. De redundantie van de Network Load Balancer wordt door AWS gegarandeerd.
Dit schema stelt ons in staat om probleemloos nieuwe PgBouncer-servers toe te voegen.
Het creëren van een redundant PostgreSQL-cluster.
Bij het oplossen van deze taak hebben we verschillende opties overwogen: zelfgeschreven failover, repmgr, AWS RDS, Patroni.
Eigen scripts
Ze kunnen het werk van de master monitoren en, in geval van een uitval, de replicant promoveren tot master en de PgBouncer-configuratie bijwerken.
De voordelen van deze aanpak zijn de maximale eenvoud, omdat je zelf de scripts schrijft en precies begrijpt hoe ze werken.
Nadelen:
- De master kan niet zijn uitgevallen; in plaats daarvan kan er een netwerkstoring hebben plaatsgevonden. Failover zal, zonder hiervan op de hoogte te zijn, de replicant promoveren tot master, terwijl de oude master blijft draaien. Dit resulteert in twee servers in de rol van master, en we weten niet op welke van de twee de meest recente gegevens staan. Deze situatie wordt ook split-brain genoemd;
- We zijn zonder replicant gebleven. In onze configuratie is er een master en één replicant, na de switch wordt de replicant tot master gepromoveerd en hebben we geen replicanten meer, dus moeten we handmatig een nieuwe replicant toevoegen;
- Er is extra monitoring van de failover nodig, waarbij we 12 PostgreSQL-shards hebben, wat betekent dat we 12 clusters moeten monitoren. Bij een toename van het aantal shards moeten we ook de failover niet vergeten bij te werken.
Een zelfgeschreven failover lijkt erg ingewikkeld en vereist aanzienlijke ondersteuning. Met één PostgreSQL-cluster is dit de eenvoudigste optie, maar het schaalt niet, dus het is niet geschikt voor ons.
Repmgr
Replication Manager voor PostgreSQL-clusters die het clusterbeheer van PostgreSQL kan uitvoeren. Het ontbreekt echter aan automatische failover 'uit de doos', dus je moet je eigen 'wrapper' schrijven bovenop de bestaande oplossing. Het kan zelfs ingewikkelder zijn dan met zelfgeschreven scripts, daarom hebben we Repmgr zelfs niet geprobeerd.
AWS RDS
Biedt alles wat we nodig hebben, kan back-ups maken en ondersteunt connection pooling. Het heeft automatische overschakeling: als de master uitvalt, wordt de replica de nieuwe master, en AWS wijzigt het DNS-record naar de nieuwe master, terwijl de replica's zich in verschillende AZ's kunnen bevinden.
Nadelen zijn onder andere het ontbreken van fijne instellingen. Voorbeeld van fijne instellingen: op onze instanties zijn er beperkingen voor TCP-verbindingen, wat helaas niet mogelijk is in RDS.
net.ipv4.tcp_keepalive_time=10
net.ipv4.tcp_keepalive_intvl=1
net.ipv4.tcp_keepalive_probes=5
net.ipv4.tcp_retries2=3
Bovendien is de prijs van AWS RDS bijna twee keer zo duur als de normale prijs van een instantie, wat de belangrijkste reden was om van deze oplossing af te zien.
Patroni
Dit is een sjabloon in Python voor het beheren van PostgreSQL met goede documentatie, automatische failover en de broncode op GitHub.
Voordelen van Patroni:
- Elk configuratieparameter is beschreven, het is duidelijk hoe alles werkt;
- Automatische failover werkt uit de doos;
- Het is geschreven in Python, en omdat wij zelf veel in Python schrijven, zullen we gemakkelijker problemen kunnen begrijpen en misschien zelfs kunnen helpen bij de ontwikkeling van het project;
- Beheert PostgreSQL volledig, stelt in staat om de configuratie rechtstreeks op alle nodes van het cluster te wijzigen, en als het opnieuw opstarten van het cluster nodig is om een nieuwe configuratie toe te passen, kan dit opnieuw met Patroni worden gedaan.
Nadelen:
- Uit de documentatie is het onduidelijk hoe je correct met PgBouncer moet omgaan. Hoewel dit moeilijk een nadeel te noemen is, omdat de taak van Patroni is om PostgreSQL te beheren, en hoe de verbindingen naar Patroni lopen is al onze verantwoordelijkheid;
- Er zijn weinig voorbeelden van het implementeren van Patroni op grote schaal, terwijl er veel voorbeelden zijn van implementaties vanaf nul.
Uiteindelijk hebben we gekozen voor Patroni om een fouttolerant cluster te creëren.
Het proces van het implementeren van Patroni
Voor Patroni hadden we 12 shards van PostgreSQL in een configuratie van één master en één replica met asynchrone replicatie. De applicatieservers maakten verbinding met de databases via de Network Load Balancer, achter welke twee instanties met PgBouncer stonden, en daarachter bevonden zich alle PostgreSQL-servers.
Voor de implementatie van Patroni moesten we een gedistribueerde configuratieopslag voor de cluster kiezen. Patroni werkt met gedistribueerde configuratiesystemen zoals etcd, Zookeeper, Consul. We hebben al een volledige Consul-cluster in production draaien die samenwerkt met Vault en verder gebruiken we deze niet. Een uitstekende gelegenheid om Consul voor het beoogde doel te gaan gebruiken.
Hoe Patroni met Consul werkt
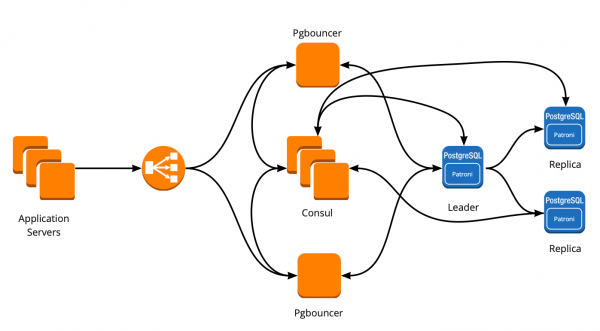
We hebben een Consul-cluster dat bestaat uit drie nodes en een Patroni-cluster dat bestaat uit een leider en een replica (in Patroni wordt de master een clusterleider genoemd en de slaves replicas). Elke instance van het Patroni-cluster stuurt voortdurend informatie over de status van het cluster naar Consul. Daarom kan je altijd de actuele configuratie van het Patroni-cluster en wie op dat moment de leider is, bij Consul opvragen.
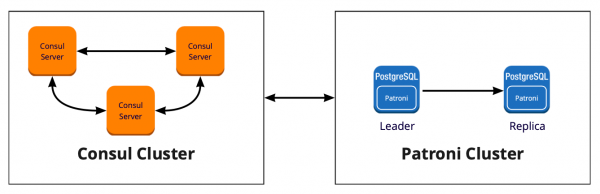
Om Patroni met Consul te verbinden is het voldoende om de officiële documentatie te bestuderen, waarin staat dat je de host in het http- of https-formaat moet opgeven, afhankelijk van hoe we met Consul werken, en optioneel het verbindingsschema:
host: de host:poort voor de Consul-eindpunt, in het formaat: http(s)://host:poort
schema: (optioneel) http of https, standaard http
Het lijkt eenvoudig, maar hier beginnen de complicaties. We werken met Consul via een beveiligde verbinding via https, en onze verbindingsconfiguratie zal er als volgt uitzien:
consul:
  host: https://server.production.consul:8080
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Maar zo werkt het niet. Bij het starten kan Patroni geen verbinding maken met Consul, omdat het toch probeert verbinding te maken via http.
De oplossing voor het probleem kwam uit de broncode van Patroni. Gelukkig is het geschreven in Python. Het blijkt dat de parameter host op geen enkele manier wordt geparsed, en dat het protocol in de schema moet worden opgegeven. Zo ziet het werkende configuratieblok eruit voor het werken met Consul bij ons:
consul:
  host: server.production.consul:8080
  scheme: https
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Consul-template
Dus, we hebben een opslag voor de configuratie gekozen. Nu moeten we begrijpen hoe PgBouncer zijn configuratie wijzigt bij het wisselen van leider in het Patroni-cluster. In de documentatie is hier geen antwoord op te vinden, aangezien er in feite niet wordt ingegaan op het werken met PgBouncer.
Op zoek naar een oplossing vonden we een artikel (de titel kan ik helaas niet herinneren), waarin stond dat Consul-template erg nuttig was in de koppeling tussen PgBouncer en Patroni. Dit bracht ons ertoe om de werking van Consul-template verder te onderzoeken.
Het bleek dat Consul-template continu de configuratie van het PostgreSQL-cluster in Consul monitort. Bij het wisselen van leider wordt de configuratie van PgBouncer bijgewerkt en wordt er een opdracht verzonden om deze opnieuw te laden.
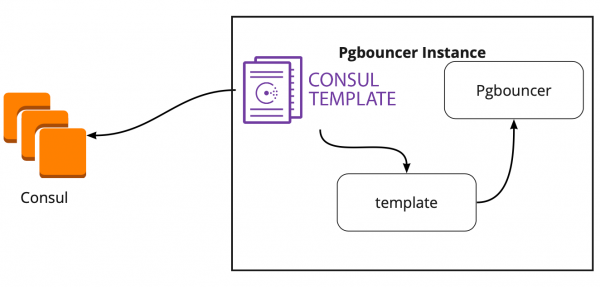
Een groot voordeel van de template is dat deze in de vorm van code wordt opgeslagen. Dus bij het toevoegen van een nieuwe shard is het voldoende om een nieuwe commit te maken en de template automatisch te updaten, waardoor het principe van Infrastructure as Code wordt gehandhaafd.
Nieuwe architectuur met Patroni
Uiteindelijk kregen we het volgende werkingsschema:
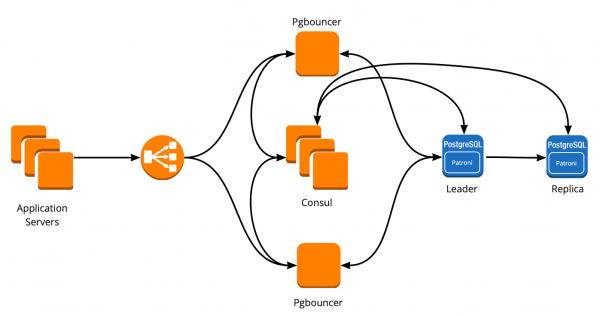
Alle applicatieservers wendden zich tot de load balancer → hierachter staan twee PgBouncer-instanties → op elke instantie draait Consul-template, dat de status van elk Patroni-cluster monitort en de actualiteit van de PgBouncer-configuratie in de gaten houdt, die verzoeken naar de huidige leider van elk cluster stuurt.
Handmatige test
Deze schema hebben we voor productie op een kleine testomgeving draaien en de werking van de automatische overschakeling gecontroleerd. We openden het bord, verplaatsten de sticker en op dat moment 'verwijderden' we de leider van het cluster. In AWS is het voldoende om de instantie via de console uit te schakelen.
De sticker kwam binnen 10-20 seconden terug, en daarna begon deze weer normaal te bewegen. Dit betekent dat het Patroni-cluster goed functioneerde: het wisselde van leider, verstuurde informatie naar Consul, en Consul-template nam deze informatie onmiddellijk over, verving de PgBouncer-configuratie en stuurde een opdracht om te herladen.
Hoe te overleven onder hoge belasting en minimale downtime te behouden?
Alles werkt uitstekend! Maar er rijzen nieuwe vragen: Hoe zal dit werken onder hoge belasting? Hoe snel en veilig alles op de productie uitrollen?
De eerste vraag beantwoorden we met behulp van een testomgeving, waarop we belastingstests uitvoeren. Deze is volledig identiek aan de productieomgeving qua architectuur en heeft gegenereerde testgegevens die qua hoeveelheid ongeveer gelijk zijn aan die in de productie. We besluiten simpelweg om een van de PostgreSQL-masters tijdens de test ‘uit te schakelen’ en kijken wat er gebeurt. Maar het is belangrijk om eerst de automatische implementatie te controleren, want in deze omgeving hebben we verschillende PostgreSQL-shards, zodat we een uitstekende test van de configuratiescripts voor de productie kunnen uitvoeren.
Beide taken lijken ambitieus, maar we hebben PostgreSQL 9.6. Misschien kunnen we direct naar 11.2 upgraden?
We besluiten dit in twee fasen te doen: eerst de versie upgraden naar 11.2, daarna Patroni starten.
PostgreSQL-upgrade
Voor een snelle upgrade van de PostgreSQL-versie moet de optie worden gebruikt -k, waarbij harde links op de schijf worden gemaakt en er geen kopie van uw gegevens nodig is. Bij databases van 300-400 GB duurt de upgrade 1 seconde.
We hebben veel shards, dus de upgrade moet automatisch worden uitgevoerd. Daarvoor hebben we een Ansible-playbook geschreven dat het hele upgradeproces voor ons uitvoert:
/usr/lib/postgresql/11/bin/pg_upgrade
<b>--link </b>
--old-datadir='' --new-datadir=''
 --old-bindir=''  --new-bindir=''
 --old-options=' -c config_file='
 --new-options=' -c config_file='
Het is belangrijk op te merken dat voor het starten van de upgrade dit moet worden uitgevoerd met de parameter —check, om er zeker van te zijn dat de upgrade mogelijk is. Ook vervangt ons script de configuraties tijdens de upgrade. Ons script uitgevoerd in 30 seconden, wat een uitstekend resultaat is.
Starten van Patroni
Om het tweede probleem op te lossen, is het voldoende om naar de configuratie van Patroni te kijken. In de officiële repository is er een voorbeeldconfiguratie met initdb, die verantwoordelijk is voor de initialisatie van een nieuwe database bij de eerste start van Patroni. Maar omdat we al een bestaande database hebben, hebben we dit gedeelte gewoon uit de configuratie verwijderd.
Toen we Patroni begonnen te installeren op een bestaande PostgreSQL-cluster en het opstartten, stuitten we op een nieuw probleem: beide servers startten als leader. Patroni weet niet van de eerdere staat van de cluster en probeert beide servers te starten als twee afzonderlijke clusters met dezelfde naam. Om dit probleem op te lossen, moet de gegevensdirectory op de slave worden verwijderd:
rm -rf /var/lib/postgresql/Dit moet alleen op de slave worden gedaan!
Bij het verbinden met een schone replica maakt Patroni een basebackup van de leader en herstelt deze op de replica, en haalt vervolgens de actuele staat in via de wal-logs.
Een andere complexiteit waarmee we te maken kregen, is dat alle PostgreSQL-clusters standaard 'main' worden genoemd. Wanneer elk cluster niets over het andere weet, is dat normaal. Maar wanneer je Patroni wilt gebruiken, moeten alle clusters een unieke naam hebben. De oplossing is om de naam van het cluster in de PostgreSQL-configuratie te wijzigen.
Loadtest
We hebben een test uitgevoerd die het gedrag van gebruikers op de borden simuleert. Toen de belasting ons gemiddelde dagelijkse niveau bereikte, herhaalden we precies dezelfde test en schakelden we één instance met de leader PostgreSQL uit. De automatische failover werkte zoals we verwachtten: Patroni verving de leader, Sconsul-template bijgewerkt de PgBouncer-configuratie en gaf een opdracht om te herladen. Uit onze grafieken in Grafana bleek dat er vertragingen waren van 20-30 seconden en een klein aantal fouten van de servers met betrekking tot de verbinding met de database. Dit is een normale situatie, dergelijke waarden zijn acceptabel voor onze failover en beslist beter dan de down tijd van de service.
Uitvoer van Patroni in productie
Uiteindelijk hebben we het volgende plan opgesteld:
- Deploy Sconsul-template op de PgBouncer-servers en opstarten;
- Updates van PostgreSQL naar versie 11.2;
- Verander de naam van het cluster;
- Start het Patroni-cluster.
Onze schema stelt ons in staat om het eerste punt praktisch op elk moment te maken; we kunnen elk PgBouncer om de beurt uitschakelen en de consul-template op hem implementeren en opstarten. Zo hebben we het ook gedaan.
Voor de snelle uitrol hebben we Ansible gebruikt, omdat we alle playbooks al op de testomgeving hadden gecontroleerd, en de uitvoeringstijd van het volledige scenario varieerde van 1,5 tot 2 minuten per shard. We konden alles om de beurt op elke shard uitrollen zonder onze service te onderbreken, maar we zouden elk PostgreSQL een paar minuten moeten uitschakelen. In dit geval konden gebruikers wiens gegevens op deze shard staan, niet volledig werken tijdens deze tijd, wat voor ons onaanvaardbaar is.
De oplossing voor deze situatie was een geplande maintenance die elke 3 maanden plaatsvindt. Dit is een periode voor gepland werk, waarin we onze service volledig uitschakelen en de database-instanties bijwerken. Er was nog maar een week tot het volgende onderhoud, en we besloten gewoon te wachten en ons verder voor te bereiden. In de tussentijd hebben we extra voorzorgsmaatregelen genomen: voor elke PostgreSQL-shard hebben we een reserve-replica opgezet voor het geval dat er iets misgaat, om de meest actuele gegevens te behouden, en we hebben een nieuwe instantie voor elke shard toegevoegd die een nieuwe replica in het Patroni-cluster moet worden, zodat we de opdracht voor het verwijderen van gegevens niet hoeven uit te voeren. Dit hielp het risico op fouten tot een minimum te beperken.
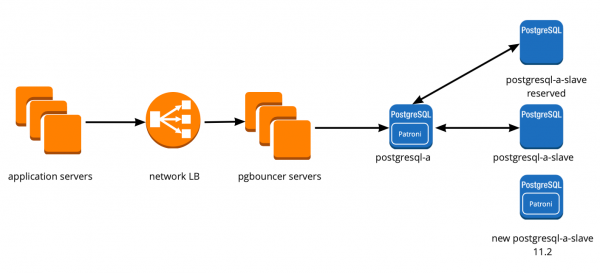
We hebben onze service opnieuw opgestart, alles werkte zoals het hoort, de gebruikers konden verder werken, maar op de grafieken zagen we abnormaal hoge belasting op de Consul-servers.
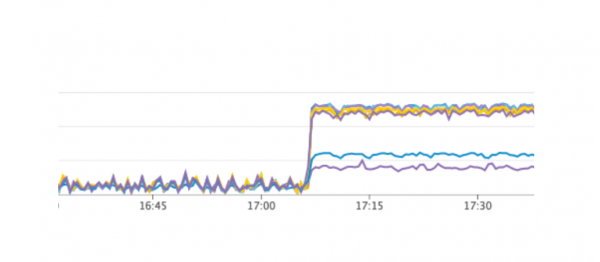
Waarom hebben we dit niet in de testomgeving gezien? Dit probleem illustreert heel goed dat we het principe van Infrastructure as Code moeten volgen en onze gehele infrastructuur moeten verbeteren, vanaf de testomgevingen tot aan productie. Anders is het heel gemakkelijk om zo'n probleem te krijgen als wij dat hebben. Wat is er gebeurd? Consul verscheen eerst in productie en daarna in de testomgevingen, waardoor de versie van Consul in de testomgevingen hoger was dan in productie. In een van de releases was er een CPU-lek opgelost bij het werken met consul-template. Daarom hebben we gewoon Consul bijgewerkt, waarmee we het probleem oplosten.
Herstart het Patroni-cluster
Echter, we kregen een nieuw probleem waar we niet eens van verdacht waren. Bij het bijwerken van Consul verwijderen we gewoon de Consul-knoop uit het cluster met het commando consul leave → Patroni maakt verbinding met een andere Consul-server → alles werkt. Maar toen we bij de laatste instantie van het Consul-cluster kwamen en hem het commando consul leave gaven, herstarten alle Patroni-clusters gewoon en zagen we de volgende fout in de logs:
FOUT: get_cluster
Traceback (meest recente aanroep laatst):
...
RetryFailedError: 'Overschreden retry-deadline'
FOUT: Fout bij communicatie met DCS
<b>LOG: databasesysteem is afgesloten</b>
Het Patroni-cluster kon geen informatie over zijn cluster verkrijgen en herstartte.
Om een oplossing te vinden, hebben we contact opgenomen met de makers van Patroni via een issue op GitHub. Ze hebben verbeteringen aan onze configuratiebestanden voorgesteld:
consul:
 consul.checks: []
bootstrap:
 dcs:
   retry_timeout: 8
We konden het probleem in de testomgeving reproduceren en hebben deze parameters daar getest, maar helaas werkten ze niet.
Het probleem is nog steeds niet opgelost. We zijn van plan de volgende oplossingen te proberen:
- Gebruik de Consul-agent op elke instantie van het Patroni-cluster;
- Los het probleem in de code op.
Het is ons duidelijk waar de fout ontstaat: waarschijnlijk ligt het probleem bij de standaard timeout, die niet wordt overschreven via het configuratiebestand. Bij het verwijderen van de laatste Consul-server uit het cluster hangt het hele Consul-cluster langer dan een seconde, waardoor Patroni de status van het cluster niet kan krijgen en het hele cluster opnieuw opstart.
Gelukkig hebben we geen verdere fouten ondervonden.
Resultaten van het gebruik van Patroni
Na de succesvolle lancering van Patroni hebben we een extra replica aan elk cluster toegevoegd. Nu heeft elk cluster een soort quorum: één leider en twee replicas, voor de zekerheid in geval van split-brain tijdens de omschakeling.
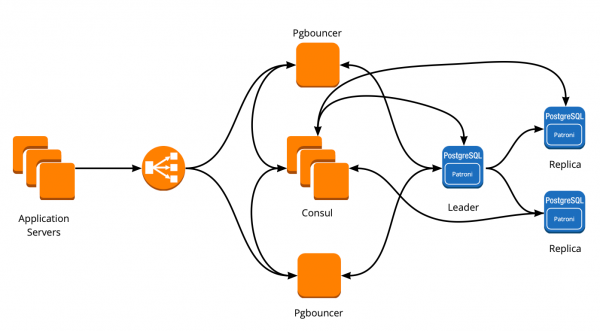
Op de productie draait Patroni al meer dan drie maanden. In deze tijd heeft het ons al geholpen. Onlangs overleed de leider van een van de clusters in AWS, de automatische failover werkte en gebruikers konden doorgaan met werken. Patroni voldeed aan zijn belangrijkste taak.
Een korte samenvatting van het gebruik van Patroni:
- Gemak van configuratiewijzigingen. Het is voldoende om de configuratie op één instantie te wijzigen en deze wordt naar het hele cluster doorgetrokken. Als een herstart nodig is voor de toepassing van de nieuwe configuratie, zal Patroni dit melden. Patroni kan het hele cluster opnieuw opstarten met één opdracht, wat ook erg handig is.
- Automatische failover werkt en heeft ons al geholpen.
- Bijwerken van PostgreSQL zonder downtime van de applicatie. Eerst moeten de replicas naar de nieuwe versie worden bijgewerkt, daarna moet de leider in het Patroni-cluster worden gewijzigd en de oude leider worden bijgewerkt. Tijdens dit proces vindt de noodzakelijke test van de automatische failover plaats.
Bron: habr.com
