

Een paar jaar geleden werd Kubernetes op de officiële GitHub-blog. Sindsdien is het de standaardtechnologie geworden voor het implementeren van services. Nu beheert Kubernetes een aanzienlijk deel van de interne en openbare diensten. Naarmate onze clusters zijn gegroeid en de prestatievereisten strenger zijn geworden, hebben we gemerkt dat er sporadisch vertragingen optreden in sommige diensten op Kubernetes die niet te verklaren zijn door de belasting van de applicatie zelf.
In wezen treedt er een willekeurige netwerklatentie op in applicaties tot 100 ms of meer, wat leidt tot time-outs of herhalingspogingen. Het was de verwachting dat de diensten veel sneller op verzoeken zouden kunnen reageren dan 100 ms. Maar dat is onmogelijk als de verbinding zelf zo veel tijd kost. We hebben ook zeer snelle MySQL-aanvragen geobserveerd die milliseconden moesten duren, en MySQL deed dat inderdaad in milliseconden, maar vanuit het perspectief van de aanroepende applicatie duurde het antwoord 100 ms of langer.
Het was meteen duidelijk dat het probleem alleen optrad bij het verbinden met een Kubernetes-knoop, zelfs als de oproep van buiten Kubernetes kwam. De eenvoudigste manier om het probleem te reproduceren is in een test , die vanaf elk intern host draait, de Kubernetes-service op een bepaalde poort test en sporadisch grote vertraging registreert. In dit artikel zullen we bekijken hoe we de oorzaak van dit probleem konden traceren.
Onnodige complexiteit in de foutketen verwijderen
Door hetzelfde voorbeeld te reproduceren, wilden we de focus van het probleem versmallen en onnodige complexiteit verwijderen. Aanvankelijk waren er te veel elementen in de stroom tussen Vegeta en de pods op Kubernetes. Om een diepgaandere netwerkprobleem te bepalen, moesten we enkele van hen uitsluiten.
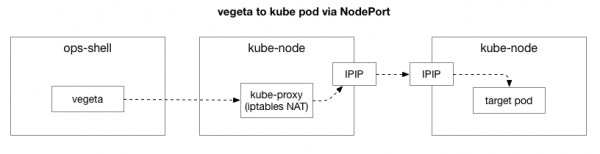
De client (Vegeta) maakt een TCP-verbinding met een willekeurige knoop in het cluster. Kubernetes functioneert als een overlay-netwerk (bovenop het bestaande datacenter-netwerk), dat gebruikmaakt van , wat betekent dat het IP-pakketten van het overlay-netwerk in IP-pakketten van het datacenter encapsuleert. Bij het verbinden met de eerste knoop wordt er een netwerkadresvertaling uitgevoerd. (NAT) met statusbewaking voor het omzetten van het IP-adres en de poort van de Kubernetes-knoop naar het IP-adres en de poort in het overlay-netwerk (in het bijzonder, de pod met de applicatie). Voor binnenkomende pakketten wordt de omgekeerde volgorde van handelingen uitgevoerd. Dit is een gecompliceerd systeem met veel staten en elementen die continu worden bijgewerkt en veranderd tijdens de implementatie en verplaatsing van diensten.
Hulpprogramma tcpdump in de Vegeta-test veroorzaakt vertraging tijdens de TCP-handshake (tussen SYN en SYN-ACK). Om deze onnodige complexiteit te verminderen, kan men hping3 voor eenvoudige 'pings' met SYN-pakketten. We controleren of er vertraging is in het antwoordpakket en zetten vervolgens de verbinding opnieuw. We kunnen de gegevens filteren door alleen pakketten van meer dan 100 ms op te nemen, en zo een eenvoudigere manier te bieden om het probleem te reproduceren dan een volledige netwerktest op niveau 7 in Vegeta. Hier zijn de 'pings' van de Kubernetes-knoop met gebruik van TCP SYN/SYN-ACK op de 'knooppoort' van de service (30927) met een interval van 10 ms, gefilterd op de langzaamste antwoorden:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -S -p 30927 -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1485 win=29200 rtt=127.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1486 win=29200 rtt=117.0 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1487 win=29200 rtt=106.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1488 win=29200 rtt=104.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5024 win=29200 rtt=109.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5231 win=29200 rtt=109.2 ms
We kunnen meteen de eerste observatie doen. Aan de volgnummer en timing is te zien dat dit geen eenmalige congesties zijn. De vertraging stapelt zich vaak op en wordt uiteindelijk verwerkt.
Daarna willen we uitzoeken welke componenten betrokken kunnen zijn bij het ontstaan van de congestie. Is het misschien één van de honderden iptables-regels in NAT? Of zijn er problemen met IPIP-tunneling in het netwerk? Een manier om dit te verifiëren, is om elke stap van het systeem te controleren door deze uit te sluiten. Wat gebeurt er als we NAT en de firewall-logica weglaten en alleen het IPIP-gedeelte overhouden:
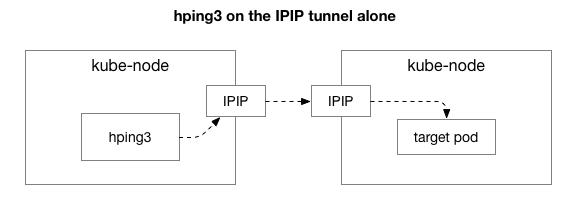
Gelukkig maakt Linux het gemakkelijk om rechtstreeks toegang te krijgen tot de overlay-laag van IP, als de machine zich in hetzelfde netwerk bevindt:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7346 win=0 rtt=127.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7347 win=0 rtt=117.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7348 win=0 rtt=107.2 ms
Op basis van de resultaten blijft het probleem bestaan! Dit sluit iptables en NAT uit. Dus, ligt het probleem bij TCP? Laten we eens kijken hoe de normale ICMP-ping verloopt:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=28 ip=10.125.20.64 ttl=64 id=42594 icmp_seq=104 rtt=110.0 ms
len=28 ip=10.125.20.64 ttl=64 id=49448 icmp_seq=4022 rtt=141.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49449 icmp_seq=4023 rtt=131.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49450 icmp_seq=4024 rtt=121.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49451 icmp_seq=4025 rtt=111.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49452 icmp_seq=4026 rtt=101.1 ms
len=28 ip=10.125.20.64 ttl=64 id=50023 icmp_seq=4343 rtt=126.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50024 icmp_seq=4344 rtt=116.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50025 icmp_seq=4345 rtt=106.8 ms
len=28 ip=10.125.20.64 ttl=64 id=59727 icmp_seq=9836 rtt=106.1 ms
De resultaten tonen aan dat het probleem niet is verdwenen. Is het misschien een IPIP-tunnel? Laten we de test vereenvoudigen:
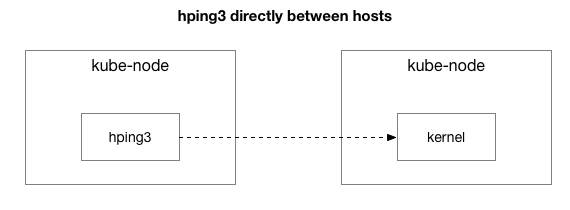
Worden alle pakketten tussen deze twee hosts verzonden?
theojulienne@kube-node-client ~ $ sudo hping3 172.16.47.27 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 id=41127 icmp_seq=12564 rtt=140.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41128 icmp_seq=12565 rtt=130.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41129 icmp_seq=12566 rtt=120.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41130 icmp_seq=12567 rtt=110.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41131 icmp_seq=12568 rtt=100.7 ms
len=46 ip=172.16.47.27 ttl=61 id=9062 icmp_seq=31443 rtt=134.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9063 icmp_seq=31444 rtt=124.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9064 icmp_seq=31445 rtt=114.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9065 icmp_seq=31446 rtt=104.2 ms
We hebben de situatie vereenvoudigd tot twee Kubernetes-knooppunten die elkaar elk pakket, zelfs een ICMP-ping, verzenden. Ze ervaren nog steeds vertraging als de doelsite 'slecht' is (sommige zijn slechter dan andere).
Nu de laatste vraag: waarom ontstaat er alleen vertraging op de kube-node servers? En doet het zich voor wanneer de kube-node de verzender of de ontvanger is? Gelukkig is dit ook vrij eenvoudig te achterhalen door een pakket te sturen vanaf een host buiten Kubernetes, maar met dezelfde 'bekende slechte' ontvanger. Zoals we zien, is het probleem niet verdwenen:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=312 win=0 rtt=108.5 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=5903 win=0 rtt=119.4 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=6227 win=0 rtt=139.9 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=7929 win=0 rtt=131.2 ms
Laten we vervolgens dezelfde verzoeken doen vanaf de vorige bron kube-node naar de externe host (wat de uitgangshost uitsluit, omdat ping zowel RX als TX omvat):
theojulienne@kube-node-client ~ $ sudo hping3 172.16.33.44 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
 ^C
 --- 172.16.33.44 hping-statistiek ---
 22352 pakketten verzonden, 22350 pakketten ontvangen, 1% pakketverlies
 rondreis min/gemiddeld/max = 0.2/7.6/1010.6 ms
Na het bestuderen van de pakketcaptures met vertraging hebben we aanvullende informatie verkregen. In het bijzonder dat de afzender (onder) deze time-out opmerkt, terwijl de ontvanger (boven) dit niet ziet — zie de kolom Delta (in seconden):
Bovendien, als we kijken naar het verschil in de volgorde van TCP- en ICMP-pakketten (op volgnummer) aan de kant van de ontvanger, worden ICMP-pakketten altijd in dezelfde volgorde ontvangen als ze zijn verzonden, maar met verschillende timing. Ondertussen komen TCP-pakketten soms in een andere volgorde binnen en kunnen sommige vast komen te zitten. In het bijzonder, als we de poorten van SYN-pakketten bestuderen, komen ze aan de kant van de afzender in volgorde binnen, maar aan de kant van de ontvanger niet.
Er is een subtiel verschil in hoe moderne servers (zoals in ons datacenter) pakketten behandelen die TCP of ICMP bevatten. Wanneer een pakket binnenkomt, 'hasht' de netwerkadapter het op de verbinding, wat betekent dat het probeert verbindingen over verschillende queues te verspreiden en elke queue naar een aparte processor te sturen. Voor TCP omvat deze hash zowel het bron- als het bestemmings-IP-adres en de poort. Met andere woorden, elke verbinding wordt (potentieel) op een andere manier gehasht. Voor ICMP worden alleen de IP-adressen gehasht, omdat er geen poorten zijn.
Een andere nieuwe observatie: gedurende deze periode zien we ICMP-vertragingen in alle communicatie tussen twee hosts, maar TCP heeft dit niet. Dit suggereert dat de oorzaak waarschijnlijk verband houdt met het hashen van RX-queues: het lijkt er bijna zeker op dat er een bottleneck is in de verwerking van RX-pakketten en niet in het verzenden van antwoorden.
Dit sluit het verzenden van pakketten uit als een mogelijke oorzaak. Nu weten we dat het probleem met de verwerking van pakketten zich aan de ontvangende kant op sommige kube-node servers bevindt.
We onderzoeken de verwerking van pakketten in de Linux-kernel
Om te begrijpen waarom het probleem zich bij de ontvanger op sommige kube-node servers voordoet, laten we eens kijken naar hoe de Linux-kernel pakketten behandelt.
Terugkomend op de eenvoudigste traditionele implementatie, ontvangt de netwerkkaart een pakket en stuurt een naar de Linux-kernel dat er een pakket is dat moet worden verwerkt. De kernel stopt met de andere taken, schakelt de context over naar de interrupt-handler, verwerkt het pakket en keert dan terug naar de huidige taken.
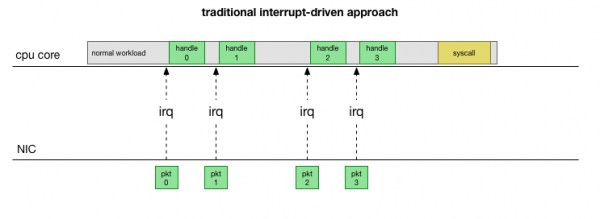
Deze contextwisseling gebeurt langzaam: misschien was de vertraging onopgemerkt op 10-megabit netwerkkarten in de jaren 90, maar op moderne 10G kaarten met een maximale doorvoer van 15 miljoen pakketten per seconde kan elke kern van een kleine achtkernige server miljoenen keren per seconde worden onderbroken.
Om niet constant interruptverwerking te moeten uitvoeren, werd jaren geleden in Linux toegevoegd : een netwerkinterface die door alle moderne drivers wordt gebruikt om de prestaties bij hoge snelheden te verbeteren. Bij lage snelheden blijft de kern interrupts van de netwerkkart op de oude manier ontvangen. Zodra er een voldoende aantal pakketten is dat de drempel overschrijdt, schakelt de kern interrupts uit en begint in plaats daarvan de netwerkadapter te ondervragen en pakketten in batches te ontvangen. De verwerking vindt plaats in softirq, dat wil zeggen in na systeemaanroepen en hardware-interrupts, wanneer de kern (in tegenstelling tot de gebruikersruimte) al draait.
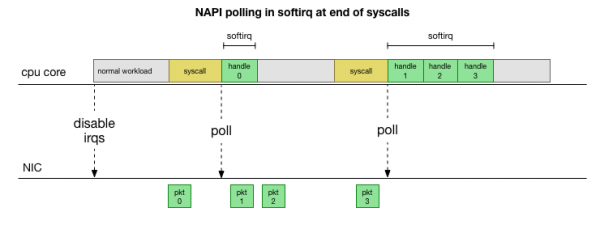
Dit is veel sneller, maar creëert een ander probleem. Als er te veel pakketten zijn, gaat al de tijd op aan de verwerking van pakketten van de netwerkkart, waardoor de processen in de gebruikersruimte niet in staat zijn om deze wachtrijen effectief te legen (lezen van TCP-verbindingen, enz.). Uiteindelijk raken de wachtrijen vol en beginnen we pakketten te laten vallen. Proberend een balans te vinden, stelt de kern een budget in voor het maximaal aantal pakketten dat in de context van softirq wordt verwerkt. Zodra dit budget is overschreden, wordt een aparte thread wakker ksoftirqd (je zult er een zien in ps voor elk core), die deze softirq buiten de normale syscall/interrupt route verwerkt. Deze thread wordt gepland met de standaard procesplanner, die probeert middelen eerlijk te verdelen.
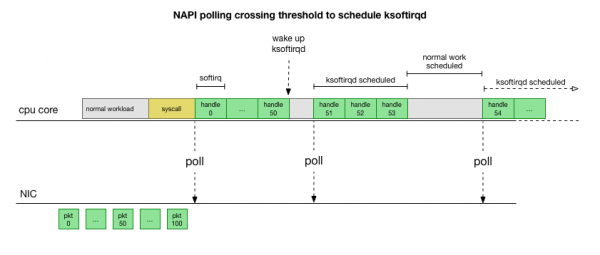
Door te bestuderen hoe de kern pakketten verwerkt, kun je opmerken dat er een zekere kans op congestie is. Als softirq-aanroepen minder vaak binnenkomen, moeten pakketten enige tijd wachten op verwerking in de RX-wachtrij van de netwerkkart. Misschien komt dit doordat een taak de kern van de processor blokkeert, of iets anders verhindert dat de kern softirq start.
We beperken de verwerking tot de kern of methode
Softirq-vertragingen zijn momenteel slechts een aanname. Maar het heeft zin, en we weten dat we iets heel vergelijkbaars observeren. Daarom is de volgende stap om deze theorie te bevestigen. En als het wordt bevestigd, moeten we de oorzaak van de vertragingen vinden.
Laten we teruggaan naar onze langzame pakketten:
len=46 ip=172.16.53.32 ttl=61 id=29573 icmp_seq=1953 rtt=99.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29574 icmp_seq=1954 rtt=89.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29575 icmp_seq=1955 rtt=79.2 ms
len=46 ip=172.16.53.32 ttl=61 id=29576 icmp_seq=1956 rtt=69.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29577 icmp_seq=1957 rtt=59.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29790 icmp_seq=2070 rtt=75.7 ms
len=46 ip=172.16.53.32 ttl=61 id=29791 icmp_seq=2071 rtt=65.6 ms
len=46 ip=172.16.53.32 ttl=61 id=29792 icmp_seq=2072 rtt=55.5 ms
Zoals eerder besproken, worden deze ICMP-pakketten gehasht in één wachtrij van de NIC RX en worden ze verwerkt door één CPU-kern. Als we de werking van Linux willen begrijpen, is het nuttig te weten waar (op welke CPU-kern) en hoe (softirq, ksoftirqd) deze pakketten worden verwerkt, zodat we het proces kunnen volgen.
Nu is het tijd om tools te gebruiken die de werking van de Linux-kernel in real-time kunnen volgen. Hier hebben we gebruikt . Deze toolset stelt ons in staat om kleine programma's in C te schrijven die willekeurige functies in de kernel onderscheppen en gebeurtenissen buffer in een Python-programma in de gebruikersruimte, dat ze kan verwerken en ons het resultaat kan teruggeven. Hooks voor willekeurige functies in de kernel zijn een complex onderwerp, maar de utility is ontworpen met maximale veiligheid en is bedoeld om precies die productieproblemen te traceren die moeilijk te reproduceren zijn in een test- of ontwikkelomgeving.
Het plan is eenvoudig: we weten dat de kernel deze ICMP-pings verwerkt, dus we gaan een hook plaatsen op de kernelfunctie , die een binnenkomend ICMP-pakket "echo request" accepteert en het verzenden van een ICMP-antwoord "echo response" initieert. We kunnen het pakket identificeren aan de hand van de toenemende icmp_seq-nummer, dat aangeeft hping3 above.
Code er moeilijk uitziet, maar het is niet zo eng als het lijkt. De functie icmp_echo geeft aan struct sk_buff *skb: is het pakket met de "echo request". We kunnen het volgen, de volgorde extraheren echo.sequence (die overeenkomt met icmp_seq van hping3 boven), en het naar de gebruikersruimte sturen. Het is ook handig om de huidige procesnaam/id vast te leggen. Hieronder staan de resultaten die we direct tijdens de verwerking van de pakketten door de kernel zien:
TGID    PID     PROCESS NAME    ICMP_SEQ
0       0       swapper/11      770
0       0       swapper/11      771
0       0       swapper/11      772
0       0       swapper/11      773
0       0       swapper/11      774
20041   20086   prometheus      775
0       0       swapper/11      776
0       0       swapper/11      777
0       0       swapper/11      778
4512    4542   spokes-report-s  779
Het moet opgemerkt worden dat in de context softirq de processen die systeemoproepen hebben gedaan, als 'processen' worden weergegeven, hoewel het in feite de kernel is die veilig pakketten in de context van de kernel verwerkt.
Met deze tool kunnen we de verbinding tussen specifieke processen en specifieke pakketten tot stand brengen die vertraging vertonen in hping3. We maken een eenvoudige grep opname voor bepaalde waarden icmp_seq. De pakketten die overeenkomen met de hierboven vermelde icmp_seq-waarden zijn gemarkeerd samen met hun RTT, die we hierboven hebben waargenomen (de verwachte RTT-waarden van de pakketten die we hebben gefilterd vanwege RTT-waarden van minder dan 50 ms worden in haakjes vermeld):
TGID    PID     PROCESS NAME    ICMP_SEQ ** RTT
--
10137   10436   cadvisor        1951
10137   10436   cadvisor        1952
76      76      ksoftirqd/11    1953 ** 99ms
76      76      ksoftirqd/11    1954 ** 89ms
76      76      ksoftirqd/11    1955 ** 79ms
76      76      ksoftirqd/11    1956 ** 69ms
76      76      ksoftirqd/11    1957 ** 59ms
76      76      ksoftirqd/11    1958 ** (49ms)
76      76      ksoftirqd/11    1959 ** (39ms)
76      76      ksoftirqd/11    1960 ** (29ms)
76      76      ksoftirqd/11    1961 ** (19ms)
76      76      ksoftirqd/11    1962 ** (9ms)
--
10137   10436   cadvisor        2068
10137   10436   cadvisor        2069
76      76      ksoftirqd/11    2070 ** 75ms
76      76      ksoftirqd/11    2071 ** 65ms
76      76      ksoftirqd/11    2072 ** 55ms
76      76      ksoftirqd/11    2073 ** (45ms)
76      76      ksoftirqd/11    2074 ** (35ms)
76      76      ksoftirqd/11    2075 ** (25ms)
76      76      ksoftirqd/11    2076 ** (15ms)
76      76      ksoftirqd/11    2077 ** (5ms)
De resultaten vertellen ons een aantal dingen. Ten eerste worden al deze pakketten verwerkt door de context ksoftirqd/11. Dit betekent dat voor dit specifieke paar machines ICMP-pakketten zijn gehasht naar kernel 11 aan de ontvangende zijde. We zien ook dat er bij elke congestie pakketten aanwezig zijn die worden verwerkt in de context van systeemoproep cadvisor. Vervolgens ksoftirqd neemt de taak het over en verwerkt de opgestapelde wachtrij: precies het aantal pakketten dat zich heeft opgestapeld na cadvisor.
Het feit dat vlak voor dit altijd cadvisoris actief, impliceert zijn betrokkenheid bij het probleem. Ironisch genoeg is de taak van om 'het gebruik van middelen en de prestatiekenmerken van de draaiende containers te analyseren', en niet om dit prestatieprobleem te veroorzaken.
Zoals met andere aspecten van containerwerk, is dit allemaal uiterst geavanceerde tooling, waar je in sommige onvoorzien omstandigheden problemen met de prestaties van kunt verwachten.
Wat doet cadvisor eigenlijk dat de pakketwachtrij vertraagt?
Nu hebben we een behoorlijk goed begrip van hoe de fout optreedt, welk proces deze veroorzaakt en op welke CPU. We zien dat door strikte locking de Linux-kernel niet tijdig kan plannen. ksoftirqd. En we zien dat de pakketten worden verwerkt in de context van cadvisor. Het is logisch om aan te nemen dat cadvisor een trage syscall aandraagt, waarna alle pakketten die in de tussentijd zijn opgelopen worden verwerkt:
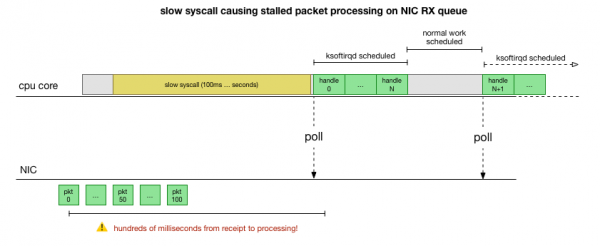
Dit is de theorie, maar hoe kunnen we deze verifiëren? Wat we kunnen doen, is de werking van de CPU-kernel gedurende dit proces volgen, het punt vinden waar het budget voor het aantal pakketten wordt overwogen en ksoftirqd wordt aangeroepen, en dan iets eerder kijken - wat er precies op de CPU-kernel werkte vlak voordat dit moment zich voordeed. Het is als een röntgenfoto van de CPU elke paar milliseconden. Het zou er ongeveer zo uitzien:
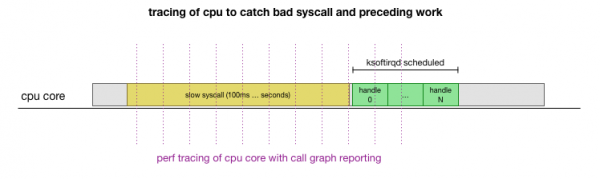
Het is handig dat al deze dingen met bestaande hulpmiddelen kunnen worden gedaan. Bijvoorbeeld, controleert met een opgegeven periodiciteit een opgegeven CPU-kernel en kan een oproepgrafiek genereren van het werkende systeem, inclusief zowel de gebruikersruimte als de Linux-kernel. We kunnen deze opname nemen en verwerken met behulp van een kleine fork van het programma van Brendan Gregg, dat volgorde van stacktracering behoudt. We kunnen eenlijnige stacktraceringen opslaan elke 1 ms, en dan een monster nemen en opslaan voor 100 milliseconden voordat het in de tracering belandt. ksoftirqd:
# record 999 times a second, or every 1ms with some offset so not to align exactly with timers
 sudo perf record -C 11 -g -F 999
 # take that recording and make a simpler stack trace.
 sudo perf script 2>/dev/null | ./FlameGraph/stackcollapse-perf-ordered.pl | grep ksoftir -B 100
Hier zijn de resultaten:
(honderden sporen die op elkaar lijken)
cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_iter cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;ixgbe_poll;ixgbe_clean_rx_irq;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;bond_handle_frame;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;ipip_tunnel_xmit;ip_tunnel_xmit;iptunnel_xmit;ip_local_out;dst_output;__ip_local_out;nf_hook_slow;nf_iterate;nf_conntrack_in;generic_packet;ipt_do_table;set_match_v4;ip_set_test;hash_net4_kadt;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;hash_net4_test ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;gro_cell_poll;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;dev_queue_xmit_nit;packet_rcv;tpacket_rcv;sch_direct_xmit;validate_xmit_skb_list;validate_xmit_skb;netif_skb_features;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;__dev_queue_xmit;dev_hard_start_xmit;__bpf_prog_run;__bpf_prog_run
Er is veel te zien, maar het belangrijkste is dat we het patroon "cadvisor voor ksoftirqd" herkennen, dat we eerder in de ICMP-tracer zagen. Wat betekent dit?
Elke regel is een CPU-tracering op een bepaald moment in de tijd. Elke oproep naar beneden in de stack in de regel is gescheiden door een puntkomma. In het midden van de regels zien we de aanroepende syscall: read(): .... ;do_syscall_64;sys_read; .... Dus cadvisor besteedt veel tijd aan de systeemaanroep read(), gerelateerd aan de functies mem_cgroup_* (bovenste deel van de oproepstack/einde van de regel).
In de oproeptracering is het onhandig om te zien wat er precies wordt gelezen, dus laten we strace en kijken wat cadvisor doet, en zoeken naar systeemaanroepen die langer dan 100 ms duren:
theojulienne@kube-node-bad ~ $ sudo strace -p 10137 -T -ff 2>&1 | egrep '<0.[1-9]'
 [pid 10436]  ) = 0
 [pid 10432]  ) = 0
 [pid 10137]  ) = 0
 [pid 10384]  ) = 0
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 658
 [pid 10384]  ) = 0
 [pid 10436]  ) = 0
 [pid 10436]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10427]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10411]  ) = 0
 [pid 10382]  ) = 0 (Timeout)
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 660
 [pid 10417]  ) = 0
 [pid 10436]  ) = 0
 [pid 10417]  ) = 0
 [pid 10417]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 576
Zoals we konden aannemen, zien we hier langzame oproepen. read(). Uit de inhoud van leesoperaties en context mem_cgroup is te zien dat deze aanroepen read() verwijzen naar het bestand memory.stat, dat het geheugenverbruik en de beperkingen van cgroup laat zien (een technologie voor resource-isolatie in Docker). De tool cadvisor vraagt dit bestand op om informatie te verkrijgen over het resourceverbruik voor containers. Laten we controleren of de kernel of cadvisor iets onverwachts doet:
theojulienne@kube-node-bad ~ $ time cat /sys/fs/cgroup/memory/memory.stat > /dev/null
real 0m0.153s
user 0m0.000s
sys 0m0.152s
theojulienne@kube-node-bad ~ $
Nu kunnen we de bug reproduceren en begrijpen we dat de Linux-kernel met een pathologie worstelt.
Waarom is de leesoperatie zo traag?
Op dit punt is het veel eenvoudiger om berichten van andere gebruikers over soortgelijke problemen te vinden. Het blijkt dat in de cadvisor-tracker over deze bug is gerapporteerd als een , maar niemand merkte op dat de vertraging ook willekeurig werd weergegeven in de netwerkstack. Het werd echt opgemerkt dat cadvisor meer CPU-tijd verbruikte dan verwacht, maar daar werd niet veel aandacht aan besteed, omdat onze servers veel CPU-resources hebben, dus het probleem werd niet grondig onderzocht.
Het probleem is dat cgroups het geheugenverbruik binnen de namespace (container) bijhouden. Wanneer alle processen in deze cgroup eindigen, bevrijdt Docker de geheugen-cgroup. Echter, 'geheugen' is niet alleen het geheugen van het proces. Hoewel het geheugen van de processen zelf niet meer wordt gebruikt, blijkt dat de kernel ook gecachede inhoud toewijst, zoals dentries en inodes (metadata van mappen en bestanden), die gecached worden in memory cgroup. Uit de probleemomschrijving:
cgroups-zombies: cgroups zonder processen die zijn verwijderd, maar waarvoor nog steeds geheugen is toegewezen (in mijn geval, uit de dentry-cache, maar het kan ook worden toegewezen uit de pagina-cache of tmpfs).
Het controleren van alle pagina's in de cache door de kernel bij het vrijgeven van de cgroup kan erg traag zijn, daarom is er voor een luie aanpak gekozen: wachten tot deze pagina's opnieuw worden opgevraagd, en dan, wanneer het geheugen echt nodig is, eindelijk de cgroup opruimen. Tot dat moment wordt de cgroup nog steeds meegerekend bij het verzamelen van statistieken.
Vanuit een prestatieperspectief hebben ze geheugen opgeofferd voor prestaties: snellere initiële opruiming doordat er een beetje gecachet geheugen overblijft. Dit is acceptabel. Wanneer de kernel het laatste deel van het gecachete geheugen gebruikt, wordt de cgroup uiteindelijk opgeruimd, dus dit kan niet worden aangeduid als een 'geheugenlek'. Helaas resulteert de specifieke implementatie van de zoekmechanismen memory.stat in deze versie van de kernel (4.9), in combinatie met de enorme hoeveelheid geheugen op onze servers, in veel meer tijd om de laatste gecachete gegevens te herstellen en cgroup-zombie op te ruimen.
Het blijkt dat er op sommige van onze knooppunten zoveel cgroup-zombies waren dat de leessnelheid en de vertraging meer dan een seconde overschreden.
Een manier om het cadvisor-probleem te omzeilen, is door de caches van dentries/inodes onmiddellijk door het hele systeem vrij te geven, wat de leeschwelling direct oplost, net als de netwerklatentie op de host, aangezien het verwijderen van de cache ook de gecachete pagina's van cgroup-zombies omvat, die ook worden vrijgegeven. Dit is geen oplossing, maar bevestigt de oorzaak van het probleem.
Het bleek dat de prestatie van systeemaanroep verbeterd was in nieuwere versies van de kernel (4.19+), waardoor het overstappen naar deze kernel het probleem oploste. Ondertussen hadden we tools om probleemknopen in Kubernetes-clusters op te sporen, elegant te lozen en opnieuw op te starten. We hebben alle clusters doorzocht, knooppunten met een aanzienlijk hoge vertraging gevonden en ze opnieuw opgestart. Dit gaf ons tijd om het besturingssysteem op de overige servers bij te werken. memory.statAangezien deze bug de verwerking van NIC RX-queues honderd milliseconden onderbrak, veroorzaakte hij tegelijkertijd zowel hoge vertraging op korte verbindingen als vertraging in het midden van de verbinding, bijvoorbeeld tussen MySQL-verzoeken en de bijbehorende pakketten.
Samenvattend
Het begrijpen en ondersteunen van de prestaties van de meest fundamentele systemen, zoals Kubernetes, is cruciaal voor de betrouwbaarheid en snelheid van alle diensten die daarop gebaseerd zijn. Alle draaiende systemen profiteren van prestatieverbeteringen in Kubernetes.
🥇Netwerkvertragingen in Kubernetes debuggen | ProHoster
Bron: habr.com
