

Hoe deze artikel te lezen: mijn excuses dat de tekst zo lang en chaotisch is geworden. Om uw tijd te besparen, begin ik elk hoofdstuk met een inleiding "Wat ik heb geleerd", waarin ik in één of twee zinnen de essentie van het hoofdstuk samenvat.
"Laat gewoon de oplossing zien!" Als u alleen maar wilt zien wat ik heb bereikt, ga dan naar het hoofdstuk "Word slimmer", maar ik vind het interessanter en nuttiger om over de mislukkingen te lezen.
Onlangs kreeg ik de opdracht om het proces voor het verwerken van een groot aantal DNA-sequenties in te stellen (technisch gezien is dit een SNP-chip). Ik moest snel gegevens verkrijgen over een bepaald genetisch locatie (dat SNP wordt genoemd) voor verdere modellering en andere taken. Met R en AWK slaagde ik erin de gegevens op een natuurlijke manier te reinigen en te organiseren, wat de verwerkingstijd aanzienlijk versnelde. Het kostte me veel moeite en vereiste talloze iteraties. Dit artikel zal u helpen enkele van mijn fouten te vermijden en zal laten zien wat ik uiteindelijk heb bereikt.
Laten we beginnen met enkele inleidende uitleg.
Gegevens
Ons universitaire centrum voor genetische informatieverwerking heeft ons gegevens geleverd in de vorm van een TSV van 25 TB. Ik ontving ze verdeeld in 5 pakketten, gecomprimeerd met Gzip, elk met ongeveer 240 vier-gigabyte bestanden. Elke rij bevatte gegevens voor één SNP van één persoon. In totaal werden gegevens doorgegeven over ~2,5 miljoen SNP's en ~60.000 personen. Naast SNP-informatie waren er in de bestanden tal van kolommen met cijfers die verschillende kenmerken weerspiegelen, zoals leessnelheid, frequentie van verschillende allelen, enzovoort. Er waren ongeveer 30 kolommen met unieke waarden.
Doel
Net als bij elk databeheerproject was het belangrijkste om te bepalen hoe de gegevens gebruikt zouden worden. In dit geval zullen we in de meeste gevallen modellen en workflows voor SNP's afstemmen op basis van SNP's. Dat wil zeggen, tegelijkertijd hebben we alleen gegevens nodig over één SNP. Ik moest leren om alle records die betrekking hebben op een van de 2,5 miljoen SNP's zo eenvoudig, snel en goedkoop mogelijk te extraheren.
Hoe dit niet te doen
Citeer een passend cliché:
Ik heb niet duizend keer gefaald, ik heb slechts duizend manieren ontdekt om een hoop gegevens niet op een manier te parseren die geschikt is voor verzoeken.
Eerste poging
Wat ik heb geleerd: er bestaat geen goedkope manier om 25 Tb tegelijk te parseren.
Na het volgen van het vak 'Geavanceerde methoden voor big data-analyse' aan de Vanderbilt Universiteit, was ik ervan overtuigd dat het een koud kunstje zou zijn. Misschien zou het een uur of twee duren om de Hive-server in te stellen, zodat ik door alle gegevens kon lopen en de resultaten kon rapporteren. Aangezien onze gegevens zijn opgeslagen in AWS S3, maakte ik gebruik van de service , die het mogelijk maakt om Hive SQL-query's op S3-gegevens toe te passen. Je hoeft geen Hive-cluster op te zetten, en je betaalt alleen voor de gegevens die je zoekt.
Nadat ik Athena mijn gegevens en hun indeling had getoond, voerde ik verschillende tests uit met vergelijkbare query's:
select * from intensityData limit 10;En kreeg snel goed gestructureerde resultaten. Klaar.
Totdat we de gegevens in de praktijk gingen gebruiken...
Ik kreeg de opdracht om alle informatie over SNP's op te halen om deze te testen op een model. Ik startte de query:
select * from intensityData
where snp = 'rs123456';
...en wachtte. Na acht minuten en meer dan 4 Tb aan opgevraagde gegevens kreeg ik het resultaat. Athena rekent kosten voor het volume gevonden gegevens, tegen $5 per terabyte. Dus deze enige query kostte $20 en acht minuten wachttijd. Om het model over alle gegevens te draaien, zou ik 38 jaar moeten wachten en $50 miljoen moeten betalen. Het is duidelijk dat dit niet voor ons werkte.
We moesten Parquet gebruiken...
Wat ik heb geleerd: wees voorzichtig met de grootte van je Parquet-bestanden en hun organisatie.
In het begin probeerde ik de situatie te verbeteren door alle TSV's om te zetten naar Ze zijn handig voor het werken met grote datasets, omdat de informatie in kolommen wordt opgeslagen: elke kolom ligt in een eigen segment van het geheugen/schijf, in tegenstelling tot tekstbestanden, waarin rijen elementen van elke kolom bevatten. En als je iets wilt vinden, hoef je alleen maar de benodigde kolom te lezen. Bovendien bevat elk bestand in de kolom een bereik van waarden, zodat als de gezochte waarde niet in het bereik van de kolom zit, Spark geen tijd verspilt aan het doorbladeren van het hele bestand.
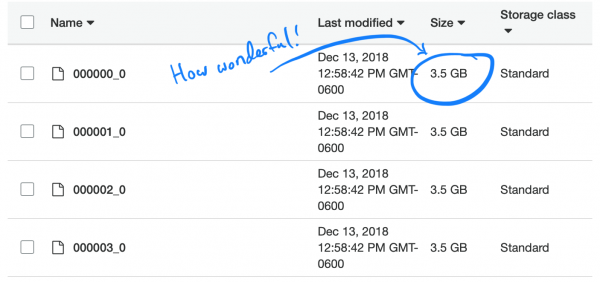
Ik startte een eenvoudige taak Voor het omzetten van onze TSV naar Parquet heb ik nieuwe bestanden in Athena geüpload. Dit heeft ongeveer 5 uur geduurd. Maar toen ik de query uitvoerde, kostte het ongeveer dezelfde tijd en iets minder geld. Het probleem is dat Spark, in een poging om de taak te optimaliseren, gewoon één TSV-chunk uitpakte en het in zijn eigen Parquet-chunk plaatste. En omdat elke chunk vrij groot was en volledige records van veel mensen bevatte, stonden in elk bestand alle SNP's opgeslagen, waardoor Spark alle bestanden moest openen om de benodigde informatie te extraheren.
Het is interessant dat het standaard (en aanbevolen) compressietype in Parquet - snappy - niet splitable is. Daarom bleef elke executor vastzitten op de taak van het uitpakken en het uploaden van de volledige dataset van 3,5 GB.
Laten we het probleem onderzoeken
Wat ik heb geleerd: sorteren is moeilijk, vooral als de gegevens verspreid zijn.
Het leek me dat ik de essentie van het probleem nu snapte. Ik hoefde de gegevens alleen maar op de SNP-kolom te sorteren, niet op de mensen. Dan zou een aparte chunk met gegevens meerdere SNP's bevatten en zou de 'slimme' functie van Parquet 'alleen openen als de waarde binnen het bereik ligt' zich volledig ontplooien. Helaas bleek het sorteren van miljarden regels verspreid over het cluster een uitdagende taak te zijn.
Ik tijdens de algoritmenles op de universiteit: «Ugh, niemand geeft om de computationele complexiteit van al deze sorteeralgoritmen»
Ik die probeer te sorteren op een kolom in een 20TB tabel: «Waarom duurt dit zo lang?» strijd.
— Nick Strayer (@NicholasStrayer)
AWS wil absoluut geen geld teruggeven vanwege de reden ‘Ik ben een verstrooide student’. Nadat ik de sortering op Amazon Glue had gestart, duurde het 2 dagen en is het mislukt.
Hoe zit het met partitionering?
Wat ik heb geleerd: de partities in Spark moeten in balans zijn.
Toen kwam ik op het idee om de gegevens op chromosomen te partitioneren. Er zijn er 23 (en nog een paar als je de mitochondriale DNA en onontcijferde gebieden meetelt).
Dit maakt het mogelijk om de gegevens in kleinere porties te splitsen. Als ik slechts één regel toevoegt aan de Spark-exportfunctie in het Glue-script, partition_by = "chr", zouden de gegevens over buckets moeten worden verdeeld.
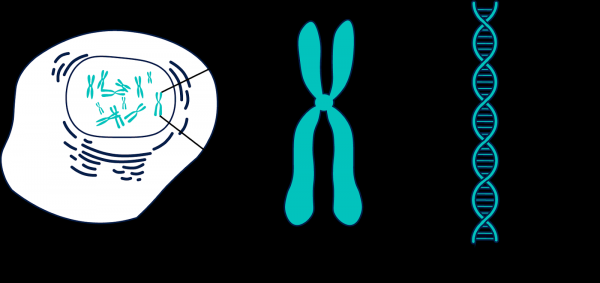
Het genoom bestaat uit talloze fragmenten die chromosomen worden genoemd.
Helaas werkte dit niet. Chromosomen hebben verschillende afmetingen, en dus ook een verschillende hoeveelheid informatie. Dit betekent dat de taken die Spark naar de workers stuurde, niet gebalanceerd waren en langzaam werden uitgevoerd, omdat sommige knooppunten eerder klaar waren en stil stonden. De taken werden echter uitgevoerd. Maar bij het aanvragen van één SNP werd de onbalans opnieuw de oorzaak van problemen. De verwerkingskosten van SNP in grotere chromosomen (dat wil zeggen de gebieden waar we gegevens vandaan willen halen) verminderden slechts met ongeveer tien keer. Veel, maar niet genoeg.
En wat als we het in nog kleinere partities verdelen?
Wat ik heb geleerd: probeer nooit 2,5 miljoen partities te maken.
Ik besloot het helemaal op te blazen en elk SNP te partitioneren. Dit garandeerde gelijke grootte van de partities. HET WAS EEN SLECHTE IDEE. Ik maakte gebruik van Glue en voegde een onschuldige regel toe partition_by = 'snp'. De taak werd gestart en begon met uitvoeren. Een dag later controleerde ik het, en zag ik dat er nog steeds niets in S3 was opgeslagen, dus beëindigde ik de taak. Blijkbaar schreef Glue tussentijdse bestanden naar een verborgen locatie in S3, en er waren veel bestanden, mogelijk een paar miljoen. Als gevolg hiervan kostte mijn fout meer dan duizend dollar en maakte mijn mentor niet blij.
Partitionering + sortering
Wat ik heb geleerd: alles sorteren blijft moeilijk, net als het configureren van Spark.
Mijn laatste poging tot partitionering was dat ik de chromosomen partitioneerde en daarna elke partitie sorteerde. In theorie zou dit elke query versnellen, omdat de gewenste SNP-gegevens binnen enkele Parquet-blokken binnen het opgegeven bereik moesten liggen. Helaas bleek het sorteren van zelfs gepartitioneerde gegevens een moeilijke opgave te zijn. Als resultaat schakelde ik over naar EMR voor een aangepaste cluster en gebruikte acht krachtige instanties (C5.4xl) en Sparklyr om een flexibeler werkproces te creëren...
# Sparklyr snippet to partition by chr and sort w/in partition
# Join the raw data with the snp bins
raw_data
  group_by(chr) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr')
  )
...maar de taak werd nog steeds niet voltooid. Ik stelde alles in: verhoogde de toegewezen geheugenruimte voor elke query-executant, gebruikte knooppunten met meer geheugen, passte broadcast-variabelen toe, maar elke keer bleek het slechts een halfslachtige poging te zijn, en geleidelijk begonnen de uitvoerders te falen totdat alles stopte.
Update: het begint.
— Nick Strayer (@NicholasStrayer)
Ik word vindingrijker
Wat ik heb geleerd: soms vereisen speciale gegevens speciale oplossingen.
Elke SNP heeft een positiereferentie. Dit nummer correspondeert met het aantal basen langs zijn chromosoom. Dit is een goede en natuurlijke manier om onze gegevens te organiseren. In eerste instantie wilde ik partitioneren op basis van de gebieden van elk chromosoom. Bijvoorbeeld, posities 1 – 2000, 2001 – 4000, enzovoort. Maar het probleem is dat SNP's ongelijkmatig over de chromosomen zijn verdeeld, waardoor de grootte van de groepen sterk zal variëren.
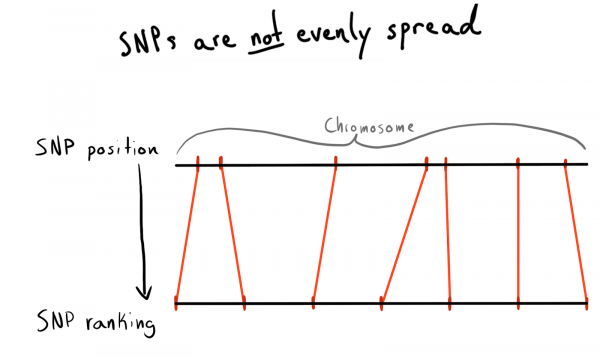
Als resultaat kwam ik tot de indeling in categorieën (rank) van posities. Op basis van de al geladen gegevens voerde ik een query uit om een lijst te krijgen van unieke SNP's, hun posities en chromosomen. Vervolgens sorteerde ik de gegevens binnen elk chromosoom en groepeerde ik SNP's in groepen (bin) van een bepaalde grootte. Laten we zeggen, per 1000 SNP's. Dit gaf me een relatie tussen SNP en groep-in-chromosoom.
Uiteindelijk maakte ik groepen (bin) van 75 SNP's, de reden leg ik hieronder uit.
snp_to_bin %
  group_by(chr) %>%
  arrange(position) %>%
  mutate(
    rank = 1:n()
    bin = floor(rank/snps_per_bin)
  ) %>%
  ungroup()
Eerste poging met Spark
Wat ik heb geleerd: het samenvoegen in Spark werkt snel, maar partitioneren blijft duur.
Ik wilde dit kleine (2,5 miljoen rijen) DataFrame in Spark lezen, samenvoegen met ruwe gegevens en vervolgens partitioneren op de pas toegevoegde kolom. bin.
# Join the raw data with the snp bins
data_w_bin <- raw_data %>%
  left_join(sdf_broadcast(snp_to_bin), by ='snp_name') %>%
  group_by(chr_bin) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr_bin')
  )
Ik heb gebruikt sdf_broadcast(), zodat Spark weet dat het het DataFrame naar alle knooppunten moet verzenden. Dit is nuttig als de gegevens klein zijn en voor alle taken nodig zijn. Anders probeert Spark slim te zijn en verdeelt de gegevens naar behoefte, wat kan leiden tot vertragingen.
En weer werkte mijn idee niet: de taken draaiden een tijdje, voltooiden de samenvoeging en begonnen vervolgens, net als de partitioneringstaken, fouten te geven.
Ik voeg AWK toe
Wat ik heb geleerd: slaap niet terwijl je de basisprincipes leert. Vast en zeker heeft iemand jouw probleem al opgelost in de jaren '80.
Tot op dit moment was de reden voor al mijn mislukte pogingen met Spark de door elkaar gegooide gegevens in de cluster. Misschien kan de situatie verbeterd worden met voorafgaande verwerking. Ik besloot te proberen de ruwe tekstgegevens op te splitsen in chromosoomkolommen, in de hoop Spark ‘vooraf gepartitioneerde’ gegevens te kunnen geven.
Ik zocht op StackOverflow hoe ik op basis van kolomwaarden kon splitsen en vond Met AWK kunt u een tekstbestand splitsen op kolomwaarden door een script te schrijven in plaats van de resultaten naar stdout.
Als proef heb ik een Bash-script geschreven. Ik heb een van de verpakte TSV gedownload en het vervolgens uitgepakt met behulp van gzip en verzonden naar awk.
gzip -dc path/to/chunk/file.gz |
awk -F 't'
'{print $1",..."$30" > "chunked/"$chr"_chr"$15".csv"}'
Het werkte!
Kernvervulling
Wat ik heb geleerd: gnu parallel is een magische tool, iedereen zou het moeten gebruiken.
Het splitsen ging vrij langzaam, en toen ik htop, opende om het gebruik van de krachtige (en dure) EC2-instantie te controleren, bleek ik slechts één kern en ongeveer 200 MB geheugen te gebruiken. Om de taak op te lossen en niet een fortuin te verliezen, moest ik bedenken hoe ik de klus kon paralleliseren. Gelukkig vond ik in het geweldige boek van Jeroen Janssens een hoofdstuk dat aan parallelisatie was gewijd. Hierin leerde ik over gnu parallel, een zeer flexibele manier om multithreading in Unix te implementeren.
Toen ik de splitsing met de nieuwe methode uitvoerde, ging alles goed, maar er bleef een knelpunt: het downloaden van S3-objecten naar de schijf ging niet zo snel en was niet volledig parallel. Om dit te verhelpen, deed ik het volgende:
- Ik ontdekte dat ik de S3-downloadfase direct in de pijplijn kon implementeren, waardoor tussentijdse opslag op de schijf volledig kon worden geëlimineerd. Dit betekent dat ik het schrijven van ruwe gegevens naar de schijf kan vermijden en een nog kleiner, dus goedkoper, opslagmedium op AWS kan gebruiken.
- Met het commando
aws configure set default.s3.max_concurrent_requests 50verhoogde het aantal threads dat de AWS CLI gebruikt aanzienlijk (standaard zijn dit er 10). - Ik ben overgestapt op een netwerk-geoptimaliseerde EC2-instantie, met de letter n in de naam. Ik ontdekte dat het verlies aan rekenkracht bij het gebruik van n-instanties ruimschoots wordt gecompenseerd door de verhoogde uploadsnelheid. Voor de meeste taken heb ik c5n.4xl gebruikt.
- Ik heb veranderd
gzipen een werkende opdracht krijgen. , dit is het gzip-hulpmiddel dat coole dingen kan doen voor het paralleliseren van taken die van oorsprong niet waren geparalleliseerd (dit hielp het minste).
# Let S3 use as many threads as it wants
aws configure set default.s3.max_concurrent_requests 50

for chunk_file in $(aws s3 ls $DATA_LOC | awk '{print $4}' | grep 'chr'$DESIRED_CHR'.csv') ; do

        aws s3 cp s3://$batch_loc$chunk_file - |
        pigz -dc |
        parallel --block 100M --pipe
        "awk -F 't' '{print $1",..."$30">"chunked/{#}_chr"$15".csv"}'"

       # Combine all the parallel process chunks to single files
        ls chunked/ |
        cut -d '_' -f 2 |
        sort -u |
        parallel 'cat chunked/*_{} | sort -k5 -n -S 80% -t, | aws s3 cp - '$s3_dest'/batch_'$batch_num'_{}'

         # Clean up intermediate data
       rm chunked/*
done
Deze stappen zijn met elkaar gecombineerd om alles zeer snel te laten werken. Dankzij de verhoogde downloadsnelheid en het afzien van het schrijven naar de schijf kon ik nu een pakket van 5 terabyte in slechts enkele uren verwerken.
Er is niets zoeters dan alle cores die je betaalt op AWS in gebruik te zien. Dankzij gnu-parallel kan ik een 19 gig csv net zo snel uitpakken en splitsen als ik het kan downloaden. Ik kreeg zelfs Spark niet aan de praat.
— Nick Strayer (@NicholasStrayer)
Deze tweet had ‘TSV’ moeten vermelden. Helaas.
Gebruik van opnieuw geparseerde gegevens
Wat ik heb geleerd: Spark houdt van niet-gecomprimeerde gegevens en houdt niet van het combineren van partities.
Nu lagen de gegevens in S3 in een ongecomprimeerd (lees: gescheiden) en semi-geordend formaat, en ik kon weer terug naar Spark. Ik werd verrast: ik kon opnieuw niet de gewenste resultaten behalen! Het was erg moeilijk om Spark precies te vertellen hoe de gegevens gepartitioneerd waren. En zelfs toen ik dit deed, bleek dat er te veel partities waren (95 duizend), en toen ik met behulp van coalesce het aantal verlaagde tot redelijk aantal, verstoorde dit mijn partitionering. Ik weet zeker dat dit opgelost kan worden, maar na een paar dagen zoeken kon ik geen oplossing vinden. Uiteindelijk voltooide ik alle taken in Spark, hoewel het enige tijd kostte, en mijn gesplitste Parquet-bestanden waren niet erg klein (~200 Kb). Maar de gegevens lagen daar waar ze moesten zijn.
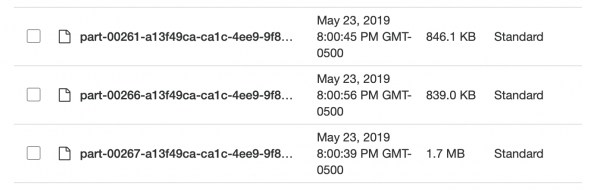
Te klein en ongelijk, geweldig!
Testen van lokale Spark-query's
Wat ik heb geleerd: Spark heeft te veel overhead bij het oplossen van eenvoudige taken.
Door de gegevens in een doordacht formaat te laden, kon ik de snelheid testen. Ik configureerde een script in R om een lokale Spark-server op te starten, en vervolgens laadde ik een Spark-dataframe uit de opgegeven Parquet-groep (bin). Ik probeerde alle gegevens te laden, maar kon Sparklyr niet laten inzien hoe de partitionering was.
sc <- Spark_connect(master = "local")

desired_snp <- 'rs34771739'

# Start een timer
start_time <- Sys.time()

# Laad de gewenste bin in Spark
intensity_data %
  Spark_read_Parquet(
    name = 'intensity_data',
    path = get_snp_location(desired_snp),
    memory = FALSE )

# Subset bin naar snp en verzamel naar lokaal
test_subset %
  filter(SNP_Name == desired_snp) %>%
  collect()

print(Sys.time() - start_time)
De uitvoering duurde 29,415 seconden. Veel beter, maar niet goed genoeg voor massale testdoeleinden. Bovendien kon ik de snelheid niet verhogen door te cachen, omdat als ik probeerde te cachen in het geheugen van het dataframe, Spark altijd viel, zelfs als ik meer dan 50 GB geheugen toewijzing voor een dataset die minder dan 15 woog.
Terug naar AWK
Wat ik heb geleerd: associatieve arrays in AWK zijn zeer efficiënt.
Ik besefte dat ik een hogere snelheid kon behalen. Ik herinnerde me dat in de geweldige Ik las over een gave functie die "" wordt genoemd. In wezen zijn dit key-value paren, die om de een of andere reden anders werden genoemd in AWK, waardoor ik er ook niet bijzonder aan dacht. herinnerde me eraan dat de term "associatieve arrays" veel ouder is dan de term "key-value paar". Zelfs als je , zul je die term daar niet zien, maar je zult associatieve arrays vinden! Bovendien wordt "key-value paar" meestal geassocieerd met databases, dus het is logischer om te vergelijken met hashmap. Ik realiseerde me dat ik deze associatieve arrays kon gebruiken om mijn SNP's te koppelen aan de bin-tabel en ruwe gegevens zonder Spark te gebruiken.
Hiervoor gebruikte ik in het AWK-script een blok BEGIN. Dit is een codefragment dat wordt uitgevoerd voordat de eerste regel gegevens naar het hoofdgedeelte van het script wordt doorgestuurd.
join_data.awk
BEGIN {
  FS=",";
  batch_num=substr(chunk,7,1);
  chunk_id=substr(chunk,15,2);
  while(getline  "chunked/chr_"chr"_bin_"bin[$1]"_"batch_num"_"chunk_id".csv"
}
Opdracht while(getline...) las alle rijen uit de CSV-groep (bin) geladen, waarbij de eerste kolom (naam SNP) als sleutel voor de associatieve array diende bin en de tweede waarde (groep) als waarde. Vervolgens, in het blok { }, dat wordt uitgevoerd voor alle rijen van het hoofd bestand, wordt elke regel naar het uitvoerbestand gestuurd, dat een unieke naam krijgt afhankelijk van de groep (bin): ..._bin_"bin[$1]"_....
Variabelen batch_num en chunk_id waren in overeenstemming met de gegevens die door de pipeline werden verstrekt, waardoor een raceconditie werd vermeden en elke uitvoeringsstroom die werd uitgevoerd parallel, schreef naar zijn eigen unieke bestand.
Aangezien ik alle ruwe gegevens had verspreid over mappen per chromosoom, overgebleven na mijn eerdere experiment met AWK, kon ik nu een andere Bash-script schrijven om per chromosoom tegelijk te verwerken en die dieper partitioneerde gegevens naar S3 te sturen.
DESIRED_CHR='13'

# Download chromosome data from s3 and split into bins
aws s3 ls $DATA_LOC |
awk '{print $4}' |
grep 'chr'$DESIRED_CHR'.csv' |
parallel "echo 'reading {}'; aws s3 cp "$DATA_LOC"{} - | awk -v chr=""$DESIRED_CHR"" -v chunk="{}" -f split_on_chr_bin.awk"

# Combine all the parallel process chunks to single files and upload to rds using R
ls chunked/ |
cut -d '_' -f 4 |
sort -u |
parallel "echo 'zipping bin {}'; cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R '$S3_DEST'/chr_'$DESIRED_CHR'_bin_{}.rds"
rm chunked/*
Het script heeft twee secties parallel.
In het eerste gedeelte worden gegevens uit alle bestanden gelezen die informatie bevatten over het betreffende chromosoom, waarna deze gegevens worden verdeeld over threads die de bestanden in overeenkomende groepen (bin) plaatsen. Om te voorkomen dat er een race-conditie ontstaat waarbij meerdere threads naar één bestand schrijven, geeft AWK de bestandsnamen door voor het schrijven van gegevens naar verschillende locaties, bijvoorbeeld, chr_10_bin_52_batch_2_aa.csv. Hierdoor worden er veel kleine bestanden op de schijf aangemaakt (hiervoor heb ik terabyte EBS-volumes gebruikt).
De pijplijn uit het tweede gedeelte parallel doorloopt de groepen (bin) en voegt hun afzonderlijke bestanden samen in gezamenlijke CSV's met cat, en verzendt deze vervolgens voor export.
Vertaling naar R?
Wat ik heb geleerd: kan worden aangeroepen vanuit stdin en stdout R-scripts, en kan dus ook in de pijplijn worden gebruikt.
In het Bash-script heb je misschien zo'n regel opgemerkt: ...cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R.... Dit vertaalt alle geconcateneerde bestanden van de groep (bin) naar het onderstaande R-script. {} is een speciale methode parallel, die alle gegevens die het naar de opgegeven stream verzendt direct in het commando invoegt. De optie {#} geeft een unieke ID voor de uitvoeringsstroom, en {%} is het nummer van de taakslot (herhaald, maar nooit tegelijkertijd). Een overzicht van alle opties is te vinden in
#!/usr/bin/env Rscript
library(readr)
library(aws.s3)

# Read first command line argument
data_destination <- commandArgs(trailingOnly = TRUE)[1]

data_cols <- list(SNP_Name = 'c', ...)

s3saveRDS(
  read_csv(
        file("stdin"),
        col_names = names(data_cols),
        col_types = data_cols
    ),
  object = data_destination
)
Wanneer de variabele file("stdin") wordt doorgegeven aan readr::read_csv, worden de gegevens die naar het R-script zijn vertaald geladen in een frame, dat vervolgens als .rds-bestand met behulp van aws.s3 direct naar S3 geschreven.
RDS is een soort junior versie van Parquet, zonder de finesse van een kolommenopslag.
Na het voltooien van het Bash-script kreeg ik een batch .rds-bestanden die in S3 lagen, waardoor ik efficiënt comprimeren en ingebouwde types kon gebruiken.
Ondanks het gebruik van traag R, werkte alles erg snel. Het is geen verrassing dat de fragmenten in R die verantwoordelijk zijn voor het lezen en schrijven van gegevens goed zijn geoptimaliseerd. Na testen op één chromosoom van gemiddelde grootte, werd de taak uitgevoerd op een C5n.4xl-instantie in ongeveer twee uur.
De beperkingen van S3
Wat ik heb geleerd: door de slimme implementatie van paden kan S3 met veel bestanden omgaan.
Ik maakte me zorgen of S3 het aantal verzonden bestanden kon verwerken. Ik kon de bestandsnamen betekenisvol maken, maar hoe zou S3 daarnaar zoeken?
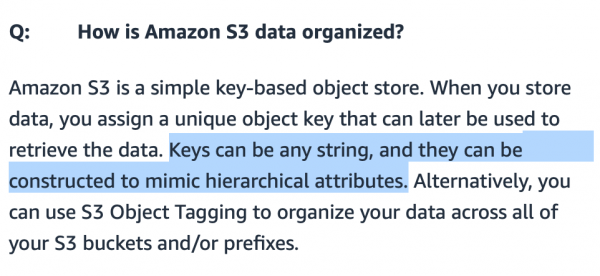
Mappen in S3 zijn alleen voor de show, het systeem is in werkelijkheid niet geïnteresseerd in het symbool /.
Het lijkt erop dat S3 een pad naar een specifiek bestand weergeeft in de vorm van een eenvoudige sleutel in een soort hash-tabel of documentgebaseerde database. Een bucket kan worden beschouwd als een tabel, terwijl bestanden de records in deze tabel zijn.
Aangezien snelheid en efficiëntie belangrijk zijn voor winstgevendheid bij Amazon, is het niet verwonderlijk dat dit systeem van ‘key-as-file-path’ geweldig is geoptimaliseerd. Ik probeerde een balans te vinden: het vermijden van talloze get-requests, maar tegelijkertijd ervoor zorgen dat de aanvragen snel werden uitgevoerd. Het bleek het beste te zijn om ongeveer 20.000 bin-bestanden te maken. Ik denk dat als we verder optimaliseren, we de snelheid kunnen verbeteren (bijvoorbeeld door een speciale bucket alleen voor data te maken, waardoor de grootte van de zoektabel afneemt). Maar ik had niet meer de tijd en het geld voor verdere experimenten.
Hoe zit het met kruiscompatibiliteit?
Wat ik heb geleerd: de belangrijkste reden voor tijdverlies is voortijdige optimalisatie van je opslagmethode.
Op dit moment is het erg belangrijk om jezelf af te vragen: 'Waarom een propriëtaire bestandsindeling gebruiken?' De reden is de laadsnelheid (gecomprimeerde gzip CSV-bestanden laadden zeven keer langzamer) en compatibiliteit met onze werkprocessen. Ik kan mijn besluit heroverwegen als R bestanden in Parquet (of Arrow) gemakkelijk kan laden zonder de lading van Spark. In ons laboratorium gebruikt iedereen R, en als ik de data naar een ander formaat moet converteren, heb ik nog steeds de oorspronkelijke tekstgegevens, dus ik kan gewoon de pipeline opnieuw uitvoeren.
Taakverdeling
Wat ik heb geleerd: probeer taken niet handmatig te optimaliseren, laat dat over aan de computer.
Ik heb de workflow op één chromosoom gedebugd, nu moet ik de andere gegevens verwerken.
Ik wilde een aantal EC2-instanties opzetten voor de conversie, maar tegelijkertijd was ik bang voor een extreem ongebalanceerde belasting in verschillende verwerkingsopdrachten (zoals Spark leed onder ongebalanceerde partities). Bovendien had ik geen zin in het opzetten van één instantie voor elke chromosoom, aangezien er een standaardlimiet van 10 instanties is voor AWS-accounts.
Toen besloot ik een script in R te schrijven voor de optimalisatie van verwerkingsopdrachten.
Eerst vroeg ik S3 om te berekenen hoeveel opslagruimte elke chromosoom in beslag neemt.
library(aws.s3)
library(tidyverse)

chr_sizes %
  mutate(Size = as.numeric(Size)) %>%
  filter(Size != 0) %>%
  mutate(
    # Haal chromosoom uit de bestandsnaam
    chr = str_extract(Key, 'chr.{1,4}.csv') %>%
             str_remove_all('chr|.csv')
  ) %>%
  group_by(chr) %>%
  summarise(total_size = sum(Size)/1e+9) # Deel om waarde in GB te krijgen


# Een tibble: 27 x 2
   chr   total_size

 1 0           163.
 2 1           967.
 3 10          541.
 4 11          611.
 5 12          542.
 6 13          364.
 7 14          375.
 8 15          372.
 9 16          434.
10 17          443.
# … met 17 meer rijen
Vervolgens schreef ik een functie die de totale grootte neemt, de volgorde van chromosomen door elkaar husselt, ze in groepen verdeelt num_jobs en rapporteert hoe de groottes van alle verwerkingsjobs variëren.
num_jobs <- 7
# Hoe groot zou elke job zijn als perfect verdeeld?
job_size <- sum(chr_sizes$total_size)/7

shuffle_job %
    sample_frac() %>%
    mutate(
      cum_size = cumsum(total_size),
      job_num = ceiling(cum_size/job_size)
    ) %>%
    group_by(job_num) %>%
    summarise(
      job_chrs = paste(chr, collapse = ','),
      total_job_size = sum(total_size)
    ) %>%
    mutate(sd = sd(total_job_size)) %>%
    nest(-sd)
}

shuffle_job(1)


# Een tibble: 1 x 2
     sd data

1  153.
Daarna draaide ik duizend husselingen met purrr en selecteerde het beste.
1:1000 %>%
  map_df(shuffle_job) %>%
  filter(sd == min(sd)) %>%
  pull(data) %>%
  pluck(1)
Zo kreeg ik een set jobs die heel vergelijkbaar van grootte waren. Daarna restte alleen nog maar mijn vorige Bash-script in een grote lus te wikkelen. voor. Voor het schrijven van deze optimalisatie had ik ongeveer 10 minuten nodig. Dat is aanzienlijk minder dan de tijd die ik zou hebben besteed aan het handmatig creëren van jobs bij een onevenwichtigheid. Daarom denk ik dat ik met deze voorlopige optimalisatie goed zat.
for DESIRED_CHR in "16" "9" "7" "21" "MT"
do
# Code voor het verwerken van een enkele chromosoom
fi
Aan het einde voeg ik een shutdown-commando toe:
sudo shutdown -h now … en het is gelukt! Met behulp van AWS CLI startte ik instanties en gaf via de optie user_data hen de Bash-scripts voor hun verwerkingsjobs door. Ze werden uitgevoerd en schakelden automatisch uit, zodat ik niet betaalde voor overmatige rekencapaciteit.
aws ec2 run-instances ...
--tag-specifications "ResourceType=instance,Tags=[{Key=Name,Value=<>}]"
--user-data file://<>
Laten we inpakken!
Wat ik heb geleerd: De API moet eenvoudig zijn voor eenvoud en flexibiliteit van gebruik.
Uiteindelijk had ik de gegevens op de juiste plek en in de juiste vorm. Het enige wat nog restte was het proces voor het gebruik van de gegevens te vereenvoudigen, zodat het voor mijn collega’s gemakkelijker werd. Ik wilde een eenvoudige API maken voor het indienen van verzoeken. Als ik in de toekomst besluit over te stappen van .rds Als het om Parquet-bestanden gaat, zou dit een probleem voor mij moeten zijn en niet voor mijn collega's. Daarom besloot ik een interne R-pakket te maken.
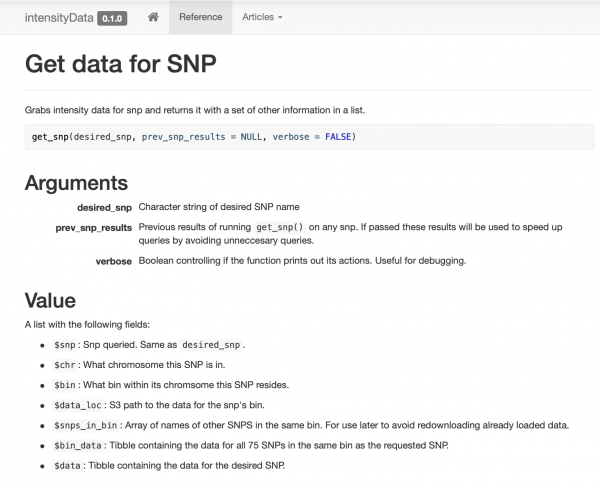
Ik heb een zeer eenvoudig pakket samengesteld en gedocumenteerd, met slechts een paar functies voor toegang tot gegevens, rondom de functie get_snp. Ook heb ik voor mijn collega's een site gemaakt , zodat ze eenvoudig voorbeelden en documentatie kunnen bekijken.
Slim cachebeheer
Wat ik heb geleerd: als uw gegevens goed zijn voorbereid, zal cachen eenvoudig zijn!
Aangezien een van de belangrijkste workflows hetzelfde analysemiddel toepaste op het SNP-pakket, besloot ik groepering (binning) in mijn voordeel te gebruiken. Wanneer gegevens worden doorgegeven voor SNP, wordt alle informatie uit de groep (bin) aan het geretourneerde object gehecht. Dit betekent dat oude aanvragen (in theorie) de verwerking van nieuwe aanvragen kunnen versnellen.
# Part of get_snp()
...
  # Test if our current snp data has the desired snp.
  already_have_snp <- desired_snp %in% prev_snp_results$snps_in_bin

  if(!already_have_snp){
    # Grab info on the bin of the desired snp
    snp_results <- get_snp_bin(desired_snp)

    # Download the snp's bin data
    snp_results$bin_data <- aws.s3::s3readRDS(object = snp_results$data_loc)
  } else {
    # The previous snp data contained the right bin so just use it
    snp_results <- prev_snp_results
  }
...
Bij het bouwen van het pakket heb ik veel benchmarks uitgevoerd om de snelheid van verschillende methoden te vergelijken. Ik raad aan dit niet te verwaarlozen, omdat de resultaten soms onverwacht kunnen zijn. Bijvoorbeeld, dplyr::filter bleek veel sneller te zijn dan het vastleggen van rijen met behulp van indexeringsfilters, en het ophalen van één kolom uit het gefilterde gegevensframe werkte veel sneller dan het toepassen van de indexeringssyntaxis.
Let op dat het object prev_snp_results de sleutel bevat snps_in_bin. Dit is een array van alle unieke SNP's in de groep (bin), waardoor het snel mogelijk is te controleren of er al gegevens uit een vorige aanvraag zijn. Het vereenvoudigt ook het cyclisch doorlopen van alle SNP's in de groep (bin) met deze code:
# Get bin-mates
snps_in_bin <- my_snp_results$snps_in_bin

for(current_snp in snps_in_bin){
  my_snp_results <- get_snp(current_snp, my_snp_results)
  # Do something with results
}
Resultaten
Nu kunnen we (en zijn we serieus begonnen) modellen en scenario's te draaien die voorheen niet beschikbaar waren. Het mooiste is dat mijn laboratoriumpartners zich geen zorgen hoeven te maken over allerlei complicaties. Ze hebben gewoon een werkende functie.
En hoewel het pakket hen ontlast van de details, heb ik geprobeerd het datamodel eenvoudig genoeg te maken zodat ze het kunnen begrijpen, mocht ik morgen plotseling verdwijnen...
De snelheid is aanzienlijk toegenomen. Gewoonlijk scannen we functioneel significante fragmenten van het genoom. Eerder konden we dit niet doen (te duur), maar nu, dankzij de groepsstructuur (bin) en caching, duurt een aanvraag voor één SNP gemiddeld minder dan 0,1 seconde, en het gebruik van gegevens is zo laag dat de kosten voor S3 verwaarloosbaar zijn.
Onlangs ben ik verantwoordelijk geworden voor het verwerken van meer dan 25 TB aan ruwe genotyperingsdata voor mijn lab. Toen ik begon, duurde het 8 minuten om een SNP te queryen met Spark en kostte dit $20. Na het gebruik van AWK + is het nu minder dan een tiende van een seconde en kost het $0.00001. Mijn persoonlijke overwinning.
— Nick Strayer (@NicholasStrayer)
Conclusie
Dit artikel is absoluut geen handleiding. De oplossing is individueel ontstaan en is bijna zeker niet optimaal. Het is eerder een verhaal over een reis. Ik wil dat anderen begrijpen dat dergelijke oplossingen niet als geheel gevormd in je hoofd ontstaan; het is het resultaat van proberen en fouten maken. Bovendien, als je op zoek bent naar een data-analist, houd dan rekening met het feit dat ervaring vereist is om deze hulpmiddelen effectief te gebruiken, en ervaring kost geld. Ik ben blij dat ik de middelen had om te betalen, maar veel anderen die hetzelfde werk beter kunnen doen, zullen nooit die mogelijkheid hebben vanwege een gebrek aan geld zelfs voor een poging.
Hulpmiddelen voor big data zijn universeel. Als je tijd hebt, kun je bijna zeker een snellere oplossing schrijven door gebruik te maken van 'slimme' data cleansing, opslag en extractiemethoden. Uiteindelijk komt alles neer op een kosten-batenanalyse.
Wat ik heb geleerd:
- er is geen goedkope manier om 25 TB in één keer te parseren;
- wees voorzichtig met de grootte van je Parquet-bestanden en hun organisatie;
- partities in Spark moeten gebalanceerd zijn;
- probeer nooit 2,5 miljoen partities te maken;
- sorteren blijft moeilijk, net als het configureren van Spark;
- soms vereisen speciale data speciale oplossingen;
- samenvoegen in Spark werkt snel, maar partitioneren blijft duur;
- slaap niet tijdens de basislessen; iemand heeft je probleem waarschijnlijk al in de jaren '80 opgelost;
gnu paralleldat is een magische functie, iedereen moet het gebruiken;- Spark houdt van onbewerkte data en houdt niet van het combineren van partities;
- er is te veel overhead in Spark bij het oplossen van eenvoudige taken;
- associatieve arrays in AWK zijn zeer efficiënt;
- je kunt toegang krijgen tot
stdinenstdoutuit een R-script, wat betekent dat je het in de pipeline kunt gebruiken; - door slimme implementatie kan S3 veel bestanden verwerken;
- de belangrijkste reden voor tijdverlies is voortijdige optimalisatie van je opslagmethode;
- probeer taken niet handmatig te optimaliseren; laat de computer dat doen;
- de API moet eenvoudig zijn voor de eenvoud en flexibiliteit van gebruik;
- als je data goed voorbereid is, zal cachen eenvoudig zijn!
Bron: habr.com
