

Hallo, Habr!
We remind you that our latest extremely interesting and useful on Kubernetes patterns has been released. It all started with "" by Brendan Burns, and, by the way, our work in this area is . Today, we offer you an article from the MinIO blog that briefly outlines the trends and specifics of data storage patterns in Kubernetes.
Kubernetes has fundamentally changed the traditional patterns of application development and deployment. Now a team can take just a few days to develop, test, and deploy an application in different environments, all within Kubernetes clusters. Working with technologies from previous generations usually took weeks, if not months.
Such acceleration has become possible thanks to the abstraction provided by Kubernetes — that is, due to the fact that Kubernetes itself interacts with the low-level details of physical or virtual machines, allowing users to declare among other parameters the desired processor, the required amount of memory, and the number of container instances. As immense community support is dedicated to Kubernetes, and the scale of its application is continually expanding, it leads all container orchestration platforms by a large margin.
As the use of Kubernetes expands, confusion regarding the data storage patterns used within it also grows..
In the overall competition for a piece of the pie of Kubernetes (that is, for data storage), when it comes to data storage, the signal tends to get drowned out by strong noise.
Kubernetes embodies a modern model of application development, deployment, and management. This modern model decouples data storage from computation. To fully understand this decoupling in the context of Kubernetes, one must also understand what stateful and stateless applications are, as well as how data storage fits in. This is where the REST API approach used by S3 has clear advantages over the POSIX/CSI approach typical of other solutions.
In dit artikel bespreken we de gegevensopslagpatronen in Kubernetes en gaan we dieper in op de discussie over applicaties die met en zonder toestand werken, om zo goed te begrijpen wat het verschil is tussen beide, en waarom dit belangrijk is. Verder in de tekst worden applicaties en de gebruikte gegevensopslagpatronen bekeken in het licht van de beste praktijken voor het werken met containers en Kubernetes.
Stateless containers
Containers zijn van nature lichtgewicht en efemeer. Ze kunnen eenvoudig worden gestopt, verwijderd of op een andere node worden gedeployed – dit kost slechts enkele seconden. In een groot systeem voor containerorkestratie komen dergelijke operaties voortdurend voor en de gebruikers merken deze veranderingen vaak niet op. Verplaatsingen zijn echter alleen mogelijk als de container geen afhankelijkheden heeft van de node waarop deze zich bevindt. Van dergelijke containers wordt gezegd dat ze werken zonder toestand.
Stateful containers
Als een container gegevens opslaat op lokaal aangesloten apparaten (of op een blockdevice), dan moet de gegevensopslag waarop deze is geplaatst, samen met de container naar een nieuwe node worden verplaatst in het geval van een storing. Dit is belangrijk, omdat het anders niet mogelijk is voor de applicatie die in de container draait om goed te functioneren, aangezien deze toegang moet hebben tot de gegevens die zijn opgeslagen op lokale media. Van dergelijke containers wordt gezegd dat ze werken met toestand.
Technisch gezien kunnen stateful containers ook naar andere nodes worden verplaatst. Dit wordt doorgaans mogelijk gemaakt door middel van gedistribueerde bestandssystemen of block network storage, dat aan alle nodes is gekoppeld waarop de containers draaien. Op deze manier krijgen containers toegang tot volumes voor persistente gegevensopslag, en wordt informatie opgeslagen op schijven door het hele netwerk. Deze methode noem ik de “stateful containerbenadering”, en in de rest van het artikel zal ik deze term gebruiken voor consistentie.
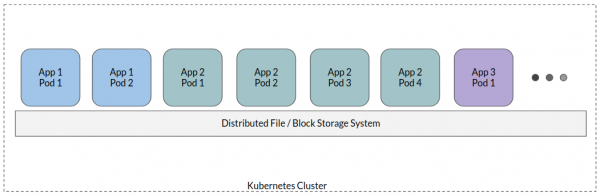
Bij de typische containerbenadering met statusbehoud worden alle pods van applicaties gekoppeld aan één gedistribueerd bestandssysteem - dit resulteert in een soort gedeelde opslag waar alle applicatiegegevens zich bevinden. Hoewel er enkele variaties mogelijk zijn, is dit een hoogniveau benadering.
Laten we nu eens bekijken waarom de containerbenadering met statusbehoud in een cloud-georiënteerde wereld een antipatroon is.
Cloud-georiënteerde applicatieontwerp
Traditioneel gebruikten applicaties databases voor gestructureerde opslag van informatie en lokale schijven of gedistribueerde bestandssystemen om alle ongestructureerde of zelfs halfgestructureerde gegevens op te slaan. Naarmate de volumes van ongestructureerde gegevens toenamen, realiseerden ontwikkelaars zich dat POSIX te "communicatief" was, gepaard ging met aanzienlijke kosten en uiteindelijk de werking van de applicatie belemmerde bij het overstappen naar werkelijk grote schalen.
Dit heeft voornamelijk bijgedragen aan de opkomst van een nieuwe opslagstandaard, namelijk cloud-georiënteerde opslag die voornamelijk gebaseerd is op REST API's, en die de applicatie bevrijdt van de last van lokaal gegevensbeheer. In dit geval functioneert de applicatie feitelijk in een modus zonder status (aangezien de status zich in de externe opslag bevindt). Moderne applicaties worden vanaf het begin gebouwd met dit in gedachten. Over het algemeen is elke moderne applicatie die gegevens van welke aard dan ook verwerkt (logboeken, metadata, blobs, enz.) gebouwd volgens een cloud-georiënteerde paradigma, waarbij de status wordt overgebracht naar een speciaal voor die opslag aangewezen softwaresysteem.
De containerbenadering met statusbehoud dwingt dit hele paradigma terug naar waar het begon!
Bij het gebruik van POSIX-interfaces voor gegevensopslag werken applicaties op dezelfde manier alsof ze de toestand opslaan, en daardoor wijken ze af van de belangrijkste postulaten van cloud-georiënteerd ontwerp, namelijk de mogelijkheid om de grootte van de applicatieworkflows aan te passen aan de binnenkomende belasting, te verhuizen naar een nieuwe node zodra de huidige node faalt, en dergelijke.
Wanneer we deze situatie nader bekijken, ontdekken we dat we bij het kiezen van een gegevensopslag opnieuw en opnieuw worden geconfronteerd met het dilemma 'POSIX versus REST API', MAAR met een extra complicatie van de problemen met POSIX, veroorzaakt door de gedistribueerde aard van Kubernetes-omgevingen. In het bijzonder,
- POSIX is spraakzaam: De semantiek van POSIX vereist dat elke bewerking wordt geassocieerd met metadata en bestandsdescriptors die helpen de staat van de operatie te behouden. Dit leidt tot aanzienlijke kosten die geen echte waarde hebben. Objectopslag-API's, in het bijzonder de S3 API, hebben deze vereisten verwijderd, zodat de applicatie kan werken en daarna de oproep kan 'vergeten'. De reactie van het opslag systeem geeft aan of de actie succesvol is uitgevoerd of niet. In geval van een mislukking kan de applicatie het opnieuw proberen.
- Netwerkbeperkingen: In een gedistribueerd systeem wordt aangenomen dat er meerdere applicaties kunnen zijn die proberen gegevens naar hetzelfde aangesloten opslagmedium te schrijven. Daarom, niet alleen zullen applicaties met elkaar concurreren om bandbreedte (omgegevens naar de opslag te verzenden), maar ook het opslag systeem zelf zal concurreren om deze bandbreedte door gegevens over fysieke schijven te verspreiden. Door de spraakzaamheid van POSIX neemt het aantal netwerkaanroepen meerdere keren toe. Aan de andere kant biedt de S3 API een duidelijke scheiding van netwerkaanroepen tussen die welke van de client naar de server komen en die welke binnen de server plaatsvinden.
- Beveiliging: Het POSIX-beveiligingsmodel is ontworpen voor actieve menselijke betrokkenheid: beheerders configureren specifieke toegangslevels voor elke gebruiker of groep. Dit paradigma is moeilijk aan te passen aan de cloudgerichte wereld. Moderne applicaties zijn afhankelijk van beveiligingsmodellen die op API's zijn gebaseerd, waar toegangsmachtigingen worden bepaald als een set beleidsregels, service-accounts en tijdelijke inloggegevens.
- Beheerbaarheid: Stateful containers brengen bepaalde kosten met zich mee die verband houden met beheer. Dit betreft de synchronisatie van gelijktijdige toegang tot gegevens en het waarborgen van de gegevensconsistentie; dit vereist een zorgvuldige afweging van welke datatoegangsmodellen te gebruiken. Het is noodzakelijk om extra software te installeren, te controleren en te configureren, nog afgezien van de extra inspanningen die nodig zijn voor ontwikkeling.
Container dataopslaginterface
Terwijl de Container Storage Interface (CSI) uitstekend heeft geholpen bij de verspreiding van het Kubernetes volume niveau, gedeeltelijk door dit aan derde partijen voor opslag te geven, heeft het ook onbedoeld bijgedragen aan de overtuiging dat de stateful containerbenadering de aanbevolen methode is voor gegevensopslag in Kubernetes.
CSI is ontwikkeld als een standaard voor het aanbieden van willekeurige block- en bestandopslagsystemen aan geërfde applicaties tijdens het werken met Kubernetes. En zoals in dit artikel is aangetoond, is de enige situatie waarin de stateful containerbenadering (en CSI in zijn huidige vorm) zinvol is, wanneer de applicatie zelf een geërfd systeem is waarin het onmogelijk is om ondersteuning voor een objectstorage API toe te voegen.
Het is belangrijk te begrijpen dat, door CSI in zijn huidige vorm te gebruiken, dat wil zeggen volumes te monteren bij moderne applicaties, we ongeveer dezelfde problemen tegenkomen die zich ook voordeden in systemen waar gegevensopslag in POSIX-stijl was georganiseerd.
Een kwalitatief betere benadering
In dit geval is het belangrijk om te begrijpen dat de meeste applicaties in wezen niet zijn ontworpen voor het werken met of zonder statusopslag. Dit gedrag hangt af van de algemene architectuur van het systeem en van de specifieke keuzes die gemaakt zijn tijdens het ontwerp. Laten we het even hebben over applicaties die status opslaan.
In principe kunnen alle gegevens van applicaties worden onderverdeeld in verschillende brede typen:
- Loggegevens
- Tijdstempelgegevens
- Transactiedata
- Metadata
- Containerbeelden
- Blobgegevens (grote binaire objecten)
Al deze datatypes worden goed ondersteund op moderne gegevensopslagsystemen, en er zijn verschillende cloud-georiënteerde platforms die zijn aangepast om gegevens in elk van deze specifieke formats aan te bieden. Bijvoorbeeld, transactiedata en metadata kunnen zich bevinden in een moderne cloud-georiënteerde database zoals CockroachDB, YugaByte, enzovoorts. Containerbeelden of blobgegevens kunnen worden opgeslagen in een docker-register, gebaseerd op MinIO. Tijdstempelgegevens kunnen worden opgeslagen in een tijdreeksdatabase, zoals InfluxDB, enzovoorts. Laten we niet in detail treden over elk datatype en de bijbehorende applicaties, maar het algemene idee is om persistente opslag van gegevens te vermijden die is gebaseerd op lokale schijfmontages.
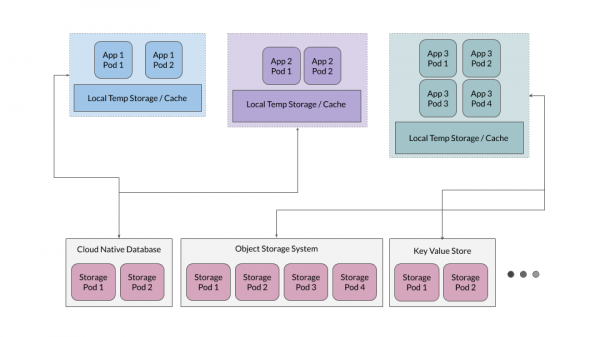
Bovendien blijkt het vaak effectief te zijn om een niveau van tijdelijke caching te bieden, dat fungeert als een soort opslag voor tijdelijke bestanden voor applicaties, maar applicaties moeten niet van dit niveau afhankelijk zijn als de bron van waarheid.
Opslag voor applicaties met statusopslag
Hoewel het in de meeste gevallen nuttig is om applicaties zonder status op te houden, dienen die applicaties die bedoeld zijn voor gegevensopslag – zoals databases, objectopslag, key-value opslag – status op te slaan. Laten we onderzoeken waarom deze applicaties op Kubernetes worden uitgerold. Als voorbeeld nemen we MinIO, maar dergelijke principes zijn ook toepasbaar op andere grote cloud-georiënteerde gegevensopslagsystemen.
Cloud-native applicaties zijn ontworpen voor optimaal gebruik van de flexibiliteit die containers bieden. Dit betekent dat er geen aannames worden gedaan over de omgeving waarin ze worden uitgevoerd. Bijvoorbeeld, MinIO gebruikt een interne mechanisme voor redundante codering (erasure coding) dat het systeem voldoende veerkracht biedt om operationeel te blijven, zelfs bij het falen van de helft van de schijven. Ook beheert MinIO de integriteit en veiligheid van gegevens door gebruik te maken van eigen hashing en versleuteling aan de serverzijde.
Voor dergelijke cloud-native applicaties zijn lokale persistente volumes (PV) de meest praktische keuze als back-upopslag. Lokale PV biedt de mogelijkheid om ruwe gegevens op te slaan, terwijl applicaties die bovenop deze PV draaien zelf informatie verzamelen om gegevens te schalen en te voldoen aan de groeiende data-eisen.
Deze aanpak is veel eenvoudiger en schaalbaarder dan PV op basis van CSI, die eigen lagen van gegevensbeheer en redundantie in het systeem introduceren; het probleem is dat deze lagen meestal conflicteren met applicaties die zijn ontworpen volgens het principe van stateful storage.
Zelfverzekerde beweging naar het loskoppelen van gegevens van berekeningen
In dit artikel hebben we besproken hoe applicaties zich heroriënteren naar het werken zonder stateful storage, of anders gezegd, hoe de opslag van gegevens wordt losgekoppeld van de berekeningen op die gegevens. Tot slot bekijken we enkele echte voorbeelden van deze trend.
, het beroemde platform voor data-analyse, werd traditioneel gebruikt met stateful storage en werd uitgevoerd in het HDFS-bestandssysteem. Echter, naarmate Spark de cloud-native wereld binnengaat, wordt dit platform steeds actiever gebruikt zonder stateful storage met behulp van `s3a`. Spark gebruikt s3a om state door te geven aan andere systemen, terwijl de Spark-containers zelf volledig zonder stateful storage draaien. Andere grote enterprise-spelers in de big data-analyse, in het bijzonder, , , gaan ook over naar een werkwijze met de scheiding van gegevensopslag en berekeningen.
Dergelijke patronen zijn ook zichtbaar op andere grote analytische platforms, waaronder Presto, Tensorflow to R en Jupyter. Door de status naar externe cloudopslag systemen te exporteren, wordt het veel eenvoudiger om uw applicatie te beheren en te schalen. Bovendien bevordert dit de draagbaarheid van de applicatie in verschillende omgevingen.
Bron: habr.com
