

HPE InfoSight – een cloudservice van HPE die proactief potentiële problemen met de betrouwbaarheid en prestaties van HPE Nimble en HPE 3PAR arrays kan identificeren. Bovendien kan de service direct aanbevelingen doen voor het oplossen van mogelijke problemen, waarbij in sommige gevallen problemen proactief en automatisch kunnen worden verholpen.
Over HPE InfoSight hebben we al gesproken op HABR, zie bijvoorbeeld, of .
In deze post wil ik een nieuwe functie van HPE InfoSight bespreken – de Resource Planner.
HPE InfoSight Resource Planner is een nieuwe krachtige tool die klanten helpt bepalen of ze nieuwe werklasten of applicaties kunnen toevoegen aan hun arrays, rekening houdend met de bestaande werklasten. Kan de array de extra belasting aan, of is er een nieuwe array nodig? Als er een nieuwe array nodig is, welke dan? De voorspellende modellering van de Resource Planner helpt precies de behoeften te begrijpen en de juiste sizing voor de upgrade van de bestaande array of de sizing van een nieuwe array uit te voeren.
De Planner maakt het volgende mogelijk:
- potentiële veranderingen in bestaande werklasten modelleren;
- de impact op resources van de array, zoals: processor, capaciteit en cachegeheugen, beoordelen;
- resultaten voor verschillende array-modellen bekijken.
Door statistieken en parametrieringsinformatie over de werking van arrays (over de gehele geïnstalleerde basis van arrays) te verzamelen en verschillende werklasten in veel klantomgevingen te analyseren, kunnen we bepaalde oorzaak-gevolgrelaties en kwantitatieve relaties identificeren. We weten bijvoorbeeld hoe deduplicatie de CPU-gebruik beïnvloedt in verschillende array-modellen. We weten dat Virtual Desktop-omgevingen beter dedupliceren en comprimeren dan SQL. We weten dat Exchange-applicaties over het algemeen een hoger percentage sequentiële (in tegenstelling tot willekeurige) leesoperaties hebben dan Virtual Desktop. Met deze informatie kunnen we de impact van veranderingen in de belasting modelleren om de resourcebehoeften voor een bepaald array-model te voorspellen.
Hoe de Planner werkt, bekijken we aan de volgende voorbeelden.
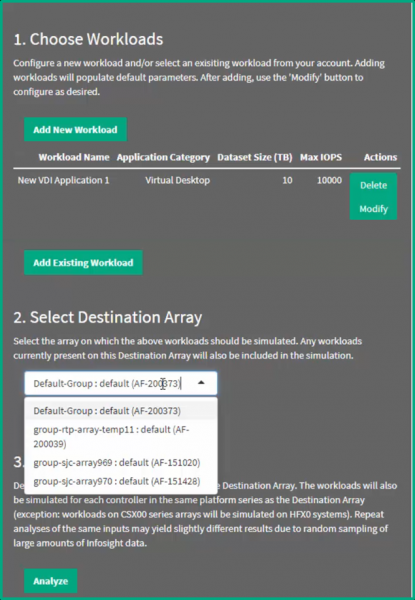
De Resource Planner wordt gestart op het HPE InfoSight-portaal in de sectie LABS. Laten we beginnen met het kiezen van een nieuwe workload – Add New Workload (naast de bestaande). Een andere optie, die we later zullen bekijken, is Add Existing Workload (wijziging van een bestaande workload).
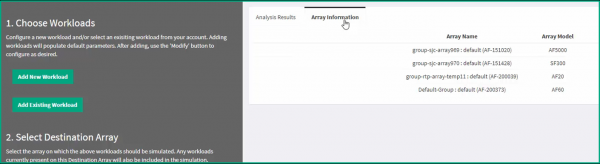
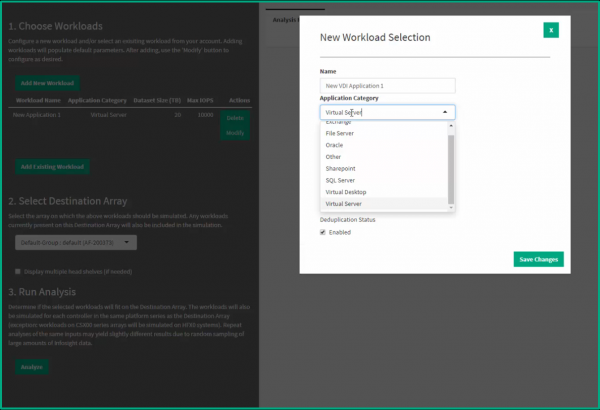
Kies een categorie workload/applicatie:
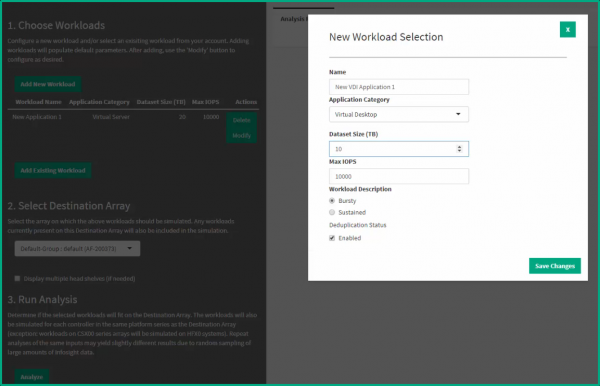
Indien nodig kunnen er verschillende wijzigingen worden aangebracht in de nieuwe workload: datavolume, IOPs, type workload en de-duplicatiemodus.
Vervolgens kiezen we de array (van de beschikbare bij de klant) waarvoor we deze nieuwe workload willen simuleren en drukken we op de knop Analyze.
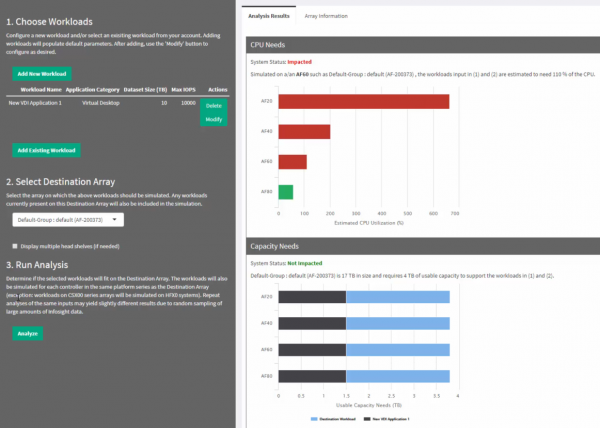
Uiteindelijk krijgen we de impact van deze nieuwe voorgestelde workload (naast de huidige workload) op CPU-resources en capaciteit. Als we een hybride flash-array hadden gekozen, zouden we ook de impact op het cache-geheugen van de array hebben gezien, maar in dit geval hebben we een all flash-array AF60, waarvoor het concept van cache-geheugen (op SSD) niet van toepassing is.
We zien (rechts, in het bovenste diagram – CPU needs) dat de AF60-array, waarvoor we de nieuwe workload hadden gepland, niet genoeg processorkapaciteit heeft om de nieuwe workload te verwerken: met de nieuwe workload zullen de CPU's voor 110% worden benut. In het onderste diagram (Capacity needs) is te zien dat er voldoende capaciteit is voor de nieuwe workload. Naast de AF60-array zijn in beide diagrammen ook andere array-modellen getoond – ter vergelijking met wat er zou zijn gebeurd als we een andere array hadden.
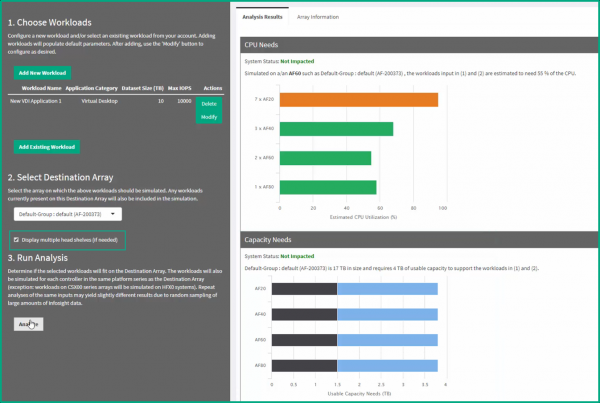
Op de volgende afbeelding is te zien wat er gebeurt wanneer we het vakje display multiple head shelves aanvinken (optie bij het kiezen van de oorspronkelijke array). Deze optie maakt een analyse voor meerdere identieke arrays mogelijk. Het is duidelijk dat voor de totale (nieuwe en bestaande) workload één AF80-array, of twee AF60-arrays, of drie AF40-arrays voldoende zijn.
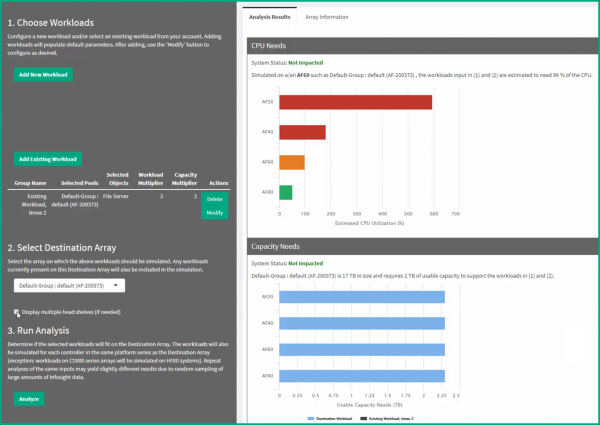
Met de resource planner kan ook een wijziging van alleen de huidige workload worden gemodelleerd. Hiervoor moet in de eerste stap add existing workload worden gekozen (in plaats van add new workload – zoals we eerder deden). Vervolgens kan de wijziging van de bestaande workload worden gemodelleerd en kan worden bekeken wat dit teweegbrengt. In het onderstaande voorbeeld wordt de verdubbeling van de workload en capaciteit voor applicaties zoals File Server gemodelleerd (met andere woorden, in dit voorbeeld verhogen we niet de totale workload op de array, maar verhogen we de workload alleen voor specifieke typen applicaties).
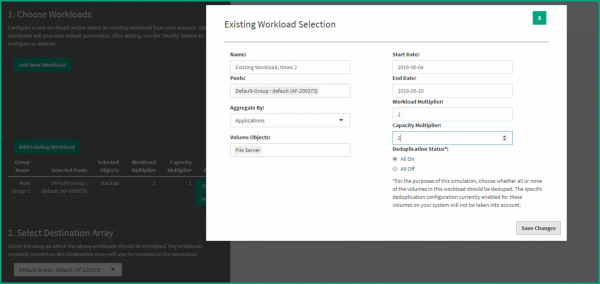
In dit geval is duidelijk dat de bronnen van de array het mogelijk maken om de belasting voor File Server-applicaties te verdubbelen, maar niet meer dan dat – omdat de processorbronnen voor 99% benut zullen worden.
Bron: habr.com
