

TL;DR: Vier jaar geleden verliet ik Google met het idee voor een nieuw hulpmiddel voor servermonitoring. Het idee was om normaal gesproken geïsoleerde functies samen te brengen in één dienst. en analyse van logs, het verzamelen van metrics, en een dashboard. Een van de principes is dat de service echt snel, waardoor DevOps een gemakkelijke, interactieve en plezierige ervaring krijgt. Dit vereist de verwerking van datasets van enkele gigabytes in fracties van een seconde, zonder het budget te overschrijden. Bestaande tools voor logbeheer zijn vaak traag en onhandig, waardoor we een mooie uitdaging kregen: een instrument goed ontwerpen dat gebruikers een nieuwe ervaring in hun werk biedt.
In dit artikel beschrijven we hoe we bij Scalyr dit probleem hebben opgelost door oude methoden toe te passen, brute kracht te gebruiken, overbodige lagen te verwijderen en complexe datastructuren te vermijden. Deze lessen kunt u toepassen op uw eigen engineering uitdagingen.
De kracht van de oude school
Loganalyse begint meestal met zoeken: alle berichten vinden die aan een bepaald patroon voldoen. Bij Scalyr zijn dit tientallen of honderden gigabytes aan logs van veel servers. Moderne benaderingen vereisen meestal het bouwen van een complexe datastructuur die geoptimaliseerd is voor zoekopdrachten. Ik heb zo'n aanpak natuurlijk gezien bij Google, waar ze daar behoorlijk goed in zijn. Maar wij kozen voor een veel ruigere aanpak: lineair loggen. En dit werkte; we bieden een interface met zoeken die veel sneller is dan die van de concurrentie (zie de animatie aan het einde).
De belangrijkste openbaring was dat moderne processors echt heel snel zijn in eenvoudige, rechtlijnige operaties. Dit is gemakkelijk over het hoofd te zien in complexe, gelaagde systemen die afhankelijk zijn van I/O-snelheid en netwerkoperaties, en zulke systemen zijn tegenwoordig zeer gebruikelijk. Daarom hebben we een ontwerp ontwikkeld dat het aantal lagen en onnodige rommel minimaliseert. Met meerdere processors en servers parallel, bereikt de zoek snelheid 1 TB per seconde.
Belangrijkste conclusies uit dit artikel:
- Brutale zoekopdrachten zijn een zeer levensvatbare aanpak voor het oplossen van echte, grootschalige problemen.
- Brute force is a design technique, not a way to avoid work. Like any technique, it is better suited to some problems than others, and it can be implemented poorly or well.
- Brute force is especially good for achieving stabiele performance.
- Effective use of brute force requires code optimization and timely application of sufficient resources. It is suitable when your servers are under heavy load unrelated to users, while user operations remain a priority.
- Performance depends on the design of the entire system, not just on the algorithm of the inner loop.
(This article describes in-memory data search. In most cases, when a user searches logs, Scalyr servers have already cached them. The next article will discuss searching through uncached logs. The same principles apply: efficient code, brute force method with large computational resources).
Brute force method
Traditionally, searching a large dataset is done via keyword indexes. In the context of server logs, this means searching for each unique word in the log. For each word, a list of all occurrences needs to be created. This allows for easy retrieval of all messages containing that word, such as 'error', 'firefox', or 'transaction_16851951' — you simply look it up in the index.
I used this approach at Google, and it worked well. But at Scalyr, we search through logs byte by byte.
Why? From an abstract algorithmic perspective, keyword indexes are much more efficient than brute search. However, we do not sell algorithms; we sell performance. And performance is not just about algorithms but also system engineering. We must consider everything: data volume, search type, available hardware, and software context. We decided that for our specific problem, an option like 'grep' is better than indexing.
Indexes are great, but they have limitations. Finding a single word is easy. But searching for messages with multiple words, such as 'googlebot' and '404', is much more complex. Searching for a phrase like 'uncaught exception' requires a more cumbersome index that not only logs all messages with that word but also the specific location of the word.
De echte uitdaging ontstaat wanneer je niet naar woorden zoekt. Stel dat je wilt weten hoeveel verkeer er van bots komt. De eerste gedachte is om in de logs te zoeken op het woord ‘bot’. Zo vind je een aantal bots: Googlebot, Bingbot en vele anderen. Maar hier is ‘bot’ geen volledig woord, maar een deel ervan. Als we naar ‘bot’ in de index zoeken, zullen we geen berichten met het woord ‘Googlebot’ vinden. Als we elk woord in de index controleren en vervolgens de index scannen op de gevonden zoekwoorden, zal de zoekactie aanzienlijk vertragen. Als gevolg hiervan staat bepaalde logverwerkingssoftware geen zoekopdrachten op delen van woorden toe, of in het beste geval, staat het gebruik van specifieke syntaxis met lagere prestaties toe. Dit willen we vermijden.
Een ander probleem is de interpunctie. Wil je alle zoekopdrachten van vinden 50.168.29.7? Что насчёт отладки логов, содержащих [error]? Индексы обычно пропускают пунктуацию.
Ten slotte houden ingenieurs van krachtige tools, en soms kan een probleem alleen worden opgelost met behulp van reguliere expressies. De index van zoekwoorden is hier niet goed voor geschikt.
Bovendien zijn de indexes complex. Elk bericht moet aan meerdere lijst van zoekwoorden worden toegevoegd. Deze lijsten moeten voortdurend in een doorzoekbaar formaat worden gehouden. Zoekopdrachten met zinnen, toetsenfragmenten of reguliere expressies moeten worden omgezet in bewerkingen met meerdere lijsten, en de resultaten moeten worden gescand en samengevoegd om een resulterende set te verkrijgen. In de context van een grootschalige multiplayerdienst creëert deze complexiteit prestatieproblemen die niet zichtbaar zijn bij de analyse van algoritmen.
Zoekwoordindexen nemen ook veel ruimte in beslag, en opslag is een belangrijke kostenpost in het logbeheersysteem.
Aan de andere kant kan elke zoekopdracht veel rekencapaciteit vergen. Onze gebruikers waarderen snelle zoekopdrachten op unieke verzoeken, maar dergelijke verzoeken komen relatief zeldzaam voor. Voor typische zoekopdrachten, zoals die op het dashboard, gebruiken we speciale technieken (die we in het volgende artikel zullen beschrijven). Andere verzoeken zijn zeldzaam, waardoor we meestal niet meer dan één gelijktijdig hoeven te verwerken. Maar dat betekent niet dat onze servers niet druk zijn: ze zijn bezig met het ontvangen, analyseren en comprimeren van nieuwe berichten, het evalueren van meldingen, het comprimeren van oude gegevens, enzovoort. Daardoor hebben we een aanzienlijke reserve aan processoren die we kunnen inzetten voor het uitvoeren van verzoeken.
Brute kracht werkt als je een brute probleem hebt (en veel kracht).
Brute kracht werkt het beste bij eenvoudige taken met kleine interne lussen. Vaak kun je de interne lus optimaliseren om op zeer hoge snelheden te draaien. Als de code complex is, wordt het veel moeilijker om te optimaliseren.
Oorspronkelijk had onze zoekcode een behoorlijk grote interne lus. We slaan berichten op in pagina's van 4K; elke pagina bevat enkele berichten (in UTF-8) en metadata voor elk bericht. De metadata is een structuur waarin de lengte van de waarde, de interne ID van het bericht en andere velden zijn gecodeerd. De zoeklus zag er als volgt uit:
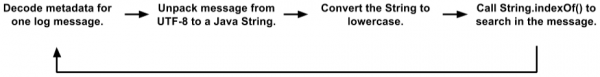
Dit is een vereenvoudigde versie vergeleken met de daadwerkelijke code. Maar zelfs hier zijn er verschillende plaatsingen van objecten, datakopieën en functieaanroepen zichtbaar. De JVM optimaliseert functieaanroepen en maakt vergankelijke objecten vrij, dus deze code werkte beter dan we verdienden. Tijdens het testen maakten klanten er behoorlijk succesvol gebruik van. Maar uiteindelijk zijn we naar een nieuw niveau gegaan.
(U kunt zich afvragen waarom we berichten in dit formaat bewaren met pagina's van 4K, tekst en metadata, in plaats van rechtstreeks met logboeken te werken. Er zijn veel redenen, die samenvallen met het feit dat de interne Scalyr-engine meer op een gedistribueerde database lijkt dan op een bestandssysteem. Tekstzoekopdrachten worden vaak gecombineerd met database-achtige filters op velden na het parseren van logboeken. We kunnen tegelijkertijd zoeken in duizenden logboeken, en gewone tekstbestanden zijn niet geschikt voor ons transactionele, gerepliceerde, gedistribueerde gegevensbeheer).
In het begin leek deze code niet echt geschikt voor optimalisatie met behulp van brute kracht. 'Echt werk' in String.indexOf() dominant was zelfs niet in het CPU-profiel. Dat wil zeggen, alleen het optimaliseren van deze methode zou geen significante effecten opleveren.
Toevallig bewaren we metadata aan het begin van elke pagina, terwijl de tekst van alle berichten in UTF-8 aan de andere kant is verpakt. Hierop gebaseerde hebben we de lus herschreven om direct op de hele pagina te zoeken:
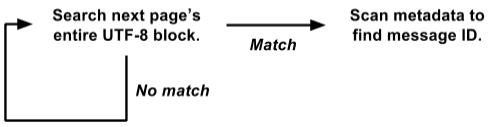
Deze versie werkt rechtstreeks op de weergave van raw byte[] en voert de zoekopdracht uit voor alle berichten tegelijk op de hele pagina van 4K.
Dit is veel gemakkelijker te optimaliseren voor de bruteforce-methode. De interne zoeklus wordt tegelijk voor de hele pagina van 4K aangeroepen, in plaats van afzonderlijk voor elk bericht. Er is geen datakopie en geen objectallocatie. En complexere bewerkingen met metadata worden alleen uitgevoerd bij een positieve uitkomst, en niet voor elk bericht. Zo hebben we een hoop overhead uitgesloten, en de resterende belasting is geconcentreerd in een kleine interne zoeklus, die goed geschikt is voor verdere optimalisatie.
Ons eigenlijke zoekalgoritme is gebaseerd op . Het lijkt op het Boyer-Moore-algoritme met het overslaan van ongeveer de lengte van de zoekstring bij elke stap. Het belangrijkste verschil is dat het twee bytes tegelijk controleert om valse overeenkomsten te minimaliseren.
Onze implementatie vereist dat voor iedere zoekopdracht een zoektafel van 64K wordt aangemaakt, maar dat is niets vergeleken met de gigabytes aan gegevens waarin we zoeken. De interne loop verwerkt meerdere gigabytes per seconde op één kern. In de praktijk bedraagt de stabiele prestaties ongeveer 1,25 GB per seconde op elke kern, en er is ruimte voor verbetering. We kunnen enkele overheadkosten buiten de interne loop elimineren en we zijn van plan om met de interne loop in C in plaats van Java te experimenteren.
Pas de kracht toe
We hebben besproken dat het zoekproces in logs 'groot' kan worden geïmplementeerd, maar hoeveel 'kracht' hebben we? Niet weinig.
1 kern: bij goed gebruik is één kern van een moderne processor vrij krachtig op zich.
8 cores: momenteel draaien we op Amazon-servers hi1.4xlarge en i2.4xlarge SSD, waarbij elk 8 kernen (16 threads) heeft. Zoals eerder vermeld, zijn deze kernen meestal bezig met achtergrondtaken. Wanneer een gebruiker zoekt, worden de achtergrondtaken gepauzeerd, waardoor alle 8 kernen vrij komen voor de zoekopdracht. De zoekopdracht wordt meestal binnen een fractie van een seconde voltooid, waarna het achtergrondwerk wordt hervat (de regelaarsprogramma garandeert dat de golf van zoekopdrachten de belangrijke achtergrondwerkzaamheden niet verstoort).
16 kernen: voor betrouwbaarheid organiseren we servers in master/slave groepen. Elke master heeft één SSD-server en één EBS-server onder zich. Als de hoofdserver uitvalt, neemt de SSD-server onmiddellijk de plaats in. Bijna de hele tijd werken master en slave normaal, zodat elk datablok op twee verschillende servers beschikbaar is voor zoekopdrachten (de EBS-slave server heeft een zwakke processor, dus die beschouwen we niet). We verdelen de taak tussen hen, zodat we in totaal 16 kernen beschikbaar hebben.
Veel kernen: in de nabije toekomst zullen we de gegevens zo over de servers verdelen dat allemaal meewerken aan de verwerking van elke niet-triviale zoekopdracht. Elke kern zal actief zijn. [Opmerking: we hebben een plan geïmplementeerd en de zoek snelheid verhoogd tot 1 TB/s, zie opmerking aan het einde van het artikel].
Eenvoud zorgt voor betrouwbaarheid
Een ander voordeel van de brute kracht methode is de vrij stabiele prestaties. Over het algemeen is zoeken niet erg gevoelig voor de details van de taak en de dataset (ik denk dat dit is waarom het 'bruut' wordt genoemd).
De zoekindex van sleutelwoorden geeft soms ongelooflijk snelle resultaten, terwijl dit in andere gevallen niet het geval is. Stel dat je 50 GB aan logbestanden hebt, waarin de term 'customer_5987235982' precies drie keer voorkomt. Het zoeken naar deze term kijkt direct in de index naar drie locaties en is binnen enkele seconden klaar. Maar een complexe zoekopdracht met wildcards kan duizenden sleutelwoorden scannen en veel tijd kosten.
Aan de andere kant wordt brute force zoeken voor elke zoekopdracht met meer of minder dezelfde snelheid uitgevoerd. Het zoeken naar lange woorden is beter, maar zelfs het zoeken naar één symbool gaat redelijk snel.
De eenvoud van de brute force-methode betekent dat de prestaties dicht bij het theoretische maximum liggen. Er zijn minder kansen voor onvoorzien schijven overbelasting, vergrendelingconflicten, pointer chasing en duizenden andere redenen voor storingen. Ik heb zojuist naar de zoekopdrachten van Scalyr-gebruikers gekeken die vorige week op onze drukste server zijn gedaan. Er waren 14.000 verzoeken. Slechts acht ervan duurden langer dan één seconde; 99% werd uitgevoerd binnen 111 milliseconden (en als je geen loganalysetools hebt gebruikt, geloof me: dat is snel).
Stabiele, betrouwbare prestaties zijn belangrijk voor de gebruikservaring van de service. Als deze af en toe traag is, zullen gebruikers dat als onbetrouwbaar beschouwen en het slechts terughoudend gebruiken.
Log zoeken in actie
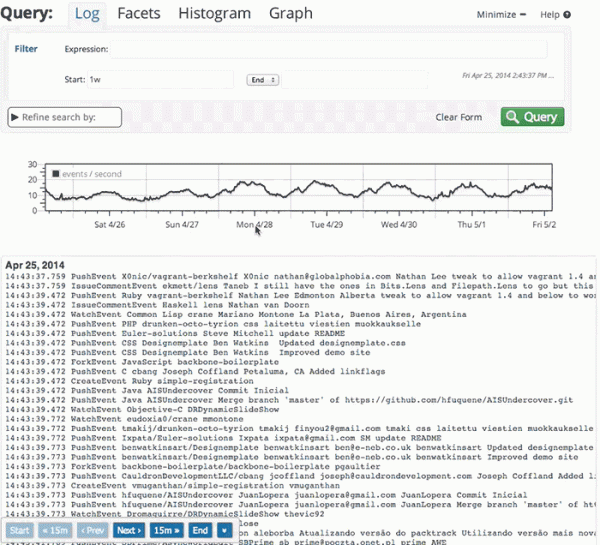
Hier is een kleine animatie die toont hoe Scalyr zoeken in actie is. We hebben een demo-account waar we elk evenement in elk openbaar Github-repository importeren. In deze demonstratie bekijk ik de gegevens van de afgelopen week: ongeveer 600 MB aan onbewerkte logbestanden.
De video is live opgenomen, zonder speciale voorbereiding, op mijn desktop (ongeveer 5000 kilometer van de server). De prestaties die je zult zien, zijn grotendeels te danken aan , evenals een snelle en betrouwbare backend. Elke keer als er een pauze zonder een 'loading'-indicator is, pauzeer ik zodat je de tijd hebt om te lezen waar ik op ga klikken.
Ter conclusie
Bij het verwerken van grote hoeveelheden gegevens is het belangrijk om een goed algoritme te kiezen, maar "goed" betekent niet "opvallend". Denk na over hoe uw code in de praktijk zal werken. Bij de theoretische analyse van algoritmen vallen enkele factoren weg die in de echte wereld van groot belang kunnen zijn. Eenvoudigere algoritmen zijn gemakkelijker te optimaliseren en ze zijn stabieler in grensgevallen.
Denk ook aan de context waarin de code zal worden uitgevoerd. In ons geval zijn krachtige servers nodig om achtergrondtaken te beheren. Gebruikers initiëren relatief zelden een zoekopdracht, dus we kunnen een hele groep servers lenen voor de korte periode die nodig is om elke zoekopdracht uit te voeren.
Met brute force hebben we een snelle, betrouwbare en flexibele zoekoplossing geïmplementeerd voor een set logs. We hopen dat deze ideeën nuttig zullen zijn voor uw projecten.
Wijziging: de titel en tekst zijn gewijzigd van "Zoeken met een snelheid van 20 GB per seconde" naar "Zoeken met een snelheid van 1 TB per seconde" om de toegenomen prestaties van de afgelopen jaren weerspiegelen. Deze toename in snelheid is voornamelijk te danken aan de verandering in het type en aantal EC2-servers die we nu in gebruik nemen om de groeiende klantenbasis te bedienen. In de nabije toekomst worden er wijzigingen verwacht die een nieuwe grote verhoging van de efficiëntie zullen opleveren, en we kijken ernaar uit om hierover te kunnen berichten.
Bron: habr.com
