

Vervolg van de vertaling van een klein boek:
«Understanding Message Brokers»,
auteur: Jakub Korab, uitgeverij: O’Reilly Media, Inc., publicatiedatum: juni 2017, ISBN: 9781492049296.
Vorige vertaalde deel:
HOOFDSTUK 3
Kafka
Kafka is ontwikkeld bij LinkedIn om bepaalde beperkingen van traditionele berichtbrokers te omzeilen en de noodzaak te vermijden om meerdere berichtbrokers in te stellen voor verschillende 'point-to-point' interacties, zoals beschreven in dit boek in het deel 'Verticaal en horizontaal schalen' op pagina 28. De gebruikscenario's bij LinkedIn waren voornamelijk gebaseerd op het eenrichtingsabsorberen van zeer grote hoeveelheden data, zoals klikken op pagina's en toegang logs, terwijl deze data tegelijkertijd door meerdere systemen konden worden gebruikt, zonder dat dit de prestaties van producenten of andere consumenten beïnvloedde. In feite is de reden voor het bestaan van Kafka om een dergelijk architectuur van berichtuitwisseling te krijgen als beschreven in de Universal Data Pipeline.
Met dit uiteindelijke doel in gedachten, ontstonden natuurlijk ook andere eisen. Kafka moet:
- Extreem snel zijn
- Hoge doorvoer bieden bij het verwerken van berichten
- Ondersteuning bieden voor de modellen 'Publisher-Subscriber' en 'Point-To-Point'
- Niet vertragen door het toevoegen van consumenten. Bijvoorbeeld, de prestaties van zowel de wachtrij als het onderwerp in ActiveMQ verslechteren bij een toename van het aantal consumenten aan de ontvangende kant.
- Horizontaal schaalbaar zijn; als één broker die berichten opslaat dit alleen kan doen op de maximale schijf snelheid, dan is het zinvol om verder te kijken dan één broker instantie om de prestaties te verbeteren.
- Toegang tot het opslaan en opnieuw ophalen van berichten scheiden
Om dit alles te bereiken, heeft Kafka een architectuur aangenomen die de rollen en verantwoordelijkheden van klanten en message brokers heeft herschreven. Het JMS-model is sterk gericht op de broker, die verantwoordelijk is voor de distributie van berichten, terwijl klanten zich alleen moeten bekommeren om het verzenden en ontvangen van berichten. Kafka daarentegen is klantgericht, waarbij de klant veel functies van de traditionele broker overneemt, zoals het eerlijke verdelen van relevante berichten onder consumenten, in ruil voor een extreem snelle en schaalbare broker. Voor mensen die met traditionele messaging-systemen hebben gewerkt, vereist het werken met Kafka fundamentele veranderingen in perspectief.
Deze engineeringrichting heeft geleid tot de creatie van messaging-infrastructuur die in staat is om de doorvoer met meerdere orden van grootte te verhogen in vergelijking met een gewone broker. Zoals we zullen zien, zijn er compromissen verbonden aan deze benadering, wat betekent dat Kafka niet geschikt is voor bepaalde soorten belasting en gevestigde software.
Gecoördineerd adresseringsmodel
Om aan de bovenstaande eisen te voldoen, heeft Kafka messaging van het type 'publicatie-abonnement' en 'punt-tot-punt' gecombineerd binnen één type ontvanger - topic. Dit verwart mensen die met messaging-systemen hebben gewerkt, waar het woord 'topic' verwijst naar een broadcastmechanisme, waarvan het lezen (uit het topic) niet betrouwbaar is (is nondurable). Topics in Kafka moeten worden beschouwd als een hybride type ontvanger, volgens de definitie die in de inleiding van dit boek is gegeven.
In de rest van dit hoofdstuk, tenzij we uitdrukkelijk anders aangeven, zal de term 'topic' verwijzen naar een Kafka-topic.
Om volledig te begrijpen hoe topics zich gedragen en welke garanties ze bieden, moeten we eerst kijken naar hoe ze in Kafka zijn geïmplementeerd.
Elke topic in Kafka heeft zijn eigen log.
Producers die berichten naar Kafka verzenden, schrijven naar dit logboek, terwijl consumenten uit het logboek lezen met behulp van pointers die continu vooruit worden verplaatst. Periodiek verwijdert Kafka de oudste delen van het logboek, ongeacht of de berichten in die delen al dan niet zijn gelezen. Een centraal aspect van het ontwerp van Kafka is dat de broker zich niet bekommert om de vraag of berichten zijn gelezen of niet — dit is de verantwoordelijkheid van de cliënt.
De termen "logboek" en "pointer" komen niet voor in . Deze goed bekende termen worden hier gebruikt om het begrip te vergemakkelijken.
Dit model verschilt volledig van ActiveMQ, waar berichten uit alle wachtrijen in één logboek worden opgeslagen en de broker berichten markeert als verwijderd nadat ze zijn gelezen.
Laten we nu wat dieper ingaan op het logboek van het topic.
Het Kafka-logboek bestaat uit verschillende partities (). Kafka garandeert een strikte volgorde binnen elke partitie. Dit betekent dat berichten die in een bepaalde volgorde naar een partitie zijn geschreven, ook in die volgorde zullen worden gelezen. Elke partitie is geïmplementeerd als een cyclisch logboekbestand dat een subverzameling (subset) van alle berichten bevat die door de producenten naar het topic zijn verzonden. Een aangemaakt topic bevat standaard één partitie. Het idee van partities is een centraal idee van Kafka voor horizontale schaalvergroting.
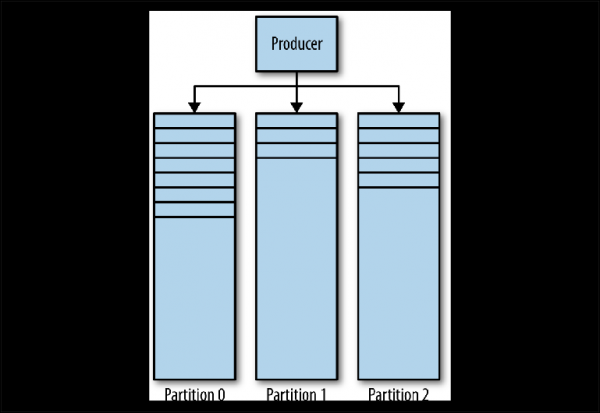
Figuur 3-1. Partities van Kafka
Wanneer een producent een bericht naar een Kafka-topic verzendt, besluit hij naar welke partitie hij het bericht moet sturen. We zullen hier later meer over bekijken.
Berichten lezen
Een cliënt die berichten wil lezen, beheert een genummerde pointer, genaamd consumentengroep (consumer group), die wijst naar de offset van berichten in de partitie. De offset is een positie met een oplopend nummer dat begint bij 0 aan het begin van de partitie. Deze consumentengroep, waarnaar wordt verwezen in de API via een door de gebruiker gedefinieerd id group_id, komt overeen met één logische consument of systeem..
De meeste systemen die berichtenuitwisseling gebruiken, lezen gegevens van de ontvanger via meerdere instanties en threads voor parallelle verwerking van berichten. Hierdoor zijn er meestal veel instanties van consumenten die dezelfde consumentengroep delen.
Het probleem van het lezen kan als volgt worden weergegeven:
- Een topic heeft verschillende partitions
- Meerdere consumer groepen kunnen tegelijkertijd gebruik maken van een topic
- Een consumer groep kan meerdere aparte instanties hebben
Dit is een niet-triviaal probleem van "veel-naar-veel". Om te begrijpen hoe Kafka omgaat met de relaties tussen consumer groepen, consumer instanties en partitions, beschouwen we een reeks geleidelijk complexer wordende lees-scenario's.
Consumers en consumer groepen
Laten we als startpunt een topic met één partition nemen ().
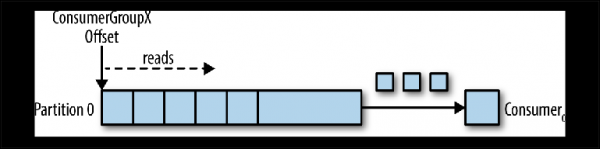
Figuur 3-2. Een consumer leest uit een partition
Wanneer een consumer instantie met zijn eigen group_id verbinding maakt met dit topic, wordt er een partition toegewezen voor het lezen en een offset in deze partition. De positie van deze offset is in de client geconfigureerd, als een aanwijzer naar de meest recente positie (het nieuwste bericht) of de vroegste positie (het oudste bericht). De consumer vraagt (polls) berichten op uit het topic, wat leidt tot het sequentieel lezen ervan uit het logboek.
De offset positie wordt regelmatig teruggecommit naar Kafka en opgeslagen als berichten in het interne topic _consumer_offsets. Gelezen berichten worden niet verwijderd, in tegenstelling tot een gewone broker, en de client kan de offset terugspoelen (rewind) om eerder bekeken berichten opnieuw te verwerken.
Wanneer een tweede logische consumer verbinding maakt, met een andere group_id, beheert deze een tweede aanwijzer die niet van de eerste afhankelijk is (). Zo functioneert een Kafka topic als een wachtrij, waarbij er één consumer is en als een gewone publish-subscribe topic, waarop meerdere consumers zijn geabonneerd, met als extra voordeel dat alle berichten worden opgeslagen en meerdere keren kunnen worden verwerkt.
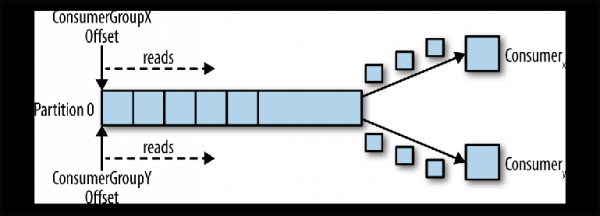
Figuur 3-3. Twee consumers in verschillende consumer groepen lezen uit één partition
Consumers in een consumer groep
Wanneer één instantie van een consumer gegevens uit een partition leest, controleert deze volledig de aanwijzer en verwerkt deze de berichten zoals beschreven in de vorige sectie.
Als meerdere exemplaren van consumenten met dezelfde group_id zijn verbonden aan een onderwerp met één partition, ontvangt het exemplaar dat als laatste verbinding maakt de controle over de pointer en zal vanaf dat moment alle berichten ontvangen ().
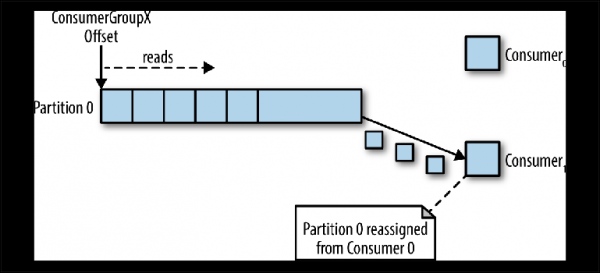
Figuur 3-4. Twee consumenten in dezelfde groep consumenten lezen uit één partition
Deze verwerkingsmodus, waarin het aantal consumentexemplaren het aantal partitions overschrijdt, kan worden gezien als een soort monopolistische consument. Dit kan nuttig zijn als u een 'actief-passieve' (of 'hete-warme') clustering van uw consumentexemplaren nodig heeft, hoewel parallelle werking van meerdere consumenten ('actief-actief' of 'hete-hete') veel gebruikelijker is dan consumenten in een wachttijd.
Dit gedrag van berichtverdeling, zoals hierboven beschreven, kan verrassend zijn in vergelijking met hoe een reguliere JMS-rij werkt. In dit model worden berichten die naar de rij worden verzonden gelijkmatig verdeeld over twee consumenten.
Meestal, wanneer we meerdere exemplaren van consumenten aanmaken, doen we dit ofwel voor parallelle verwerking van berichten, ofwel om de leessnelheid te verhogen, of om de veerkracht van het leesproces te verbeteren. Aangezien gegevens uit een partition gelijktijdig alleen door één consumentenexemplaar kunnen worden gelezen, hoe wordt dit bereikt in Kafka?
Een manier om dit te doen is door één exemplaar van de consument alle berichten te laten lezen en deze naar een threadpool door te geven. Hoewel deze benadering de verwerkingscapaciteit verhoogt, verhoogt deze de complexiteit van de logica van consumenten en draagt deze niet bij aan de veerkracht van het leessysteem. Als één exemplaar van de consument uitvalt door een stroomstoring of een soortgelijk evenement, stopt de verwerking.
De canonieke manier om dit probleem in Kafka op te lossen, is door gebruik te maken van eengroot aantal partitions.Partitionering
Partitions zijn het belangrijkste mechanisme voor het parallelle lezen en het schalen van een onderwerp buiten de bandbreedte van één broker-exemplaar. Om dit beter te begrijpen, laten we een situatie bekijken waarin er een onderwerp is met twee partitions en één consument zich op dat onderwerp abonneert (
Figuur 3-5).
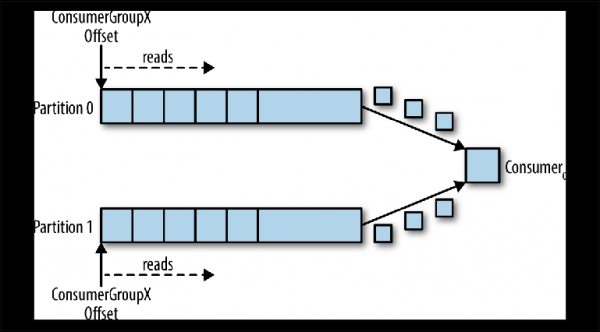
Figuur 3-5. Eén consument leest uit meerdere partities
In dit scenario krijgt de consument controle over de indexen die overeenkomen met zijn group_id in beide partities en begint hij berichten uit beide partities te lezen.
Wanneer een extra consument voor dezelfde group_id aan deze topic wordt toegevoegd, wijst Kafka een van de partities opnieuw toe (reallocate) van de eerste naar de tweede consument. Daarna zal elke instantie van de consument uit één partitie van de topic lezen ().
Om berichten parallel in 20 threads te verwerken, heeft u minimaal 20 partities nodig. Als dit aantal lager is, blijven er consumenten over zonder werk, zoals eerder besproken over monopolistische consumenten.
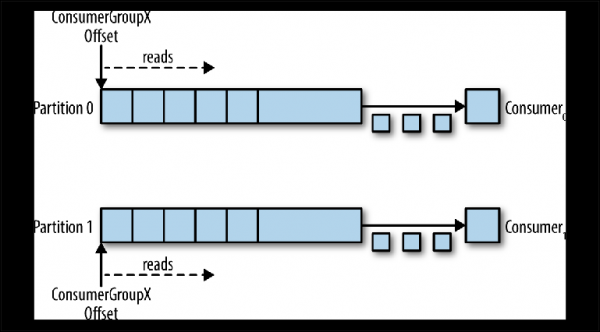
Figuur 3-6. Twee consumenten in dezelfde groep consumenten lezen uit verschillende partities
Dit schema vermindert de complexiteit van de Kafka-broker aanzienlijk in vergelijking met de verdeling van berichten die nodig is voor het ondersteunen van een JMS-queue. Hier hoeft men zich geen zorgen te maken over de volgende zaken:
- Welke consument het volgende bericht moet ontvangen, op basis van cyclische (round-robin) distributie, de huidige capaciteit van prefetch-buffers of eerdere berichten (zoals voor JMS-berichtgroepen).
- Welke berichten naar welke consumenten zijn verzonden en of ze opnieuw moeten worden afgeleverd in geval van een storing.
Alles wat de Kafka-broker moet doen, is berichten sequentieel aan de consument doorgeven wanneer deze ze aanvraagt.
Echter, de eisen voor het parallel lezen en opnieuw verzenden van mislukte berichten verdwijnen niet — de verantwoordelijkheid daarvoor verschuift gewoon van de broker naar de cliënt. Dit betekent dat ze in uw code moeten worden meegenomen.
Berichten verzenden
De verantwoordelijkheid voor de beslissing in welke partitie een bericht verzonden moet worden, ligt bij de producent van dat bericht. Om het mechanisme te begrijpen waarmee dit gebeurt, moeten we eerst bekijken wat we eigenlijk verzenden.
Terwijl we in JMS een berichtstructuur met metadata (koppen en eigenschappen) en een lichaam dat de payload bevat, gebruiken, is in Kafka een bericht een paar 'sleutel-waarde'. De payload van het bericht wordt verzonden als waarde (value). De sleutel daarentegen wordt hoofdzakelijk gebruikt voor partitionering en moet bevatten een sleutel die specifiek is voor de bedrijfslogica, zodat gerelateerde berichten in dezelfde partition kunnen worden geplaatst.
In Hoofdstuk 2 hebben we het scenario van online wedden besproken, waarbij gerelateerde gebeurtenissen in volgorde door één consument moeten worden verwerkt:
- De gebruikersaccount is ingesteld.
- Het geld wordt bijgeschreven op de rekening.
- Er wordt een inzet geplaatst die geld van de rekening haalt.
Als elke gebeurtenis een bericht vertegenwoordigt dat naar het onderwerp is gestuurd, is in dit geval de natuurlijke sleutel de accountidentificatie.
Wanneer een bericht wordt verzonden met behulp van de Kafka Producer API, wordt het doorgegeven aan de partitioneringsfunctie, die, rekening houdend met het bericht en de huidige status van het Kafka-cluster, het identificatienummer van de partition retourneert waarin het bericht moet worden verzonden. Deze functie is geïmplementeerd in Java via de Partitioner-interface.
Deze interface ziet er als volgt uit:
interface Partitioner {
    int partition(String topic,
        Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster);
}
De implementatie van Partitioner voor het bepalen van de partition maakt standaard gebruik van een hashing-algoritme voor de sleutel (general-purpose hashing algorithm over the key) of ronde-robine (round-robin) als de sleutel niet is opgegeven. Deze standaardinstelling werkt goed in de meeste gevallen. Echter, in de toekomst wilt u misschien uw eigen versie schrijven.
Het schrijven van uw eigen partitioneringsstrategie
Laten we een voorbeeld bekijken waarbij u metadata wilt verzenden samen met de payload van het bericht. De payload in ons voorbeeld is een instructie voor het storten van geld op de speelrekening. De instructie is hetgeen wat we zeker niet willen aanpassen tijdens de overdracht en we willen er zeker van zijn dat alleen een vertrouwd hoger systeem deze instructie kan initiëren. In dit geval stemmen de verzendende en ontvangende systemen af over het gebruik van een handtekening voor de authenticatie van het bericht.
In gewone JMS definiëren we eenvoudig de eigenschap 'handtekening van het bericht' en voegen deze toe aan het bericht. Kafka biedt ons echter geen mechanisme om metadata over te dragen — alleen een sleutel en waarde.
Aangezien de waarde de payload van de bankoverschrijving is, waarvan we de integriteit willen behouden, hebben we geen andere keuze dan de datastructuur te definiëren die we in de sleutel gaan gebruiken. Aangenomen dat we een rekeningnummer nodig hebben voor partitionering, omdat alle berichten die aan de rekening zijn gekoppeld in volgorde moeten worden verwerkt, zullen we de volgende JSON-structuur bedenken:
{
  "signature": "541661622185851c248b41bf0cea7ad0",
  "accountId": "10007865234"
}
Aangezien de waarde van de handtekening zal variëren afhankelijk van de payload, zal de standaard hashstrategie van de Partitioner waarschijnlijk niet betrouwbaar gerelateerde berichten groeperen. Daarom zullen we onze eigen strategie moeten schrijven die deze sleutel analyseert en de waarde accountId partitioneert.
Kafka omvat checksums voor het detecteren van beschadigde berichten in de opslag en heeft een compleet scala aan beveiligingsfuncties. Ondanks dit komen er soms sector-specifieke eisen voor, zoals hierboven vermeld.
Een aangepaste partitioneringsstrategie moet ervoor zorgen dat alle gerelateerde berichten zich in één partitie bevinden. Hoewel dit eenvoudig lijkt, kan de eis worden bemoeilijkt door het belang van de volgorde van gerelateerde berichten en hoe vast het aantal partitities in het onderwerp is.
Het aantal partitities in een onderwerp kan in de loop van de tijd veranderen, omdat er nieuwe kunnen worden toegevoegd als het verkeer de oorspronkelijke verwachtingen overschrijdt. Hierdoor kunnen de sleutels van berichten worden gekoppeld aan de partitie waarvoor ze oorspronkelijk zijn verzonden, implicerend dat een deel van de status verdeeld moet worden over de instanties van de producer.
Een andere factor om rekening mee te houden is de gelijkmatigheid van de verdeling van berichten over de partitities. Over het algemeen worden sleutels niet gelijkmatig verdeeld over berichten, en hashfuncties garanderen geen eerlijke verdeling van berichten voor een kleine set sleutels.
Het is belangrijk op te merken dat, hoe u ook beslist om berichten te splitsen, de scheiding mogelijk opnieuw moet worden gebruikt.
Laten we de vereiste gegevensreplicatie tussen Kafka-clusters op verschillende geografische locaties bekijken. Hiervoor wordt Kafka geleverd met een commandoregeltool genaamd MirrorMaker, die wordt gebruikt om berichten uit één cluster te lezen en deze naar een ander cluster te verzenden.
MirrorMaker moet de sleutels van het te repliceren topic begrijpen om de relatieve volgorde tussen de berichten tijdens de replicatie tussen clusters te behouden, aangezien het aantal partities voor dit topic niet noodzakelijkerwijs in beide clusters overeenkomt.
Aangepaste partitioneringsstrategieën komen relatief zelden voor, omdat het standaard hash- of cyclisch algoritme in de meeste scenario's goed werkt. Echter, als u strikte garanties voor ordening nodig heeft of als u metadata uit de payloads moet extraheren, dan is partitionering iets waar u beter naar moet kijken.
De voordelen van schaalbaarheid en prestaties van Kafka zijn te danken aan het overdragen van enkele verantwoordelijkheden van de traditionele broker naar de client. In dit geval wordt besloten om potentieel gerelateerde berichten over verschillende consumenten, die parallel werken, te verdelen.
JMS-brokers moeten ook met dergelijke vereisten omgaan. Interessant is dat het mechanisme om gerelateerde berichten naar dezelfde consument te sturen, dat is geïmplementeerd via JMS Message Groups (een soort sticky load balancing (SLB)-strategie), ook vereist dat de afzender berichten als gerelateerd markeert. In het geval van JMS is de broker verantwoordelijk voor het verzenden van deze groep gerelateerde berichten naar één consument van de velen en voor het overdragen van het eigendom van de groep als de consument uitvalt.
Producentovereenkomsten
Partitionering is niet het enige dat in overweging moet worden genomen bij het verzenden van berichten. Laten we de send() methoden van de Producer klasse in de Java API bekijken:
Future  send(ProducerRecord  record);
Future  send(ProducerRecord  record, Callback callback);
Het is belangrijk op te merken dat beide methoden een Future teruggeven, wat aangeeft dat de verzendoperatie niet onmiddellijk wordt uitgevoerd. Dit betekent dat het bericht (ProducerRecord) wordt opgeslagen in de verzendbuffer voor elke actieve partitie en in de achtergrond naar de broker wordt verzonden via de Kafka-clientbibliotheek. Hoewel dit de uitvoering ongelooflijk snel maakt, betekent het dat een onervaren geschreven applicatie berichten kan verliezen als het proces wordt gestopt.
Zoals altijd is er een manier om de verzendoperatie betrouwbaarder te maken ten koste van de prestaties. De grootte van deze buffer kan op 0 worden ingesteld, en de verzendende applicatie zal gedwongen worden te wachten tot de overdracht van het bericht naar de broker is voltooid, als volgt:
RecordMetadata metadata = producer.send(record).get();Nogmaals over het lezen van berichten
Het lezen van berichten heeft extra complicaties waarover nagedacht moet worden. In tegenstelling tot de JMS-API, die een berichtlistener kan starten als reactie op het binnenkomen van een bericht, is de interface Consumer Kafka alleen maar polling. Laten we de methode poll ()diezelfde doel nader bekijken:
ConsumerRecords poll(long timeout);De retourwaarde van de methode is een containerstructuur die meerdere objecten bevat ConsumerRecord van mogelijk meerdere partities. ConsumerRecord Zelf is het een houder-object voor een sleutel-waarde paar met bijbehorende metadata, zoals de partitie waaruit het is gehaald.
Zoals besproken in Hoofdstuk 2, moeten we altijd in gedachten houden wat er met de berichten gebeurt na succesvolle of onsuccesvolle verwerking, bijvoorbeeld als de client het bericht niet kan verwerken of als deze crasht. In JMS werd dit behandeld via de bevestigingsmodus (acknowledgement mode). De broker verwijdert ofwel het succesvol verwerkte bericht, of levert het onverwerkte of gefaalde opnieuw (op voorwaarde dat transacties zijn gebruikt).
Kafka werkt heel anders. Berichten worden niet verwijderd in de broker na uitlezing en de verantwoordelijkheid voor wat er gebeurt bij een fout ligt bij de uitlezende code.
Zoals we al zeiden, is een groep consumenten gekoppeld aan de offset in het log. De positie in het log, die aan deze offset is gekoppeld, komt overeen met het volgende bericht dat zal worden uitgegeven in reactie op poll ()Het tijdstip waarop deze offset toeneemt, is cruciaal bij het lezen.
Als we terugkijken naar het eerder besproken leermodel, bestaat de verwerking van een bericht uit drie fasen:
- Het bericht voor lezen ophalen.
- Het bericht verwerken.
- Het bericht bevestigen.
De Kafka-consumer komt met een configuratieoptie enable.auto.commit. Dit is een veelgebruikte standaardinstelling, zoals vaak het geval is met instellingen die het woord "auto" bevatten.
Tot Kafka 0.10 stuurde een client die deze parameter gebruikte de offset van het laatst gelezen bericht bij de volgende aanroep poll () na verwerking. Dit betekende dat eventuele berichten die al waren opgehaald (fetched), opnieuw konden worden verwerkt als de client deze al had verwerkt maar onverwacht was neergestort vóór de aanroep. poll (). Aangezien de broker geen staat opslaat over hoe vaak een bericht is gelezen, zal de volgende consumer die dit bericht ophaalt, niet weten dat er iets mis was gegaan. Dit gedrag was pseudo-transactief. De offset werd alleen gecommit in het geval van succesvol verwerkte berichten, maar als de client crashte, stuurde de broker hetzelfde bericht opnieuw naar een andere client. Dit gedrag kwam overeen met de garantie van berichtlevering "ten minste één keer«.
. In Kafka 0.10 werd de clientcode zodanig gewijzigd dat de commit regelmatig werd uitgevoerd door de clientbibliotheek, in overeenstemming met de instelling auto.commit.interval.ms. Dit gedrag bevindt zich ergens tussen de JMS AUTO_ACKNOWLEDGE en DUPS_OK_ACKNOWLEDGE modi. Bij het gebruik van auto-commit konden berichten worden bevestigd, ongeacht of ze daadwerkelijk waren verwerkt — dit kon gebeuren bij een trage consumer. Als de consumer crashte, werden berichten door de volgende consumer opgehaald, beginnend vanaf de gecommitteerde positie, wat kan leiden tot het overslaan van een bericht. In dit geval verloor Kafka geen berichten, de leescode verwerkte ze gewoon niet.
Deze modus heeft dezelfde perspectieven als in versie 0.9: berichten kunnen worden verwerkt, maar in het geval van een storing kan de offset mogelijk niet zijn gecommitteerd, wat potentieel kan leiden tot dubbele afleveringen. Hoe meer berichten je ophaalt bij het uitvoeren poll (), hoe groter dit probleem.
Zoals besproken in de sectie 'Berichten lezen uit de wachtrij' op pagina 21, bestaat er binnen het berichtenuitwisselingssysteem geen concept van een eenmalige levering van berichten, rekening houdend met de foutmodus.
In Kafka zijn er twee manieren om een offset vast te leggen (committen): automatisch en handmatig. In beide gevallen kunnen berichten meerdere keren worden verwerkt als het bericht wel is verwerkt, maar er een fout is opgetreden vóór de commit. U kunt ook besluiten om een bericht helemaal niet te verwerken, als de commit op de achtergrond heeft plaatsgevonden en uw code is beëindigd voordat deze met de verwerking is begonnen (mogelijk in Kafka 0.9 en eerdere versies).
U kunt het proces van handmatig committen van offsets beheren in de Kafka-consumenten-API door de parameter enable.auto.commit in te stellen op false en expliciet een van de volgende methoden aan te roepen:
void commitSync();
void commitAsync();
Als u een bericht 'ten minste één keer' wilt verwerken, moet u de offset handmatig committen met commitSync (), door deze opdracht meteen na de verwerking van berichten uit te voeren.
Deze methoden maken het niet mogelijk om bevestigde (acknowledged) berichten te bevestigen voordat ze zijn verwerkt, maar ze doen niets om dubbele verwerking te voorkomen, terwijl ze tegelijkertijd de indruk van transactionaliteit wekken. In Kafka zijn er geen transacties. De client kan het volgende niet doen:
- Automatisch een mislukt bericht terugdraaien (roll back). Consumenten moeten zelf de uitzonderingen afhandelen die voortvloeien uit problematische payloads en backend-onderbrekingen, aangezien ze niet kunnen rekenen op de herlevering van berichten door de broker.
- Berichten naar meerdere topics verzenden als onderdeel van één atomische operatie. Zoals we binnenkort zullen zien, kan de controle over verschillende topics en partijen zich op verschillende machines in het Kafka-cluster bevinden, die geen transacties coördineren bij verzending. Op het moment van schrijven van dit artikel is er werk verricht om dit mogelijk te maken met KIP-98.
- Het lezen van een bericht uit één topic koppelen aan het verzenden van een ander bericht naar een ander topic. Nogmaals, de architectuur van Kafka hangt af van veel onafhankelijke machines die als één bus fungeren en er wordt geen enkele poging gedaan om dit te verbergen. Bijvoorbeeld, er zijn geen API-componenten die het mogelijk maken om Consument en Producent in de transactie. In JMS wordt dit gegarandeerd door het object Session, waaruit de MessageProducers en MessageConsumers.
Als we niet op transacties kunnen vertrouwen, hoe kunnen we dan semantiek garanderen die dichter ligt bij wat traditionele berichtenuitwisselingssystemen bieden?
Als er een kans bestaat dat de offset van de consument kan toenemen voordat het bericht is verwerkt, bijvoorbeeld tijdens een storing van de consument, heeft de consument geen manier om te weten of zijn consumentengroep berichten heeft gemist wanneer hem een partitie wordt toegewezen. Een van de strategieën is daarom om de offset terug te spoelen naar de vorige positie. De Kafka-consumenten-API biedt de volgende methoden hiervoor:
void seek(TopicPartition partition, long offset);
void seekToBeginning(Collection  partitions);
Methode seek () kan worden gebruikt met de methode
offsetsForTimes (Map timestampsToSearch) om terug te spoelen naar een bepaalde staat op een bepaald moment in het verleden.
Impliciet betekent het gebruik van deze aanpak dat het zeer waarschijnlijk is dat enkele berichten die eerder zijn verwerkt, opnieuw worden gelezen en verwerkt. Om dit te voorkomen, kunnen we idempotente leesmethoden gebruiken, zoals beschreven in Hoofdstuk 4, om eerder bekeken berichten bij te houden en duplicaten uit te sluiten.
Als alternatief kan de code van uw consument eenvoudig zijn, als verlies of duplicatie van berichten acceptabel is. Wanneer we gebruiksscenario's overwegen waarvoor Kafka meestal wordt gebruikt, zoals het verwerken van logboeken, statistieken, kliktracking, enz., begrijpen we dat het verlies van individuele berichten waarschijnlijk een verwaarloosbare impact zal hebben op de omringende applicaties. In dergelijke gevallen zijn de standaardwaarden volkomen acceptabel. Aan de andere kant, als uw applicatie betalingen moet verwerken, moet u zorgvuldig omgaan met elk afzonderlijk bericht. Het komt allemaal neer op de context.
Persoonlijke observaties laten zien dat naarmate de intensiteit van berichten toeneemt, de waarde van elk afzonderlijk bericht afneemt. Berichten van grote omvang worden doorgaans waardevol als ze in geaggregeerde vorm worden beschouwd.
Hoge beschikbaarheid (High Availability)
De aanpak van Kafka met betrekking tot hoge beschikbaarheid verschilt wezenlijk van die van ActiveMQ. Kafka is ontworpen op basis van horizontaal schaalbare clusters, waarin alle brokerinstellingen gelijktijdig berichten ontvangen en verzenden.
Een Kafka-cluster bestaat uit meerdere brokerinstellingen die op verschillende servers draaien. Kafka is ontwikkeld voor gebruik op reguliere autonome hardware, waarbij elke node zijn eigen toegewezen opslag heeft. Het gebruik van netwerkopslag (SAN) wordt niet aanbevolen, omdat meerdere rekenknopen kunnen concurreren voor de tijdsintervallen van de opslag en conflicten kunnen creëren.ZDeze.
Kafka is een altijd ingeschakelde systeem. Veel grote gebruikers van Kafka schakelen hun clusters nooit uit en de software zorgt altijd voor updates door middel van gestructureerde herstarts. Dit wordt bereikt door compatibiliteit met eerdere versies voor berichten en interacties tussen brokers te garanderen.
Brokers zijn verbonden met het cluster van servers , dat fungeert als een configuratieregister en wordt gebruikt voor de coördinatie van de rollen van elke broker. ZooKeeper zelf is een gedistribueerd systeem dat hoge beschikbaarheid biedt door informatie te repliceren door het vestigen van een quorum..
In de basisconfiguratie wordt een topic in het Kafka-cluster aangemaakt met de volgende eigenschappen:
- Aantal partities. Zoals eerder besproken, is de exacte waarde die hier wordt gebruikt afhankelijk van het gewenste niveau van parallele lezing.
- De replicatiefactor bepaalt hoeveel brokerinstellingen binnen het cluster de logs voor deze partitie moeten bevatten.
Door gebruik te maken van ZooKeeper voor coördinatie, probeert Kafka nieuwe partities eerlijk te verdelen over de brokers in het cluster. Dit wordt gedaan door één instantie, die de rol van Controller vervult.
Tijdens de runtime toewijst voor elke partitie van het topic Controller de rollen aan brokers leider (leader, master, hoofd) en volgers. (followers, slaves, subordinates). De broker die optreedt als leider voor deze partition is verantwoordelijk voor het ontvangen van alle berichten die door producenten naar hem zijn gestuurd, en voor het verspreiden van de berichten naar de consumenten. Bij het verzenden van berichten naar de partition van het topic worden deze gerepliceerd naar alle broker knooppunten die optreden als volgers voor deze partition. Elk knooppunt dat logs voor de partition bevat, wordt genoemd replica. De broker kan als leider fungeren voor sommige partitions en als volger voor andere.
De volger die alle berichten bevat die bij de leider zijn opgeslagen, wordt genoemd gesynchroniseerde replica (replica in gesynchroniseerde staat, in-sync replica). Als de broker die als leider voor de partition fungeert, uitvalt, kan elke broker die in de actuele of gesynchroniseerde staat voor deze partition verkeert, de rol van leider overnemen. Dit is een ongelooflijk robuust ontwerp.
Een onderdeel van de producentconfiguratie is de parameter acks, die bepaalt hoeveel replica's de ontvangst van een bericht moeten bevestigen (acknowledge) voordat de datastroom van de applicatie doorgaat: 0, 1 of allemaal. Als de waarde wordt ingesteld op all, zal de leider bij ontvangst van het bericht een bevestiging (confirmation) terugsturen naar de producent, zodra hij bevestigingen (acknowledgements) van meerdere replica's (inclusief zichzelf) heeft ontvangen, zoals ingesteld door de topicconfiguratie min.insync.replicas (standaard 1). Als een bericht niet met succes kan worden gerepliceerd, zal de producent een uitzondering voor de applicatie oproepen (NotEnoughReplicas of NotEnoughReplicasAfterAppend).
In een typische configuratie wordt een topic met een replicatiefactor van 3 (1 leider, 2 volgers voor elke partition) gemaakt en de parameter min.insync.replicas wordt ingesteld op 2. In dit geval staat het cluster toe dat een van de brokers die de partition van het topic beheert, kan uitvallen zonder invloed op de clientapplicaties.
Dit leidt ons terug naar de al bekende compromissen tussen prestaties en betrouwbaarheid. Replicatie gaat ten koste van extra wachttijd voor bevestigingen (acknowledgments) van volgers. Hoewel, omdat het parallel wordt uitgevoerd, heeft replicatie, op zijn minst op drie knooppunten, dezelfde prestaties als op twee (de verhoogde netwerkbandbreedte gebruik negerend).
Met behulp van dit replicatieschema ontwijkt Kafka handig de noodzaak om elke boodschap fysiek op schijf te schrijven met een actie sync (). Elke boodschap die door de producent wordt verzonden, wordt opgeslagen in het partition journal, maar zoals besproken in Hoofdstuk 2, wordt de schrijfactie aanvankelijk uitgevoerd in de buffer van het besturingssysteem. Als deze boodschap wordt gerepliceerd naar een andere Kafka-instantie en zich in zijn geheugen bevindt, betekent het verlies van de leider niet dat de boodschap zelf verloren is gegaan — deze kan worden overgenomen door een gesynchroniseerde replica.
De noodzaak om de actie uit te voeren sync () betekent dat Kafka boodschappen kan accepteren met de snelheid waarmee het ze in het geheugen kan schrijven. En omgekeerd, hoe langer de flush (spoelen) van het geheugen naar schijf kan worden uitgesteld, hoe beter. Om deze reden is het niet ongebruikelijk dat Kafka-brokers meer dan 64 GB geheugen toegewezen krijgen. Dit geheugengebruik betekent dat één Kafka-instantie gemakkelijk snelheden kan bereiken die duizenden keren sneller zijn dan die van een traditionele berichtbroker.
Kafka kan ook worden ingesteld om de actie toe te passen sync () op boodschappenpakketten. Aangezien alles in Kafka gericht is op het werken met pakketten, werkt dit in werkelijkheid behoorlijk goed voor veel gebruiksscenario's en is het een nuttig hulpmiddel voor gebruikers die sterke garanties vereisen. Een groot deel van de pure prestaties van Kafka is gerelateerd aan de boodschappen die in de vorm van pakketten naar de broker worden verzonden, en aan het feit dat deze boodschappen sequentieel uit de broker worden gelezen met behulp van operaties (operaties waarin geen kopietaak van gegevens van het ene geheugen naar het andere wordt uitgevoerd). Het laatste is een grote winst op het gebied van prestaties en middelen en is alleen mogelijk dankzij de onderliggende datastructuur van het logboek die het partition schema bepaalt.
In een Kafka-cluster is het mogelijk om veel hogere prestaties te bereiken dan bij het gebruik van een enkele Kafka-broker, omdat de partitions van het topic horizontaal kunnen worden geschaald over meerdere afzonderlijke machines.
Conclusies
In dit hoofdstuk hebben we gekeken naar hoe de architectuur van Kafka de relaties tussen clients en brokers heroverweegt om een ongelooflijk veerkrachtige berichtenuitwisselingspijplijn te bieden, met een doorvoercapaciteit die vele malen hoger is dan die van een standaard berichtenbroker. We hebben de functionaliteiten besproken die het gebruikt om dit doel te bereiken en kort de architectuur van de toepassingen die deze functionaliteit mogelijk maken. In het volgende hoofdstuk zullen we de algemene problemen onderzoeken waarmee berichtgebaseerde toepassingen te maken krijgen en bespreken we strategieën voor het oplossen daarvan. We sluiten het hoofdstuk af door te schetsen hoe je over berichttechnologieën in het algemeen kunt redeneren, zodat je hun geschiktheid voor jouw gebruiksscenario's kunt beoordelen.
Vorige vertaalde deel:
Vertaling uitgevoerd:
Wordt vervolgd…
Alleen geregistreerde gebruikers kunnen deelnemen aan de enquête. , alstublieft.
Wordt Kafka in uw organisatie gebruikt?
Yes
No
Vroeger wel, nu niet
We zijn van plan het te gebruiken
38 gebruikers hebben gestemd. 8 gebruikers hebben zich onthouden.
Bron: habr.com
