

Het probleem van table- en indexbloat is wijdverbreid en komt niet alleen voor in Postgres. Er zijn 'out of the box' manieren om dit aan te pakken, zoals VACUUM FULL of CLUSTER, maar deze blokkeren tabellen tijdens het gebruik en kunnen daarom niet altijd worden toegepast.
In dit artikel zullen we een beetje theorie bespreken over hoe bloat ontstaat, hoe je het kunt bestrijden, over deferred constraints en over de problemen die ze met zich meebrengen bij het gebruik van de pg_repack extensie.
Dit artikel is geschreven op basis van PgConf.Russia 2020.
Waarom ontstaat bloat
De basis van Postgres is een multiversion model (). Het idee is dat elke rij in een tabel meerdere versies kan hebben, waarbij transacties niet meer dan één van deze versies zien, maar niet noodzakelijk dezelfde. Dit maakt gelijktijdige transacties mogelijk zonder veel invloed op elkaar.
Het is duidelijk dat al deze versies moeten worden opgeslagen. Postgres werkt pagina-gewijs, en een pagina is het minimale gegevensvolume dat van de schijf kan worden gelezen of erop kan worden geschreven. Laten we een klein voorbeeld bekijken om te begrijpen hoe dit werkt.
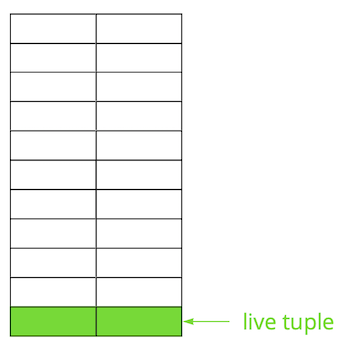
Stel dat we een tabel hebben waaraan we een aantal records hebben toegevoegd. Op de eerste pagina van het bestand waarin de tabel is opgeslagen, zijn er nieuwe gegevens verschenen. Dit zijn actieve versies van rijen die beschikbaar zijn voor andere transacties na de commit (voor de eenvoud nemen we aan dat het isolatieniveau Read Committed is).
Daarna hebben we een van de records bijgewerkt, waardoor de oude versie als verouderd is gemarkeerd.
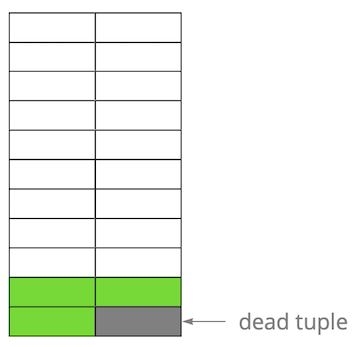
Stap voor stap, door versies van rijen bij te werken en te verwijderen, hebben we een pagina gekregen waar ongeveer de helft van de gegevens 'afval' is. Deze gegevens zijn voor geen enkele transactie zichtbaar.
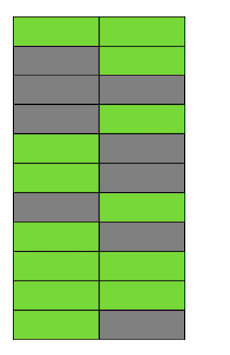
In Postgres bestaat er een mechanisme , dat verouderde versies opruimt en ruimte vrijmaakt voor nieuwe gegevens. Maar als dit niet agressief genoeg is ingesteld of bezig is met andere tabellen, blijven de 'afvalgegevens' bestaan, en moeten we extra pagina's gebruiken voor nieuwe gegevens.
In ons voorbeeld zal de tabel op een bepaald moment uit vier pagina's bestaan, maar er zal slechts de helft van de gegevens actief zijn. Als resultaat zullen we bij het raadplegen van de tabel veel meer gegevens uitlezen dan nodig is.
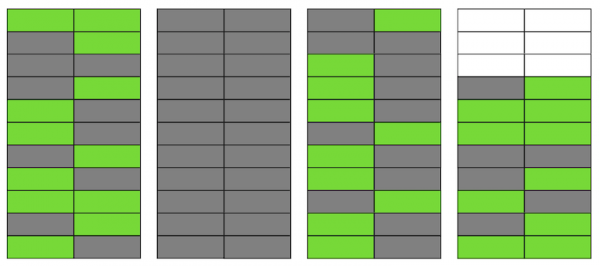
Zelfs als VACUUM nu alle obsoleet geworden versies van rijen verwijdert, zal de situatie niet drastisch verbeteren. We krijgen vrije ruimte op pagina's of zelfs hele pagina's voor nieuwe rijen, maar we zullen nog steeds meer gegevens lezen dan nodig is.
Overigens, als een volledig lege pagina (de tweede in ons voorbeeld) aan het einde van het bestand zou staan, zou VACUUM deze kunnen verwijderen. Maar nu bevindt deze zich in het midden, dus er is niets mee te doen.
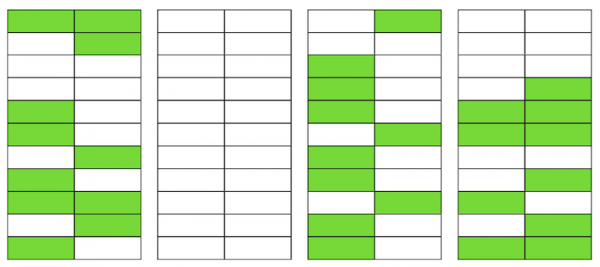
Wanneer het aantal van dergelijke lege of sterk verspreide pagina's groot wordt, wat bloat wordt genoemd, begint dit de prestaties te beïnvloeden.
De bovenstaande beschrijving is de mechanica van het ontstaan van bloat in tabellen. In indexen gebeurt dit ongeveer hetzelfde.
Heb ik bloat?
Er zijn verschillende manieren om te bepalen of je bloat hebt. Het idee van de eerste is het gebruik van interne statistieken van Postgres, die schattingen geven van het aantal rijen in tabellen, het aantal 'levende' rijen, enz. Op internet zijn veel variaties van kant-en-klare scripts te vinden. Wij hebben als basis genomen van PostgreSQL Experts, dat bloat in tabellen kan inschatten, samen met toast en bloat van btree-indexen. Volgens onze ervaring ligt de foutmarge tussen 10-20%.
Een andere manier is het gebruik van de extensie , die toestaat om binnen pagina's te kijken en zowel een schatting als een exacte waarde van bloat te krijgen. Maar in het tweede geval moet de hele tabel worden gescand.
Een kleine bloat-waarde, tot 20%, beschouwen wij als acceptabel. Dit kan worden beschouwd als een analogon van fillfactor voor en . Bij 50% of hoger kunnen er prestatiewerkzaamheden ontstaan.
Manieren om bloat te bestrijden
Postgres biedt verschillende manieren om bloat 'out of the box' te bestrijden, maar ze zijn lang niet altijd geschikt voor iedereen.
Stel AUTOVACUUM in om bloat te voorkomenEn als we specifieker zijn, zodat het op een voor u acceptabel niveau blijft. Het lijkt misschien een 'kapiteinsadvies', maar in werkelijkheid is het niet altijd gemakkelijk te bereiken. Bijvoorbeeld, als u actief ontwikkelt met regelmatige wijzigingen in het datamodel of wanneer er een gegevensmigratie plaatsvindt. Als gevolg daarvan kan uw belastingprofiel vaak veranderen en is het meestal verschillend voor verschillende tabellen. Dit betekent dat u constant een stap vooruit moet werken en AUTOVACUUM moet afstemmen op het veranderende profiel van elke tabel. Maar het is duidelijk dat dit niet eenvoudig te realiseren is.
Een andere veelvoorkomende reden waarom AUTOVACUUM de tabellen niet kan verwerken, is de aanwezigheid van langdurige transacties die het onmogelijk maken om gegevens op te ruimen omdat deze toegankelijk zijn voor deze transacties. Het advies hier is ook duidelijk: schaf de 'hangende' transacties af en minimaliseer de tijd van actieve transacties. Maar als de belasting op uw applicatie een hybride van OLAP en OLTP is, dan kunt u tegelijkertijd zowel veel frequente updates en korte aanvragen als lange operaties hebben – bijvoorbeeld het opstellen van een rapport. In zo'n situatie moet u overwegen de belasting over verschillende databases te verdelen, wat een fijnere afstemming van elke database mogelijk maakt.
Een ander voorbeeld: zelfs als het profiel homogeen is, maar de database staat onder zeer hoge druk, kan zelfs de meest agressieve AUTOVACUUM moeite hebben, en er kan bloat ontstaan. Schaling (verticaal of horizontaal) is de enige oplossing.
Wat moeten we doen in een situatie waarin u AUTOVACUUM hebt ingesteld, maar de bloat blijft toenemen?
Opdracht VACUUM FULL herbouwt de inhoud van tabellen en indices en laat alleen actuele gegevens achter. Voor het verwijderen van bloat werkt het perfect, maar tijdens de uitvoering wordt er een exclusieve blokkering op de tabel (AccessExclusiveLock) verkregen, waardoor het niet mogelijk is om aanvragen naar deze tabel uit te voeren, zelfs niet selecties. Als u het zich kunt veroorloven om uw service of een deel ervan enige tijd (van tientallen minuten tot enkele uren, afhankelijk van de grootte van de database en uw hardware) stop te zetten, dan is deze optie de beste. Helaas hebben we niet genoeg tijd om VACUUM FULL te draaien binnen de geplande onderhoudsperiode, dus deze methode is niet geschikt voor ons.
Opdracht CLUSTER Het herschikt ook de inhoud van tabellen, net als VACUUM FULL, maar stelt je in staat om een index op te geven volgens welke de gegevens fysiek op de schijf geordend zullen worden (maar voor nieuwe rijen is de volgorde in de toekomst niet gegarandeerd). In bepaalde situaties kan dit een goede optimalisatie zijn voor een aantal queries – met het lezen van meerdere records via de index. Het nadeel van het commando is hetzelfde als dat van VACUUM FULL – het blokkeert de tabel tijdens de uitvoering.
Opdracht REINDEX is vergelijkbaar met de twee voorgaande, maar voert de herschikking van een specifieke index of alle indexen van de tabel uit. De blokkeringen zijn iets zwakker: ShareLock op de tabel (verhindert wijzigingen, maar staat selecties toe) en AccessExclusiveLock op de te herschikken index (blokkeert verzoeken die deze index gebruiken). Echter, in versie 12 van Postgres is er een parameter verschenen , die het mogelijk maakt om een index te herschikken zonder gelijktijdige toevoegingen, wijzigingen of verwijderingen van records te blokkeren.
In eerdere versies van Postgres kan een vergelijkbaar resultaat als REINDEX CONCURRENTLY worden bereikt met . Dit maakt het mogelijk om een index te creëren zonder strikte blokkering (ShareUpdateExclusiveLock, wat gelijktijdige verzoeken niet verstoort), om vervolgens de oude index door de nieuwe te vervangen en de oude index te verwijderen. Dit maakt het mogelijk om bloat van indexen te verwijderen zonder de werking van je applicatie te verstoren. Het is belangrijk om te overwegen dat er extra belasting op het schijfsysteem zal zijn tijdens de herschikking van indexen.
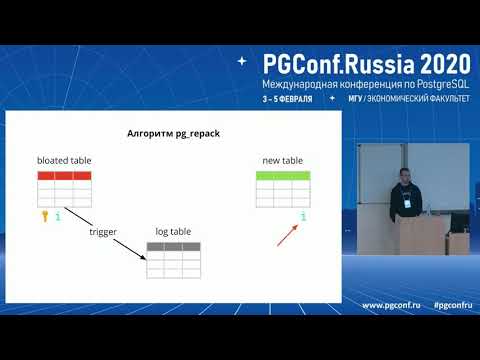
Dus, als er voor indexen manieren zijn om bloat 'hot' te verwijderen, zijn die er niet voor tabellen. Hier komen verschillende externe uitbreidingen in beeld: (voorheen pg_reorg), , en anderen. In dit artikel zal ik ze niet vergelijken en alleen vertellen over pg_repack, dat we na enige aanpassing in ons gebruik hebben.
Hoe pg_repack werkt
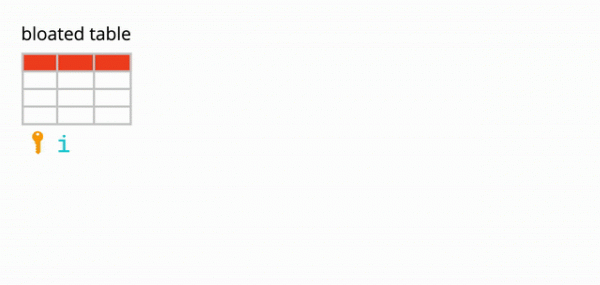
Stel dat we een vrij gewone tabel hebben – met indexen, beperkingen en, helaas, met bloat. De eerste stap die pg_repack neemt is het creëren van een log-tabel om gegevens over alle wijzigingen tijdens de uitvoering op te slaan. De trigger zal deze wijzigingen repliceren bij elke insert, update en delete. Vervolgens wordt er een tabel gemaakt, die qua structuur overeenkomt met de oorspronkelijke, maar zonder indexen en beperkingen, om het proces van gegevensinvoer niet te vertragen.
Vervolgens verplaatst pg_repack de gegevens van de oude naar de nieuwe tabel, waarbij automatisch alle irrelevante rijen worden gefilterd, en vervolgens worden de indexen voor de nieuwe tabel aangemaakt. Gedurende de uitvoering van al deze bewerkingen worden de wijzigingen in de logtabel verzameld.
De volgende stap is het overbrengen van de wijzigingen naar de nieuwe tabel. De overdracht wordt in meerdere iteraties uitgevoerd, en wanneer er minder dan 20 records in de logtabel overblijven, neemt pg_repack een strikte lock, verplaatst de laatste gegevens en vervangt de oude tabel door de nieuwe in de systeemtabellen van Postgres. Dit is het enige en zeer korte moment waarop je niet met de tabel kunt werken. Daarna worden de oude tabel en de logtabel verwijderd en komt er ruimte vrij in het bestandssysteem. Het proces is voltooid.
In theorie lijkt alles geweldig, maar hoe zit het in de praktijk? We hebben pg_repack getest zonder belasting en onder belasting, en hebben de werking ervan gecontroleerd in geval van voortijdige stopzetting (in gewone taal, bij Ctrl+C). Alle testen waren positief.
We zijn naar de productie gegaan - en hier ging alles niet zoals we hadden verwacht.
De eerste keer in productie
Bij het eerste cluster kregen we een foutmelding over schending van de unieke beperking:
$ ./pg_repack -t tablename -o id
INFO: repacking table "tablename"
ERROR: query failed:
    ERROR: duplicate key value violates unique constraint "index_16508"
DETAIL:  Key (id, index)=(100500, 42) already exists.
Deze beperking had een automatisch gegenereerde naam index_16508 – deze is door pg_repack aangemaakt. Aan de hand van de kenmerken die erin zijn opgenomen, hebben we onze beperking bepaald die overeenkomt met deze. Het probleem was dat dit geen gewone beperking is, maar een uitgestelde (), dat wil zeggen dat de controle later wordt uitgevoerd dan de SQL-opdracht, wat tot onverwachte gevolgen leidt.
Uitgestelde beperkingen: waarom ze nodig zijn en hoe ze werken
Een beetje theorie over uitgestelde beperkingen.
Laten we een eenvoudig voorbeeld bekijken: we hebben een referentietabel voor auto's met twee kenmerken - de naam en de volgorde van de auto in de referentie.
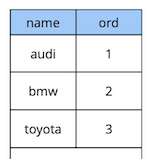
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Stel dat we de eerste en tweede auto van plaats willen verwisselen. De ‘rechttoe rechtaan’ oplossing is om de eerste waarde naar de tweede te updaten, en de tweede naar de eerste:
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
Maar bij het uitvoeren van deze code zullen we verwachte wijze een schending van de beperking krijgen, omdat de volgorde van de waarden in de tabel uniek is:
[23305] FOUT: duplicaat sleutelwaarde schendt unieke beperking “uk_cars”
Detail: Sleutel (ord)=(2) bestaat al.
Hoe anders te doen? Eerste optie: voeg een extra vervangwaarde toe voor een volgorde die gegarandeerd niet in de tabel voorkomt, bijvoorbeeld “-1”. In programmeren noemt men dit “de waarden van twee variabelen ruilen via een derde”. Het enige nadeel van deze methode is de extra update.
Tweede optie: herontwerp de tabel zodat de volgordewaarde een floating-point datatype gebruikt in plaats van gehele getallen. Dan zal bij het bijwerken van de waarde van 1, bijvoorbeeld naar 2.5, het eerste record automatisch tussen het tweede en derde komen te staan. Deze oplossing werkt, maar er zijn twee beperkingen. Ten eerste, het is niet geschikt als de waarde ergens in de interface wordt gebruikt. Ten tweede, afhankelijk van de precisie van het datatype zult u een beperkt aantal mogelijke invoegen hebben voordat u alle waarden van de records opnieuw moet berekenen.
Derde optie: maak de beperking uitgesteld, zodat deze pas wordt gecontroleerd op het moment van commit:
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique deferrable initially deferred
);
Aangezien de logica van onze oorspronkelijke query garandeert dat tegen de tijd van de commit alle waarden uniek zijn, zal deze succesvol worden uitgevoerd.
Het hierboven besproken voorbeeld is natuurlijk zeer synthetisch, maar het onthult het idee. In onze applicatie gebruiken we uitgestelde beperkingen om de logica te implementeren die verantwoordelijk is voor het oplossen van conflicten wanneer gebruikers gelijktijdig met gedeelde objecten-widget op het bord werken. Het gebruik van dergelijke beperkingen stelt ons in staat om de applicatiecode iets eenvoudiger te maken.
Over het algemeen, afhankelijk van het type beperking, zijn er in Postgres drie niveaus van granulariteit voor hun controle: rijniveau, transactie- en expressieniveau.
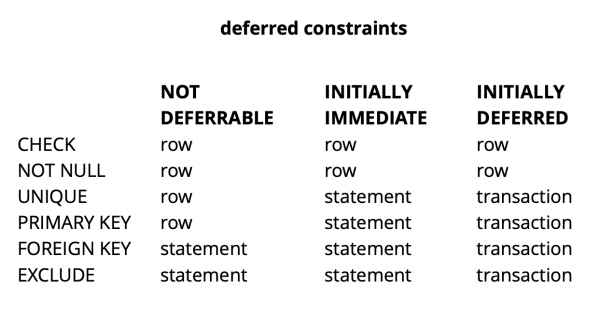
Bron:
CHECK en NOT NULL worden altijd gecontroleerd op het rijniveau, voor andere beperkingen, zoals te zien is in de tabel, zijn er verschillende opties. Meer details zijn te lezen. .
Samengevat geven uitgestelde beperkingen in bepaalde situaties een leesbaardere code en minder commando's. Echter, dit komt met de prijs van een complexer debugproces, omdat het moment waarop een fout optreedt en het moment waarop je ervan op de hoogte bent in de tijd uit elkaar liggen. Een ander mogelijk probleem is dat de planner niet altijd een optimale planning kan maken als er een uitgestelde beperking in de aanvraag is.
Aanpassing pg_repack
We hebben begrepen wat uitgestelde beperkingen zijn, maar hoe zijn ze gerelateerd aan ons probleem? Laten we de fout herinneren die we eerder hebben gekregen:
$ ./pg_repack -t tablename -o id
INFO: repacking table "tablename"
ERROR: query failed:
    ERROR: duplicate key value violates unique constraint "index_16508"
DETAIL:  Key (id, index)=(100500, 42) already exists.
Deze doet zich voor op het moment dat gegevens uit de logtabel naar de nieuwe tabel worden gekopieerd. Dit lijkt vreemd, omdat de gegevens in de logtabel samen met de gegevens van de oorspronkelijke tabel worden gecommitteerd. Als ze voldoen aan de beperkingen van de oorspronkelijke tabel, hoe kunnen ze dan dezelfde beperkingen in de nieuwe schenden?
Blijkbaar ligt de wortel van het probleem in de vorige stap van het werken met pg_repack, waar alleen indexen worden aangemaakt, maar geen beperkingen: in de oude tabel was er een unieke beperking, en in de nieuwe is in plaats daarvan een unieke index aangemaakt.
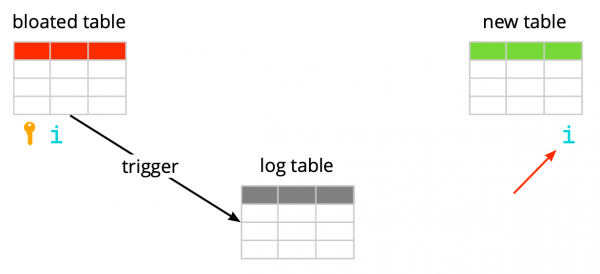
Het is belangrijk op te merken dat als de beperking normaal is en niet uitgesteld, de unieke index die er in plaats van ontstaat gelijkwaardig is aan die beperking, omdat unieke beperkingen in Postgres worden geïmplementeerd door het maken van een unieke index. Maar in het geval van een uitgestelde beperking is het gedrag niet hetzelfde, omdat een index niet uitgesteld kan zijn en altijd wordt gecontroleerd op het moment van uitvoering van de sql-opdracht.
Dus de essentie van het probleem ligt in de 'uitstel' van de check: in de oorspronkelijke tabel gebeurt deze op het moment van commit, en in de nieuwe op het moment van uitvoering van de sql-opdracht. Dat betekent dat we ervoor moeten zorgen dat de controles in beide gevallen op dezelfde manier plaatsvinden: ofwel altijd uitgesteld, ofwel altijd onmiddellijk.
Dus, welke ideeën hadden we.
Creëer een index die gelijkwaardig is aan uitgesteld.
Het eerste idee is om beide controles in de onmiddellijke modus uit te voeren. Dit kan enkele false positives van beperkingen veroorzaken, maar als het er niet te veel zijn, zou dit de gebruikerservaring niet moeten beïnvloeden, omdat dergelijke conflicten normaal zijn voor hen. Ze komen bijvoorbeeld voor wanneer twee gebruikers tegelijkertijd dezelfde widget beginnen te bewerken, en de client van de tweede gebruiker er niet op tijd in slaagt om de informatie te krijgen dat de widget al geblokkeerd is voor bewerking door de eerste gebruiker. In zo'n situatie weigert de server de tweede gebruiker, en zijn client maakt de wijzigingen ongedaan en blokkeert de widget. Iets later, wanneer de eerste gebruiker de bewerking heeft voltooid, ontvangt de tweede gebruiker de informatie dat de widget niet langer geblokkeerd is, en kan hij zijn actie herhalen.
Om ervoor te zorgen dat de controles altijd in de urgentie-modus plaatsvinden, hebben we een nieuwe index gemaakt, die vergelijkbaar is met de originele uitgestelde beperking:
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- run pg_repack
DROP INDEX CONCURRENTLY uk_tablename__immediate;
In de testomgeving kregen we slechts een paar verwachte fouten. Succes! We hebben pg_repack opnieuw in de productie uitgevoerd en kregen 5 fouten in de eerste cluster na een uur werken. Dit is een acceptabel resultaat. Echter, in de tweede cluster nam het aantal fouten exponentieel toe en moesten we pg_repack stoppen.
Waarom gebeurde dit? De kans op fouten hangt af van het aantal gebruikers dat tegelijkertijd met dezelfde widgets werkt. Blijkbaar waren er op dat moment veel minder concurrerende wijzigingen in de gegevens die op de eerste cluster werden opgeslagen dan in de andere, wat betekent dat we gewoon 'geluk' hadden.
Het idee werkte niet. Op dat moment zagen we twee andere oplossingsvarianten: onze applicatiecode herschrijven om af te zien van uitgestelde beperkingen, of pg_repack 'te leren' werken met deze beperkingen. We hebben voor de tweede optie gekozen.
De indices in de nieuwe tabel vervangen door de uitgestelde beperkingen van de oorspronkelijke tabel.
Het doel van de aanpassing was duidelijk – als de oorspronkelijke tabel een uitgestelde beperking heeft, moet er voor de nieuwe een dergelijk beperking worden aangemaakt in plaats van een index.
Om onze wijzigingen te controleren, hebben we een eenvoudige test geschreven:
- een tabel met een uitgestelde beperking en één record;
- we voegen in een lus gegevens toe die conflicteren met het bestaande record;
- we doen een update - de gegevens conflicten niet meer;
- we committen de wijzigingen.
create table test_table
(
  id serial,
  val int,
  constraint uk_test_table__val unique (val) deferrable initially deferred
);
INSERT INTO test_table (val) VALUES (0);
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (0) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    COMMIT;
  END;
END LOOP;
De oorspronkelijke versie van pg_repack viel altijd bij de eerste insert, de verbeterde versie werkte zonder fouten. Geweldig.
We gaan naar productie en krijgen opnieuw een fout tijdens dezelfde fase van het kopiëren van gegevens uit de logtabel naar de nieuwe:
$ ./pg_repack -t tablename -o id
INFO: repacking table "tablename"
ERROR: query failed:
    ERROR: duplicate key value violates unique constraint "index_16508"
DETAIL:  Key (id, index)=(100500, 42) already exists.
Een klassieke situatie: op testomgevingen werkt alles, maar in productie - niet?!
APPLY_COUNT en de overgang tussen twee batches
We zijn de code letterlijk regel voor regel gaan analyseren en ontdekten een belangrijk punt: de overdracht van gegevens uit de logtabel naar de nieuwe gebeurt in batches, de constante APPLY_COUNT gaf de batchgrootte aan:
for (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

if (num > MIN_TUPLES_BEFORE_SWITCH)
     continue;
/* er kunnen nog steeds enkele tuples zijn, herhaal. */
...
}
Het probleem is dat de gegevens van de oorspronkelijke transactie, waarin meerdere bewerkingen potentieel de beperking kunnen schenden, bij de overdracht op de overgang tussen twee batches kunnen terechtkomen - de helft van de commando's wordt gecommit in de eerste batch, en de andere helft in de tweede. En hier heb je geluk: als de commando's in de eerste batch niets schenden, is alles goed, als ze wel schenden - ontstaat er een fout.
APPLY_COUNT is gelijk aan 1000 records, wat verklaart waarom onze tests succesvol waren - ze dekte de situatie van de 'overgang tussen batches' niet. We gebruikten twee commando's - insert en update, zodat precies 500 transacties met twee commando's altijd in de batch pasten en we geen problemen ondervonden. Na het toevoegen van de tweede update stopte onze wijziging met werken:
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (1) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    UPDATE test_table set val = i where id = v_id; -- nog een update
    COMMIT;
  END;
END LOOP;
Dus de volgende taak is om ervoor te zorgen dat de gegevens uit de oorspronkelijke tabel, die binnen één transactie zijn gewijzigd, ook binnen één transactie in de nieuwe tabel komen.
Afzien van batching
En we hadden opnieuw twee oplossingen. De eerste: laten we het splitsen in batches volledig achterwege laten en de data in één transactie overdragen. De eenvoud van deze oplossing sprak in ons voordeel – de benodigde codewijzigingen zijn minimaal (overigens werkte pg_reorg in de oudere versies zo). Maar er is een probleem — we creëren een langdurige transactie, wat, zoals eerder vermeld, een risico is voor de mogelijkheid van nieuwe bloat.
De tweede oplossing — complexer, maar waarschijnlijk meer correct: creëer in de logtabel een kolom met de identificatie van de transactie die de data in de tabel heeft toegevoegd. Dan kunnen we de gegevens tijdens het kopiëren groeperen op basis van deze eigenschap en garanderen dat gerelateerde wijzigingen samen worden overgedragen. Een batch zal bestaan uit meerdere transacties (of één grote) en de grootte zal variëren, afhankelijk van hoeveel data in deze transacties is gewijzigd. Het is belangrijk op te merken dat, aangezien gegevens van verschillende transacties in willekeurige volgorde in de logtabel terechtkomen, het niet meer mogelijk is om deze sequentieel te lezen zoals eerder. seqscan bij elke aanvraag met filter op tx_id is te duur; er is een index nodig, maar die zal ook de werking van de methode vertragen door de overhead van de updates. Kortom, zoals altijd moet er ergens voor worden opgeofferd.
Dus besloten we om met de eerste optie te beginnen, omdat deze eenvoudiger was. Eerst moesten we bepalen of een langdurige transactie een echt probleem zou zijn. Aangezien de belangrijkste data-overdracht van de oude tabel naar de nieuwe ook in één langdurige transactie plaatsvindt, werd de vraag ‘hoeveel vergroten we deze transactie?’ De duur van de eerste transactie hangt voornamelijk af van de grootte van de tabel. De duur van de nieuwe is afhankelijk van hoeveel wijzigingen er in de tabel worden verzameld tijdens de data-overdracht, d.w.z. van de intensiteit van de belasting. De pg_repack draait tijdens minimale belasting op de service en het volume van de wijzigingen was vergeleken met het oorspronkelijke volume van de tabel verwaarloosbaar klein. We besloten dat we de tijd van de nieuwe transactie konden negeren (ter vergelijking gemiddeld is het 1 uur en 2-3 minuten).
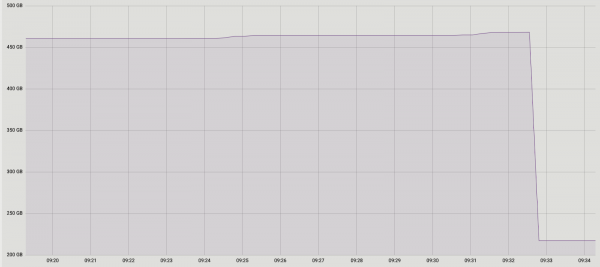
De experimenten waren positief. De lancering op productie ook. Voor de duidelijkheid – hier is een afbeelding van de grootte van een van de databases na het uitvoeren:
Aangezien deze oplossing ons volledig bevalt, hebben we niet geprobeerd om een tweede te implementeren, maar we overwegen de mogelijkheid om deze met de ontwikkelaars van de extensie te bespreken. Helaas is onze huidige aanpassing nog niet klaar voor publicatie, omdat we het probleem alleen met unieke uitgestelde beperkingen hebben opgelost, en voor een volledige patch moet ook ondersteuning voor andere typen worden gerealiseerd. We hopen dit in de toekomst te kunnen doen.
Misschien vraagt u zich af waarom we ons überhaupt in deze kwestie van het aanpassen van pg_repack hebben gestort, en niet simpelweg zijn overgestapt op alternatieven? Op een gegeven moment dachten we daar ook over na, maar de positieve ervaring die we eerder hadden met het gebruik ervan op tabellen zonder uitgestelde beperkingen, motiveerde ons om de kern van het probleem te proberen te begrijpen en op te lossen. Bovendien vereist het gebruik van andere oplossingen ook tijd voor tests, dus hebben we besloten eerst te proberen het probleem daarin op te lossen, en als we begrijpen dat we dit niet binnen een redelijke termijn kunnen verwezenlijken, zullen we alternatieven overwegen.
Conclusies
Wat we kunnen aanbevelen op basis van eigen ervaring:
- Houd uw bloat in de gaten. Op basis van de monitoringsdata kunt u begrijpen hoe goed autovacuum is ingesteld.
- Stel AUTOVACUUM in om bloat op een aanvaardbaar niveau te houden.
- Als bloat toch toeneemt en u kunt het niet bestrijden met de standaardtools, wees dan niet bang om externe uitbreidingen te gebruiken. Het belangrijkste is dat u alles goed test.
- Wees niet bang om externe oplossingen aan te passen aan uw behoeften – soms kan dit effectiever en zelfs eenvoudiger zijn dan het aanpassen van uw eigen code.
Bron: habr.com
