

Fijn vrijdag iedereen! Er blijft steeds minder tijd over tot de lancering van de cursus , daarom delen we vandaag de vertaling van nog een nuttig materiaal over dit onderwerp.
Tijdens de ontwikkeling is er indrukwekkend werk verricht om de table partitioning te verbeteren. Tabelpartitionering is een functie die al geruime tijd in PostgreSQL bestaat, maar die, als je het zo wilt zeggen, in wezen pas echt aanwezig was sinds versie 10, waar het een zeer nuttige functie werd. Eerder hebben we gesteld dat table inheritance onze implementatie van partitionering is, en dat is waar. Alleen dat deze methode je dwong om het grootste deel van het werk handmatig te doen. Bijvoorbeeld, als je wilde dat tuples in secties werden ingevoerd tijdens INSERTs, moest je triggers instellen om dat voor je te doen. Partitionering via inheritance was erg traag en complex om aanvullende functies bovenop te ontwikkelen.
In PostgreSQL 10 zagen we de geboorte van «declarative partitioning» — een functie die is ontworpen om veel problemen op te lossen die onoplosbaar waren met de oude methode via inheritance. Dit leidde tot de komst van een veel krachtiger hulpmiddel waarmee we gegevens horizontaal kunnen splitsen!
Vergelijking van functies
In PostgreSQL 11 is er een indrukwekkende set nieuwe functies toegevoegd die helpen de prestaties te verbeteren en partitioned tables transparanter te maken voor applicaties.
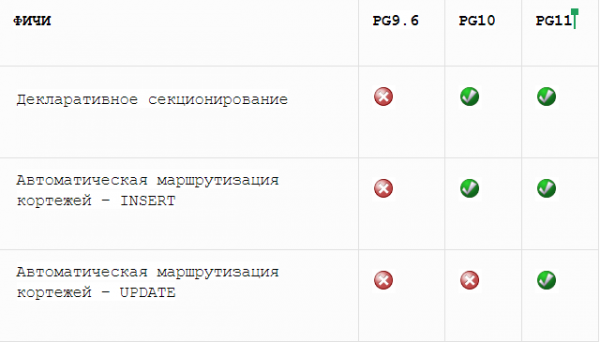
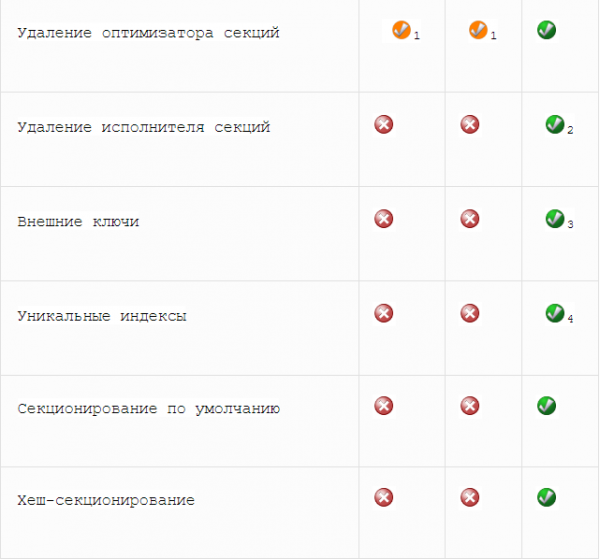
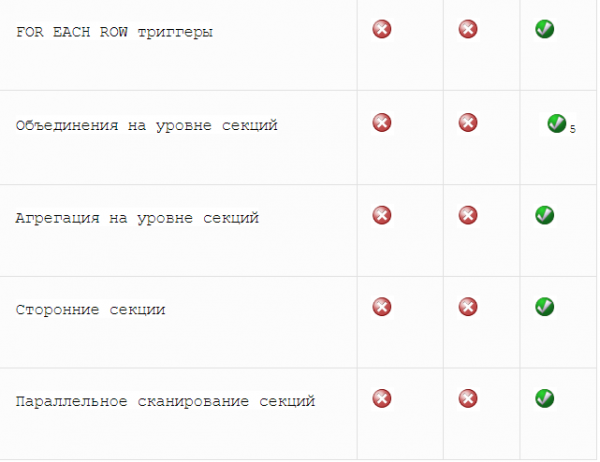
1. Het gebruik van constraint exclusions
2. Voegt alleen knooppunten toe
3. Alleen voor partitioned tables die verwijzen naar niet-gepartitioneerde
4. Indexen moeten alle sleutelkolommen van de sectie bevatten
5. Beperkingen van de sectie aan beide zijden moeten overeenkomen
Prestaties
Hier hebben we ook goed nieuws! Er is een nieuwe methode toegevoegd voor . Dit nieuwe algoritme kan geschikte secties identificeren door de query-voorwaarde te bekijken WAAR. Het vorige algoritme controleerde elke sectie om te bepalen of deze aan de voorwaarde kon voldoen WAAR. Dit leidde tot een extra toename van de planningsduur naarmate het aantal secties groeide.
In 9.6, with partitioning using inheritance, routing tuples in a section was typically done by writing a trigger function that contained a series of IF statements to insert the tuple into the correct section. These functions could be very slow in execution. With declarative partitioning introduced in version 10, this now works much faster.
Using a partitioned table with 100 sections, we can evaluate the performance of loading 10 million rows into a table with 1 BIGINT column and 5 INT columns.
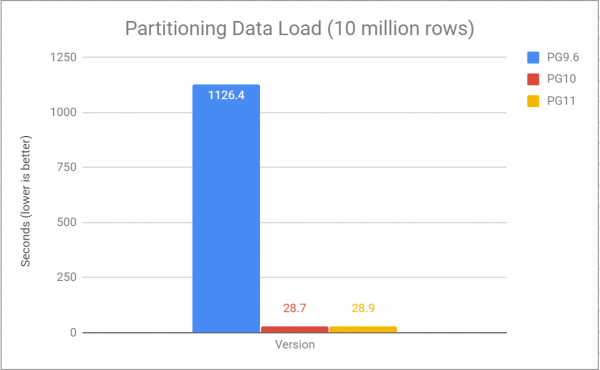
The performance of a query to this table for searching one indexed record and executing DML to manipulate one record (using only 1 processor):
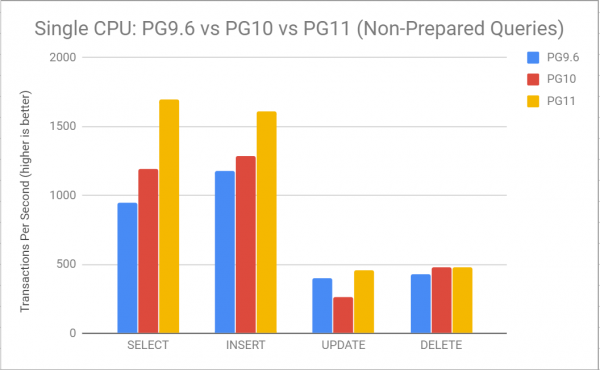
Here we see that the performance of each operation significantly increased after PG 9.6. Queries SELECT look much better, especially those capable of excluding multiple sections during query planning. This means that the planner can skip much of the work it had to do before. For example, paths for unnecessary sections are no longer built.
Conclusie
Table partitioning is becoming a very powerful feature in PostgreSQL. It allows for quick output of data online and transferring it offline without waiting for slow massive DML operations to complete.It also means that related data can be stored together, allowing access to the required data to be much more efficient. The improvements made in this version would not have been possible without the developers, reviewers, and committers who tirelessly worked on all of these features.
Thanks to them all! PostgreSQL 11 looks simply fantastic!
Here’s a short but quite interesting article. Share your comments, and don’t forget to register for the , during which the course program will be detailed.
Bron: habr.com
