

In SQL, you describe 'what' you want to obtain, not 'how' it should be executed. Therefore, the issue of developing SQL queries in a 'write as you hear' style holds its esteemed place alongside .
Today, through the simplest examples, we will see what this can lead to in the context of using GROUP/DISTINCT en LIMIT alongside them.
If you wrote in the query 'first, join these tables, and then throw away all duplicates, only one instance per key should remain' — that is exactly how it will work, even if the join was not needed at all.
Sometimes it works out and 'just works', sometimes it negatively affects performance, and other times it gives completely unexpected effects from the developer's point of view.
Well, maybe not as spectacular, but…
'The sweet couple': JOIN + DISTINCT
SELECT DISTINCT
  X.*
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
WHERE
  Y.bool_condition;
It's clear what they wanted to select such records X for which there are related records in Y that meet the executing condition.The query was written through JOIN — resulting in some pk values being returned multiple times (exactly as many as the matching records in Y turned out to be). How to remove them? Of course, UNIEK!
It’s especially 'exciting' when each X record finds several hundred related Y records, and then duplicates are heroically removed…
How to fix it? First, realize that the task can be modified to 'select such records X for which there is AT LEAST ONE related record in Y that meets the executing condition' — since we don’t need anything from the Y record itself.
Nested EXISTS
SELECT
  *
FROM
  X
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  );
Some versions of PostgreSQL understand that in EXISTS it is enough to find the first matching record, older ones do not. Therefore, I always prefer to specify LIMIT 1 binnenin EXISTS.
LATERAL JOIN
SELECT
  X.*
FROM
  X
, LATERAL (
    SELECT
      Y.*
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  ) Y
WHERE
  Y IS DISTINCT FROM NULL;
This same option allows you to simultaneously return some data from the found related Y record if needed. A similar option is discussed in the article .
'Why pay more': DISTINCT [ON] + LIMIT 1
Een extra voordeel van dergelijke query-transformaties is de mogelijkheid om eenvoudig de selectie van records te beperken, als we er slechts één of enkele nodig hebben, zoals in het volgende geval:
SELECT DISTINCT ON(X.pk)
  *
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Laten we nu de query lezen en proberen te begrijpen wat er door het DBMS wordt voorgesteld:
- verbinden van tabellen
- uniek maken op X.pk
- uit de resterende records kies een enkele
Wat hebben we dus gekregen? «Een enkele record» uit de unieke — en als we deze ene uit de niet-unieke nemen, verandert het resultaat dan op een of andere manier? .. «Als er geen verschil is, waarom meer betalen?»
SELECT
  *
FROM
  (
    SELECT
      *
    FROM
      X
    -- hier kunnen geschikte voorwaarden worden toegevoegd
    LIMIT 1 -- +1 Limit
  ) X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
En hetzelfde geldt voor GROUP BY + LIMIT 1.
«Ik moet alleen vragen»: impliciete GROUP + LIMIT
Dergelijke zaken komen voor bij verschillende controle op leegte tabellen of CTE's tijdens het uitvoeren van de query:
...
CASE
  WHEN (
    SELECT
      count(*)
    FROM
      X
    LIMIT 1
  ) = 0 THEN ...
Aggregaatfuncties (count/min/max/sum/...) worden met succes uitgevoerd op de gehele dataset, zelfs zonder expliciete vermelding. Toegang tot de recursieve 'tabel' kan zich niet in een genestelde subquery bevinden.. Alleen deze LIMIT komen niet goed overeen.
De ontwikkelaar kan denken «Als er records zijn, dan moet ik niet meer dan LIMIT». Maar dat moet niet! Want voor de database is het:
- tel wat ze willen geef zoveel rijen als gevraagd
- Afhankelijk van de doelvoorwaarden is hier een van de vervangingen eens passend:
(count + LIMIT 1) = 0
NOT EXISTS(LIMIT 1)en een werkende opdracht krijgen.(count + LIMIT 1) > 0EXISTS(LIMIT 1)en een werkende opdracht krijgen.count >= N(SELECT count(*) FROM (... LIMIT N))en een werkende opdracht krijgen.«Hoeveel weeg ik in grammen»: DISTINCT + LIMIT
SELECT DISTINCT pk FROM X LIMIT $1
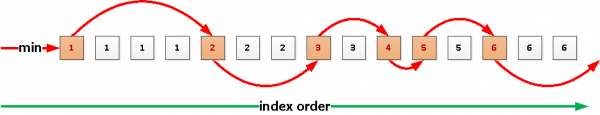
Een naïeve ontwikkelaar kan oprecht geloven dat de uitvoering van de query zal stoppen,zodra we $1 eerste verschillende waarden vinden. In de toekomst kan dit werken dankzij de nieuwe node.
Index Skip Scan , waarvan de implementatie nu wordt uitgewerkt, maar voorlopig — niet.Voorlopig worden eerst
alle records opgehaald , uniek gemaakt, en alleen al uit deze records wordt teruggegeven wat er is gevraagd. Het is vooral treurig als we iets als, en er honderden duizenden records in de tabel zijn... $1 = 4Om niet onnodig verdrietig te zijn, laten we de recursieve query
«DISTINCT voor de armen» uit de PostgreSQL Wiki gebruiken. :
Bron: habr.com
