

In complexe ERP-systemen hebben veel entiteiten een hiërarchische aard, waarbij homogene objecten zich rangschikken in een boomstructuur van ‘voorouder – nakomeling’ — dit betreft zowel de organisatiestructuur van een bedrijf (al die vestigingen, afdelingen en werkgroepen), alsook een productcatalogus, takengebieden en de geografie van verkooplocaties,…
Feitelijk is er geen enkele , waar er op enige manier geen hiërarchie aanwezig zou zijn. Maar zelfs als je niet in het ‘zakelijke’ werkt, kun je nog steeds gemakkelijk met hiërarchische relaties worden geconfronteerd. Gewoonlijk, zelfs jouw stamboom of de plattegrond van een winkelcentrum zijn een soortgelijke structuur.
Er zijn veel manieren om zo’n boom in een DBMS op te slaan, maar vandaag zullen we ons alleen concentreren op één optie:
CREATE TABLE hier(
  id
    integer
      PRIMARY KEY
, pid
    integer
      REFERENCES hier
, data
    json
);

CREATE INDEX ON hier(pid); -- vergeet niet dat FK niet automatisch een index aanmaakt, in tegenstelling tot PK
En terwijl je de diepte van de hiërarchie bestudeert, wacht deze geduldig tot je ‘naïeve’ manieren van werken met een dergelijke structuur al dan niet ‘effectief’ zullen blijken te zijn.
Laten we gangbare problemen analyseren, hun implementatie in SQL bekijken en proberen hun prestaties te verbeteren.
#1. Насколько глубока кроличья нора?
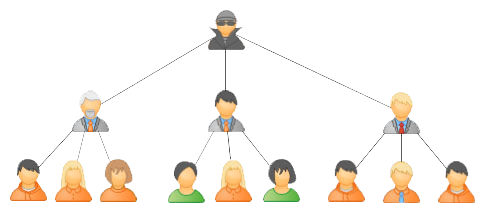
Laten we, ter verduidelijking, aannemen dat deze structuur onze afhankelijkheden van afdelingen in de organisatiestructuur zal weerspiegelen: departementen, divisies, sectoren, vestigingen, werkgroepen,… hoe je ze ook noemt.
Laten we beginnen met het genereren van onze 'boom' van 10K elementen
INSERT INTO hier
WITH RECURSIVE T AS (
  SELECT
    1::integer id
  , '{1}'::integer[] pids
UNION ALL
  SELECT
    id + 1
  , pids[1:(random() * array_length(pids, 1))::integer] || (id + 1)
  FROM
    T
  WHERE
    id < 10000
)
SELECT
  pids[array_length(pids, 1)] id
, pids[array_length(pids, 1) - 1] pid
FROM
  T;
Laten we beginnen met de eenvoudigste taak — het vinden van alle medewerkers die binnen een specifieke sector werken, of in hiërarchische termen — het vinden van alle nakomelingen van een knooppunt. En het zou ook goed zijn om de ‘diepte’ van de nakomeling te krijgen… Dit kan bijvoorbeeld nodig zijn voor het opbouwen van een .
Het zou allemaal goed zijn als er maar een paar niveaus van deze afstammelingen zijn en het aantal binnen een tiental blijft, maar als er meer dan 5 niveaus zijn en de afstammelingen al tientallen zijn, kunnen er problemen ontstaan. Laten we eens kijken hoe de traditionele methoden om 'diep in de boom' te zoeken worden geschreven (en werken). Maar laten we eerst bepalen welke van de knooppunten het meest interessant zullen zijn voor ons onderzoek.
De meest diepe subbomen:
WITH RECURSIVE T AS (
  SELECT
    id
  , pid
  , ARRAY[id] path
  FROM
    hier
  WHERE
    pid IS NULL
UNION ALL
  SELECT
    hier.id
  , hier.pid
  , T.path || hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T ORDER BY array_length(path, 1) DESC;
id | pid | path
---------------------------------------------
7624 | 7623 | {7615,7620,7621,7622,7623,7624}
4995 | 4994 | {4983,4985,4988,4993,4994,4995}
4991 | 4990 | {4983,4985,4988,4989,4990,4991}
...De meest de brede subbomen:
...
SELECT
  path[1] id
, count(*)
FROM
  T
GROUP BY
  1
ORDER BY
  2 DESC;
id | count
------------
5300 | 30
450 | 28
1239 | 27
1573 | 25
Voor deze query's hebben we gebruik gemaakt van een typische recursieve JOIN:
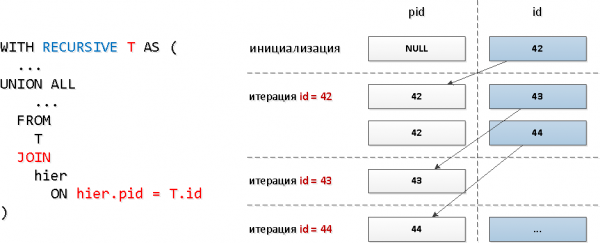
Het is duidelijk dat bij dit soort query's het aantal iteraties zal overeenkomen met het totale aantal afstammelingen (en dat zijn er tientallen), en dit kan aanzienlijke middelen en dus tijd vergen.
Laten we het testen op de 'breedste' subboom:
WITH RECURSIVE T AS (
  SELECT
    id
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T; 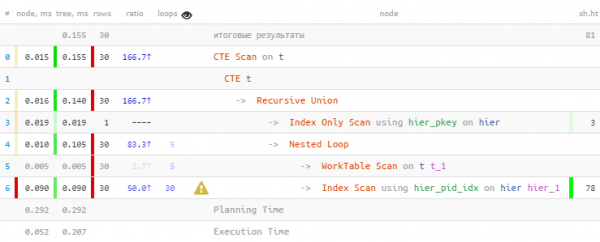
Zoals we vermoedden, hebben we alle 30 records gevonden. Maar we besteedden 60% van de totale tijd — omdat we daarbij ook 30 zoekopdrachten op de index hebben gedaan. Is er een mogelijkheid om het te reduceren?
Massale uitlezing op de index
Is het voor elk knooppunt nodig om een aparte aanvraag naar de index te doen? Blijkt van niet — we kunnen tegelijkertijd op meerdere sleutels uit de index lezen in één keer met behulp van = ANY(array).
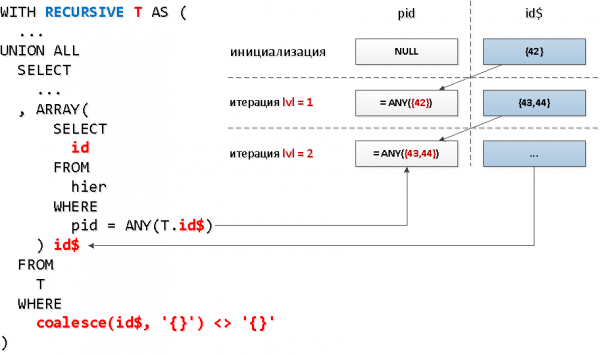
En in elke dergelijke groep van identificatoren kunnen we alle op de vorige stap gevonden ID's nemen per 'knooppunt'. Dit betekent dat we bij elke volgende stap tegelijkertijd alle afstammelingen van een bepaald niveau zullen zoeken..
Alleen, dat is het probleem, in een recursieve selectie kan je niet naar jezelf verwijzen in de geneste query, maar we moeten wel op de een of andere manier alleen kiezen wat op het vorige niveau is gevonden... Blijkt dat het maken van een geneste query voor de gehele selectie niet mogelijk is, maar voor een specifiek veld kan het wel. En dat specifieke veld kan ook een array zijn - wat we nodig hebben om te gebruiken. ANY.
Het klinkt misschien wat vreemd, maar op de schema is het heel eenvoudig.
MET RECURSIVE T AS (
  SELECT
    ARRAY[id] id$
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    ARRAY(
      SELECT
        id
      FROM
        hier
      WHERE
        pid = ANY(T.id$)
    ) id$
  FROM
    T
  WHERE
    coalesce(id$, '{}')  '{}' -- uitgangsvoorwaarde van de lus - lege array
)
SELECT
  unnest(id$) id
FROM
T; 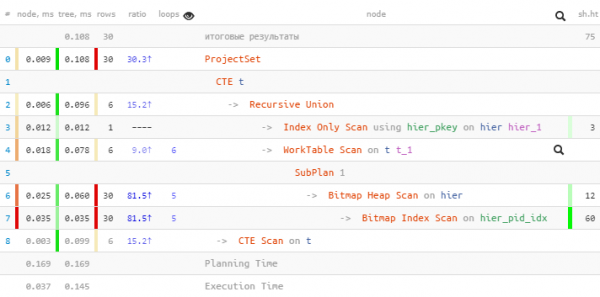
En het belangrijkste hier is zelfs niet de winst van 1,5 keer in tijd, maar dat we minder buffers hebben afgetrokken, omdat we in totaal maar 5 indexaanroepen hebben in plaats van 30!
Een extra voordeel is dat na de laatste unnest de identificatoren geordend zullen blijven op ‘niveaus’.
Kenmerk van de knoop
Een volgende overweging die kan helpen de prestaties te verbeteren is dat ‘bladeren’ geen kinderen kunnen hebben, dat wil zeggen dat we ‘omlaag’ voor hen helemaal niets hoeven te zoeken. In de context van onze taak betekent dit dat als we langs de keten van afdelingen zijn gegaan en bij een medewerker zijn aangekomen, we verder langs deze tak niet meer hoeven te zoeken.
Laten we een extra boolean-veld invoeren, dat ons onmiddellijk vertelt of dit specifieke record in onze boom een ‘knoop’ is - dat wil zeggen of het überhaupt nakomelingen kan hebben.
ALTER TABLE hier
  ADD COLUMN branch boolean;

UPDATE
  hier T
SET
  branch = TRUE
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      hier
    WHERE
      pid = T.id
    LIMIT 1
);
-- De query is succesvol uitgevoerd: 3033 rijen gewijzigd in 42 ms.
Geweldig! Blijkbaar heeft iets meer dan 30% van alle elementen in de boom nakomelingen.
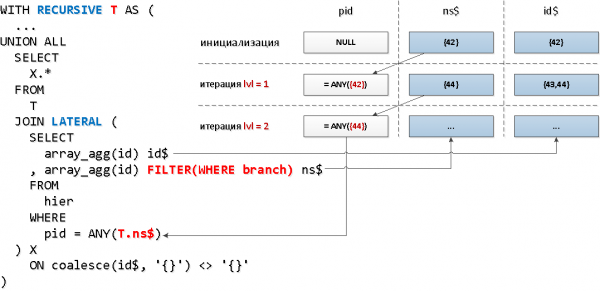
Laten we nu een andere mechaniek toepassen - verbindingen met het recursieve deel via LATERAL, wat ons in staat zal stellen om onmiddellijk naar de velden van de recursieve ‘tabel’ te verwijzen, en we gebruiken de aggregatiefunctie met een filtervoorwaarde op basis van het kenmerk van de knoop om de set sleutels te verkleinen:
MET RECURSIVE T AS (
  SELECT
    array_agg(id) id$
  , array_agg(id) FILTER(WHERE branch) ns$
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    X.*
  FROM
    T
  JOIN LATERAL (
    SELECT
      array_agg(id) id$
    , array_agg(id) FILTER(WHERE branch) ns$
    FROM
      hier
    WHERE
      pid = ANY(T.ns$)
  ) X
    ON coalesce(T.ns$, '{}')  '{}'
)
SELECT
  unnest(id$) id
FROM
T; 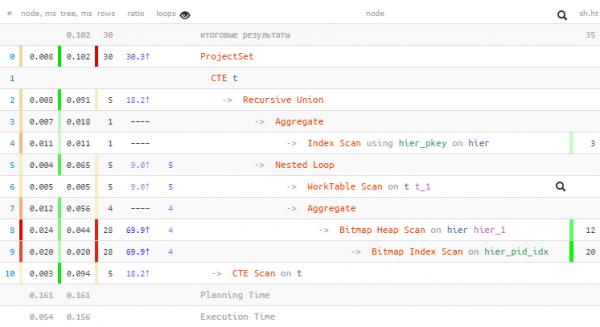
We hebben nog een indexaanroep kunnen verkorten en meer dan twee keer gewonnen in volume dat we inlezen.
#2. Вернемся к корням
Dit algoritme zal nuttig zijn als u records voor alle elementen ‘omhoog in de boom’ moet verzamelen, terwijl u de informatie behoudt over welk origineel blad (en met welke indicatoren) het in de selectie is opgenomen - bijvoorbeeld voor het opstellen van een samenvattend rapport met aggregatie op knopen.
Het vervolg moet uitsluitend gezien worden als proof-of-concept, aangezien de query behoorlijk omslachtig is. Maar als deze dominant is in jouw database, is het de moeite waard om dergelijke methoden toe te passen.
Laten we beginnen met een paar eenvoudige statements:
- Eenzelfde record uit de database is beter één keer te lezen.
- Records uit de database zijn efficiënter te lezen in een 'batch', dan afzonderlijk.
Laten we nu proberen om de gewenste query te construeren.
Stap 1
Het is duidelijk dat we bij de initiatie van de recursie (waarom niet!) de records van de bladeren moeten uitlezen op basis van de set van initiële identificatoren:
WITH RECURSIVE tree AS (
  SELECT
    rec -- dit is een volledig record van de tabel
  , id::text chld -- dit is de "set" van aanvoerbladeren
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  ...
Als iemand het vreemd vond dat de "set" als string wordt opgeslagen en niet als array, dan is er een simpele verklaring hiervoor. Voor strings is er een ingebouwde aggregatiefunctie die "samenvoegen" genoemd wordt. string_agg, maar voor arrays is dat er niet. Hoewel het niet moeilijk is om dat zelf te implementeren. .
Stap 2
ze groeperen , terwijl we de informatie over de bronbladeren behouden.Maar hier wachten ons drie problemen:
De 'onder-recurieve' deel van de query kan geen aggregatiefuncties bevatten met
- GROUP BY
Toegang tot de recursieve 'tabel' kan zich niet in een genestelde subquery bevinden.. - De query in het recursieve deel kan geen CTE bevatten.
- Gelukkig zijn deze problemen vrij gemakkelijk te omzeilen. Laten we met het laatste beginnen.
CTE in het recursieve deel
Zo werkt het:
WITH RECURSIVE tree AS ( ... UNION ALL WITH T (...) SELECT ... ) niet En zo — werkt het, haakjes lossen het op!
WITH RECURSIVE tree AS (
  ...
UNION ALL
  (
    WITH T (...)
    SELECT ...
  )
)
Geneste query naar de recursieve 'tabel'
Hmm... Toegang tot de recursieve CTE kan zich niet in een geneste query bevinden. Maar het kan binnen de CTE zijn! En de geneste query kan al toegang krijgen tot deze CTE!GROUP BY binnen de recursie
Ongemakkelijk, maar... We hebben een eenvoudige manier om GROUP BY te simuleren met behulp van
DISTINCT ON
en vensterfuncties! SELECT (rec).pid id , string_agg(chld::text, ',') chld FROM tree WHERE (rec).pid IS NOT NULL GROUP BY 1 -- werkt niet! Maar zo — werkt het!
SELECT DISTINCT ON((rec).pid)
  (rec).pid id
, string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
SELECT DISTINCT ON((rec).pid) (rec).pid id , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld FROM tree WHERE (rec).pid IS NOT NULL
SELECT DISTINCT ON((rec).pid)
  (rec).pid id
, string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
Nu zien we waarom het numerieke ID in tekst werd omgezet — zodat ze met een komma konden worden samengevoegd!
Stap 3
Voor de finale hebben we nog maar een beetje over:
- we controleren de notities van de 'secties' op een reeks gegroepeerde ID's
- we koppelen de gecontroleerde secties aan de 'sets' van de oorspronkelijke lijsten
- we 'ontvouwen' de setregel met behulp van
unnest(string_to_array(chld, ',')::integer[])
WITH RECURSIVE tree AS (
  SELECT
    rec
  , id::text chld
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  (
    WITH prnt AS (
      SELECT DISTINCT ON((rec).pid)
        (rec).pid id
      , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
      FROM
        tree
      WHERE
        (rec).pid IS NOT NULL
    )
    , nodes AS (
      SELECT
        rec
      FROM
        hier rec
      WHERE
        id = ANY(ARRAY(
          SELECT
            id
          FROM
            prnt
        ))
    )
    SELECT
      nodes.rec
    , prnt.chld
    FROM
      prnt
    JOIN
      nodes
        ON (nodes.rec).id = prnt.id
  )
)
SELECT
  unnest(string_to_array(chld, ',')::integer[]) leaf
, (rec).*
FROM
tree; 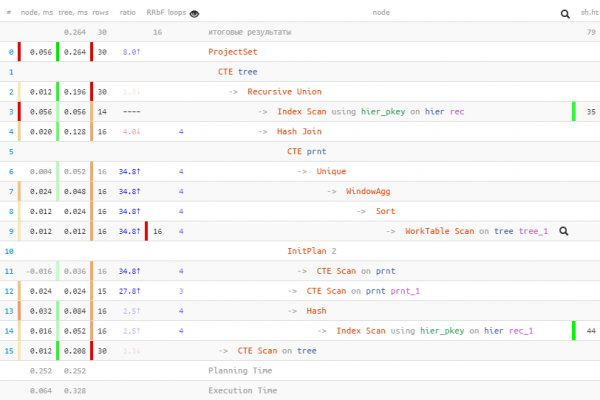
Bron: habr.com
