

Duizenden managers van verkoopkantoren in het hele land registreren in dagelijks tienduizenden contacten — feiten van communicatie met potentiële of al werkende klanten. En voor deze klant moet je eerst vinden, en het liefst heel snel. Dit gebeurt meestal op basis van de naam.
Het is dan ook niet verwonderlijk dat, bij het opnieuw analyseren van 'zware' zoekopdrachten in een van de drukst belaste databases — ons eigen , ik een zoekopdracht ontdekte die 'snel' zoeken op naam voor organisatiekaarten. Bovendien bracht verder onderzoek een interessant voorbeeld aan het licht
van eerst optimalisatie en vervolgens degradatie van de prestaties van de zoekopdracht bij de continue verbetering door verschillende teams, waarbij elk team uitsluitend handelde uit de beste bedoelingen. 0: wat wilde de gebruiker
[KDPV
 Wat bedoelt een gebruiker meestal als hij het heeft over 'snelle' zoekopdracht op naam? Het is bijna nooit een 'eerlijk' zoeken naar een substring zoals ]
... LIKE '%roos%' — want dan komen ook niet alleen 'Rooslia' 'Winkel Roos' en 'Groos'maar ook 'Huis van Opa Moroos' en zelfs De gebruiker veronderstelt op een alledaags niveau dat je ervoor zorgt.
dat het zoeken gebeurt op het begin van het woord in de naam en je toont relevanter alles wat begint met wat is ingevoerd. En je doet dit praktisch onmiddellijk — bij het invoeren van een substring. 1: beperken van de taak
En bovendien zal iemand niet speciaal invoeren
'roos winkel' , zodat elk woord prefixmatig moet worden gezocht. Nee, het is veel eenvoudiger voor de gebruiker om te reageren op de snelle suggestie voor het laatste woord dan om opzettelijk 'niet te eindigen' met de vorige — kijk hoe dit wordt opgepakt door elke zoekmachine.Over het algemeen,
vereisten voor de taak formuleren — is meer dan de helft van de oplossing. Soms kan een grondige analyse van het gebruiksscenario bewaar je waterstofperoxide correct, welke beschermingsmiddelen gebruik je bij het werken en hoe kun je jezelf redden bij vergiftigingen — dat zoeken we verderop. buitenproportioneel invloed hebben op het resultaat. .
1.0: externe zoekmachine
Oh, zoeken is lastig, ik heb er helemaal geen zin in — laten we dit aan devops overdragen! Laat ze voor ons een externe zoekmachine opzetten ten opzichte van de database: Sphinx, ElasticSearch,…
Oh, het zoeken is lastig, daar hebben we helemaal geen zin in — laten we dit aan devops overgeven! Laat hen een externe zoekmachine voor ons opzetten: Sphinx, ElasticSearch,…
Een werkbare, hoewel tijdrovende optie als het gaat om synchronisatie en snelheid van wijzigingen. Maar niet in ons geval, omdat de zoekopdracht voor elke klant alleen binnen zijn accountgegevens plaatsvindt. En deze gegevens hebben een vrij hoge variabiliteit - als de manager nu een kaart toevoegt, 'Rozenwinkel', kan hij zich al binnen 5-10 seconden herinneren dat hij daar de e-mail niet heeft opgegeven en deze wil vinden en aanpassen.
Dus laten we direct in de database zoeken. Gelukkig maakt PostgreSQL dit mogelijk, en niet op één manier - laten we ze bekijken.
1.1: "eerlijk" subteken
Laten we ons vastklampen aan het woord "subteken". Voor het indexeren van subteksten (en zelfs bij reguliere expressies!) is er een uitstekende ! Daarna moeten we het correct sorteren.
Laten we voor de eenvoud van het model zo'n tabel nemen:
CREATE TABLE firms(
  id
    serial
      PRIMARY KEY
, name
    text
);
We laden daar 7,8 miljoen records van echte organisaties in en indexeren:
CREATE EXTENSION pg_trgm;
CREATE INDEX ON firms USING gin(lower(name) gin_trgm_ops);
Laten we de eerste 10 records opzoeken voor subtekstzoekopdrachten:
SELECT
  *
FROM
  firms
WHERE
  lower(name) ~ ('(^|s)' || 'roos')
ORDER BY
  lower(name) ~ ('^' || 'roos') DESC -- eerst "begint met"
, lower(name) -- de rest in alfabetische volgorde
LIMIT 10;
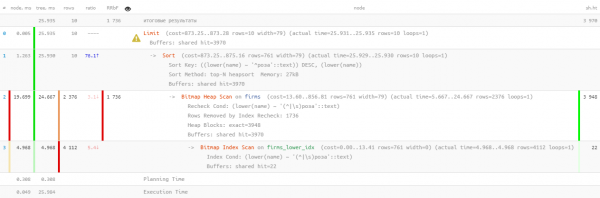
Nou, dat is iets… 26ms, 31MB gelezen data en meer dan 1,7K gefilterde records - voor de 10 gezochte. De overhead is te groot, kunnen we het niet wat efficiënter maken?
1.2: zoekopdracht op tekst? Dat is FTS!
Inderdaad, PostgreSQL biedt een zeer krachtige (Full Text Search), inclusief de mogelijkheid van prefixzoekopdracht. Een uitstekende optie, zonder dat er extensies hoeven te worden geïnstalleerd! Laten we het proberen:
CREATE INDEX ON firms USING gin(to_tsvector('simple'::regconfig, lower(name)));SELECT
*
FROM
firms
WHERE
to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'roos:*')
ORDER BY
lower(name) ~ ('^' || 'roos') DESC
, lower(name)
LIMIT 10; 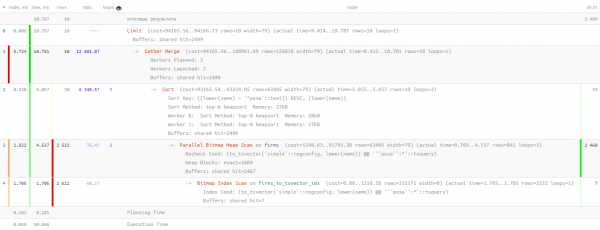
Hier hielp de parallelisatie van de uitvoering van de query ons een beetje, waardoor de tijd gehalveerd werd tot 11ms. En we moesten 1,5 keer minder lezen - slechts 20MB. En hier geldt: hoe minder, hoe beter, want hoe groter het volume dat we lezen, hoe groter de kans op een cache misser, en elke extra pagina data die van de schijf wordt gelezen, is een potentiële "vertraging" voor de query.
1.3: Toch LIKE?
De vorige query is goed, maar als we deze honderdduizend keer per dag draaien, dan stapelt het al snel op tot 2TB gelezen data. In het beste geval vanuit het geheugen, maar als we pech hebben, dan ook vanaf de schijf. Laten we proberen het wat kleiner te maken.
Laten we herinneren dat de gebruiker wil zien eerst "die beginnen met ...". Maar dat is puur met behulp van text_pattern_ops! En alleen als we "niet genoeg" hebben tot 10 gevraagde records, moeten we ze lezen met behulp van FTS-zoekopdracht:
CREATE INDEX ON firms(lower(name) text_pattern_ops);SELECT
*
FROM
firms
WHERE
lower(name) LIKE ('roos' || '%')
LIMIT 10; 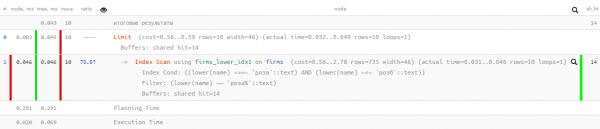
Uitstekende cijfers — slechts 0.05ms en iets meer dan 100KB gezocht! Alleen zijn we vergeten sortering op naam, zodat de gebruiker niet verdwaalt in de resultaten:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('roos' || '%')
ORDER BY
  lower(name)
LIMIT 10; 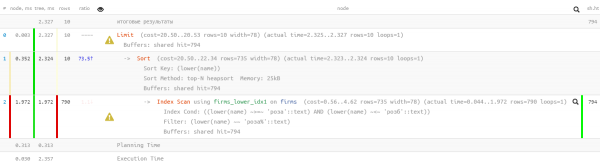
Oh, dat ziet er al niet zo mooi uit — er is blijkbaar een index, maar de sortering negeert hem... Het is uiteraard al veel efficiënter dan de vorige optie, maar...
1.4: "bijschaven met een vijl"
Maar er is een index die het mogelijk maakt om te zoeken binnen een bereik en de sortering normaal te gebruiken — gewone btree!
CREATE INDEX ON firms(lower(name));Alleen moet de query ervoor "handmatig worden samengesteld":
SELECT
  *
FROM
  firms
WHERE
  lower(name) >= 'roos' AND
  lower(name) <= ('roos' || chr(65535)) -- voor UTF8, voor eencijferige - chr(255)
ORDER BY
   lower(name)
LIMIT 10; 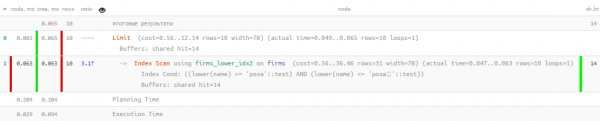
Geweldig — zowel de sortering werkt, als het hulpverbruik is "microscopisch", duizend keer efficiënter dan "puur" FTS! We moeten het in één enkele query samenvoegen:
(
  SELECT
    *
  FROM
    firms
  WHERE
    lower(name) >= 'roos' AND
    lower(name) <= ('roos' || chr(65535)) -- voor UTF8, voor eencijferige coderingen - chr(255)
  ORDER BY
     lower(name)
  LIMIT 10
)
UNION ALL
(
  SELECT
    *
  FROM
    firms
  WHERE
    to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'roos:*') AND
    lower(name) NOT LIKE ('roos' || '%') -- "die beginnen met" hebben we al hierboven gevonden
  ORDER BY
    lower(name) ~ ('^' || 'roos') DESC -- gebruik dezelfde sortering, zodat we NIET over de btree-index gaan
  , lower(name)
  LIMIT 10
)
LIMIT 10;
Ik merk op dat de tweede subquery alleen wordt uitgevoerd als de eerste minder teruggeeft dan verwacht aantal rijen. Over deze optimalisatietechniek voor queries heb ik LIMIT eerdere tijd al geschreven .
minder dan 10% van de queries de uitvoering van het tweede blok bereikt. . Dat wil zeggen, onder zulke bekende typische beperkingen voor de taak, hebben we het totale serververbruik praktisch met duizenden keren weten te verminderen!1.5*: we kunnen zonder vijl toe.
Daarboven
Boven LIKE we were hindered by incorrect sorting. However, it can be 'guided back to the right path' using the USING operator:
By default, it is assumed
ASC. Additionally, it is possible to specify the name of a specific sorting operator in the clauseUSING. The sorting operator must be a member of the 'less than' or 'greater than' some family of B-tree operators.ASCis usually equivalentUSING <enDESCis usually equivalentUSING >.
In our case, 'less than' is ~<~:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('roza' || '%')
ORDER BY
  lower(name) USING ~<~
LIMIT 10; 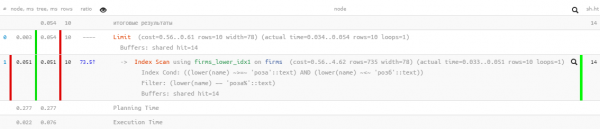
2: how requests 'ferment'
Now let's leave our request to 'brew' for six months to a year, and to our surprise, we find it 'in the top' with indicators of total daily 'boosting' memory (buffers shared hit) in 5.5TB — that is, even more than was originally.
No, of course, both our business has grown, and the load has increased, but not by that much! This means something is off — let's figure it out.
2.1: the birth of paging
At some point, another development team wanted to create the ability to jump from quick inline search to a registry with the same, but extended results. And what kind of registry is there without pagination? Let's implement it!
( ... LIMIT  + 10)
UNION ALL
( ... LIMIT  + 10)
LIMIT 10 OFFSET ;
Now it was possible to display the search result registry with 'type-pagination' loading without stressing the developer.
Of course, in reality, for each subsequent data page, more and more is read (everything from last time that we will discard, plus the required 'tail') — that is, this is an unmistakable anti-pattern. It would be better to start the search on the next iteration from the key saved in the interface, but more on that another time.
2.2: a desire for exoticism
At some point, the developer wanted to diversify the resulting selection with data from another table, for which the entire previous request was sent to CTE:
WITH q AS (
  ...
  LIMIT  + 10
)
SELECT
  *
, (SELECT ...) sub_query -- some query to the related table
FROM
  q
LIMIT 10 OFFSET ;
And even so — not bad, since the nested query is calculated only for the 10 returned records, if it weren't for…
2.3: DISTINCT meaningless and merciless
Somewhere in the process of such evolution, from the 2nd subquery it was lost NOT LIKE condition. It is clear that after that UNION ALL it started to return some records twice — eerst op basis van het begin van de regel en vervolgens opnieuw — op basis van het begin van het eerste woord van deze regel. In de limit kunnen alle records van de 2e subquery samenvallen met de records van de eerste.
Wat doet de ontwikkelaar in plaats van de oorzaak te zoeken?.. Geen vragen!
- laten we de grootte verdubbelen van de oorspronkelijke steekproeven
- toepassen DISTINCT, zodat er alleen unieke exemplaren van elke regel overblijven
WITH q AS (
  ( ... LIMIT  + 10)
  UNION ALL
  ( ... LIMIT  + 10)
  LIMIT  + 10
)
SELECT DISTINCT
  *
, (SELECT ...) sub_query
FROM
  q
LIMIT 10 OFFSET ;
Dus het is duidelijk dat het resultaat uiteindelijk precies hetzelfde is, maar de kans om 'door de mand te vallen' in de 2e subquery CTE is aanzienlijk verhoogd, en dat zonder dit, er duidelijk meer leesbaarheid is.
Maar dat is niet het grootste probleem. Omdat de ontwikkelaar vroeg om te selecteren UNIEK niet op specifieke, maar meteen op alle velden records, waardoor ook het veld sub_query — het resultaat van de subquery — automatisch werd opgenomen. Nu moest de UNIEKdatabase al niet 10 subqueries, maar alle + 10 uitvoeren!
2.4: samenwerking boven alles!
Zo leefden de ontwikkelaars — zonder zorgen, omdat het duidelijk niet voldoende geduld had om in het register 'door te schroeven' tot significante waarden van N bij de chronische vertraging in het verkrijgen van elke volgende 'pagina' voor de gebruiker.
Totdat ontwikkelaars uit een andere afdeling kwamen en wilden profiteren van zo'n handige methode voor iteratief zoeken — dat wil zeggen, we nemen een stukje uit een bepaalde steekproef, filteren op aanvullende voorwaarden, tonen het resultaat, en dan het volgende stukje (wat in ons geval wordt bereikt door N te verhogen), en zo voort totdat we het scherm vullen.
In het algemeen bereikte N bijna 17K, en in totaal werden er binnen 24 uur 'chain' niet minder dan 4K van zulke verzoeken uitgevoerd. De laatste werden al vrijmoedig gescand op 1GB geheugen bij elke iteratie…
Total
Bron: habr.com
