

De interne mechanismen van PostgreSQL zorgen ervoor dat het in sommige situaties erg snel is en in andere situaties 'niet zozeer'. Laten we vandaag stilstaan bij een klassiek voorbeeld van het conflict tussen hoe de database werkt en wat de ontwikkelaar ermee doet — UPDATE versus MVCC-principes.
Kortom, het verhaal van :
Wanneer een rij wordt gewijzigd door het UPDATE-commando, worden er in feite twee bewerkingen uitgevoerd: DELETE en INSERT. In de huidige versie van de rij wordt xmax ingesteld, gelijk aan het transactionnummer dat de UPDATE heeft uitgevoerd. Vervolgens wordt er een nieuwe versie zelfde rij aangemaakt; de waarde van xmin komt overeen met de waarde van xmax van de vorige versie.
Na een tijdje, na het voltooien van deze transactie, worden de oude of nieuwe versies, afhankelijk van de COMMIT/ROLLBACK, als ‘dode rijen’ (dead tuples) beschouwd tijdens het doorlopen VACUUM van de tabel en gewist.
Maar dit gebeurt beslist niet meteen, terwijl je snel problemen kunt krijgen met ‘doden’ — bij meervoudige of in een grote tabel, om later te ontdekken dat zelfs .
#1: I Like To Move It
Stel je voor dat je methode voor de bedrijfslogica prima werkt, en je ineens beseft dat je veld X in een bepaald record moet bijwerken:
UPDATE tbl SET X = WHERE pk = $1;Dan, tijdens de uitvoering, ontdek je dat je ook veld Y moet bijwerken:
UPDATE tbl SET Y = WHERE pk = $1;… en misschien ook Z — waarom niet?
UPDATE tbl SET Z = WHERE pk = $1;Hoeveel versies van dit record hebben we nu in de database? Juist, 4 stuks! Van deze is er één actueel, en de overige 3 moet je opruimen met [auto]VACUUM.
Doe dat niet! Gebruik een update van alle velden in één verzoek — bijna altijd kun je de logica van de methode zo aanpassen:
UPDATE tbl SET X = , Y = , Z = WHERE pk = $1;#2: Use IS DISTINCT FROM, Luke!
Nou, je wilt toch echt (bijvoorbeeld tijdens het uitvoeren van een script of converter). En het script bevat iets als:
UPDATE tbl SET X = WHERE pk BETWEEN $1 AND $2;In deze vorm komt het verzoek vrij vaak voor en bijna altijd niet om een nieuw leeg veld in te vullen, maar om een aantal fouten in de gegevens te corrigeren. Daarbij wordt de correctheid van de al bestaande gegevens helemaal niet in aanmerking genomen — en dat is zonde! Dit betekent dat het record wordt herschreven, zelfs als daar precies staat wat je wilde — waarom? Laten we het aanpassen:
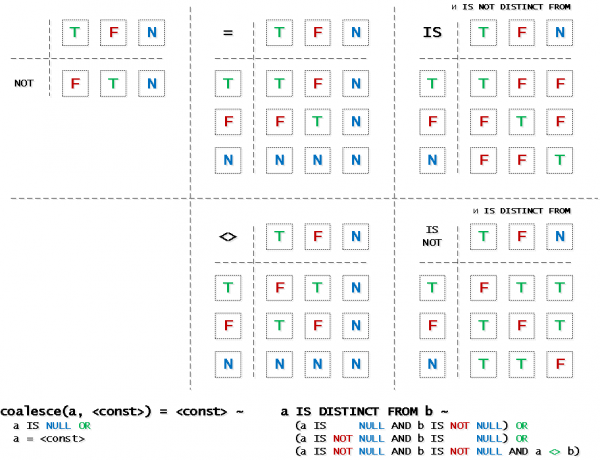
UPDATE tbl SET X = WHERE pk BETWEEN $1 AND $2 AND X IS DISTINCT FROM ; Veel mensen zijn zich niet bewust van het bestaan van deze geweldige operator, daarom hier een spiekbriefje over IS DISTINCT FROM en andere logische operators ter ondersteuning:
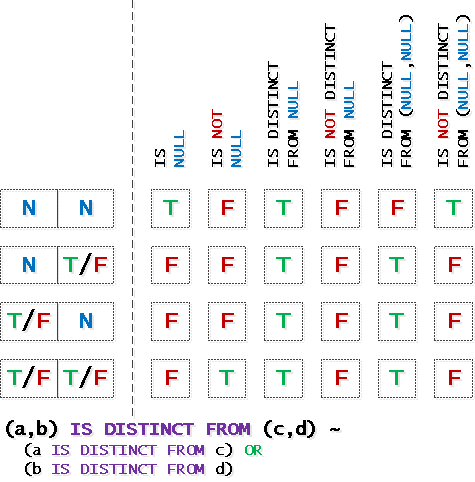
… en een beetje over operaties met complexe ROW()-uitdrukkingen:
#3: А я милого узнаю по… блокировке
Worden gestart twee identieke parallelle processen, waarbij elk probeert aan te geven dat de opname "in behandeling" is:
UPDATE tbl SET processing = TRUE WHERE pk = $1;Zelfs als deze processen feitelijk onafhankelijk van elkaar dingen doen, maar binnen hetzelfde ID, vergrendelt de tweede client deze aanvraag totdat de eerste transactie is voltooid.
Oplossing #1: de taak is gereduceerd tot de eerder genoemde
Laten we eenvoudigweg toevoegen IS DISTINCT FROM:
UPDATE tbl SET processing = TRUE WHERE pk = $1 AND processing IS DISTINCT FROM TRUE;In deze vorm zal de tweede aanvraag eenvoudigweg niets in de database wijzigen, daar is "alles al goed" — daarom ontstaat er ook geen vergrendeling. Vervolgens behandelen we het feit dat de opname "niet gevonden" is in het toepassingsalgoritme.
Oplossing #2: advisory locks
Een groot onderwerp voor een apart artikel waarin je kunt lezen over .
Oplossing #3: ondoordachte aanroepen
Het is absoluut noodzakelijk dat er gelijktijdig gewerkt wordt met dezelfde opname? Или вы все-таки накосячили с алгоритмами вызовов бизнес-логики со стороны клиента, например? А если подумать?..
Bron: habr.com
