

Wees voorzichtig met bewerkingen, buffers die…
Laten we aan de hand van een kleine query enkele universele benaderingen voor query-optimalisatie in PostgreSQL bekijken. Of je ze moet gebruiken of niet - dat is aan jou, maar het is goed om ervan op de hoogte te zijn.
In sommige latere versies van PG kan de situatie veranderen met de 'slimmer' planner, maar voor 9.4/9.6 ziet het er ongeveer hetzelfde uit als hier de voorbeelden.
Ik neem een volkomen reële query:
SELECT
  TRUE
FROM
  "Document" d
INNER JOIN
  "DocumentUitbreiding" doc_ex
    USING("@Document")
INNER JOIN
  "DocumentType" t_doc ON
    t_doc."@DocumentType" = d."DocumentType"
WHERE
  (d."Lichaam3" = 19091 or d."Medewerker" = 19091) AND
  d."$Concept" IS NULL AND
  d."Verwijderd" IS NOT TRUE AND
  doc_ex."Status"[1] IS TRUE AND
  t_doc."DocumentType" = 'WerkPlan'
LIMIT 1;
over tabel- en veldnamenMen kan op verschillende manieren naar "Russische" namen van velden en tabellen kijken, maar dat is een kwestie van smaak. Aangezien geen buitenlandse ontwikkelaars hebben, en PostgreSQL ons toestaat om namen zelfs in hiërogliefen te geven, als ze tussen aanhalingstekensstaan, geven we de voorkeur aan eenduidige namen voor objecten zodat er geen misverstanden ontstaan.
Laten we het ontvangen plan bekijken:
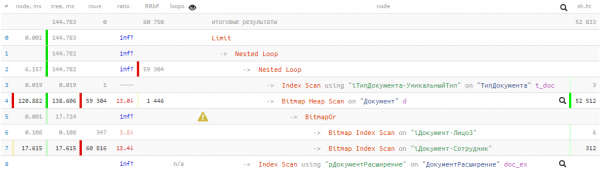
144 ms en bijna 53K buffers - dat is meer dan 400 MB aan gegevens! En we hebben geluk als al deze gegevens in de cache aanwezig zijn op het moment van onze query, anders wordt het veel langer zodra het van de schijf moet worden gelezen.
Het algoritme is het belangrijkste!
Om een query te optimaliseren, moet je eerst begrijpen wat het eigenlijk moet doen.
Laten we de ontwikkeling van de database-structuur voor deze artikel voorlopig buiten beschouwing laten, en laten we afspreken dat we relatief 'goedkoop' de query herschrijven en/of de database bepaalde noodzakelijke indexen.
Dus, de query:
- controleert of er een document bestaat
- in de gewenste status en van het bepaalde type
- waar de auteur of uitvoerder de benodigde medewerker is
JOIN + LIMIT 1
Vaak is het voor de ontwikkelaar gemakkelijker om een query te schrijven waarin eerst een grote hoeveelheid tabellen wordt samengevoegd, en vervolgens een unieke record uit deze massa wordt gehaald. Maar gemakkelijker voor de ontwikkelaar betekent niet effectiever voor de database.
In ons geval waren er slechts 3 tabellen - en wat een effect…
Laten we in eerste instantie de join met de tabel 'DocumentType' verwijderen, en daarnaast de database laten weten dat de type record uniek is (dat weten wij, maar de planner vermoedt het nog niet):
WITH T AS (
  SELECT
    "@DocumentType"
  FROM
    "DocumentType"
  WHERE
    "DocumentType" = 'WerkPlan'
  LIMIT 1
)
...
WHERE
  d."DocumentType" = (TABLE T)
...
Ja, als de tabel/CTE uit één veld van één record bestaat, kan je in PG zelfs zo schrijven, in plaats van
d."DocumentType" = (SELECT "@DocumentType" FROM T LIMIT 1)‘Lui’ berekeningen in PostgreSQL-queries
BitmapOr vs UNION
In sommige gevallen kan een Bitmap Heap Scan ons veel kosten — bijvoorbeeld in onze situatie, waar er een behoorlijk aantal records zijn die aan de vereiste voorwaarde voldoen. We hebben het gekregen door een OR-voorwaarde die is omgevormd tot BitmapOr-operatie in het plan.
Laten we terugkeren naar de oorspronkelijke taak — we moeten een record vinden die overeenkomt met elke van de voorwaarden — dat betekent dat het niet nodig is om alle 59K records op beide voorwaarden te doorzoeken. Er is een manier om één voorwaarde te verwerken, en pas naar de tweede over te schakelen als er niets is gevonden op de eerste. We kunnen hiervoor de volgende constructie gebruiken:
(
  SELECT
    ...
  LIMIT 1
)
UNION ALL
(
  SELECT
    ...
  LIMIT 1
)
LIMIT 1
De "externe" LIMIT 1 garandeert dat de zoektocht eindigt zodra de eerste record wordt gevonden. En als deze al in het eerste blok gevonden wordt, zal de uitvoering van het tweede niet plaatsvinden (nooit uitgevoerd in het plan).
We 'verbergen onder CASE' complexe voorwaarden
In de oorspronkelijke query is er een uiterst ongemakkelijke situatie — het controleren van de status via de gerelateerde tabel "DocumentExtensie". Ongeacht de waarheidsgetrouwe status van de andere voorwaarden in de uitdrukking (bijvoorbeeld, d."Verwijderd" IS NOT TRUE), wordt deze verbinding altijd uitgevoerd en 'kost middelen'. Of meer of minder middelen worden verbruikt, hangt af van het volume van deze tabel.
Maar we kunnen de query zo aanpassen dat het zoeken naar een gerelateerd record alleen gebeurt wanneer het echt nodig is:
SELECT
  ...
FROM
  "Document" d
WHERE
  ...
/*index cond*/ EN
  CASE
    WHEN "$Concept" IS NULL EN "Verwijderd" IS NOT TRUE DAN (
      SELECT
        "Status"[1] IS TRUE
      VAN
        "DocumentExtensie"
      WAAR
        "@Document" = d."@Document"
    )
  EIND
Aangezien we uit de gekoppelde tabel geen van de velden nodig hebben voor het resultaat, hebben we de mogelijkheid om de JOIN in een subqueryvoorwaarde om te zetten.
We laten de indexeerbare velden 'buiten de haken' van CASE, simpelere voorwaarden van de record voegen we in de WHEN-blok in — en nu wordt de 'zware' query alleen uitgevoerd wanneer we naar THEN gaan.
Mijn achternaam is 'Totaal'
We verzamelen de resulterende query met alle bovengenoemde mechanismen:
MET T ALS (
  SELECT
    "@DocumentType"
  FROM
    "DocumentType"
  WHERE
    "DocumentType" = 'WorkPlan'
)
  (
    SELECT
      TRUE
    FROM
      "Document" d
    WHERE
      ("Person3", "DocumentType") = (19091, (TABLE T)) AND
      CASE
        WHEN "$Draft" IS NULL AND "Deleted" IS NOT TRUE THEN (
          SELECT
            "Status"[1] IS TRUE
          FROM
            "DocumentExtension"
          WHERE
            "@Document" = d."@Document"
        )
      END
    LIMIT 1
  )
UNION ALL
  (
    SELECT
      TRUE
    FROM
      "Document" d
    WHERE
      ("DocumentType", "Employee") = ((TABLE T), 19091) AND
      CASE
        WHEN "$Draft" IS NULL AND "Deleted" IS NOT TRUE THEN (
          SELECT
            "Status"[1] IS TRUE
          FROM
            "DocumentExtension"
          WHERE
            "@Document" = d."@Document"
        )
      END
    LIMIT 1
  )
LIMIT 1;
Aangepast [aan] indexen
Een geoefend oog heeft gezien dat de geïndexeerde voorwaarden in de UNION-subblokken een beetje verschillen - dit komt omdat we al geschikte indexen op de tabel hebben. Als die er niet waren, zou het de moeite waard zijn om ze aan te maken: Document(Person3, DocumentType) en Document(DocumentType, Employee).
over de volgorde van de velden in ROW-voorwaardenVanuit het perspectief van de planner kan het natuurlijk ook geschreven worden als (A, B) = (constA, constB), en (B, A) = (constB, constA). Maar bij het opschrijven in de volgorde van de velden in de index, is zo'n verzoek gewoon handiger om later te debuggen.
Wat staat er op het programma?
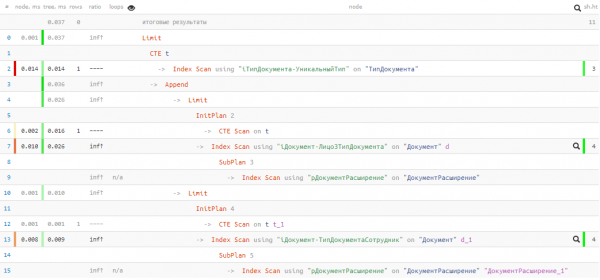
Helaas hadden we geen geluk en vond het eerste UNION-blok niets, dus moest het tweede alsnog worden uitgevoerd. Maar zelfs dan - slechts 0.037ms en 11 buffers!
We hebben de aanvraag versneld en de "doorvoer" van gegevens in het geheugen meerdere duizenden keren, door gebruik te maken van vrij eenvoudige technieken - een uitstekend resultaat bij een kleine copy-paste. 🙂
Bron: habr.com
