

De vertaling van het artikel is speciaal voorbereid voor studenten van de cursus .
In de afgelopen weken hebben we toegevoegd aan een binaire streaming-indeling, waarmee we het bestaande random access/IPC-bestandsformaat hebben uitgebreid. We hebben implementaties in Java en C++ en bindings voor Python. In dit artikel leg ik uit hoe het formaat werkt en laat ik zien hoe je een zeer hoge gegevensdoorvoer kunt bereiken voor een pandas DataFrame.
Streamen van kolomgegevens
Een veelgestelde vraag die ik van Arrow-gebruikers krijg, is hoe duur het is om grote tabulaire datasets van rij- of recordgeoriënteerde formaten naar een kolomindeling te verplaatsen. Voor datasets van meerdere gigabytes kan het transponeren in het geheugen of op schijf een onoverkomelijke taak blijken te zijn.
Voor data streaming, ongeacht of de brondatabron rij- of kolomgeoriënteerd is, is een van de opties het verzenden van kleine pakketten rijen, waarbij elk pakket intern een kolomindeling bevat.
In Apache Arrow wordt een verzameling kolomarrays in het geheugen, die een tabelchunk vertegenwoordigt, een record batch genoemd. Om een uniforme gegevensstructuur voor een logische tabel te creëren, kunnen meerdere record batches worden samengevoegd.
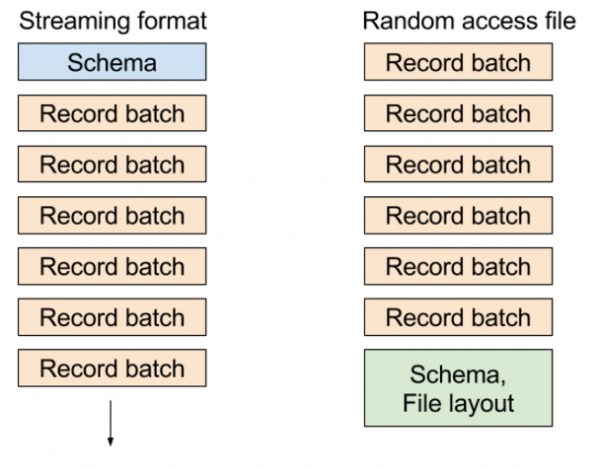
In het bestaande random access-bestandsformaat schrijven we metadata, waaronder het schema van de tabel en de locatie van de blokken aan het einde van het bestand, waardoor je zeer goedkoop elke record batch of elke kolom uit de dataset kunt selecteren. In het streamingformaat versturen we een reeks berichten: eerst het schema en daarna een of meerdere record batches.
Verschillende formaten zien er ongeveer zo uit als weergegeven in deze afbeelding:
Data streaming in PyArrow: toepassing
Om je te laten zien hoe dit werkt, zal ik een voorbeelddataset maken die één streaming chunk vertegenwoordigt:
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = int(total_size / ncols / np.dtype('float64').itemsize)
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })
Stel nu dat we 1 GB aan gegevens willen schrijven, bestaande uit chunks van elk 1 MB, in totaal 1024 chunks. Laten we beginnen met het maken van de eerste DataFrame van 1 MB met 16 kolommen:
KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

df = generate_data(MEGABYTE, NCOLS)
Daarna converteer ik ze naar pyarrow.RecordBatch:
batch = pa.RecordBatch.from_pandas(df) Nu ga ik een uitvoerstroom maken die naar het werkgeheugen schrijft en creëren StreamWriter:
sink = pa.InMemoryOutputStream()
stream_writer = pa.StreamWriter(sink, batch.schema)
Vervolgens zullen we 1024 chunks schrijven, die samen 1 GB aan gegevens zullen vormen:
for i in range(DATA_SIZE // MEGABYTE):
    stream_writer.write_batch(batch)
Omdat we naar het RAM schreven, kunnen we de hele stroom in één buffer verkrijgen:
In [13]: source = sink.get_result()

In [14]: source
Out[14]:

In [15]: source.size
Out[15]: 1074750744
Omdat deze gegevens in het geheugen staan, is het lezen van Arrow-gegevenspakketten een zero-copy operatie. Ik open de StreamReader en lees de gegevens in pyarrow.Table, en converteer ze vervolgens naar DataFrame pandas:
In [16]: reader = pa.StreamReader(source)

In [17]: table = reader.read_all()

In [18]: table
Out[18]:

In [19]: df = table.to_pandas()

In [20]: df.memory_usage().sum()
Out[20]: 1073741904
Dit is natuurlijk allemaal goed, maar u heeft misschien vragen. Hoe snel gebeurt dit? Hoe beïnvloedt de grootte van de chunk de prestaties van het verkrijgen van de DataFrame pandas?
Prestaties van datastreaming
Naarmate de grootte van de chunk afneemt, stijgt de kostprijs van het reconstrueren van een continue kolomstructuur van de DataFrame in pandas door inefficiënte geheugentoegangsmodellen. Er zijn ook enkele overheadkosten verbonden aan het werken met C++ datastructuren en arrays en hun geheugenbuffers.
Voor 1 MB, zoals hierboven vermeld, komt het op mijn laptop (Quad-core Xeon E3-1505M) tot:
In [20]: %timeit pa.StreamReader(source).read_all().to_pandas()
10 loops, best of 3: 129 ms per loop
Dit resulteert in een effectieve doorvoersnelheid van 7,75 GB/s voor het herstellen van een DataFrame van 1 GB uit 1024 chunks van 1 MB. Wat gebeurt er als we chunks van grotere of kleinere grootte gebruiken? Dit zijn de resultaten:
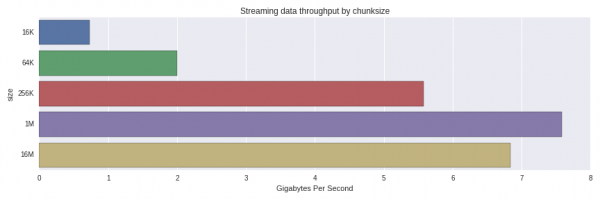
De prestaties dalen aanzienlijk van 256K naar 64K chunks. Ik was verrast dat chunks van 1 MB sneller werden verwerkt dan die van 16 MB. Het is de moeite waard om een grondiger onderzoek te doen en te begrijpen of dit een normaal verdelingspatroon is of dat er andere factoren meespelen.
In de huidige implementatie van het formaat worden de gegevens in feite niet gecomprimeerd, waardoor de grootte in het geheugen en "in de draden" ongeveer hetzelfde is. In de toekomst kan compressie een extra optie worden.
Conclusie
Streaming van kolomgegevens kan een efficiënte manier zijn om grote datasets naar kolomanalytische tools, zoals pandas, te verzenden met behulp van kleine chunks. Gegevensservices die gebruik maken van een op rijen gericht opslagysteem kunnen kleine chunks van gegevens verzenden en transponeren die beter passen bij de L2- en L3-cache van uw processor.
Volledige code
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = total_size / ncols / np.dtype('float64').itemsize
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })

KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

def get_timing(f, niter):
    start = time.clock_gettime(time.CLOCK_REALTIME)
    for i in range(niter):
        f()
    return (time.clock_gettime(time.CLOCK_REALTIME) - start) / NITER

def read_as_dataframe(klass, source):
    reader = klass(source)
    table = reader.read_all()
    return table.to_pandas()
NITER = 5
results = []

CHUNKSIZES = [16 * KILOBYTE, 64 * KILOBYTE, 256 * KILOBYTE, MEGABYTE, 16 * MEGABYTE]

for chunksize in CHUNKSIZES:
    nchunks = DATA_SIZE // chunksize
    batch = pa.RecordBatch.from_pandas(generate_data(chunksize, NCOLS))

    sink = pa.InMemoryOutputStream()
    stream_writer = pa.StreamWriter(sink, batch.schema)

    for i in range(nchunks):
        stream_writer.write_batch(batch)

    source = sink.get_result()

    elapsed = get_timing(lambda: read_as_dataframe(pa.StreamReader, source), NITER)

    result = (chunksize, elapsed)
    print(result)
    results.append(result)
Bron: habr.com
