

Hallo, Habr.
Onlangs heb ik over welke parameters we in het team het vaakst gebruiken voor Kafka Producer en Consumer, om de gegarandeerde levering te benaderen. In dit artikel wil ik vertellen hoe we de herverwerking van een gebeurtenis, ontvangen uit Kafka, hebben georganiseerd als gevolg van de tijdelijke onbeschikbaarheid van een extern systeem.
Moderne applicaties werken in een zeer complexe omgeving. De bedrijfslogica, omgeven door een moderne technologiestack, draait in een Docker-image dat wordt beheerd door een orchestrator zoals Kubernetes of OpenShift, en communiceert met andere applicaties of enterprise-oplossingen via een keten van fysieke en virtuele routers. In zo'n omgeving kan er altijd iets misgaan, daarom is de herverwerking van gebeurtenissen in geval van onbeschikbaarheid van een van de externe systemen een belangrijk deel van onze bedrijfsprocessen.
Hoe het was vóór Kafka
Vroeger gebruikten we IBM MQ voor asynchrone berichtlevering. Wanneer er een fout optrad in het werkproces van de service, kon het ontvangen bericht in een dead-letter-queue (DLQ) worden geplaatst voor verdere handmatige analyse. De DLQ werd naast de binnenkomende wachtrij aangemaakt, en het verplaatsen van berichten gebeurde binnen IBM MQ.
Als de fout tijdelijk van aard was en we dat konden vaststellen (bijvoorbeeld ResourceAccessException bij een HTTP-aanroep of MongoTimeoutException bij een verzoek aan MongoDb), dan ging de strategie voor herhaaloproepen in werking. Ongeacht de tak van de applicatielogica, werd het oorspronkelijke bericht verplaatst of naar een systeempijplijn voor later verzenden, of naar een aparte applicatie die lang geleden was gemaakt voor het opnieuw sturen van berichten. Hierbij wordt er een nummer van de herhaaling naar de header van het bericht geschreven, dat is gekoppeld aan het vertragingstijdvak of het einde van de strategie op applicatieniveau. Als we het einde van de strategie hebben bereikt, maar het externe systeem nog steeds niet beschikbaar is, zal het bericht in de DLQ worden geplaatst voor handmatige analyse.
Zoek naar een oplossing
, kun je het volgende vinden . Kort samengevat, het voorstel is om voor elk tijdsinterval een topiek te maken en op de kant van de applicatie Consumers te implementeren die berichten met de vereiste vertraging zullen lezen.
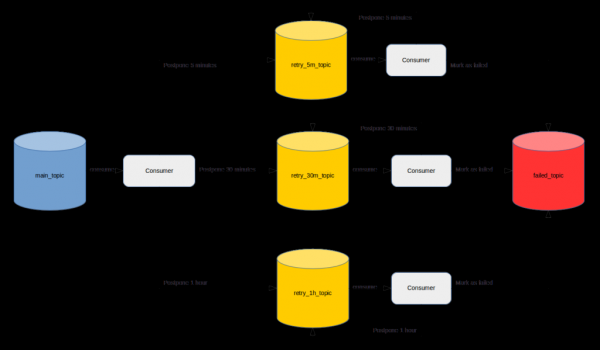
Ondanks het grote aantal positieve beoordelingen lijkt het me niet helemaal geslaagd. Dit komt vooral omdat de ontwikkelaar, naast de implementatie van zakelijke vereisten, veel tijd zal moeten besteden aan het realiseren van het beschreven mechanisme.
Bovendien, als er toegangbeheer op de Kafka-cluster is ingeschakeld, zal er enige tijd nodig zijn om onderwerpen aan te maken en de benodigde toegang tot hen te waarborgen. Daarnaast zal het nodig zijn om de juiste parameter retention.ms voor elk van de retry-onderwerpen te selecteren, zodat berichten tijdig opnieuw kunnen worden verzonden en niet verloren gaan. De implementatie en aanvraag van toegang zal voor elke bestaande of nieuwe service herhaald moeten worden.
Laten we nu eens kijken naar de mechanismen voor de herverwerking van berichten die Spring in het algemeen en Spring-Kafka in het bijzonder biedt. Spring-Kafka heeft een transitieve afhankelijkheid van Spring-Retry, dat abstracties biedt voor het beheren van verschillende BackOffPolicies. Dit is een behoorlijk flexibele tool, maar een aanzienlijk nadeel is dat berichten voor herverzending in het geheugen van de applicatie worden opgeslagen. Dit betekent dat het opnieuw opstarten van de applicatie vanwege een update of een fout tijdens de exploitatie zal leiden tot het verlies van alle berichten die wachten op herverwerking. Aangezien dit punt kritisch is voor ons systeem, hebben we besloten dit verder niet te overwegen.
Spring-Kafka zelf biedt verschillende implementaties van ContainerAwareErrorHandler, bijvoorbeeld , waarmee je een bericht later kunt verwerken zonder de offset te verschuiven in het geval van een fout. Sinds versie 2.3 van Spring-Kafka is het mogelijk om een BackOffPolicy in te stellen.
Deze aanpak stelt herverwerkte berichten in staat om een herstart van de applicatie te doorstaan, maar de DLQ-mechanisme ontbreekt nog steeds. Dit was de optie die we begin 2019 hebben gekozen, optimistisch veronderstellend dat we geen DLQ nodig zouden hebben (we hadden geluk, en dat was inderdaad niet nodig tijdens enkele maanden van de exploitatie van de applicatie met dit herverwerkingsysteem). Tijdelijke fouten leidden tot het activeren van de SeekToCurrentErrorHandler. Andere fouten werden naar de log geschreven, wat leidde tot een verschuiving van de offset, en de verwerking ging verder met het volgende bericht.
Eindoplossing
De implementatie, gebaseerd op SeekToCurrentErrorHandler, heeft ons aangezet tot de ontwikkeling van een eigen mechanisme voor het opnieuw verzenden van berichten.
In de eerste plaats wilden we onze bestaande ervaring benutten en deze uitbreiden afhankelijk van de logica van de applicatie. Voor een applicatie met lineaire logica zou het optimaal zijn om het lezen van nieuwe berichten gedurende een korte periode, vastgesteld in de strategie voor herhalingen, stop te zetten. Voor andere applicaties wilden we één enkele plek creëren die de uitvoering van de strategie voor herhalingen zou waarborgen. Bovendien zou deze enkele plek functionaliteit voor DLQ moeten hebben voor beide benaderingen.
De strategie voor herhalingen zelf moet worden opgeslagen in de applicatie die verantwoordelijk is voor het verkrijgen van het volgende interval bij het optreden van een tijdelijke fout.
Het stoppen van de Consumer voor een applicatie met lineaire logica.
Bij het gebruik van spring-kafka kan de code voor het stoppen van de Consumer er ongeveer zo uitzien:
public void pauseListenerContainer(MessageListenerContainer listenerContainer,
                                   Instant retryAt) {
        if (nonNull(retryAt) && listenerContainer.isRunning()) {
            listenerContainer.stop();
            taskScheduler.schedule(() -> listenerContainer.start(), retryAt);
            return;
        }
        // naar DLQ
    }
In het voorbeeld is retryAt het tijdstip waarop MessageListenerContainer opnieuw moet worden gestart, als deze nog steeds draait. De herstart vindt plaats in een aparte thread, die wordt uitgevoerd in TaskScheduler, waarvan de implementatie ook door spring wordt geleverd.
De waarde voor retryAt vinden we op de volgende manier:
- Zoeken naar de waarde van de herhalingscounter.
- Volgens de waarde van de counter zoeken we het huidige vertraging interval in de strategie voor herhalingen. De strategie wordt in de applicatie zelf gedeclareerd, voor de opslag hebben we het JSON-formaat gekozen.
- Het gevonden interval in de JSON-array bevat het aantal seconden waarbinnen de verwerking moet worden herhaald. Dit aantal seconden wordt bij de huidige tijd opgeteld, wat een waarde voor retryAt oplevert.
- Als het interval niet gevonden wordt, is de waarde voor retryAt null en wordt het bericht naar DLQ gestuurd voor handmatige analyse.
Met deze aanpak blijft er alleen over om het aantal herhaalkosten voor elk bericht dat momenteel in behandeling is, bijvoorbeeld in het geheugen van de applicatie, op te slaan. Het opslaan van de pogingteller in het geheugen is niet cruciaal voor deze aanpak, aangezien een applicatie met lineaire logica de verwerking als geheel niet kan uitvoeren. In tegenstelling tot spring-retry leidt het herstarten van de applicatie niet tot het verlies van alle berichten voor herverwerking, maar gewoon tot het opnieuw starten van de strategie.
Deze aanpak helpt de belasting van een extern systeem te verlichten, dat mogelijk niet beschikbaar is vanwege een zeer hoge belasting. Met andere woorden, naast herverwerking hebben we de implementatie van het patroon bereikt. .
In ons geval is de foutdrempel slechts 1, en om de stilstand van het systeem door tijdelijke netwerkonderbrekingen te minimaliseren, gebruiken we een zeer granulaire strategie voor herhaalkosten met kleine vertragingstijden. Dit is mogelijk niet geschikt voor alle applicaties binnen de groep, daarom moet de verhouding tussen de foutdrempel en de grootte van de interval worden gekozen op basis van de kenmerken van het systeem.
Een aparte applicatie voor het verwerken van berichten van applicaties met onbepaalde logica.
Hier is een voorbeeld van code die een bericht naar een dergelijke applicatie (Retryer) stuurt, die het opnieuw zal verzenden naar het topic DESTINATION wanneer de tijd RETRY_AT is bereikt:
public  void retry(ConsumerRecord record, String retryToTopic,
                         Instant retryAt, String counter, String groupId, Exception e) {
        Headers headers = ofNullable(record.headers()).orElse(new RecordHeaders());
        List arrayOfHeaders =
            new ArrayList(Arrays.asList(headers.toArray()));
        updateHeader(arrayOfHeaders, GROUP_ID, groupId::getBytes);
        updateHeader(arrayOfHeaders, DESTINATION, retryToTopic::getBytes);
        updateHeader(arrayOfHeaders, ORIGINAL_PARTITION,
                     () -> Integer.toString(record.partition()).getBytes());
        if (nonNull(retryAt)) {
            updateHeader(arrayOfHeaders, COUNTER, counter::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "retry"::getBytes);
            updateHeader(arrayOfHeaders, RETRY_AT, retryAt.toString()::getBytes);
        } else {
            updateHeader(arrayOfHeaders, REASON,
                         ExceptionUtils.getStackTrace(e)::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "backout"::getBytes);
        }
        ProducerRecord messageToSend =
            new ProducerRecord(retryTopic, null, null, record.key(), record.value(), arrayOfHeaders);
        kafkaTemplate.send(messageToSend);
    }
In het voorbeeld is te zien dat er veel informatie wordt verzonden in de headers. De waarde RETRY_AT bevindt zich net als bij het herhalingsmechanisme via het stoppen van de Consumer. Naast DESTINATION en RETRY_AT sturen we ook:
- GROUP_ID, waarmee we berichten groeperen voor handmatige analyse en het vereenvoudigen van de zoekopdracht.
- ORIGINAL_PARTITION, om te proberen dezelfde Consumer te behouden voor herverwerking. Deze parameter kan gelijk zijn aan null, in welk geval een nieuwe partition wordt verkregen op basis van de sleutel record.key() van het originele bericht.
- De vernieuwde waarde COUNTER, om de strategie voor herhaalde oproepen te volgen.
- SEND_TO — een constante die aangeeft of een bericht voor herverwerking moet worden verzonden wanneer RETRY_AT is bereikt, of in de DLQ moet worden geplaatst.
- REASON — de reden waarom de verwerking van het bericht is stopgezet.
De Retryer slaat berichten op voor herverzending en handmatige analyse in PostgreSQL. Op basis van een timer wordt een taak gestart die berichten met een verstreken RETRY_AT vindt en ze terugstuurt naar de partition ORIGINAL_PARTITION van het DESTINATION topic met de sleutel record.key().
Na verzending worden de berichten uit PostgreSQL verwijderd. Handmatige analyse van berichten gebeurt via een eenvoudige UI die communiceert met de Retryer via REST API. De belangrijkste functies zijn het opnieuw verzenden of verwijderen van berichten uit de DLQ, het bekijken van foutinformatie en het zoeken naar berichten, bijvoorbeeld op naam van de fout.
Aangezien toegang tot onze clusters is ingeschakeld, is het noodzakelijk om extra toegang tot het topic te verzoeken dat de Retryer beluistert, en de Retryer de mogelijkheid te geven om naar het DESTINATION topic te schrijven. Dit is onhandig, maar in tegenstelling tot de aanpak met een topic op interval, hebben we een volledige DLQ en een UI om deze te beheren.
Er zijn gevallen waarin het inkomende topic door verschillende consumer-groepen wordt gelezen, waarvan de applicaties verschillende logica implementeren. Herverwerking van berichten via de Retryer voor een van deze applicaties zal een duplicaat bij de andere veroorzaken. Om dit te voorkomen, creëren we een apart topic voor herverwerking. Het inkomende en retry-topic kan door dezelfde Consumer worden gelezen zonder enige beperkingen.
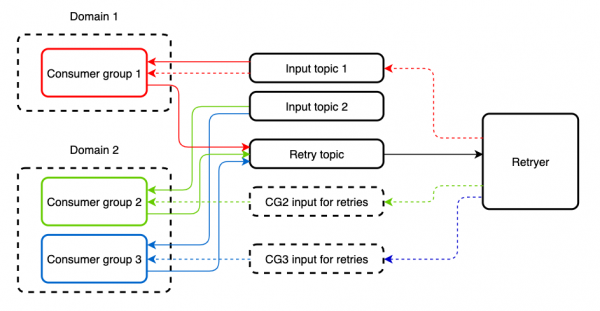
Standaard biedt deze aanpak geen mogelijkheden voor een circuit breaker, maar dit kan worden toegevoegd aan de applicatie met behulp van of de nieuwe , door de plaatsen van aanroepen van externe diensten in de bijbehorende abstracties te wikkelen. Bovendien ontstaat de mogelijkheid om een strategie te kiezen voor patroon, wat ook nuttig kan zijn. Bijvoorbeeld, in spring-cloud-netflix kan dit een thread pool of semaphore zijn.
Uitslag
Het resultaat is een afzonderlijke applicatie die de verwerking van berichten kan herhalen bij tijdelijke onbeschikbaarheid van een externe systeem.
Een van de belangrijkste voordelen van de applicatie is dat externe systemen die op dezelfde Kafka-cluster werken, deze kunnen gebruiken zonder aanzienlijke aanpassingen aan hun kant! Deze applicatie hoeft alleen toegang te krijgen tot het retry-topic, een paar Kafka-headers in te vullen en het bericht naar de Retryer te sturen. Er is geen extra infrastructuur nodig. En om het aantal berichten dat van de applicatie naar de Retryer en terug wordt verplaatst te verminderen, hebben we de applicaties met lineaire logica geïsoleerd en in die applicaties herverwerking door het stoppen van de Consumer gedaan.
Bron: habr.com
