

De laatste tijd hebben collega's in de "sector" mij onafhankelijk van elkaar gevraagd: hoe ontvang je met één SDR-ontvanger gelijktijdig alle Bluetooth-kanalen? De band geeft het toch toe, er zijn SDR's met een uitvoerbandbreedte van 80 MHz en meer. Je kunt het natuurlijk op een FPGA doen, maar de ontwikkelingstijd daarvoor zal behoorlijk lang zijn. Het was me al een tijd duidelijk dat het vrij eenvoudig is om dit op een GPU te doen, maar zo!
De Bluetooth-standaard definieert het fysieke niveau in twee versies: Classic en Low Energy. De specificatie is er. Het document is enorm, het is gevaarlijk voor je brein om het volledig te lezen. Gelukkig hebben grote bedrijven die meetinstrumenten maken de middelen om visuele documenten over dit onderwerp te maken. en , bijvoorbeeld. Ik heb absoluut geen kans om met hen te concurreren qua kwaliteit van presentatie. Geïnteresseerden vraag ik om de links te bestuderen.
Alles wat ik moet weten over het fysieke niveau voor het maken van een multikanaalfilter, zijn de frequentienetwerkstappen en de modulatiesnelheid. Deze zijn samengevat in een tabel in een van de genoemde documenten:
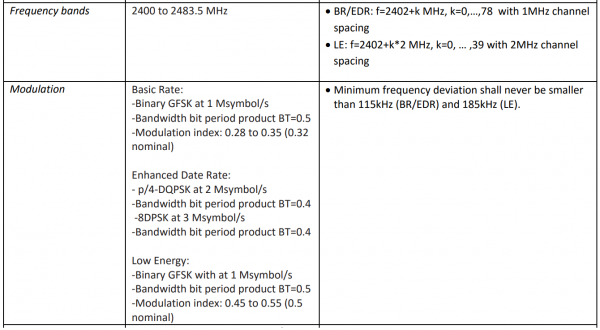
Dus moeten we de band van 80 MHz opdelen in 79 filters met een instapsectie van 1 MHz en tegelijkertijd in 40 filters met een instapsectie van 2 MHz. De samplingfrequenties van de filteruitgangen moeten respectievelijk 1 MHz en 2 MHz zijn.
Dus hebben we twee filterkammen nodig.
Laten we eerst de parameters van deze filters kiezen op basis van de bandbreedtes van Bluetooth Classic en Bluetooth Low Energy. We hebben hun impulsresponsen nodig om de belasting op het rekeneenheid van het filter te berekenen. Hier moet onmiddellijk worden opgemerkt dat we de lengtes van de impulsresponsen hebben gekozen op basis van de vereisten van een "snelle" filtering. De essentie verandert daar niet door. En het aantal coëfficiënten van de impulsrespons mag niet te groot zijn, zodat het filter kan worden geïmplementeerd op redelijke rekenelementen.
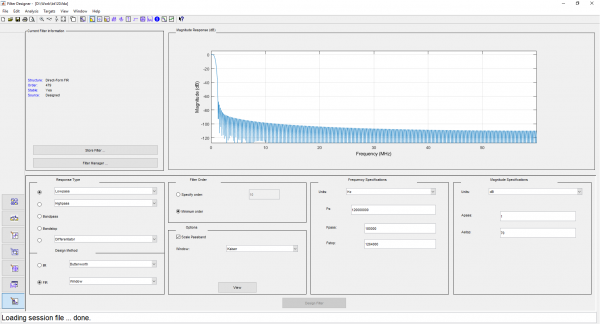
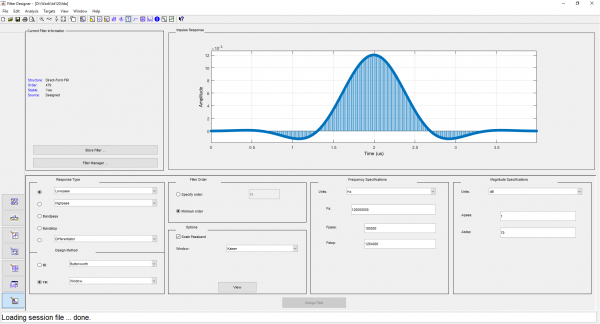
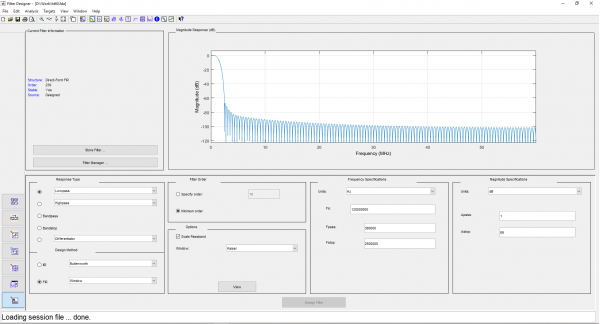
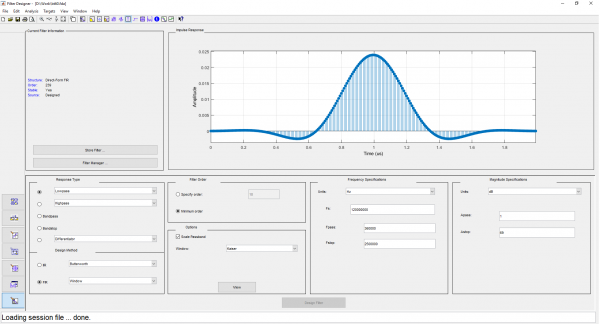
Voor filters met een stap van 1 MHz kiezen we een doorlaatband van het laagdoorlaatfilter (de helft van de doorlaatband van het bandfilter) van 500 kHz, de lengte van de impulsrespons stellen we in op 480 tapplaatsen. Voor filters met een stap van 2 MHz kiezen we deze parameters als 1 MHz en 240 tapplaatsen, respectievelijk. We kiezen het type venster als Kaiser. We berekenen de impulsresponsen in filterDesigner en exporteren ze in C-headerformaat:
Screenshots uit filterDesigner
Je kunt het probleem frontaal aanpakken: een DDC-array (Digital Down Converter) bouwen, afhankelijk van het aantal filters (). Deze aanpak is goed voor FPGA's, waar besparingen kunnen worden gerealiseerd door het verminderen van de precisie van de rekeneenheden in de eerste fasen. Daarnaast is FPGA de meest energie-efficiënte manier van implementatie. Maar de arbeidsinspanningen bij deze methode zijn het hoogst.
Bij het uitvoeren van de filterkam op momenteel populaire GPU's ontstaat de mogelijkheid om een meer geavanceerd algoritme uit te voeren: een polyfase-filterkam gebaseerd op FFT, dat op CUDA beschikbaar is via de bibliotheek. In de buitenlandse literatuur wordt het algoritme Polyphase of WOLA (Weight, Overlap and Add) FFT Filterbank genoemd. Mijn luiheid om te tekenen hindert me om een visuele uitleg zelf te maken. Er zijn veel materialen op het internet over dit onderwerp, vooral een duidelijke grafiek gemaakt op pagina 11 (grote dank aan de gerespecteerde auteurs), hier is hij:
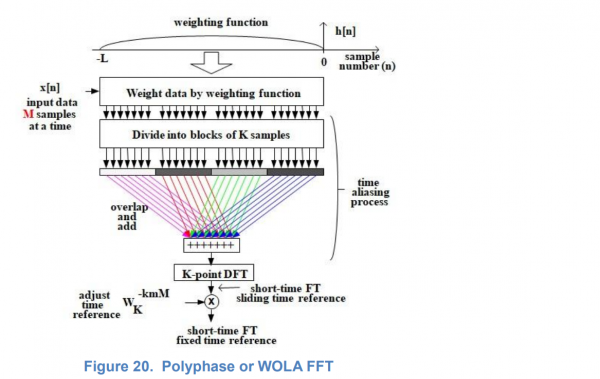
Ik zal proberen het verwerkingsschema met mijn eigen woorden toe te lichten. Mensen met een zwak hart worden verzocht niet te lezen.
Ik zal proberen het verwerkingsschema met mijn eigen woorden toe te lichten binnen de grenzen van mijn methodologische mogelijkheden. De FFT is de convolutie van het inkomende signaal met de volledige spectre van complexe orthogonale harmonischen, die zich binnen het interval van de impulsrespons bevinden. De impulsrespons van het filter, waarmee het signaal vóór de FFT wordt vermenigvuldigd, wordt gemoduleerd door deze harmonische spectre. Met andere woorden, de omhulsel van de impulsresponsen van de resulterende filters van de kam wordt buiten de haakjes genomen. Vervolgens wordt het spectre van de harmonischen gespreid over een bepaald aantal keer, wegen de uitbreiding van de bandbreedte van het filter ten opzichte van het filter met een rechthoekig venster. In de afbeelding zien we een spreiding van vier. Met andere woorden, na de uitbreiding van de bandbreedte met een Kaiser-venster (met gelijktijdige verhoging van de demping in de stopband) hebben we niet alle filters nodig, maar slechts een vierde van hen. De overige zijn overtollig, hun frequentiekenmerken overlappen elkaar. Van de vier opeenvolgende FFT-punten kiezen we alleen de nulde, waarvan de berekening de som is van vier
ingangspunten, genomen met een tijdsinterval gelijk aan een kwart van de duur van de originele FFT.
We kiezen de hardware die we bij de hand hebben. Dit is de invoerkaart van het bedrijf 'Instrumental Systems' FMC126P. Daarover heb ik al in een van mijn vorige berichten geschreven. In de FMC-sleuf van de kaart is een submodule van hetzelfde bedrijf geplaatst met een AD9371-transceeder met een bandbreedte van 100 MHz. De volledige stroom van de transceiver kan continu naar de computer worden gestuurd voor verwerking.
Laten we een videokaart met GPU GTX 1050 kiezen. (Ik heb gelogen, het is zij die ons heeft gekozen: dit is alles wat binnen handbereik was, het werd uit de rekensoftware voor antenneberekeningen gehaald, maar het was des te verrassender om een werkende combiner te zien). Laten we verder gaan met het softwaregedeelte.
Helaas kunnen we vanwege licenties de volledige code niet publiceren. We kunnen alleen de GPU-kernen laten zien. De rest van de code is bovendien niet echt interessant.
Hier is de kern die het signaal vermenigvuldigt met de venstertijd en optelt, en de wrapper voor het aanroepen ervan:
__global__ void cuComplexMultiplyWindowKernel(const cuComplex *data, const float *window, size_t windowSize, cuComplex *result) {
    __shared__ cuComplex multiplicationResult[480];
    multiplicationResult[threadIdx.x] = cuComplexMultiplyFloat(data[threadIdx.x + windowSize / 4 * blockIdx.x], window[threadIdx.x]);
    __syncthreads();
    cuComplex sum;
    sum.x = sum.y = 0;
    if (threadIdx.x < windowSize / 4) {
        for(int i = 0; i < 4; i++) {
            sum = cuComplexAdd(sum, multiplicationResult[threadIdx.x + i * windowSize / 4]);
        }
        result[threadIdx.x + windowSize / 4 * blockIdx.x] = sum;
    }
}

cudaError_t cuComplexMultiplyWindow(const cuComplex *data, const float *window, size_t windowSize, cuComplex *result, size_t dataSize, cudaStream_t stream) {
    size_t windowStep = windowSize / 4;
    cuComplexMultiplyWindowKernel<<>>(data, window, windowSize, result);
    return cudaGetLastError();
}
De signaalverwerkingscode die deze kern aanroept, herhaalt helemaal het algoritmeschema dat hierboven is afgebeeld, daarom zie ik geen reden om het hier verder te vermelden.
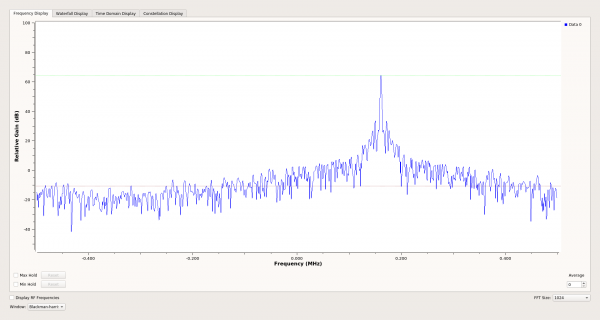
De combiners zijn getest op het uitvoerspectrum van de kanalen in realtime. Er werd een signaal van een 2450 MHz-signaalgenerator naar de AD9371 gevoerd, de selectiviteit van de filters kwam overeen met de berekende.
In de plannen: de software aanpassen voor de XRTX-kaart en het implementeren van pakketdetectie, als iemand dat nodig heeft of als er vrije tijd is.
Al het werk aan de software is uitgevoerd door , eer aan hem!
Bron: habr.com
