

Hallo iedereen, vrienden!
* Dit artikel is geschreven op basis van de open workshop REBRAIN & Yandex.Cloud. Als je liever naar video kijkt, kun je deze vinden via deze link —
Onlangs kregen we de kans om Yandex.Cloud in het echt te ervaren. Aangezien we er graag lang en intensief mee aan de slag wilden, hebben we meteen de beslissing genomen om geen eenvoudige Wordpress-blog met een clouddatabase op te zetten — dat was te saai. Na een korte overdenking besloten we om iets op te zetten dat leek op een productiearchitectuur voor het ontvangen en analyseren van evenementen in near real-time.
Ik ben er absoluut van overtuigd dat de overgrote meerderheid van online (en niet alleen online) bedrijven op de een of andere manier een enorme hoeveelheid informatie over hun gebruikers en hun acties verzamelt. Dit is minimaal nodig om bepaalde beslissingen te nemen — bijvoorbeeld, als je een online game beheert, kun je kijken naar de statistieken van op welk niveau gebruikers vaak vastlopen en je spel verwijderen. Of waarom gebruikers je website verlaten zonder iets te kopen (hallo, Yandex.Metrica).
Dus, ons verhaal: hoe we een applicatie in Golang schreven, testten Kafka versus RabbitMQ versus YQS, datastreaming naar de Clickhouse-cluster schreven en de gegevens visualiseerden met Yandex Datalens. Natuurlijk was dit alles doorspekt met infrastructuurvaardigheden zoals Docker, Terraform, GitLab CI en natuurlijk Prometheus. Laten we beginnen!
Ik wil meteen opmerken dat we alles niet in één keer kunnen instellen — hiervoor hebben we een aantal artikelen in deze serie nodig. Een beetje over de structuur:
Deel 1 (deze lees je nu). We zullen de vereisten en architectuur van de oplossing bepalen en een applicatie in Golang schrijven.
Deel 2. We brengen onze applicatie in productie, maken deze schaalbaar en testen de belasting.
Deel 3. We proberen te begrijpen waarom we berichten in een buffer moeten opslaan in plaats van in bestanden en vergelijken Kafka, RabbitMQ en Yandex Queue Service met elkaar.
Deel 4. We gaan een Clickhouse-cluster opzetten, schrijven een streamingproces om gegevens vanuit de buffer daarheen te verplaatsen, en stellen de visualisatie in Datalens in.
Deel 5. We brengen de hele infrastructuur in goede staat — we stellen CI/CD in met GitLab CI, en integreren monitoring en service discovery met Prometheus en Consul.
Vereisten
Laten we eerst de technische vereisten formuleren — wat willen we precies als resultaat willen bereiken.
- We willen een endpoint hebben zoals events.kis.im (kis.im is het testdomein dat we gedurende de artikelen zullen gebruiken), dat evenementen moet ontvangen via HTTPS.
- Evenementen zijn een eenvoudig JSON-formaat: {"event": "view", "os": "linux", "browser": "chrome"}. In de uiteindelijke fase zullen we iets meer velden toevoegen, maar dat zal niet veel uitmaken. Als je wilt, kun je overschakelen naar protobuf.
- De service moet in staat zijn om 10.000 evenementen per seconde te verwerken.
- Er moet de mogelijkheid zijn om horizontaal op te schalen - door eenvoudig nieuwe instanties aan onze oplossing toe te voegen. Het zou ook goed zijn als we de frontend naar verschillende geografische locaties kunnen verplaatsen om de latency bij klant aanvragen te verminderen.
- Fouttolerantie. De oplossing moet voldoende stabiel zijn en moeten kunnen overleven als delen falen (tot een bepaald aantal, natuurlijk).
Architectuur
Voor dit soort taken zijn er al lang klassieke architecturen bedacht die effectief kunnen opschalen. In de afbeelding is een voorbeeld van onze oplossing weergegeven.
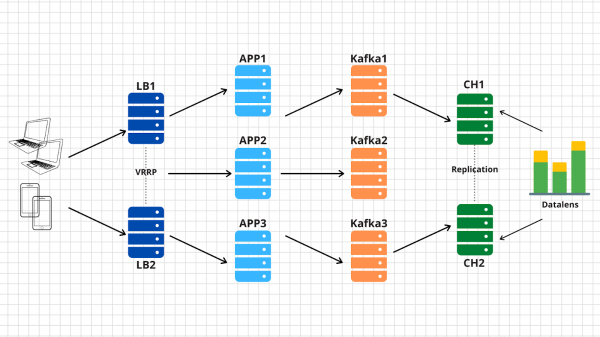
Laten we eens kijken naar wat we hebben:
1. Links zijn onze apparaten weergegeven die verschillende gebeurtenissen genereren, of het nu gaat om het bereiken van niveaus door spelers in een smartphonegame of het plaatsen van een bestelling in een online winkel via een reguliere browser. Het evenement, zoals vermeld in de specificaties, is een eenvoudige JSON die naar ons endpoint - events.kis.im - wordt verzonden.
2. De eerste twee servers zijn eenvoudige load balancers, hun belangrijkste taken zijn:
- Altijd beschikbaar zijn. Hiervoor kunnen we bijvoorbeeld keepalived gebruiken, dat het virtuele IP tussen de knooppunten zal schakelen in geval van problemen.
- TLS beëindigen. Ja, we zullen TLS precies daar beëindigen. Ten eerste om onze oplossing aan de specificaties te laten voldoen, en ten tweede om de belasting van het tot stand brengen van een versleutelde verbinding van onze backend-servers af te nemen.
- Inkomende verzoeken balanceren naar beschikbare backend-servers. Het sleutelwoord hier is beschikbaar. Op basis hiervan komen we tot de conclusie dat load balancers in staat moeten zijn om onze servers met toepassingen te monitoren en de verkeersbalans op falende knooppunten te stoppen.
3. Achter de load balancers hebben we applicatieservers, waarop een vrij eenvoudige toepassing draait. Deze moet inkomende verzoeken via HTTP kunnen accepteren, de verzonden JSON valideren en de gegevens in een buffer opslaan.
4. Als buffer in het schema is kafka weergegeven, hoewel op dit niveau ook andere vergelijkbare diensten kunnen worden gebruikt. We vergelijken Kafka, rabbitmq en yqs in het derde artikel.
5. De voorlaatste schakel in onze architectuur is Clickhouse — een kolomgeoriënteerde database die het mogelijk maakt enorme hoeveelheden data op te slaan en te verwerken. Op dit niveau moeten we data van de buffer naar het opslag systeem verplaatsen (hierover in artikel 4).
Dit schema stelt ons in staat om elk laag onafhankelijk horizontaal te schalen. Als de backend-server het niet aankan — voegen we nog een server toe — want ze zijn stateless applicaties, dus dit kan zelfs automatisch worden gedaan. Kan de buffer in de vorm van kafka het niet aan — voegen we meer servers toe en verplaatsen we een deel van de partities van ons topic naar hen. Als Clickhouse het niet aankan — dat is onmogelijk 🙂 In werkelijkheid voegen we ook servers toe en schaden we de data.
Overigens, als je het optionele gedeelte van onze technische specificaties wilt implementeren en schaling in verschillende geografische locaties wilt uitvoeren, dan is dat heel eenvoudig:
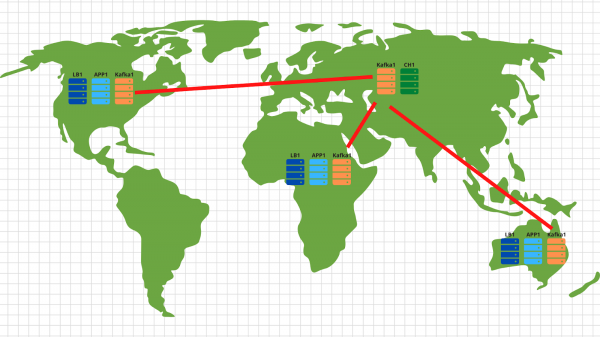
In elke geografische locatie zetten we een load balancer uit met de applicatie en kafka. Over het algemeen volstaan 2 applicatieservers, 3 kafka-nodes en een cloud load balancer, bijvoorbeeld Cloudflare, die de beschikbaarheid van de applicatienodes controleert en aanvragen op basis van het IP-adres van de klant over geolocaties balanceert. Op deze manier komen gegevens die door Amerikaanse klanten zijn verzonden, op Amerikaanse servers aan. En gegevens uit Afrika komen op Afrikaanse servers aan.
Verder is alles heel eenvoudig — we gebruiken de mirror tool uit de kafka-set en kopiëren alle gegevens uit alle locaties naar ons centrale datacenter in Rusland. Binnen halen we de gegevens uit elkaar en schrijven we ze in Clickhouse voor verdere visualisatie.
Dus, we hebben de architectuur begrepen — laten we Yandex.Cloud onder druk zetten!
We schrijven een applicatie
Voor de Cloud moeten we nog even wachten en een vrij eenvoudige service schrijven voor de verwerking van binnenkomende evenementen. We zullen golang gebruiken, omdat het zich zeer goed heeft bewezen als taal voor het schrijven van netwerkapplicaties.
Na een uur (misschien een paar uur) krijgen we ongeveer dit resultaat: .
Welke belangrijke punten zouden we hier willen benadrukken:
1. Bij het starten van de applicatie kun je twee vlaggen opgeven. De ene is verantwoordelijk voor de poort waarop we inkomende http-verzoeken zullen luisteren (-addr). De andere is het adres van de kafka-server waar we onze evenementen naartoe zullen schrijven (-kafka):
addr     = flag.String("addr", ":8080", "TCP-adres om naar te luisteren")
kafka    = flag.String("kafka", "127.0.0.1:9092", "Kafka-eindpunten")
2. De applicatie maakt gebruik van de sarama-bibliotheek () voor het verzenden van berichten naar het kafka-cluster. We hebben direct instellingen ingesteld die gericht zijn op maximale verwerkingssnelheid:
config := sarama.NewConfig()
config.Producer.RequiredAcks = sarama.WaitForLocal
config.Producer.Compression = sarama.CompressionSnappy
config.Producer.Return.Successes = true
3. Ook is er een prometheus-client geïntegreerd in onze applicatie, die verschillende statistieken verzamelt, zoals:
- het aantal verzoeken naar onze applicatie;
- het aantal fouten tijdens de verwerking van een verzoek (kan post-verzoek niet lezen, beschadigde json, kan niet schrijven naar kafka);
- de verwerkingstijd van één verzoek van de klant, inclusief de tijd om het bericht naar kafka te schrijven.
4. Drie eindpunten die onze applicatie afhandelt:
- /status — просто возвращаем ok, чтобы показать, что мы живы. Хотя можно и добавить некоторые проверки, типа доступности кафка кластера.
- /metrics — по этому url prometheus client будет возвращать собранные им метрики.
- /post — основной endpoint, куда будут приходить POST запросы с json внутри. Наше приложение проверяет json на валидность и если все ок — записывает данные в кафка-кластер.
Ik moet zeggen dat de code niet perfect is — hij kan (en moet!) verder worden verbeterd. Bijvoorbeeld, je zou kunnen afzien van het gebruik van de ingebouwde net/http en overstappen op de snellere fasthttp. Of je kunt de verwerkingstijd en CPU-bronnen besparen door de validatie van json naar een latere fase te verplaatsen — wanneer de gegevens van de buffer naar het clickhouse-cluster worden verplaatst.
Naast de ontwikkelingskant van de kwestie dachten we meteen na over onze toekomstige infrastructuur en besloten we onze applicatie via docker te implementeren. De uiteindelijke Dockerfile voor het bouwen van de applicatie — . In het algemeen is hij vrij eenvoudig, het enige waar ik op wil wijzen is de multistage-bouw, die helpt om de uiteindelijke afbeelding van onze container te verkleinen.
Eerste stappen in de cloud
Als eerste registreren we ons op . Na het invullen van alle noodzakelijke velden krijgen we een account en krijgt een subsidiebedrag dat we kunnen gebruiken om de cloudservices te testen. Als je alle stappen uit ons artikel wilt herhalen, zou deze subsidie voldoende moeten zijn.
Na registratie wordt er een aparte cloud en een standaardcatalogus voor jou aangemaakt, waarin je cloudresources kunt gaan creëren. Over het algemeen ziet de onderlinge relatie van resources in Yandex.Cloud er als volgt uit:
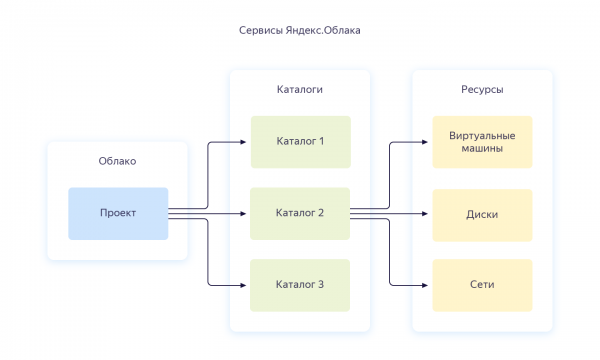
Op één account kunt u meerdere clouds creëren. Binnen de cloud kunt u verschillende mappen maken voor verschillende projecten van het bedrijf. U kunt hierover meer lezen in de documentatie — . Trouwens, ik zal hier verderop in de tekst vaak naar verwijzen. Toen ik de hele infrastructuur vanaf nul instelde, heeft de documentatie me meer dan eens geholpen, dus ik raad aan om deze goed door te nemen.
Voor het beheren van de cloud kunt u zowel de webinterface als de consoletool — yc gebruiken. De installatie kan met één opdracht worden uitgevoerd (voor Linux en Mac OS):
curl https://storage.yandexcloud.net/yandexcloud-yc/install.sh | bashAls uw interne beveiligingsfunctionaris het moeilijk heeft met het uitvoeren van scripts van internet, kunt u ten eerste het script openen en lezen, en ten tweede voeren we het uit onder onze eigen gebruiker — zonder root-rechten.
Als u de client voor Windows wilt installeren, kunt u de instructies volgen en vervolgens uitvoeren yc init, om het volledig in te stellen:
vozerov@mba:~ $ yc init
Welkom! Deze opdracht begeleidt u door het configuratieproces.
Ga alstublieft naar https://oauth.yandex.ru/authorize?response_type=token&client_id= om een OAuth-token te verkrijgen.

Voer alstublieft het OAuth-token in:
Selecteer de cloud die u wilt gebruiken:
 [1] cloud-b1gv67ihgfu3bp (id = b1gv67ihgfu3bpt24o0q)
 [2] fevlake-cloud (id = b1g6bvup3toribomnh30)
Voer uw numerieke keuze in: 2
Uw huidige cloud is ingesteld op 'fevlake-cloud' (id = b1g6bvup3toribomnh30).
Kies de map die u wilt gebruiken:
 [1] standaard (id = b1g5r6h11knotfr8vjp7)
 [2] Maak een nieuwe map aan
Voer uw numerieke keuze in: 1
Uw huidige map is ingesteld op 'standaard' (id = b1g5r6h11knotfr8vjp7).
Wilt u een standaard Compute-zone configureren? [Y/n]
Welke zone wilt u gebruiken als standaardprofiel?
 [1] ru-central1-a
 [2] ru-central1-b
 [3] ru-central1-c
 [4] Geen standaardzone instellen
Voer uw numerieke keuze in: 1
Uw standaard Compute-zone voor het profiel is ingesteld op 'ru-central1-a'.
vozerov@mba:~ $
In principe is het proces niet moeilijk — u moet eerst een oauth-token verkrijgen voor het beheer van de cloud, de cloud en de map kiezen die u wilt gebruiken.
Als u meerdere accounts of mappen binnen één cloud heeft, kunt u extra profielen met afzonderlijke instellingen maken via yc config profile create en tussen hen schakelen.
Naast de bovengenoemde methoden heeft het team van Yandex.Cloud een zeer goede geschreven om cloudresources te beheren. Van mijn kant heb ik een git-repository voorbereid, waarin ik alle resources heb beschreven die in het kader van dit artikel zullen worden aangemaakt — . We zijn geïnteresseerd in de master-tak, laten we deze lokaal klonen:
vozerov@mba:~ $ git clone https://github.com/rebrainme/yandex-cloud-events/ events
Klonen in 'events'...
remote: Objecten tellen: 100, gedaan.
remote: Tellen van objecten: 100% (100/100), gedaan.
remote: Objecten comprimeren: 100% (68/68), gedaan.
remote: Totaal 100 (delta 37), hergebruikt 89 (delta 26), pack-hergebruikt 0
Objecten ontvangen: 100% (100/100), 25.65 KiB | 168.00 KiB/s, gedaan.
Deltaversies oplossen: 100% (37/37), gedaan.
vozerov@mba:~ $ cd events/terraform/
Alle belangrijke variabelen die in terraform worden gebruikt, zijn gedefinieerd in het bestand main.tf. Om aan de slag te gaan, maken we in de map terraform het bestand private.auto.tfvars aan met de volgende inhoud:
# Yandex Cloud Oauth token
yc_token = ""
# Yandex Cloud ID
yc_cloud_id = ""
# Yandex Cloud folder ID
yc_folder_id = ""
# Default Yandex Cloud Region
yc_region = "ru-central1-a"
# Cloudflare email
cf_email = ""
# Cloudflare token
cf_token = ""
# Cloudflare zone id
cf_zone_id = ""
Alle variabelen kunnen worden gehaald uit yc config list, aangezien we de consoletool al hebben ingesteld. Ik raad aan om private.auto.tfvars meteen aan .gitignore toe te voegen, om te voorkomen dat je per ongeluk privégegevens publiceert.
In private.auto.tfvars hebben we ook de gegevens van Cloudflare opgegeven — voor het aanmaken van DNS-records en het proxy'en van het hoofddomein events.kis.im naar onze servers. Als je Cloudflare niet wilt gebruiken, verwijder dan de initialisatie van de Cloudflare-provider in main.tf en het bestand dns.tf, dat verantwoordelijk is voor het aanmaken van de benodigde DNS-records.
We zullen in ons werk alle drie de methoden combineren — zowel de webinterface, de consoletool als terraform.
Virtuele netwerken
Eerlijk gezegd zou je deze stap kunnen overslaan, aangezien er automatisch een apart netwerk en drie subnetten worden aangemaakt bij het creëren van een nieuwe cloud — één voor elke beschikbaarheidszone. Maar we willen toch een apart netwerk maken voor ons project met eigen adressering. Het algemene schema van het netwerk in Yandex.Cloud wordt hieronder weergegeven (eerlijk genomen genomen van )
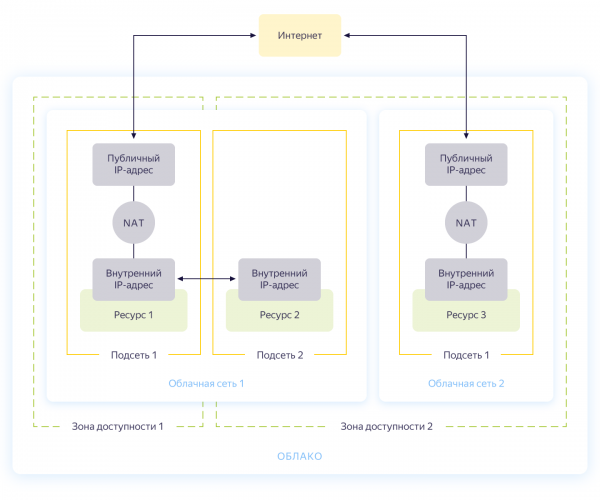
Dus, je creëert een gemeenschappelijk netwerk waarin de bronnen met elkaar kunnen communiceren. Voor elke beschikbaarheidszone wordt een subnet gemaakt met zijn eigen adressering en verbonden met het gemeenschappelijke netwerk. Uiteindelijkt kunnen alle cloudbronnen daarin met elkaar communiceren, zelfs al bevinden ze zich in verschillende beschikbaarheidszones. Bronnen die met verschillende cloudnetwerken zijn verbonden, kunnen elkaar alleen zien via externe adressen. Trouwens, hoe deze magie van binnenuit werkt, .
De creatie van het netwerk is beschreven in het bestand network.tf uit de repository. Daar maken we één gezamenlijk privé netwerk internal aan en verbinden we drie subnetten in verschillende beschikbaarheidszones — internal-a (172.16.1.0/24), internal-b (172.16.2.0/24), internal-c (172.16.3.0/24).
Laten we terraform initialiseren en netwerken aanmaken:
vozerov@mba:~\/events\/terraform (master) $ terraform init
... overgeslagen ..

vozerov@mba:~\/events\/terraform (master) $ terraform apply -target yandex_vpc_subnet.internal-a -target yandex_vpc_subnet.internal-b -target yandex_vpc_subnet.internal-c

... overgeslagen ...

Plan: 4 toe te voegen, 0 te wijzigen, 0 te vernietigen.

Wilt u deze acties uitvoeren?
  Terraform zal de hierboven beschreven acties uitvoeren.
  Alleen 'ja' wordt geaccepteerd om goed te keuren.

  Voer een waarde in: ja

yandex_vpc_network.internal: Aanmaken...
yandex_vpc_network.internal: Aanmaak compleet na 3s [id=enp2g2rhile7gbqlbrkr]
yandex_vpc_subnet.internal-a: Aanmaken...
yandex_vpc_subnet.internal-b: Aanmaken...
yandex_vpc_subnet.internal-c: Aanmaken...
yandex_vpc_subnet.internal-a: Aanmaak compleet na 6s [id=e9b1dad6mgoj2v4funog]
yandex_vpc_subnet.internal-b: Aanmaak compleet na 7s [id=e2liv5i4amu52p64ac9p]
yandex_vpc_subnet.internal-c: Nog aan het creëren... [10s verstreken]
yandex_vpc_subnet.internal-c: Aanmaak compleet na 10s [id=b0c2qhsj2vranoc9vhcq]

Toepassen compleet! Hulpbronnen: 4 toegevoegd, 0 gewijzigd, 0 vernietigd.
Geweldig! We hebben ons netwerk gemaakt en zijn nu klaar om onze interne services te creëren.
Het maken van virtuele machines
Voor het testen van de applicatie is het voldoende om twee virtuele machines te creëren — de eerste hebben we nodig voor het bouwen en uitvoeren van de applicatie, de tweede voor het draaien van Kafka, dat we zullen gebruiken voor het opslaan van binnenkomende berichten. We zullen ook een andere machine creëren waar we Prometheus instellen voor het monitoren van de applicatie.
De virtuele machines worden ingesteld met Ansible, zorg er dus voor dat je een van de laatste versies van Ansible hebt geïnstalleerd voordat je Terraform start. En installeer de vereiste rollen met Ansible Galaxy:
vozerov@mba:~\/events\/terraform (master) $ cd ..\/ansible\/
vozerov@mba:~\/events\/ansible (master) $ ansible-galaxy install -r requirements.yml
- cloudalchemy-prometheus (master) is al geïnstalleerd, overslaan.
- cloudalchemy-grafana (master) is al geïnstalleerd, overslaan.
- sansible.kafka (master) is al geïnstalleerd, overslaan.
- sansible.zookeeper (master) is al geïnstalleerd, overslaan.
- geerlingguy.docker (master) is al geïnstalleerd, overslaan.
vozerov@mba:~\/events\/ansible (master) $
Binnen de map Ansible is er een voorbeeld van een configuratiebestand .ansible.cfg, dat ik gebruik. Misschien is het nuttig.
Voordat je virtuele machines aanmaakt, zorg ervoor dat de ssh-agent is gestart en de ssh-sleutel is toegevoegd, anders kan Terraform niet verbinden met de aangemaakte machines. Ik stuitte natuurlijk op een bug in OS X: . Om ervoor te zorgen dat je niet met hetzelfde probleem komt te zitten, voeg een kleine variabele toe aan env voordat je Terraform start:
vozerov@mba:~\/events\/terraform (master) $ export OBJC_DISABLE_INITIALIZE_FORK_SAFETY=YESIn de map met Terraform creëren we de benodigde hulpbronnen:
vozerov@mba:~\/events\/terraform (master) $ terraform apply -target yandex_compute_instance.build -target yandex_compute_instance.monitoring -target yandex_compute_instance.kafka
yandex_vpc_network.internal: Status aan het vernieuwen... [id=enp2g2rhile7gbqlbrkr]
data.yandex_compute_image.ubuntu_image: Status aan het vernieuwen...
yandex_vpc_subnet.internal-a: Status aan het vernieuwen... [id=e9b1dad6mgoj2v4funog]

Een uitvoeringsplan is gegenereerd en wordt hieronder weergegeven.
Hulpbronnenacties worden aangeduid met de volgende symbolen:
  + creëren

... overgeslagen ...

Plan: 3 toe te voegen, 0 te veranderen, 0 te vernietigen.

... overgeslagen ...
Als alles succesvol is afgerond (en dat zou het moeten zijn), dan hebben we drie virtuele machines:
- build — een machine voor het testen en bouwen van de applicatie. Docker was automatisch geïnstalleerd door ansible.
- monitoring — een machine voor monitoring — hierop is prometheus & grafana geïnstalleerd. De login / wachtwoord is standaard: admin / admin
- kafka — een kleine machine met geïnstalleerde kafka, bereikbaar op poort 9092.
Laten we bevestigen dat ze allemaal aanwezig zijn:
vozerov@mba:~\/events (master) $ yc compute instance list
+----------------------+------------+---------------+---------+---------------+-------------+
|          ID          |    NAAM    |    ZONE-ID    | STATUS  |  EXTERNE IP   | INTERNE IP  |
+----------------------+------------+---------------+---------+---------------+-------------+
| fhm081u8bkbqf1pa5kgj | monitoring | ru-central1-a | RUNNING | 84.201.159.71 | 172.16.1.35 |
| fhmf37k03oobgu9jmd7p | kafka      | ru-central1-a | RUNNING | 84.201.173.41 | 172.16.1.31 |
| fhmt9pl1i8sf7ga6flgp | build      | ru-central1-a | RUNNING | 84.201.132.3  | 172.16.1.26 |
+----------------------+------------+---------------+---------+---------------+-------------+
Hulpbronnen zijn op hun plaats, en hieruit kunnen we hun ip-adressen halen. Verder zal ik de ip-adressen gebruiken voor ssh-verbinding en het testen van de applicatie. Als je een account hebt op cloudflare dat verbonden is met terraform, gebruik dan gerust de pas aangemaakte DNS-namen.
Trouwens, bij het aanmaken van de virtuele machine wordt een intern ip en een interne DNS-naam gegeven, zodat je naar de servers binnen het netwerk kunt verwijzen met namen:
ubuntu@build:~$ ping kafka.ru-central1.internal
PING kafka.ru-central1.internal (172.16.1.31) 56(84) bytes aan data.
64 bytes van kafka.ru-central1.internal (172.16.1.31): icmp_seq=1 ttl=63 tijd=1.23 ms
64 bytes van kafka.ru-central1.internal (172.16.1.31): icmp_seq=2 ttl=63 tijd=0.625 ms
^C
--- kafka.ru-central1.internal ping-statistieken ---
2 pakketten verzonden, 2 ontvangen, 0% pakketverlies, tijd 1001ms
rtt min\/gemiddeld\/max\/mdev = 0.625\/0.931\/1.238\/0.308 ms
Dit zal nuttig zijn voor het aangeven van de endpoint van de applicatie met kafka.
Laten we de applicatie samenstellen
Geweldig, we hebben servers, we hebben de applicatie — nu rest alleen nog het samenstellen en publiceren. Voor de samenstelling zullen we de normale docker build gebruiken, en als opslagdienst voor afbeeldingen nemen we de service van Yandex — container registry. Maar laten we alles stap voor stap doen.
We kopiëren de applicatie naar de build machine, loggen in via ssh en bouwen de afbeelding:
vozerov@mba:~\/events\/terraform (master) $ cd ..
vozerov@mba:~\/events (master) $ rsync -av app\/ ubuntu@84.201.132.3:app\/\n\n... overgeslagen ...\n\nsent 3849 bytes  received 70 bytes  7838.00 bytes\/sec
total size is 3644  speedup is 0.93\n\nvozerov@mba:~\/events (master) $ ssh 84.201.132.3 -l ubuntu
ubuntu@build:~$ cd app
ubuntu@build:~\/app$ sudo docker build -t app .
Verzend de bouwcontext naar Docker daemon  6.144kB
Stap 1\/9 : VAN golang:latest ALS build
... overgeslagen ...\n\nMet succes gebouwd 9760afd8ef65
Met succes getagd app:latest
De helft is gedaan — nu kunnen we de werking van onze applicatie controleren door deze te starten en de gegevens naar kafka te sturen:
ubuntu@build:~\/app$ sudo docker run --name app -d -p 8080:8080 app \/app\/app -kafka=kafka.ru-central1.internal:9092<\/code>\n\nVanaf de lokale machine kunnen we een testevent versturen en het antwoord bekijken:\n\n<code>vozerov@mba:~\/events (master) $ curl -D - -s -X POST -d '{"key1":"data1"}' http:\/\/84.201.132.3:8080\/post\nHTTP\/1.1 200 OK\nContent-Type: application\/json\nDate: Mon, 13 Apr 2020 13:53:54 GMT\nContent-Length: 41\n\n{"status":"ok","partition":0,"Offset":0}\nvozerov@mba:~\/events (master) $De applicatie gaf een succesvolle reactie met de id van de partition en offset waarin het bericht is geplaatst. Nu rest alleen nog het creëren van een registry in Yandex.Cloud en daar ons image naartoe te uploaden (hoe dit met drie regels kan, staat beschreven in het registry.tf bestand). We maken een opslagplaats aan:
vozerov@mba:~\/events\/terraform (master) $ terraform apply -target yandex_container_registry.events\n\n... overgeslagen ...\n\nPlan: 1 toe te voegen, 0 te wijzigen, 0 te vernietigen.\n\n... overgeslagen ...\n\nToepassen compleet! Hulpbronnen: 1 toegevoegd, 0 gewijzigd, 0 vernietigd.Voor authenticatie in de container registry zijn er verschillende methoden — met behulp van een oauth-token, een iam-token of een service-account sleutel. Gedetailleerder over deze methoden — in de documentatie . We zullen de sleutel van het service-account gebruiken, dus laten we een account aanmaken:
vozerov@mba:~\/events\/terraform (master) $ terraform apply -target yandex_iam_service_account.docker -target yandex_resourcemanager_folder_iam_binding.puller -target yandex_resourcemanager_folder_iam_binding.pusher\n\n... overgeslagen ...\n\nToepassen compleet! Hulpbronnen: 3 toegevoegd, 0 gewijzigd, 0 vernietigd.Nu blijft het nog om een sleutel voor hem aan te maken:
vozerov@mba:~\/events\/terraform (master) $ yc iam key create --service-account-name docker -o key.json\nid: ajej8a06kdfbehbrh91p\nservice_account_id: ajep6d38k895srp9osij\ncreated_at: "2020-04-13T14:00:30Z"\nkey_algorithm: RSA_2048We verkrijgen informatie over de id van onze opslagplaats, sturen de sleutel over en authenticeren ons:
vozerov@mba:~\/events\/terraform (master) $ scp key.json ubuntu@84.201.132.3:\nkey.json 100% 2392 215.1KB\/s 00:00\n\nvozerov@mba:~\/events\/terraform (master) $ ssh 84.201.132.3 -l ubuntu\n\nubuntu@build:~$ cat key.json | sudo docker login --username json_key --password-stdin cr.yandex\nWARNING! Uw wachtwoord wordt onversleuteld opgeslagen in \/home\/ubuntu\/.docker\/config.json.\nConfigureer een credential helper om deze waarschuwing te verwijderen. Zie\nhttps:\/\/docs.docker.com\/engine\/reference\/commandline\/login\/#credentials-store\n\nLogin Geslaagd\nubunt@build:~$Voor het uploaden van het image naar de registry hebben we de ID van de container registry nodig, die we verkrijgen via de utility yc:
vozerov@mba:~ $ yc container registry get events
id: crpdgj6c9umdhgaqjfmm
folder_id:
name: events
status: ACTIVE
created_at: "2020-04-13T13:56:41.914Z"
Daarna taggen we ons beeld met een nieuwe naam en uploaden we het:
ubuntu@build:~$ sudo docker tag app cr.yandex/crpdgj6c9umdhgaqjfmm/events:v1
ubuntu@build:~$ sudo docker push cr.yandex/crpdgj6c9umdhgaqjfmm/events:v1
De push verwijst naar de repository [cr.yandex/crpdgj6c9umdhgaqjfmm/events]
8c286e154c6e: Geüpload
477c318b05cb: Geüpload
beee9f30bc1f: Geüpload
v1: digest: sha256:1dd5aaa9dbdde2f60d833be0bed1c352724be3ea3158bcac3cdee41d47c5e380 grootte: 946
We kunnen bevestigen dat de afbeelding met succes is geüpload:
vozerov@mba:~/events/terraform (master) $ yc container repository list
+----------------------+-----------------------------+
|          ID          |            NAAM             |
+----------------------+-----------------------------+
| crpe8mqtrgmuq07accvn | crpdgj6c9umdhgaqjfmm/events |
+----------------------+-----------------------------+
Trouwens, als je het yc-hulpprogramma op een Linux-machine installeert, kun je het commando gebruiken
yc container registry configure-dockerom Docker in te stellen.
Conclusie
We hebben hard gewerkt en het resultaat is:
- We hebben de architectuur van onze toekomstige service bedacht.
- We hebben een applicatie in golang geschreven die onze bedrijfslogica implementeert.
- We hebben deze gebouwd en in een privé container registry gedepubliceerd.
In het volgende deel gaan we naar het interessante — we publiceren onze applicatie in productie en gaan eindelijk belasting op deze uitvoeren. Blijf kijken!
Dit materiaal is beschikbaar in de video-opname van de open praktijkles REBRAIN & Yandex.Cloud: We verwerken 10.000 aanvragen per seconde op Yandex Cloud —
Als je geïnteresseerd bent om dergelijke evenementen online bij te wonen en in realtime vragen te stellen, sluit je dan aan bij.
We willen Yandex.Cloud speciaal bedanken voor de mogelijkheid om zo'n evenement te organiseren. Hier is de link naar hen —
Als je hulp nodig hebt bij een cloud migratie of vragen hebt over je infrastructuur, .
P.S. We hebben 2 gratis audits per maand, misschien is jouw project wel een van hen.
Bron: habr.com
