

Opmerking van de vertaler: dit is een vertaling van een openbaar post-mortem uit de technische blog van het bedrijf . Dit beschrijft een probleem met conntrack in een Kubernetes-cluster, dat leidde tot gedeeltelijke uitval van sommige productie-diensten.
Dit artikel kan nuttig zijn voor degenen die meer willen leren over post-mortems of om enkele potentiële problemen met DNS in de toekomst te voorkomen.
Dit is geen DNS
Kan niet zijn dat dit DNS is
Dit was DNS
Een beetje over post-mortems en processen bij Preply
In het post-mortem wordt een storing of een gebeurtenis in de productie beschreven. Het post-mortem bevat een chronologie van gebeurtenissen, de impact op de gebruiker, de onderliggende oorzaak, acties en geleerde lessen.
Bij wekelijkse vergaderingen met pizza, in de kring van het technische team, delen we verschillende informatie. Een van de belangrijkste onderdelen van deze vergaderingen zijn de post-mortems, die meestal worden begeleid door een presentatie met dia's en een diepere analyse van het voorval. Ondanks dat we na post-mortems niet 'klappen', streven we ernaar een cultuur van 'zonder verwijten' te bevorderen (). We geloven dat het schrijven en presenteren van post-mortems ons (en anderen) kan helpen om soortgelijke voorvallen in de toekomst te voorkomen, daarom delen we ze.
Mensen die betrokken zijn bij het voorval moeten het gevoel hebben dat ze het in detail kunnen vertellen, zonder angst voor straf of wraak. Geen veroordeling! Het schrijven van een post-mortem is geen straf, maar een leermogelijkheid voor het hele bedrijf.
Problemen met DNS in Kubernetes. Post-mortem
Datum: 28.02.2020
Authors: Amet U., Andrei S., Igor K., Alexey P.
Status: Afgerond
Kort samengevat: Gedeeltelijke onbeschikbaarheid van DNS (26 min) voor sommige diensten in het Kubernetes-cluster
Impact: 15000 gebeurtenissen verloren voor de diensten A, B en C
Onderliggende oorzaak: Kube-proxy kon het oude record niet correct verwijderen uit de conntrack-tabel, waardoor sommige diensten nog steeds probeerden verbinding te maken met niet-bestaande pods
E0228 20:13:53.795782 1 proxier.go:610] Failed to delete kube-system/kube-dns:dns endpoint connections, error: error deleting conntrack entries for UDP peer {100.64.0.10, 100.110.33.231}, error: conntrack command returned: ...Trigger: Vanwege de lage belasting binnen het Kubernetes-cluster, heeft de CoreDNS-autoscaler het aantal pods in de deployment verminderd van drie naar twee
Oplossing: Een nieuwe implementatie van de applicatie heeft de creatie van nieuwe nodes geïnitieerd, de CoreDNS-autoscaler heeft meer pods toegevoegd voor clusterondersteuning, wat de herschrijving van de conntrack-tabel heeft veroorzaakt.
Detectie: Prometheus-monitoring heeft een groot aantal 5xx-fouten voor de services A, B en C gedetecteerd en heeft een oproep gedaan naar de dienstdoende ingenieurs.
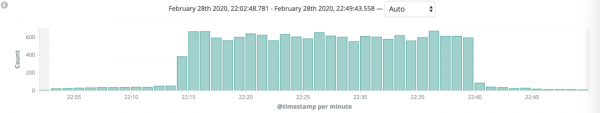
5xx-fouten in Kibana
Acties
Actie
Type
Verantwoordelijke
Task
Autoskaler uitschakelen voor CoreDNS
voorkom.
Amet U.
DEVOPS-695
Cache DNS-server instellen
vermind.
Max V.
DEVOPS-665
Conntrack-monitoring instellen
voorkom.
Amet U.
DEVOPS-674
Lessons learned
Wat goed ging:
- De monitoring werkte nauwkeurig. De reactie was snel en georganiseerd.
- We stuitten op geen limieten op de nodes.
Wat niet goed was:
- De werkelijke oorzaak is nog steeds onbekend, lijkt op in conntrack.
- Alle acties verhelpen alleen de gevolgen, niet de oorzaak (bug).
- We wisten dat we vroeg of laat problemen met DNS konden krijgen, maar prioriteerden de taken niet.
Waar we geluk hadden:
- Een nieuwe implementatie heeft de CoreDNS-autoscaler getriggerd, die de conntrack-tabel heeft herschreven.
- Deze bug heeft alleen een deel van de services aangetast.
Chronologie (EET)
Tijd
Actie
22:13
CoreDNS-autoscaler heeft het aantal pods verminderd van drie naar twee.
22:18
De dienstdoende ingenieurs begonnen oproepen van het monitoringsysteem te ontvangen.
22:21
De dienstdoende ingenieurs begonnen de oorzaak van de fouten te onderzoeken.
22:39
De dienstdoende ingenieurs begonnen een van de laatste services terug te roepen naar de vorige versie.
22:40
5xx-fouten stopten met optreden, de situatie stabiliseerde zich.
- Tijd tot detectie: 4 min
- Tijd tot actie: 21 min
- Tijd tot oplossing: 1 min
Aanvullende informatie
- [INFO] 10.1.28.1:52495 - 2606 "A IN mrkaran.hello.svc.cluster.local. udp 49 false 512" NXDOMAIN qr,aa,rd 142 0.000524939s [INFO] 10.1.28.1:59287 - 57522 "A IN mrkaran.svc.cluster.local. udp 43 false 512" NXDOMAIN qr,aa,rd 136 0.000368277s [INFO] 10.1.28.1:53086 - 4863 "A IN mrkaran.cluster.local. udp 39 false 512" NXDOMAIN qr,aa,rd 132 0.000355344s [INFO] 10.1.28.1:56863 - 41678 "A IN mrkaran. udp 25 false 512" NXDOMAIN qr,rd,ra 100 0.034629206s
I0228 20:13:53.507780 1 event.go:221] Event(v1.ObjectReference{Kind:"Deployment", Namespace:"kube-system", Name:"coredns", UID:"2493eb55-3dc0-11ea-b3a2-02bb48f8c230", APIVersion:"apps/v1", ResourceVersion:"132690686", FieldPath:""}): type: 'Normal' reason: 'ScalingReplicaSet' Verkleining van replica set coredns-6cbb6646c9 naar 2. - Links naar Kibana (weggesneden), Grafana (weggesneden)
Om het CPU-gebruik te minimaliseren, gebruikt de Linux-kernel iets dat conntrack wordt genoemd. In het kort, het is een hulpprogramma dat een lijst bevat van NAT-entries, opgeslagen in een speciale tabel. Wanneer het volgende pakket uit dezelfde pod naar dezelfde pod gaat als voorheen, wordt het eind-IP-adres niet opnieuw berekend, maar uit de conntrack-tabel gehaald.
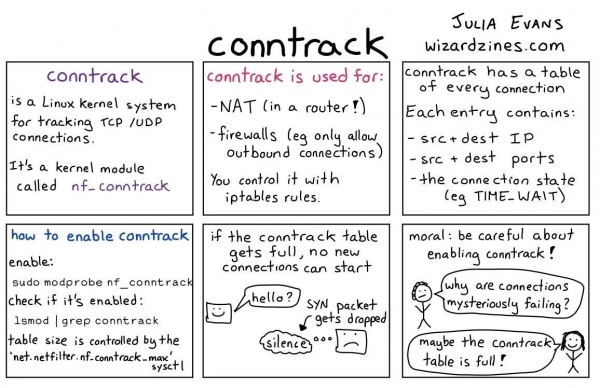
Hoe conntrack werkt.
Conclusies
Dit was een voorbeeld van een van onze post-mortems met enkele nuttige links. In dit artikel delen we informatie die nuttig kan zijn voor andere bedrijven. Daarom zijn we niet bang om fouten te maken en daarom maken we een van onze post-mortems openbaar. Hier zijn nog enkele interessante openbare post-mortems:
- GitLab:
- Dropbox:
- Spotify:
- Tal van anderen uit en repository
- Ook openbare post-mortem met het SRE-boek
Bron: habr.com
