

Dit is het verhaal over hoe we containers gebruiken in een productieomgeving, met name onder Kubernetes. Het artikel is gewijd aan het verzamelen van metrics en logs van containers, evenals het bouwen van images.
Wij zijn van fintechbedrijf Exness, dat zich richt op het ontwikkelen van services voor online trading en fintech-producten voor B2B en B2C. In onze R&D hebben we verschillende teams, met meer dan 100 medewerkers in de ontwikkelingsafdeling.
We vertegenwoordigen een team dat verantwoordelijk is voor het platform voor het verzamelen en draaien van code door onze ontwikkelaars. In het bijzonder zijn we verantwoordelijk voor het verzamelen, opslaan en verstrekken van metrics, logs en gebeurtenissen uit applicaties. Momenteel opereren we met ongeveer drieduizend Docker-containers in de productieomgeving, ondersteunen we onze big data-opslag van 50 TB en bieden we architectuur oplossingen die zijn opgebouwd rond onze infrastructuur: Kubernetes, Rancher en verschillende publieke cloudproviders.
Onze motivatie
Wat brandt? Niemand kan het antwoord geven. Waar is de brandhaard? Het is moeilijk te begrijpen. Wanneer is het begonnen? Dat is te achterhalen, maar niet meteen.
Waarom staan sommige containers stil terwijl andere zijn gevallen? Welke container is daar de schuldige van? Want van buitenaf zijn de containers identiek, maar van binnen heeft elke container zijn eigen Neo.
Onze ontwikkelaars zijn capabele mensen. Ze maken goede services die winst voor het bedrijf genereren. Maar er zijn soms problemen waarbij containers met applicaties rondslingeren. Eén container verbruikt teveel CPU, een andere te veel netwerk, een derde doet te veel invoer-uitvoer, en een vierde is eigenlijk onduidelijk wat het met sockets doet. Alles valt uit en het schip zinkt.
Agents
Om te begrijpen wat er binnenin gebeurt, hebben we besloten om agents rechtstreeks in de containers te installeren.
Deze agents zijn houdende programma's die de containers in een staat houden zodat ze elkaar niet kapot maken. De agents zijn gestandaardiseerd, wat het mogelijk maakt om de aanpak voor het onderhouden van containers te standaardiseren.
In ons geval moeten de agents logs in een gestandaardiseerd formaat leveren, getagd en met throttling. Ook moeten ze gestandaardiseerde metrics bieden die uitbreidbaar zijn vanuit het perspectief van zakelijke applicaties.
Onder agents verstaan we ook tools voor exploitatie en onderhoud die kunnen werken in verschillende orkestratiesystemen en verschillende images ondersteunen (Debian, Alpine, CentOS, enz.).
Uiteindelijk moeten agents een eenvoudige CI/CD ondersteunen, inclusief Docker-bestanden. Anders zal het schip in elkaar vallen, omdat de containers via ' kromme' rails worden geleverd.
Het bouwproces en de structuur van de doel-image.
Om alles gestandaardiseerd en beheersbaar te maken, is het noodzakelijk om een standaard bouwproces te volgen. Daarom hebben we besloten om containers met containers te bouwen — een soort van recursie.
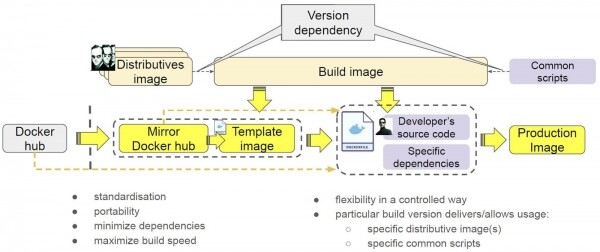
Hier worden de containers weergegeven als volle omtrekken. We hebben besloten om distributies in hen te stoppen, zodat 'het leven niet als frambozen' aanvoelt. Waarom dit is gedaan, zullen we hieronder uitleggen.
Het resultaat was een tool voor bouwen — een container van een bepaalde versie, die verwijst naar specifieke versies van distributies en specifieke versies van scripts.
Hoe passen we dit toe? We hebben een Docker Hub, waarin de container zich bevindt. We spiegelen deze naar onze eigen systeem om externe afhankelijkheden te vermijden. Hierdoor is er een container ontstaan, gemarkeerd met een gele kleur. We creëren een sjabloon om alle noodzakelijke distributies en scripts in de container te installeren. Daarna bouwen we een operationele image: ontwikkelaars plaatsen hun code en enkele van hun speciale afhankelijkheden erin.
Wat zijn de voordelen van deze aanpak?
- Ten eerste, complete versiecontrole van bouwtools – de bouwcontainer, versies van scripts en distributies.
- Ten tweede, we hebben standaardisatie bereikt: we creëren sjablonen, tussentijdse en operationele images op dezelfde manier.
- Ten derde bieden containers ons draagbaarheid. Vandaag gebruiken we Gitlab, maar morgen kunnen we overstappen op TeamCity of Jenkins en onze containers op dezelfde manier draaien.
- Ten vierde, minimalisatie van afhankelijkheden. We hebben de distributies niet zomaar in de container geplaatst, want dit voorkomt dat we ze telkens opnieuw van het internet moeten downloaden.
- Ten vijfde, de bouwsnelheid is verhoogd — het hebben van lokale kopieën van images voorkomt dat we tijd verliezen aan downloaden, omdat er een lokale image beschikbaar is.
Met andere woorden, we hebben een beheersbaar en flexibel bouwproces bereikt. We gebruiken dezelfde middelen voor het bouwen van alle containers met volledige versiecontrole.
Hoe werkt ons bouwprocedure?
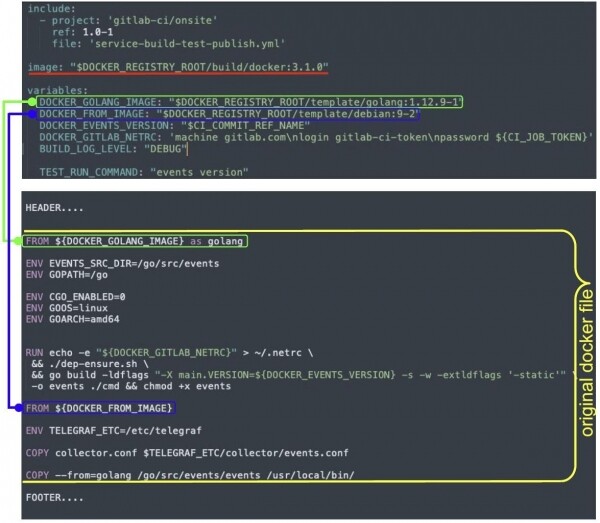
De build start met één commando, het proces wordt uitgevoerd in een afbeelding (gemarkeerd in het rood). De ontwikkelaar heeft een Docker-bestand (gemarkeerd in het geel), dat renderen we door variabelen te vervangen met waarden. En we voegen ondertussen headers en footers toe — dit zijn onze agents.
De header voegt distributies toe vanuit de bijbehorende afbeeldingen. De footer plaatst onze services erin, configureert de uitvoering van de workload, logging en andere agents, vervangt de entrypoint, enzovoort.
We hebben lang nagedacht of we een supervisor moesten installeren. Uiteindelijk hebben we besloten dat we het nodig hebben. We hebben S6 gekozen. De supervisor zorgt voor het beheer van de container: het stelt ons in staat om verbinding te maken in geval van het falen van het hoofdproces en biedt handmatige controle over de container zonder deze opnieuw te hoeven maken. Logs en metrics zijn processen die binnen de container worden uitgevoerd. Deze moeten ook op de een of andere manier worden gecontroleerd, en we doen dit met behulp van de supervisor. Ten slotte neemt S6 de uitvoering van housekeeping, het verwerken van signalen en andere taken op zich.
Aangezien we verschillende orkestratiesystemen gebruiken, moet de container na de build en start begrijpen in welke omgeving hij zich bevindt en zich naar de situatie gedragen. Bijvoorbeeld:
Dit stelt ons in staat om één afbeelding te bouwen en deze in verschillende orkestratiesystemen uit te voeren, waarbij rekening wordt gehouden met de specificiteit van dat orkestratiesysteem.
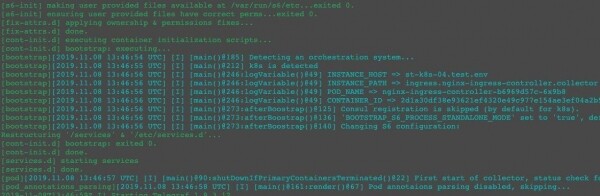
Voor dezelfde container krijgen we verschillende procesbomen in Docker en Kubernetes:
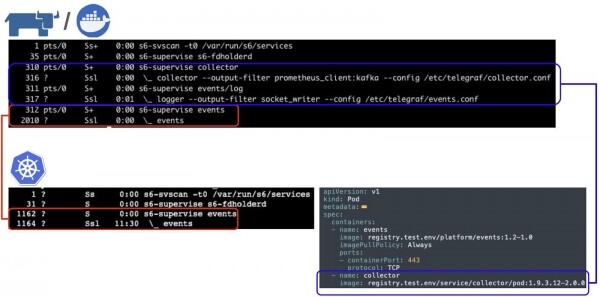
De payload wordt uitgevoerd onder de supervisor S6. Let op de collector en events – dit zijn onze agents die verantwoordelijk zijn voor logs en metrics. In Kubernetes zijn ze er niet, maar in Docker wel. Waarom?
Als we naar de specificatie van de ‘pod’ kijken (hier en verder – Kubernetes pod), dan zien we dat de container events draait in de pod, waar een aparte container collector aanwezig is, die de functie van het verzamelen van metrics en logs vervult. We kunnen gebruikmaken van de mogelijkheden van Kubernetes: containers starten in dezelfde pod, in dezelfde proces- en/of netwerkomgeving. In feite kunnen we onze agents implementeren en bepaalde functies uitvoeren. En als dezelfde container in Docker wordt gestart, krijgt hij dezelfde mogelijkheden als uitkomst, dat wil zeggen dat hij logs en metrics kan leveren, omdat de agents binnenin zullen worden uitgevoerd.
Metrics en logs
De levering van metrics en logs is een complex probleem. Er zijn verschillende aspecten verbonden aan de oplossing ervan.
De infrastructuur is ontworpen voor het uitvoeren van nuttige ladingen, niet voor massale loglevering. Dit proces moet dus worden uitgevoerd met minimale eisen aan de middelen van containers. We willen onze ontwikkelaars helpen: "Neem een Docker Hub-container, start deze en we kunnen de logs leveren."
Het tweede aspect is de beperking van de omvang van logs. Als meerdere containers te maken krijgen met een piek in logvolume (waarbij de applicatie in een lus stack-traces genereert), verhoogt dit de belasting op de CPU, communicatiekanalen en het logsysteem, wat invloed heeft op de werking van de host en andere containers op de host, en dit leidt soms tot de "uitval" van de host.
Het derde aspect is dat we zoveel mogelijk methoden voor het verzamelen van statistieken uit de doos moeten ondersteunen. Van het lezen van bestanden en het polsen van de Prometheus-endpoint tot het gebruik van specifieke applicatieprotocollen.
En het laatste aspect is dat we het verbruik van middelen moeten minimaliseren.
We hebben gekozen voor een open-source oplossing op Go genaamd Telegraf. Dit is een veelzijdige connector die meer dan 140 soorten invoerkanalen (input plugins) en 30 soorten uitvoerkanalen (output plugins) ondersteunt. We hebben het verder ontwikkeld en nu vertellen we hoe het bij ons wordt gebruikt, aan de hand van Kubernetes.
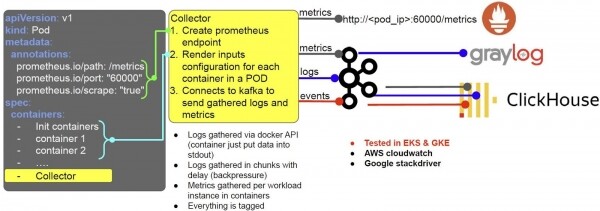
Stel dat een ontwikkelaar een workload uitrolt en Kubernetes een verzoek ontvangt om een pod te creëren. Op dat moment wordt er automatisch een container genaamd Collector voor elke pod aangemaakt (we gebruiken een mutation webhook). Collector is onze agent. Bij de start configureert deze container zichzelf voor gebruik met Prometheus en het logsysteem.
- Hiervoor gebruikt hij de annotaties van de pod, en afhankelijk van de inhoud ervan, creëert hij bijvoorbeeld een eindpunt (end-point) voor Prometheus;
- Op basis van de specificatie van de pod en specifieke instellingen van de containers beslist hij hoe de logs geleverd worden.
We verzamelen logs via de Docker API: het is voldoende voor ontwikkelaars om deze in stdout of stderr te plaatsen, en de Collector regelt de rest. Logs worden in chunks met een bepaalde vertraging verzameld om mogelijke overbelasting van de host te voorkomen.
Statistieken worden verzameld per instantie van de workload (processen) in de containers. Alles wordt gemarkeerd met tags: namespace, pod, enzovoort, en vervolgens geconverteerd naar het Prometheus-formaat - en is beschikbaar voor verzameling (behalve logs). Ook sturen we logs, statistieken en gebeurtenissen naar Kafka en verder:
- Logs zijn beschikbaar in Graylog (voor visuele analyse);
- Logs, metrics, events worden naar Clickhouse gestuurd voor langdurige opslag.
Het werkt precies hetzelfde in AWS, alleen vervangen we Graylog met Kafka door Cloudwatch. We sturen daar de logs naartoe, en alles is heel handig: je ziet direct bij welk cluster en welke container ze horen. Hetzelfde geldt voor Google Stackdriver. Onze oplossing werkt zowel on-premise met Kafka als in de cloud.
Als we geen Kubernetes met pods hebben, wordt het iets ingewikkelder, maar het werkt op dezelfde principes.
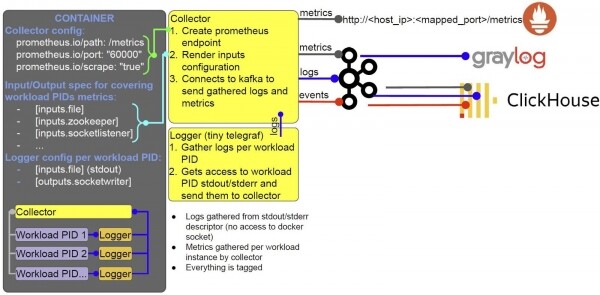
Binnen de container draaien dezelfde processen, die worden gecoördineerd met behulp van S6. Al deze processen zijn binnen één container gestart.
Uiteindelijk
We hebben een geïntegreerde oplossing ontwikkeld voor het bouwen en inzetten van images, met opties voor het verzamelen en afleveren van logs en metrics:
- We hebben een gestandaardiseerde benadering ontwikkeld voor het bouwen van images, op basis waarvan CI-sjablonen zijn ontwikkeld;
- Agents voor gegevensverzameling zijn onze Telegraf-extensies. We hebben ze goed getest in productie;
- We passen een mutation webhook toe voor het implementeren van containers met agents in de pods;
- We zijn geïntegreerd in het Kubernetes/Rancher-ecosysteem;
- We kunnen identieke containers draaien in verschillende orchestratiesystemen en het resultaat is zoals we het verwachten;
- We hebben een volledig dynamische configuratie voor het beheer van containers gecreëerd.
Co-auteur: Ilya Prudnikov
Bron: habr.com
