

Ik bied aan om kennis te maken met de transcriptie van de lezing van Nikolai Samokhvalov "Industriële benadering van PostgreSQL-tuning: experimenten met databases"
Shared_buffers = 25% – is dat veel of weinig? Of precies goed? Hoe weet je of deze – toch vrij verouderde – aanbeveling in jouw specifieke geval geschikt is?
Het is tijd om de keuze van de parameters postgresql.conf "serieus" aan te pakken. Niet met blinde "autotuners" of verouderde adviezen uit artikelen en blogs, maar op basis van:
- nauwkeurig uitgevoerde experimenten op databases, automatisch uitgevoerd, in grote hoeveelheden en onder omstandigheden die zo dicht mogelijk bij "operationele" liggen,
- diepgaand begrip van de kenmerken van de werking van DBMS en OS.
Met behulp van Nancy CLI (), zullen we een specifiek voorbeeld bekijken – de beruchte shared_buffers – in verschillende situaties, in verschillende projecten, en proberen te begrijpen hoe we de optimale configuratie voor onze infrastructuur, database en belasting kunnen kiezen.
Het zal gaan over experimenten met databases. Dit is een verhaal dat iets meer dan een half jaar duurt.
Even over mijzelf. Ik heb meer dan 14 jaar ervaring met Postgres. Ik heb een aantal sociaal-netwerkbedrijven opgericht. Overal werd en wordt Postgres gebruikt.
Ook de groep RuPostgres op Meetup, 2e plaats in de wereld. We komen langzaam dichter bij de 2.000 mensen. RuPostgres.org.
En op verschillende conferenties, waaronder Highload, ben ik verantwoordelijk voor databases, met name Postgres, sinds de oprichting.
En de laatste paar jaar heb ik mijn praktijk in Postgres-advies opnieuw gestart in 11 tijdzones van hier.
En toen ik dit een paar jaar geleden deed, had ik een zekere pauze in het actief handmatig werken met Postgres, waarschijnlijk sinds 2010. Ik was verrast hoe weinig de dagelijkse werkzaamheden van DBA waren veranderd en hoeveel handmatig werk nog steeds nodig was. En ik dacht meteen dat hier iets niet klopte, dat we meer moesten automatiseren.
En aangezien dit alles op afstand was, waren de meeste klanten in de cloud. En veel was al duidelijk geautomatiseerd. Daarover later meer. Dat wil zeggen, dit alles resulteerde in het idee dat er een reeks tools moest zijn, een soort platform dat vrijwel alle handelingen van DBA zou automatiseren zodat je een groot aantal databases zou kunnen beheren.
In deze lezing zullen er geen zijn:
- Zinnen als 'zet 8 GB of 25% shared_buffers en je bent goed' zijn niet altijd de oplossing. Er is niet veel te zeggen over shared_buffers.
- Hardcore 'innerlijke werking'.
Wat gebeurt er?
- Er zullen optimalisatieprincipes zijn die wij toepassen en verder ontwikkelen. Er zullen allerlei ideeën zijn die tijdens ons proces opkomen en verschillende tools die we voornamelijk in Open Source creëren, dat wil zeggen, we baseren ons op Open Source. Bovendien hebben we tickets; bijna al onze communicatie is in Open Source. Je kunt zien wat we momenteel doen, wat er in de volgende release zal zijn, enzovoort.
- Daarnaast zullen er ervaringen zijn met het gebruik van deze principes en tools in verschillende bedrijven: van kleine startups tot grote ondernemingen.
Hoe ontwikkelt dit alles zich?
Ten eerste is de belangrijkste taak van een DBA, naast het zorgen voor het aanmaken van instances, het implementeren van backups enzovoort, het identificeren van knelpunten en het optimaliseren van prestaties.
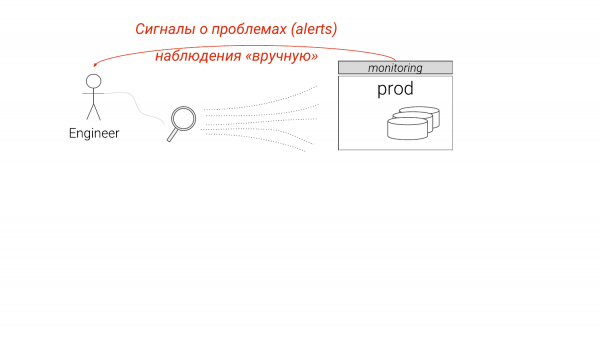
Momenteel is het zo georganiseerd. We kijken naar monitoring, zien iets, maar hebben niet alle details. We beginnen grondiger te onderzoeken, meestal handmatig, en begrijpen wat we ermee moeten doen.
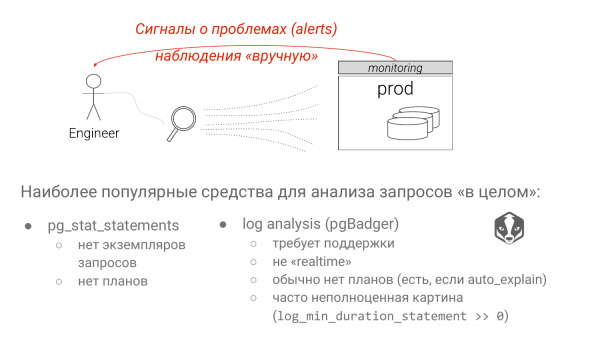
Er zijn twee benaderingen. Pg_stat_statements is de standaardoplossing voor het identificeren van trage queries. En het analyseren van logs van Postgres met pgBadger.
Elke benadering heeft serieuze tekortkomingen. Bij de eerste benadering zijn alle parameters weggelaten. En als we groepen SELECT * FROM table waar de kolom gelijk is aan het teken '?' of '$' bekijken, te beginnen met versie Postgres 10, weten we niet of het een indexscan of een seq scan is. Het hangt sterk af van de parameter. Als je een zelden voorkomend waarde invoert, krijg je een indexscan. Maar als je een waarde invoert die 90% van de tabel inneemt, zal het duidelijk een seq scan zijn, omdat Postgres de statistiek kent. Dit is een groot nadeel van pg_stat_statements, hoewel er aan gewerkt wordt.
Het grootste nadeel van loganalyse is dat je meestal 'log_min_duration_statement = 0' niet kunt veroorloven. Daarover zullen we ook praten. Hierdoor zie je niet het volledige plaatje. En een bepaalde query die heel snel is, kan een enorme hoeveelheid middelen verbruiken, maar je zult deze niet zien omdat hij onder je drempel ligt.
Hoe lossen DBA's de gevonden problemen op?
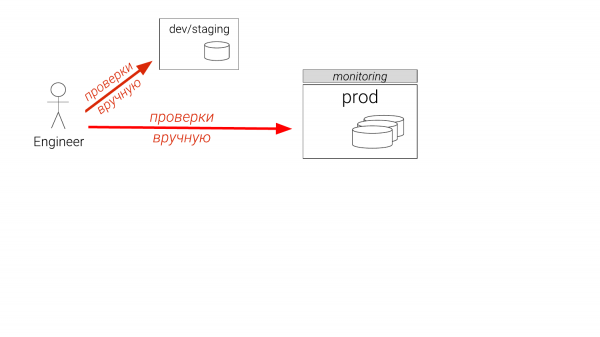
Bijvoorbeeld, we hebben een probleem gevonden. Wat wordt er meestal gedaan? Als je een ontwikkelaar bent, ga je iets doen op een bepaalde instance die niet van die grootte is. Als je DBA bent, heb je een staging. En er kan er maar één zijn. En dat is al zes maanden achterop. En je denkt dat je naar productie gaat. Zelfs ervaren DBA’s controleren daarna op productie, op een replica. Soms maken ze een tijdelijke index, zorgen ervoor dat deze helpt, verwijderen deze en geven het aan ontwikkelaars zodat zij het in de migratiebestanden kunnen opnemen. Dit soort onzin gebeurt nu. En dat is een probleem.
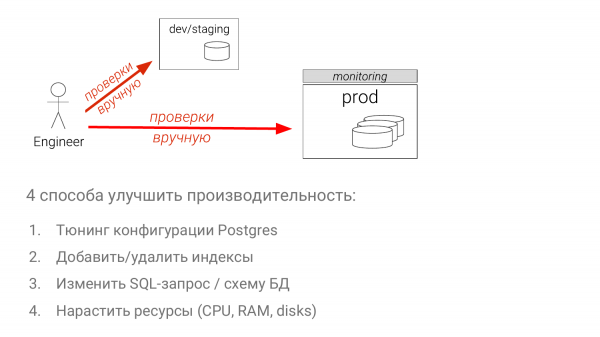
- Configuraties afstemmen.
- De set indexes optimaliseren.
- De SQL-query zelf aanpassen (dit is de moeilijkste methode).
- Extra capaciteit toevoegen (de eenvoudigste manier in de meeste gevallen).
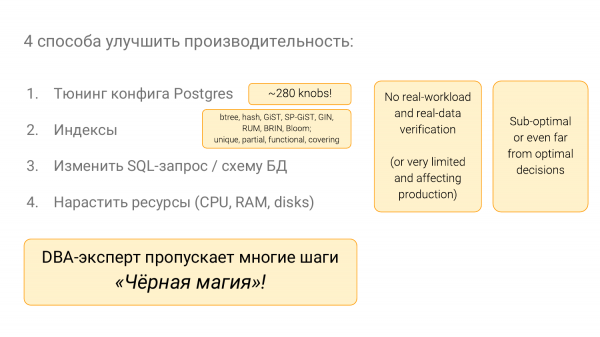
Met deze zaken is er heel veel aan de hand. Er zijn veel handvatten in Postgres. Je moet veel weten. Veel indexes in Postgres, mede dankzij de organisatoren van deze conferentie. En je moet dat allemaal weten, en dat is precies wat DBA's het gevoel geeft dat ze met zwarte magie bezig zijn. Je moet er ongeveer 10 jaar mee bezig zijn om alles echt goed te begrijpen.
En ik ben een strijder tegen deze zwarte magie. Ik wil alles zo maken dat er technologie is, en geen intuïtie in dit alles.
Voorbeelden uit het leven
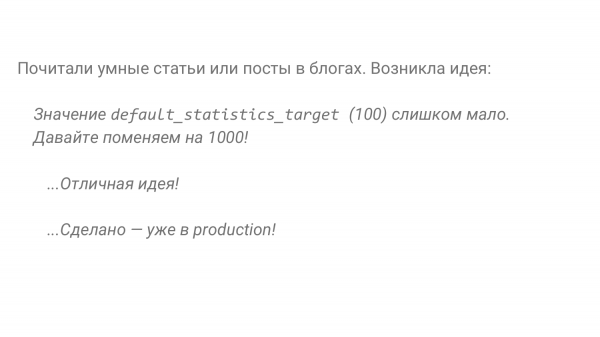
Ik heb dit in minimaal twee projecten gezien, inclusief het mijne. Een andere blogpost vertelt ons dat een waarde van 1.000 voor default_statistic_target goed is. Goed, laten we het proberen in productie.
En hier kunnen we, gebruikmakend van ons gereedschap twee jaar later met behulp van experimenten op databases waar we het vandaag over hebben, vergelijken wat er was en wat er is.
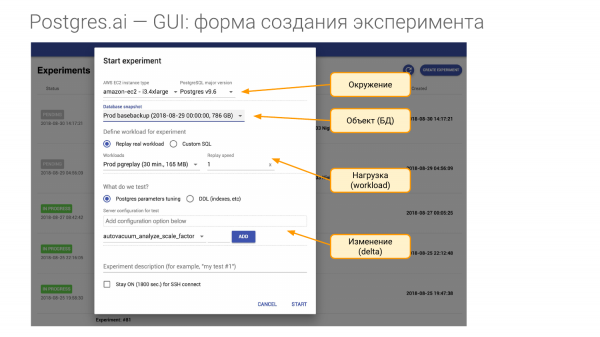
En daarvoor moeten we een experiment opzetten. Dit bestaat uit vier delen.
- Het eerste is de omgeving. We hebben hardware nodig. En wanneer ik bij een bedrijf aankom en een contract sluit, vraag ik om dezelfde hardware als in productie. Voor elk van jullie Masters heb ik ten minste één dergelijke hardware nodig. Of het nu een virtuele machine instance in Amazon of Google is, of ik heb precies dezelfde hardware nodig. Dat wil zeggen, ik wil de omgeving recreëren. En bij de term omgeving verstaan we de majeur versie van Postgres.
- Het tweede deel is het object van ons onderzoek. Dit is de database. Deze kan op verschillende manieren worden aangemaakt. Ik laat zien hoe.
- Het derde deel is de belasting. Dit is het moeilijkste moment.
- En het vierde deel is wat we controleren, dat wil zeggen waar we mee gaan vergelijken. Stel dat we een of meerdere parameters in de configuratie kunnen veranderen, of we kunnen een index creëren, enzovoort.
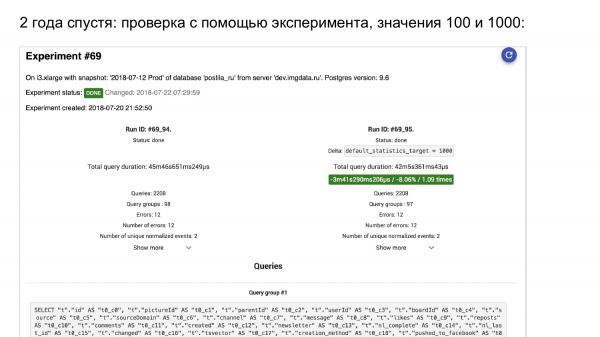
We starten een experiment. Hier is pg_stat_statements. Links is wat er was. Rechts is wat er is geworden.
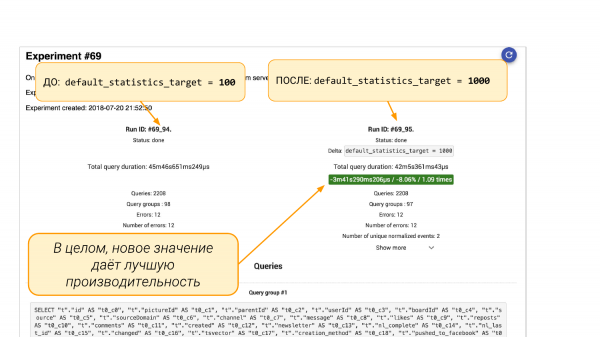
Links is default_statistics_target = 100, rechts = 1 000. We zien dat dit ons heeft geholpen. Over het algemeen is het met 8% verbeterd.
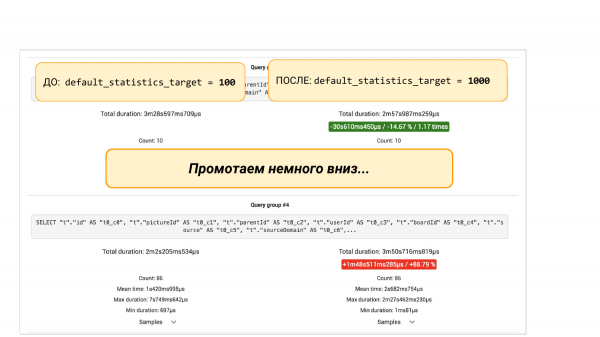
Maar als we naar beneden scrollen, zullen er groepen verzoeken zijn uit pgBadger of pg_stat_statements. Hier zijn er twee opties. We zullen zien dat een bepaalde aanvraag met 88% is gedaald. En hier komt de technische benadering. We kunnen verder graven, omdat het interessant is waarom het is gedaald. We moeten begrijpen wat er met de statistieken was. Waarom meer buckets in de statistiek leiden tot een slechter resultaat.
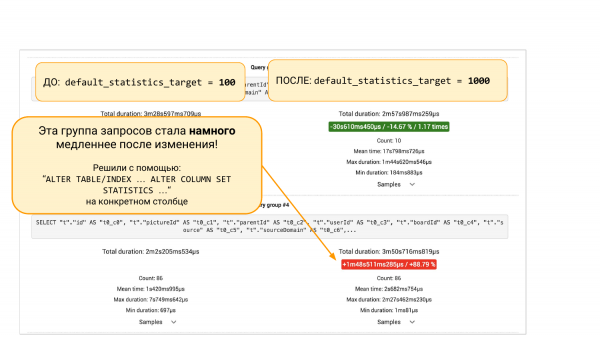
Of we kunnen niet graven, maar 'ALTER TABLE … ALTER COLUMN' doen en het terug naar 100 buckets in de statistiek van deze kolom brengen. En verder kunnen we door een experiment bevestigen dat deze oplossing heeft geholpen. Dat is het. Dit is de technische benadering die ons helpt om het geheel te zien en beslissingen te nemen op basis van data en niet op basis van intuïtie.
Enkele voorbeelden uit andere gebieden. In tests zijn er al vele jaren CI-tests. En geen enkel project zal nog in een gezond verstand zonder automatische tests leven.
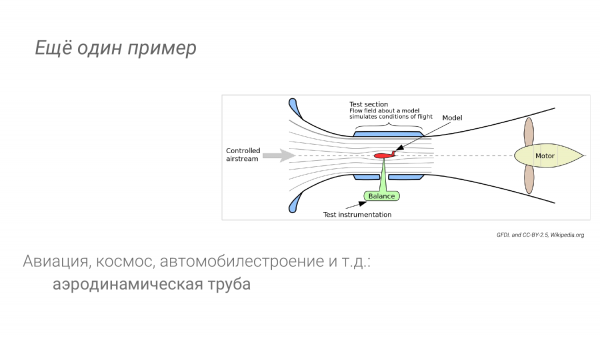
In andere sectoren: in de luchtvaart, in de auto-industrie, wanneer we aerodynamica testen, hebben we ook de mogelijkheid om experimenten uit te voeren. We zullen niets meteen vanuit de tekening de ruimte in lanceren of een auto meteen op de weg brengen. Bijvoorbeeld, er is een aerodynamische tunnel.
Uit observaties in andere sectoren kunnen we conclusies trekken.
Ten eerste hebben we een speciale omgeving. Deze ligt dicht bij productie, maar niet te dicht. Het belangrijkste kenmerk is dat het goedkoop, herhaalbaar en maximaal geautomatiseerd moet zijn. En er moeten speciale middelen zijn voor gedetailleerde analyses.
Waarschijnlijk hebben we, wanneer we het vliegtuig starten en vliegen, minder mogelijkheden om elke millimeter van het vleugeloppervlak te onderzoeken dan in de windtunnel. We hebben meer middelen voor diagnose. We kunnen ons permitteren om meer zware apparatuur aan te schaffen, wat we niet kunnen toestaan op een vliegtuig in de lucht. Hetzelfde geldt voor Postgres. In sommige gevallen kunnen we volledige logboekregistratie van verzoeken inschakelen tijdens experimenten. En dat willen we niet op productie. Misschien schakelen we dit zelfs in met plannen via auto_explain.
En zoals ik al zei, betekent een hoog niveau van automatisering dat we op een knop drukken en het herhalen. Zo zou het moeten zijn, zodat er veel experimenten zijn en dit in een stroom komt.
Nancy CLI – de basis van het "database-lab"
En zo hebben we zo'n ding gemaakt. Dat wil zeggen, ik praatte over deze ideeën in juni, bijna een jaar geleden. En we hebben al in Open Source de zogenaamde Nancy CLI. Dit is de basis om een database-laboratorium op te bouwen.
— Dit is in Open Source, op Gitlab. Je kunt het zeggen, je kunt het proberen. Ik heb een link in de slides gegeven. Je kunt erop klikken en dan heb je over alle parameters.
Natuurlijk is er nog veel in ontwikkeling. Er zijn veel ideeën. Maar dit is al iets wat we praktisch dagelijks toepassen. En wanneer we een idee hebben – wat gebeurt er bij het verwijderen van 40.000.000 regels dat alles vastloopt op IO, dan kunnen we een experiment uitvoeren en het beter bekijken om te begrijpen wat er aan de hand is en proberen dit ter plaatse te corrigeren. Dat wil zeggen, we doen een experiment. Bijvoorbeeld, we draaien iets bij en kijken wat uiteindelijk ontstaat. En we doen dit niet op productie. Dat is de essentie van het idee.
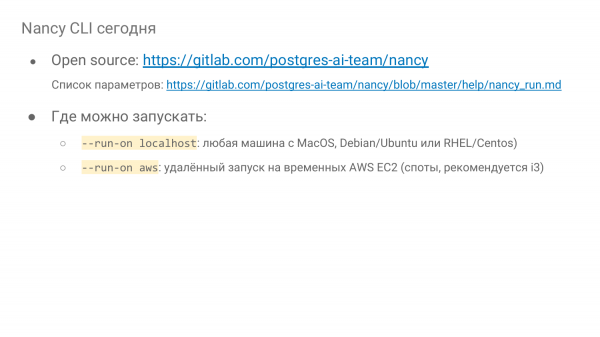
Waar kan dit werken? Dit kan lokaal werken, dat wil zeggen, je kunt dit overal doen, je kunt het zelfs op een MacBook starten. Docker is nodig, laten we gaan. En dat is het. Je kunt het starten in een of andere instance op hardware, of in een virtual machine, waar dan ook.
En er is ook de mogelijkheid om op afstand te starten in Amazon EC2-instance, in spot-instanties. Dit is een geweldige kans. Bijvoorbeeld, gisteren hebben we meer dan 500 experimenten uitgevoerd op een i3-instance, beginnend met de kleinste en eindigend met de i3-16-xlarge. En die 500 experimenten kostten ons 64 dollar. Elk experiment duurde 15 minuten. Dus door het gebruik van spot-instanties is dit erg goedkoop – 70% korting, per seconde gefactureerd door Amazon. Je kunt heel veel doen. Je kunt echt onderzoek doen.
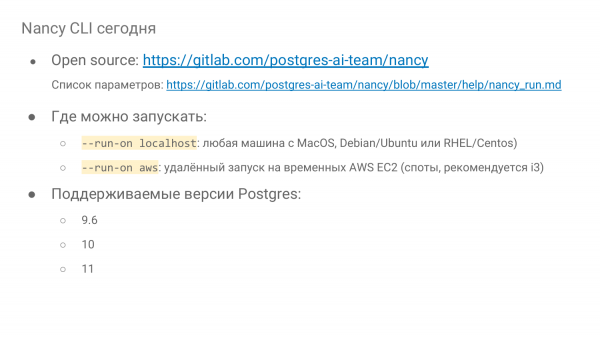
En er worden drie hoofdversies van PostgreSQL ondersteund. Het is niet zo moeilijk om enkele oude versies en de nieuwe versie 12 ook te verbeteren.
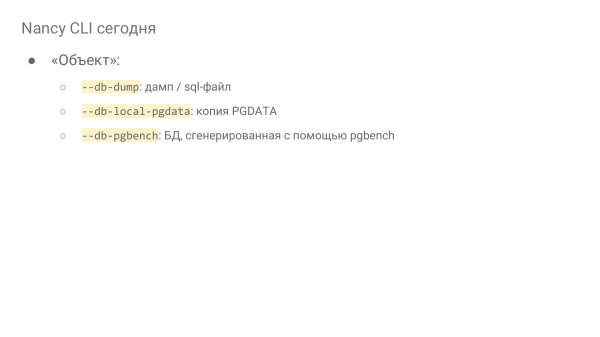
We kunnen het object op drie manieren definiëren. Dit zijn:
- Dump/sql-bestand.
- De belangrijkste methode is het klonen van de PGDATA-map. Gewoonlijk wordt dit van de back-upserver gehaald. Als je normale binaire back-ups hebt, kun je daar klonen maken. Als je cloud-diensten hebt, zal het cloudbedrijf zoals Amazon of Google dit voor je doen. Dit is de belangrijkste manier om klonen van echte productie te maken. Op deze manier zetten we het op.
- De laatste methode is geschikt voor onderzoek, wanneer je wilt begrijpen hoe iets in PostgreSQL werkt. Dit is pgbench. Je kunt dit genereren met pgbench. Dit is gewoon één optie ‘db-pgbench’. Je geeft aan welke schaal. En alles wordt in de cloud gegenereerd, zoals gezegd.
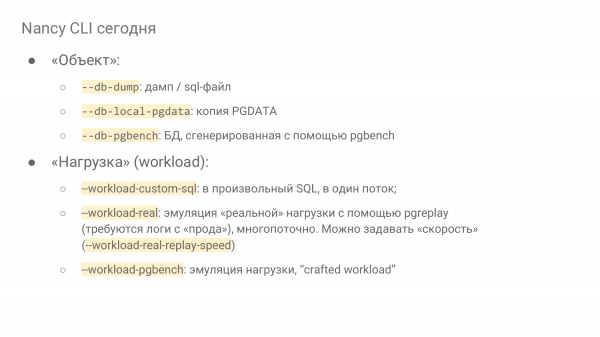
En de belasting:
- We kunnen de belasting in één enkele SQL-stroom uitvoeren. Dit is de meest primitieve methode.
- Of we kunnen de belasting emuleren. En we kunnen deze vooral als volgt emuleren. We moeten alle logs verzamelen. En dat is pijnlijk. Ik zal laten zien waarom. En met behulp van pgreplay, dat in Nancy is ingebouwd, spelen we dit af.
- Of een andere optie. De zogenaamde 'craft' belasting, die we met enige inspanning maken. Door onze huidige belasting op het productie-systeem te analyseren, extraheren we de topgroepen van aanvragen. En met pgbench kunnen we deze belasting in het laboratorium emuleren.
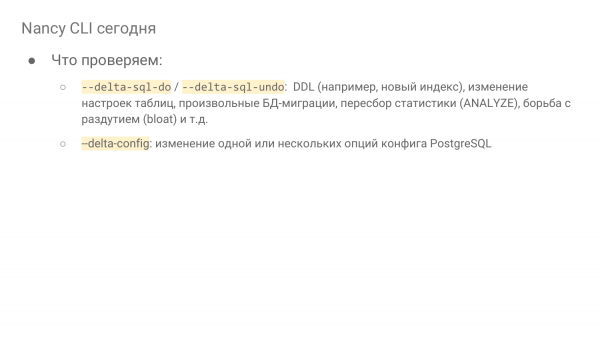
- Of we moeten een bepaalde SQL uitvoeren, d.w.z. controleren we een migratie, maken we een index, voeren we ANALYZE uit. En we kijken naar de situatie voor de vacuum en erna. In het algemeen, elke SQL.
- Ofwel, we veranderen een of meerdere parameters in de configuratie. We kunnen vragen om bijvoorbeeld 100 waarden in Amazon te controleren voor onze terabyte database. En binnen een paar uur heeft u het resultaat. Gewoonlijk zal een terabyte database een paar uur in beslag nemen om te implementeren. Maar in de ontwikkeling is er een patch, we hebben de mogelijkheid om een serie uit te voeren, dat wil zeggen dat u dezelfde pgdata sequentieel op dezelfde server kunt gebruiken en controles kunt uitvoeren. Postgres zal opnieuw opstarten, caches worden gewist. En u kunt de belasting aansteken.
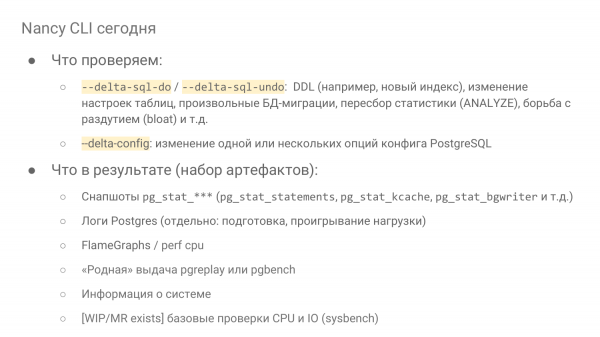
- Er komt een directory binnen met allerlei bestanden, variërend van snapshots pgstat***. En daar is het meest interessante – pg_stat_statements, pg_stat_kcacke. Dit zijn twee extensies die de aanvragen analyseren. En pg_stat_bgwriter bevat niet alleen de pgwriter-statistieken, maar ook gegevens over checkpoints en hoe de backends zelf de vuile buffers verdringen. En dat is allemaal interessant om te bekijken. Bijvoorbeeld, wanneer we shared_buffers instellen, is het heel interessant om te zien hoeveel er verdrongen is.
- Ook de Postgres-logs komen binnen. Twee logs – de voorbereiding log en de uitvoeringslog van de belasting.
- Een relatief nieuwe functie – dat zijn FlameGraphs.
- Als u ook pgreplay of pgbench varianten van belastingweergave heeft gebruikt, komt hun eigen output er ook aan. En u zult de latency en TPS zien. U kunt begrijpen hoe ze dit zagen.
- Informatie over het systeem.
- Basiscontroles van CPU en IO. Dit is meer voor EC2-instanties in Amazon wanneer u 100 identieke instanties wilt opstarten en daar 100 verschillende runs wilt uitvoeren, dan heeft u 10.000 experimenten. En u moet ervoor zorgen dat u geen defecte instantie hebt die al door iemand anders wordt onderdrukt. Op deze hardware zijn er andere actieve processen en u heeft weinig middelen over. Zulke resultaten kunnen beter worden weggelaten. Juist met behulp van sysbench van Alexey Kopytov doen we een aantal korte controles die binnenkomen en vergeleken kunnen worden met anderen, dat wil zeggen dat u zult begrijpen hoe de CPU zich gedraagt en hoe IO zich gedraagt.
Wat zijn de technische complicaties aan de hand van verschillende bedrijven?
Stel dat we een echte belasting met behulp van logs willen herhalen. Een geweldig idee, als dit is geschreven op Open Source pgreplay. We gebruiken het. Maar om het goed te laten werken, moet u volledige logging van aanvragen met parameters en timing inschakelen.
Er zijn enkele complicaties met betrekking tot duration en timestamp. We laten deze keuken helemaal achterwege. De belangrijkste vraag is: kunt u zich dit veroorloven of niet?
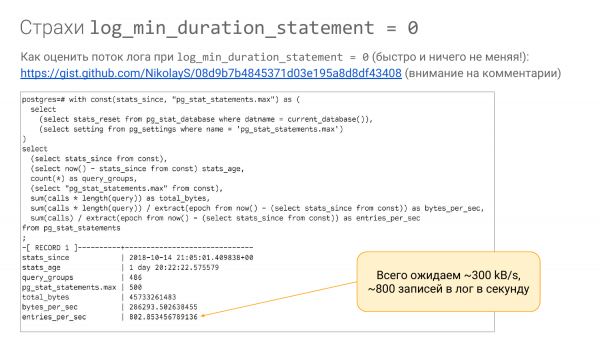
Het probleem is dat dit mogelijk niet beschikbaar is. U moet eerst begrijpen welk logboek er geschreven zal worden. Als u pg_stat_statements heeft, kunt u met deze query (de link zal beschikbaar zijn in de slides) begrijpen hoeveel bytes er ongeveer per seconde zullen worden geschreven.
We kijken naar de lengte van de query. We negeren het feit dat er geen parameters zijn, maar we weten de lengte van de query en hoeveel keer per seconde deze werd uitgevoerd. Op deze manier kunnen we inschatten hoeveel bytes er ongeveer per seconde zijn. We kunnen ons vergissen met een factor twee, maar de volgorde van grootte begrijpen we zeker op deze manier.
We kunnen zien dat deze query 802 keer per seconde wordt uitgevoerd. En we zien dat bytes_per sec ongeveer 300 kB/s zal zijn. En over het algemeen kunnen we zo'n stroom ons veroorloven.
Maar! Het probleem is dat er verschillende loggingsystemen zijn. En standaard hebben mensen meestal 'syslog'.
En als u syslog heeft, kan het eruitzien zoals dit. We zullen pgbench nemen, de query-logging inschakelen en kijken wat er gebeurt.
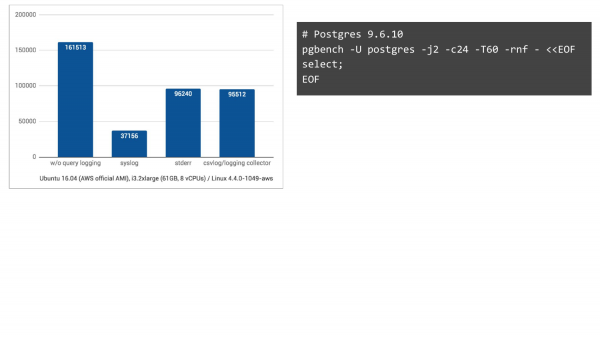
Zonder logging staat de linkerkolom. We hadden 161.000 TPS. Met syslog – in Ubuntu 16.04 op Amazon hebben we 37.000 TPS. En als we overschakelen naar twee andere loggingmethoden, zal de situatie veel beter zijn. Dat wil zeggen, we verwachtten dat het zou dalen, maar niet zo veel.
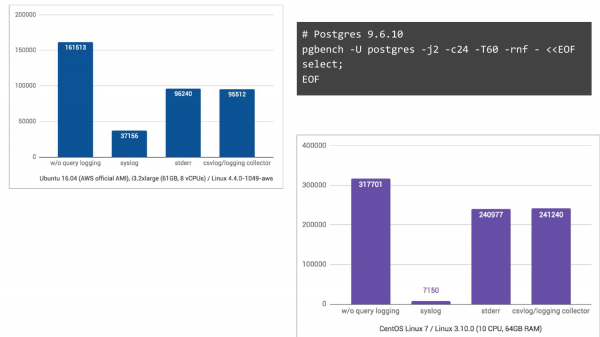
En op CentOS 7, waar journald nog betrokken is en logs in een binair formaat voor gemakkelijk zoeken omzet, doen we 44 keer minder TPS.
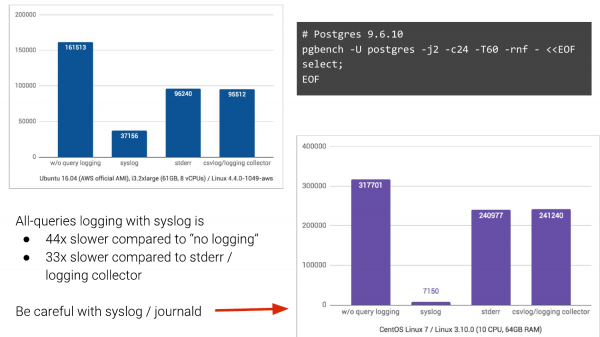
En dit is wat mensen ervaren. En vaak is het in bedrijven, vooral grote, erg moeilijk om dit te veranderen. Als u kunt overstappen van syslog, doe dat dan alsjeblieft.
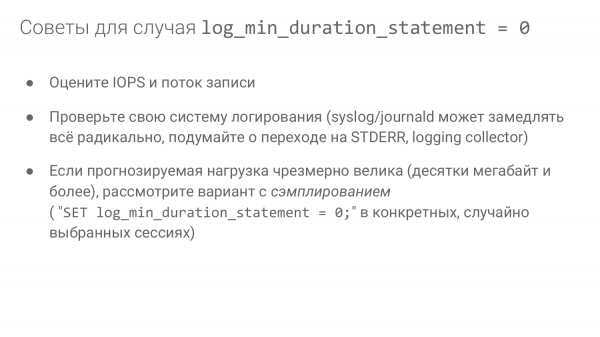
- Beoordeel de IOPS en de schrijfsnelheid.
- Controleer uw loggingsysteem.
- Als de verwachte belasting buitensporig hoog is, overweeg dan om te sample.
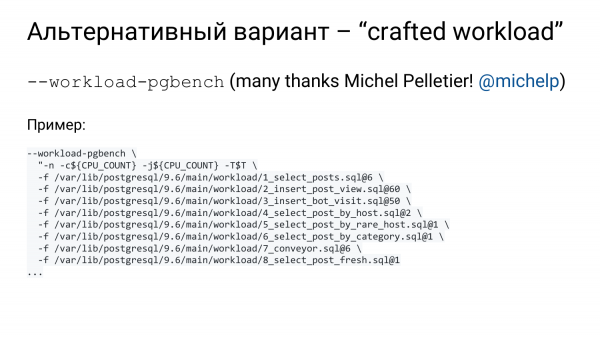
We hebben pg_stat_statements. Zoals ik al zei, moet dit absoluut aanwezig zijn. We kunnen elke groep queries op een speciale manier beschrijven in een bestand. En vervolgens kunnen we een zeer handige functie in pgbench gebruiken – de mogelijkheid om meerdere bestanden door te geven met de optie '-f'.
Hij begrijpt veel "-f". En je kunt met behulp van "@" aan het einde aangeven welk percentage van elk bestand moet worden uitgevoerd. Dat wil zeggen, we kunnen zeggen dat dit in 10% van de gevallen moet worden uitgevoerd en dit in 20%. En dat brengt ons dichter bij wat we op productie zien.
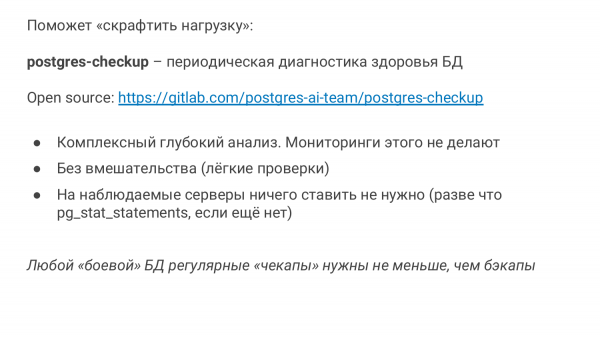
Maar hoe weten we wat we op productie hebben? Welk percentage van wat? Hier gaan we een beetje afwijken. We hebben nog een ander product. . Het is ook een database in Open Source. En we zijn dit momenteel actief aan het ontwikkelen.
Het is ontstaan om iets andere redenen. Omdat monitoring onvoldoende is. Dat wil zeggen, je komt, kijkt naar de database, kijkt naar de problemen die er zijn. En als regel maak je een health_check. Als je een ervaren DBA bent, dan doe je een health_check. Je kijkt naar het gebruik van indexen enzovoort. Als je OKmeter hebt, is dat geweldig. Dit is een geweldige monitoring tool voor Postgres. OKmeter.io – alstublieft, installeer het, het is heel goed gemaakt. Het is betaald.
Als je het niet hebt, dan heb je meestal weinig. Monitoring biedt meestal CPU, IO en dat met voorbehoud, en dat is alles. En we hebben meer nodig. We moeten kunnen zien hoe autovacuum werkt, hoe checkpoint werkt, in IO moeten we checkpoint scheiden van bgwriter en van backends, enzovoort.
Het probleem is dat wanneer je een groot bedrijf helpt, ze niets snel kunnen implementeren. Ze kunnen OKmeter niet snel kopen. Misschien kopen ze het over zes maanden. Ze kunnen niet snel bepaalde pakketten installeren.
En we kregen het idee dat we zo'n speciaal hulpmiddel nodig hadden dat niets vereist bij de installatie, dat wil zeggen, je hoeft niets op productie te installeren. Je installeert het op je laptop, of op een observing server vanwaar je het gaat uitvoeren. En het zal veel analyseren: zowel het besturingssysteem, het bestandssysteem, als Postgres zelf, door enkele lichte queries uit te voeren die je direct op productie kunt draaien zonder dat het uitvalt.
We hebben het Postgres-checkup genoemd. Medisch gezien is het een regelmatige gezondheidscontrole. In de autobezigheid is het zoals een onderhoudsbeurt. Je doet elke zes maanden of een jaar een onderhoudsbeurt voor je auto, afhankelijk van het merk. Maar doe je een onderhoudsbeurt voor je database? Dat wil zeggen, doe je regelmatig een grondige inspectie? Dat moet je doen. Als je backups maakt, zorg dan ook voor een checkup, het is minstens zo belangrijk.
En we hebben zo'n tool. Het is pas drie maanden geleden actief begonnen te ontstaan. Het is nog jong, maar het heeft al veel te bieden.
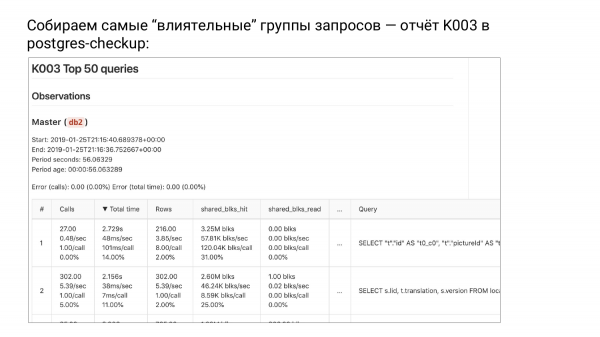
We verzamelen de meest 'invloedrijke' zoekopdrachtgroepen - rapport K003 in Postgres-checkup
En daar is een groep rapporten K. Drie rapporten tot nu toe. En er is zo'n rapport K003. Daar staat de bovenkant van pg_stat_statements, gesorteerd op total_time.
Wanneer we de zoekopdrachtgroepen sorteren op total_time, zien we bovenaan een groep die ons systeem het meest belast, dat wil zeggen, die meer middelen verbruikt. Waarom noem ik het zoekopdrachtgroepen? Omdat we de parameters hebben weggelaten. Dit zijn al geen zoekopdrachten meer, maar zoekopdrachtgroepen, dat wil zeggen, ze zijn geabstraheerd.
En als we van boven naar beneden optimaliseren, verlichten we onze middelen en stellen we het moment uit waarop we een upgrade moeten uitvoeren. Dit is een uitstekende manier om geld te besparen.
Misschien is dit niet de beste manier als het gaat om gebruikerszorg, omdat we misschien zeldzame, maar zeer vervelende gevallen niet zien, waarin iemand 15 seconden heeft gewacht. Samen zijn ze zo zeldzaam dat we ze niet opmerken, maar ondertussen zijn we bezig met onze middelen.
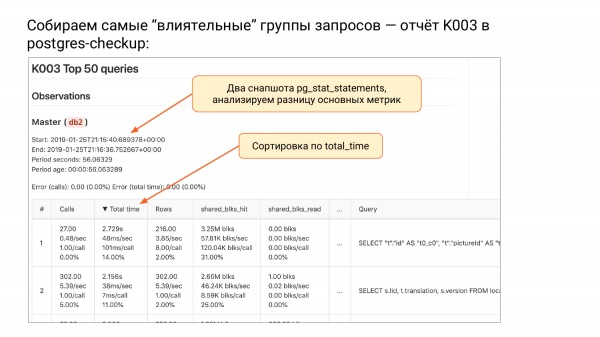
Wat is er gebeurd in deze tabel? We hebben twee snapshots gemaakt. Postgres_checkup maakt een delta voor elke metriek: total-time, calls, rows, shared_blks_read, enzovoort. Dat is alles, de delta is berekend. Het grote probleem met pg_stat_statements is dat het niet onthoudt wanneer het is gereset. Als pg_stat_database zich dat herinnert, dan doet pg_stat_statements dat niet. Je ziet daar het getal 1.000.000, maar waar we dat vandaan hebben, weten we niet.
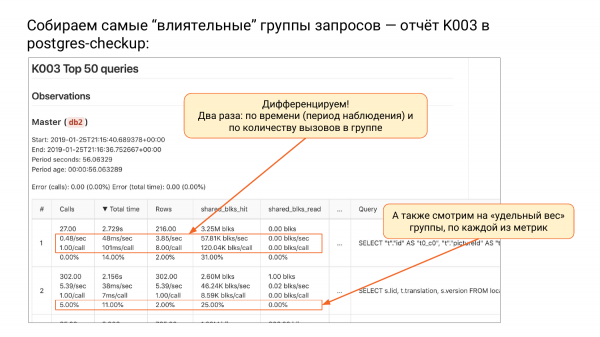
Hier weten we het, hier hebben we twee snapshots. We weten dat de delta in dit geval 56 seconden was. Een zeer korte periode. Gesorteerd op total_time. En vervolgens kunnen we differentiëren, dat wil zeggen, we delen alle metriek door de duur. Als we elke metriek door de duur delen, krijgen we het aantal oproepen per seconde.
Verder is total_time per seconde mijn favoriete metriek. Dit wordt gemeten in seconden, per seconde, dat wil zeggen, hoeveel seconden ons systeem nodig had om deze groep zoekopdrachten per seconde uit te voeren. Als je daar meer dan één seconde per seconde ziet, betekent dat dat je meer dan één kern nodig had. Dit is een zeer goede metriek. Je kunt begrijpen dat deze persoon bijvoorbeeld minimaal drie kernen nodig heeft.
Dit is onze knowhow, ik heb zoiets nergens gezien. Let op - dit is een heel simpele zaak - seconde per seconde. Soms, wanneer je CPU 100% is, dan dertig minuten per seconde, dat wil zeggen, je hebt dertig minuten alleen aan deze zoekopdrachten besteed.
Daarna zien we rijen per seconde. We weten hoeveel rijen per seconde er is teruggegeven.
En daarna is er ook iets interessants. Hoeveel shared_buffers we per seconde uit de shared_buffers hebben gelezen. Hits waren er al, en de rijen hebben we uit de systeemcache gehaald of van de schijf. De eerste optie is snel, de tweede kan snel zijn, maar dat ligt aan de situatie.
En de tweede manier van differentiatie is dat we het aantal verzoeken in deze groep delen. In de tweede kolom heeft u altijd één verzoek gedeeld door het verzoek. En dan wordt het interessant - hoeveel milliseconden er in dit verzoek zaten. We weten hoe dit verzoek zich gemiddeld gedraagt. 101 milliseconden waren er nodig voor elke aanvraag. Dit is een traditionele metric die we nodig hebben voor ons begrip.
Hoeveel rijen elke aanvraag gemiddeld heeft teruggegeven. We zien dat deze groep 8 teruggeeft. Hoeveel er gemiddeld uit de cache is gehaald en gelezen. We zien dat alles mooi gecached is. Heerlijke hits voor de eerste groep.
En de vierde subregel in elke rij is hoeveel procent van het totaal aantal is. We hebben calls. Stel, 1.000.000. En we kunnen begrijpen welke bijdrage deze groep levert. We zien dat in dit geval de eerste groep minder dan 0,01 % bijdraagt. Dit betekent dat het zo langzaam is dat we het niet in het algemene plaatje zien. En de tweede groep – 5 % van de oproepen. Dat wil zeggen, 5 % van alle oproepen komt van de tweede groep.
Wat betreft total_time is ook interessant. Voor de eerste groep verzoeken hebben we 14 % van de totale tijd besteed. En voor de tweede – 11 %, enzovoort.
Ik ga niet in detail ingaan, maar er zijn nuances. We tonen de fout bovenaan, omdat wanneer we vergelijken, snapshots kunnen verschuiven, dat wil zeggen sommige verzoeken kunnen eruit vallen en in de tweede zijn ze er mogelijk niet meer, terwijl sommige nieuwe kunnen verschijnen. En we berekenen daar de fout. Als u 0 ziet, is dat goed. Dat betekent dat er geen fouten zijn. Als de foutpercentage tot 20 % is, is dat OK.
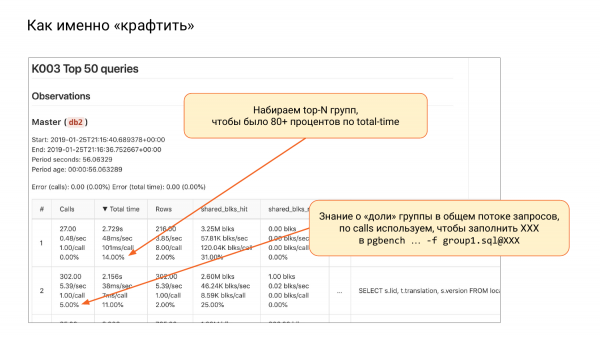
Daarna keren we terug naar ons onderwerp. We moeten de workload creëren. We gaan van boven naar beneden totdat we 80 % of 90 % hebben verzameld. Meestal zijn dit 10-20 groepen. En we maken bestanden voor pgbench. Daar gebruiken we random. Soms lukt dit helaas niet. En in Postgres 12 zullen er meer mogelijkheden zijn om deze aanpak te gebruiken.
En zo verzamelen we 80-90% van de total_time. Wat moeten we verder invullen na «@»? We kijken naar de calls, zien hoeveel procent en begrijpen dat we hier zoveel procent moeten hebben. Uit deze percentages kunnen we bepalen hoe we elk van de bestanden moeten balanceren. Daarna gebruiken we pgbench en gaan we aan het werk.
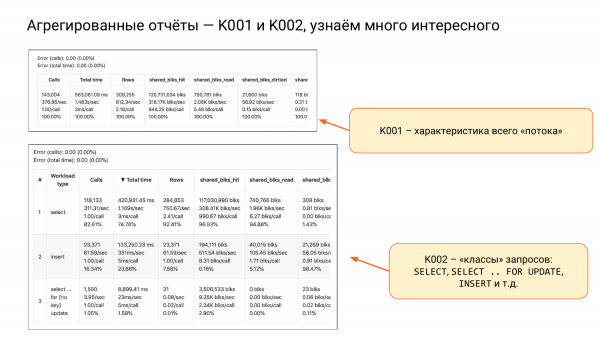
We hebben ook K001 en K002.
K001 is een grote string met vier substrings. Dit is een kenmerk van onze totale belasting. Kijk naar de tweede kolom en de tweede substring. We zien dat het ongeveer anderhalve seconde per seconde is, dat betekent dat als er twee kernen zijn, het goed zal zijn. Dat zal ongeveer 75% bezetting zijn. En het zal zo werken. Als we 10 kernen hebben, kunnen we ons helemaal ontspannen. Zo kunnen we de middelen inschatten.
K002 - dit noem ik de klassen van verzoeken, dat wil zeggen SELECT, INSERT, UPDATE, DELETE. En apart SELECT FOR UPDATE, omdat deze vergrendelt.
En hier kunnen we concluderen dat gewone SELECT-lezingen 82% van alle oproepen vormen, maar tegelijkertijd 74% van de total_time. Dat wil zeggen, ze worden vaak opgeroepen, maar verbruiken minder middelen.
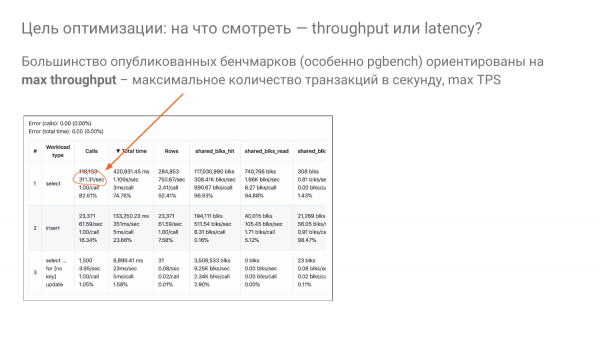
En terug naar de vraag: "Hoe kiezen we de shared_buffers op de juiste manier?" Ik zie dat de meeste benchmarks zijn gebaseerd op het idee – laten we kijken naar de throughput, dat wil zeggen, wat de doorvoer zal zijn. Dit wordt meestal gemeten in TPS of QPS.
En we proberen zoveel mogelijk transacties per seconde uit de machine te halen met tuningparameters. Hier is het 311 per seconde voor select.
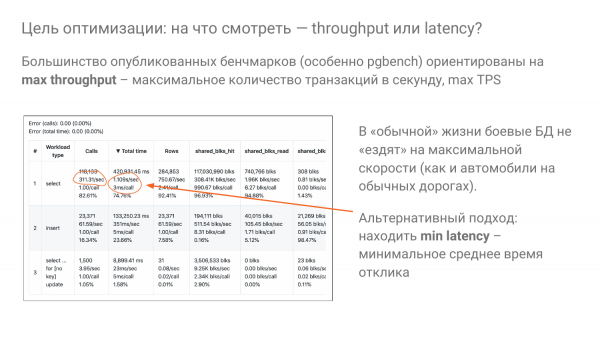
Maar niemand rijdt met volledige snelheid van huis naar werk en terug. Dat zou dom zijn. Hetzelfde geldt voor databases. We moeten niet op volle snelheid rijden, en niemand doet dat. Niemand leeft in een productieomgeving met 100% CPU. Hoewel, misschien leeft iemand dat, maar het is niet goed.
Het idee is dat we meestal op ongeveer 20% van de mogelijkheden rijden, bij voorkeur niet hoger dan 50%. En we proberen de responstijd voornamelijk voor onze gebruikers te optimaliseren. Dat wil zeggen, we moeten onze handelingen zo uitvoeren dat er minimale latency is bij 20%-snelheid, voorwaardelijk. Dit is een idee dat we ook proberen te gebruiken in onze experimenten.
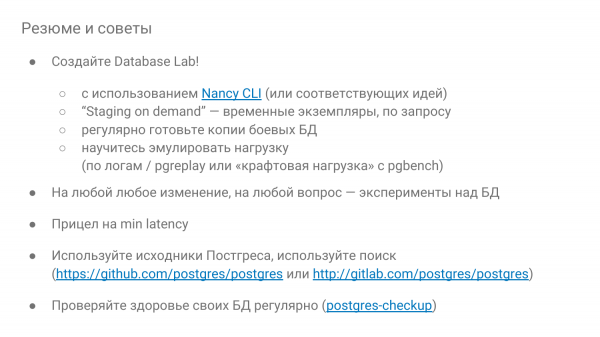
En om af te sluiten, aanbevelingen:
- Zorg ervoor dat je Database Lab probeert.
- Indien mogelijk, maak het on demand, zodat het voor enige tijd kan worden uitgerold – spelen en weer weggooien. Als je in de cloud bent, is dit vanzelfsprekend, dat wil zeggen, zorg voor veel standing.
- Wees nieuwsgierig. En als er iets niet klopt, test het dan met experimenten om te zien hoe het zich gedraagt. Nancy kan worden gebruikt om jezelf op te leiden en om te verifiëren hoe de database werkt.
- En mik op de minimale responstijd.
- Wees niet bang voor de Postgres-bronbestanden. Wanneer je met de bronbestanden werkt, moet je Engels kennen. Er zijn veel opmerkingen, alles is goed uitgelegd.
- En controleer regelmatig de gezondheid van de database, minstens één keer in de drie maanden handmatig of met Postgres-checkup.
Vragen
Heel erg bedankt! Het is een erg interessant onderwerp.
Twee dingen.
Ja, twee dingen. Ik begrijp alleen niet helemaal. Wanneer we met Nancy werken, kunnen we dan slechts één parameter aanpassen of een hele groep?
We hebben de delta-configuratieparameter. Je kunt er zoveel als je wilt tegelijk op aanpassen. Maar je moet begrijpen dat als je veel verandert, je verkeerde conclusies kunt trekken.
Ja. Waarom vroeg ik dat? Omdat het moeilijk is om experimenten uit te voeren als je maar één parameter hebt. Je past het aan, kijkt hoe het werkt. Stel het in. Dan begin je met de volgende.
Je kunt tegelijkertijd aanpassen, maar het hangt natuurlijk van de situatie af. Maar het is beter om één idee te testen. Gisteren hadden we een idee. We hadden een zeer vergelijkbare situatie. Er waren twee configuraties. En we konden niet begrijpen waarom er een groot verschil was. En het idee kwam op dat we dichotomie moesten gebruiken om geleidelijk te begrijpen en het verschil te vinden. Je kunt meteen de helft van de parameters gelijk maken, daarna een kwart, enzovoort. Het is heel flexibel.
En ik heb nog een vraag. Het project is nog jong en in ontwikkeling. Is de documentatie al klaar, is er een gedetailleerde beschrijving?
Ik heb daar speciaal een link gemaakt naar de beschrijving van de parameters. Dat is er. Maar er is nog veel niet beschikbaar. Ik ben op zoek naar gelijkgestemden. En ik vind ze wanneer ik spreek. Het is echt geweldig. Iemand werkt al met mij, iemand heeft geholpen en iets gedaan. En als je geïnteresseerd bent in dit onderwerp, geef dan feedback – wat ontbreekt.
Als we het laboratorium opzetten, misschien krijgen we feedback. We zullen zien. Bedankt!
Hallo! Bedankt voor de presentatie! Ik zag dat er ondersteuning is voor Amazon. Is er ondersteuning voor GSP gepland?
Goede vraag. We zijn begonnen met de implementatie en hebben het voorlopig stopgezet omdat we willen besparen. Dus, er is ondersteuning via run on localhost. Je kunt zelf een instance creëren en lokaal werken. Trouwens, dat doen wij ook. Bij Getlab doe ik het zo, daar op GSP. Maar we zien voor nu geen nut in zo'n orkestratie, omdat Google geen goedkope spot-aanbiedingen heeft. Er zijn wel ??? instances, maar die hebben beperkingen. Ten eerste hebben ze altijd maar 70% korting en je kunt niet met de prijs spelen. Bij spots verhogen we de prijs met 5-10% om de kans te verkleinen dat je wordt gekilled. Dus, bij spots bespaar je, maar je kunt op elk moment verwijderd worden. Als je de prijs iets hoger maakt dan anderen, word je later verwijderd. Google heeft een totaal andere specificiteit. En er is nog een zeer ongewenste beperking – ze leven maar 24 uur. Soms willen we echter 5 dagen een experiment draaien. Maar met spots is dat mogelijk, spots kunnen soms maanden meegaan.
Hallo! Dank voor de presentatie! Je noemde de checkup. Hoe bereken je de fouten in stat_statements?
Dat is een uitstekende vraag. Ik kan het heel gedetailleerd tonen en uitleggen. Kort samengevat: we kijken hoe de set van querygroepen zich heeft ontwikkeld: hoeveel er verdwenen zijn en hoeveel nieuwe zijn verschenen. Daarna kijken we naar twee metrics: total_time en calls, dus daar zijn twee fouten. We kijken ook naar de bijdrage van de groepen die zijn verdwenen. Er zijn twee subgroepen: de vertrokken en de aangekomen. We bekijken wat hun bijdrage aan het totaal is.
Ben je niet bang dat het daar twee of drie keer wordt doorlopen tussen de snapshots?
Dus, hebben ze zich opnieuw geregistreerd of zo?
Bijvoorbeeld, deze query is al eens verdrongen, toen kwam hij terug en werd weer verdrongen, toen kwam hij nog een keer terug en werd weer verdrongen. En je hebt hier iets berekend, maar waar is dit alles?
Goede vraag, dat moeten we bekijken.
Ik heb iets soortgelijks gedaan. Natuurlijk eenvoudiger en ik deed het alleen. Maar ik moest reset stat_statements uitvoeren en me oriënteren op het moment van de snapshot, zodat er minder dan een bepaald percentage was, zodat het nog niet het plafond had bereikt van hoeveel stat_statements kan accumuleren. En ik baseer me erop dat waarschijnlijk niets is verdrongen.
Ja- ja.
Maar ik begrijp niet hoe je het op een andere manier betrouwbaar kunt doen.
Helaas weet ik niet meer zeker of we daar de tekst van de query of de queryid uit pg_stat_statements gebruiken en daarop baseren. Als we ons op de queryid baseren, vergelijken we in theorie vergelijkbare dingen.
Nee, hij kan meerdere keren worden verdrongen tussen snapshots en weer terugkomen.
Met dit id?
Ja.
We zullen dit onderzoeken. Goede vraag. We moeten het bestuderen. Maar tot nu toe, wat we zien, staat er of 0 geschreven...
Dit is natuurlijk een zeldzaam geval, maar ik schrok toen ik hoorde dat stat_statements daar kan worden verdrongen.
In Pg_stat_statements kan er veel zijn. We hebben ervaren dat als je track_utility = aan hebt staan, jouw sets ook worden getracked.
Ja, natuurlijk.
En als je Java Hibernate hebt, dat willekeurig is, begint de hashtabel te vergrendelen. En zodra je een zeer zware applicatie uitschakelt, heb je 50-100 groepen. En dat is min of meer stabiel. Een van de manieren om dit tegen te gaan is om pg_stat_statements.max te verhogen.
Ja, maar je moet weten hoe ver. En je moet er op de een of andere manier op letten. Dat doe ik ook. Dus, ik heb pg_stat_statements.max. En ik kijk of ik bij het snapshot nog maar 70% heb bereikt. Goed, dat betekent dat we niets hebben verloren. We resetten en verzamelen opnieuw. Als het volgende snapshot minder dan 70 is, betekent dat waarschijnlijk dat we opnieuw niets hebben verloren.
Ja. Standaard is het nu 5.000. En veel mensen hebben daar genoeg aan.
Normaal gesproken – ja.
Video:
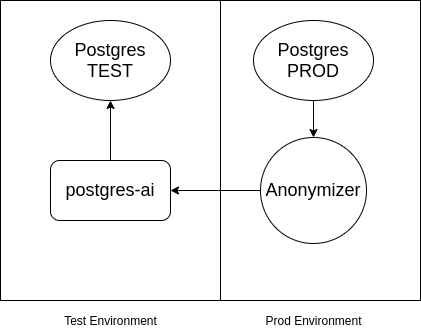
P.S. Ik voeg toe dat als er gevoelige gegevens in Postgres zijn die niet in de testomgeving mogen komen, je gebruik kunt maken van . Het schema is ongeveer als volgt:
Bron: habr.com
