

Ik heb een nieuwe project A Simple GPU Hash Table gepost op Github .
Dus de snelheid op de laptop is ongeveer 300 miljoen invoegingen/seconde en 500 miljoen verwijderingen/seconde.
De tabel is geschreven in CUDA, hoewel dezelfde methode kan worden toegepast op HLSL of GLSL. De implementatie heeft enkele beperkingen die een hoge prestatie op de grafische kaart waarborgen:
Er worden alleen 32-bits sleutels en bijbehorende waarden verwerkt.
- De hash-tabel heeft een vaste grootte.
- En die grootte moet een macht van twee zijn.
- Voor sleutels en waarden moet een eenvoudige scheidingsteken (in de gegeven code is dit 0xffffffff) worden gereserveerd.
Lock-free hash-tabel
De hash-tabel maakt gebruik van open adressering met
lineaire probing KeyValue struct KeyValue { uint32_t key; uint32_t value; };:
De grootte van de tabel is een kracht van twee en geen priemgetal, omdat voor het toepassen van pow2/AND-maskers slechts één snelle instructie nodig is, terwijl de modulusoperator veel langzamer werkt. Dit is belangrijk in het geval van lineaire probing, omdat de index van de slot tijdens het lineaire zoeken naar elke slot moet worden gewikkeld. En daarom wordt de kostprijs van de modulusoperatie aan elke slot toegevoegd.
De tabel slaat alleen de sleutel en waarde voor elk element op, en geen hash van de sleutel. Aangezien de tabel alleen 32-bits sleutels opslaat, wordt de hash erg snel berekend. De gegeven code gebruikt de Murmur3-hash, die slechts een paar verschuivingen, XOR's en vermenigvuldigingen uitvoert.
De tabel bevat alleen een sleutel en waarde voor elk element, en geen hash van de sleutel. Aangezien de tabel alleen 32-bits sleutels opslaat, wordt de hash zeer snel berekend. De gegeven code maakt gebruik van de Murmur3-hash, die slechts enkele verschuivingen, XOR's en vermenigvuldigingen uitvoert.
In de hashtabel wordt een blokkeringstechniek toegepast die onafhankelijk is van de volgorde van plaatsing in het geheugen. Zelfs als sommige schrijfoperaties de volgorde van andere operaties verstoren, behoudt de hashtabel toch een correcte status. Hierover zullen we hieronder meer spreken. Deze techniek werkt uitstekend met grafische kaarten, waar duizenden threads concurrerend worden uitgevoerd.
Sleutels en waarden in de hashtabel worden geïnitialiseerd als leeg.
De code kan worden aangepast zodat deze zowel 64-bits sleutels als waarden kan verwerken. Voor sleutels zijn atomische lees-, schrijf- en vergelijk-en-vervangoperaties (compare-and-swap) vereist. Voor waarden zijn atomische lees- en schrijfoperaties nodig. Gelukkig zijn in CUDA lees-schrijfoperaties voor 32- en 64-bits waarden atomair, zolang ze op natuurlijke wijze zijn uitgelijnd (zie ), en moderne grafische kaarten ondersteunen 64-bits atomische vergelijk-en-vervangoperaties. Natuurlijk zal de prestaties licht afnemen bij de overstap naar 64-bits.
Status van de hashtabel
Elk sleutel-waarde paar in de hashtabel kan één van de vier staten hebben:
- Sleutel en waarde zijn leeg. In deze toestand wordt de hashtabel geïnitialiseerd.
- De sleutel is geschreven, maar de waarde nog niet. Als een andere uitvoeringsthread op dat moment de gegevens leest, krijgt deze een lege waarde terug. Dit is normaal; hetzelfde zou zijn gebeurd als een andere uitvoeringsthread iets eerder had gewerkt, en we spreken over een concurrente datastructuur.
- Zowel de sleutel als de waarde zijn geschreven.
- De waarde is beschikbaar voor andere uitvoeringsthreads, maar de sleutel nog niet. Dit kan gebeuren omdat het programmamodell in CUDA een zwak geordende geheugenschema veronderstelt. Dit is normaal, want bij elke gebeurtenis is de sleutel nog steeds leeg, ook al is de waarde dat niet meer.
Een belangrijk aspect is dat zodra de sleutel in een slot is geschreven, deze niet meer wordt verplaatst — zelfs als de sleutel wordt verwijderd, hier zullen we later over praten.
De code van de hashtabel werkt zelfs met zwak geordende geheugenschema's, waarbij de volgorde van lezen en schrijven naar het geheugen niet bekend is. Wanneer we het hebben over invoegen, zoeken en verwijderen in de hashtabel, onthoud dat elk sleutel-waarde paar zich in één van de vier hierboven beschreven staten bevindt.
Invoegen in de hashtabel
De CUDA-functie die key-value paren in een hashtabel invoegt, ziet er als volgt uit:
void gpu_hashtable_insert(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        uint32_t prev = atomicCAS(&hashtable[slot].key, kEmpty, key);
        if (prev == kEmpty || prev == key)
        {
            hashtable[slot].value = value;
            break;
        }
        slot = (slot + 1) & (kHashTableCapacity-1);
    }
}
Om een sleutel in te voegen, itereert de code door de array van de hashtabel, beginnend bij de hash van de in te voegen sleutel. In elke slot van de array wordt een atomische vergelijkings-en-wisseloperatie uitgevoerd, waarbij de sleutel in die slot wordt vergeleken met leeg. Als er een mismatch wordt gevonden, wordt de sleutel in het slot bijgewerkt naar de in te voegen sleutel, waarna de originele sleutel van het slot wordt geretourneerd. Als deze originele sleutel leeg was of overeenkwam met de in te voegen sleutel, heeft de code een geschikt slot gevonden voor de invoeging en plaatst het de in te voegen waarde in het slot.
Als er in één kernel-aanroep gpu_hashtable_insert() meerdere elementen met dezelfde sleutel zijn, kan een van hun waarden in het slotsleutel worden geschreven. Dit wordt als normaal beschouwd: een van de schrijfoperaties voor de sleutel-waarde tijdens de aanroep zal succesvol zijn, maar omdat dit allemaal parallel plaatsvindt binnen meerdere uitvoeringsstromen, kunnen we niet voorspellen welke schrijfoperatie in het geheugen als laatste zal zijn.
Zoeken in de hashtabel
Code voor het zoeken naar sleutels:
uint32_t gpu_hashtable_lookup(KeyValue* hashtable, uint32_t key)
{
        uint32_t slot = hash(key);

        while (true)
        {
            if (hashtable[slot].key == key)
            {
                return hashtable[slot].value;
            }
            if (hashtable[slot].key == kEmpty)
            {
                return kEmpty;
            }
            slot = (slot + 1) & (kHashTableCapacity - 1);
        }
}
Om de waarde van een sleutel die in de tabel is opgeslagen te vinden, itereert de code door de array, beginnend bij de hash van de gezochte sleutel. In elke slot controleren we of de sleutel degene is die we zoeken, en als dat zo is, retourneren we de waarde. We controleren ook of de sleutel leeg is, en als dat zo is, onderbreken we de zoekoperatie.
Als we de sleutel niet kunnen vinden, retourneert de code een lege waarde.
Al deze zoekoperaties kunnen concurrerend plaatsvinden tijdens invoegingen en verwijderingen. Elk paar in de tabel zal voor de stroom één van de vier hierboven beschreven toestanden hebben.
Verwijderen uit de hashtabel
Code voor het verwijderen van sleutels:
void gpu_hashtable_delete(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        if (hashtable[slot].key == key)
        {
            hashtable[slot].value = kEmpty;
            return;
        }
        if (hashtable[slot].key == kEmpty)
        {
            return;
        }
        slot = (slot + 1) & (kHashTableCapacity - 1);
    }
}
Het verwijderen van een sleutel gebeurt op een ongebruikelijke manier: we laten de sleutel in de tabel staan en markeren de waarde (niet de sleutel zelf) als leeg. Deze code lijkt sterk op lookup(), met als uitzondering dat bij een overeenkomst met de sleutel, de waarde leeg wordt gemaakt.
Zoals eerder vermeld, zodra de sleutel in een slot is geschreven, verplaatst deze niet meer. Zelfs bij het verwijderen van een element uit de tabel blijft de sleutel op zijn plaats; alleen de waarde wordt leeg. Dit betekent dat we geen atomaire schrijfoperatie voor de waarde van het slot hoeven te gebruiken, omdat het niet uitmaakt of de huidige waarde leeg is of niet - het wordt toch leeg.
Het wijzigen van de grootte van de hash-tabel
De grootte van de hash-tabel kan worden gewijzigd door een grotere tabel te maken en de niet-lege elementen uit de oude tabel erin in te voegen. Deze functionaliteit heb ik niet geïmplementeerd, omdat ik de code eenvoudig wilde houden. Bovendien gebeurt geheugenallocatie in CUDA-programma's vaak in de hostcode in plaats van in de CUDA-kernel.
In dit artikel beschrijft hoe een dergelijke vergrendelingsvrije datastructuur kan worden gewijzigd.
Concurrentie
In de bovenstaande codefragmenten verwerken de functies gpu_hashtable_insert(), _lookup() en _delete() één paar sleutel-waarde tegelijk. Daarentegen gpu_hashtable_insert(), _lookup() en _delete() verwerken ze een array van paren parallel, waarbij elk paar in een aparte GPU-uitvoerende draad wordt verwerkt:
// CPU code to invoke the CUDA kernel on the GPU
uint32_t threadblocksize = 1024;
uint32_t gridsize = (numkvs + threadblocksize - 1) / threadblocksize;
gpu_hashtable_insert_kernel<<<gridsize, threadblocksize>>>(hashtable, kvs, numkvs);

// GPU code to process numkvs key/values in parallel
void gpu_hashtable_insert_kernel(KeyValue* hashtable, const KeyValue* kvs, unsigned int numkvs)
{
    unsigned int threadid = blockIdx.x*blockDim.x + threadIdx.x;
    if (threadid < numkvs)
    {
        gpu_hashtable_insert(hashtable, kvs[threadid].key, kvs[threadid].value);
    }
}
Een vergrendelingsvrije hash-tabel ondersteunt gelijktijdige invoegingen, zoekacties en verwijderingen. Aangezien sleutel-waarde paren zich altijd in een van de vier toestanden bevinden en sleutels niet verplaatst worden, garandeert de tabel correctheid, zelfs bij gelijktijdige bewerking van verschillende soorten operaties.
Als we echter een batch van invoegingen en verwijderen gelijktijdig verwerken, en als de invoerarray van paren duplicate sleutels bevat, kunnen we niet voorspellen welke paren "winnen" - die als laatste in de hash-tabel worden geschreven. Stel dat we de invoegcode hebben aangeroepen met de invoerarray van paren A/0 B/1 A/2 C/3 A/4. Wanneer de code klaar is, zullen de paren B/1 en C/3 zeker in de tabel aanwezig zijn, maar daarnaast kan elk van de paren A/0, A/2 of A/4Dit kan een probleem zijn, maar dat hoeft niet — het hangt allemaal af van de toepassing. Je kunt van tevoren weten dat er geen dubbele sleutels in de invoermatrix zijn, of het kan je niet uitmaken welke waarde als laatste is opgeslagen.
Als dit voor jou een probleem is, moet je de dubbele paren scheiden over verschillende systeem CUDA-aanroepen. In CUDA wordt elke operatie met een kernel-aanroep altijd voltooid voordat de volgende kernel-aanroep plaatsvindt (tenzij binnen hetzelfde proces. In verschillende processen worden kernels parallel uitgevoerd). Als in het bovenstaande voorbeeld één kernel wordt aangeroepen met A/0 B/1 A/2 C/3, en een andere met A/4, dan krijgt de sleutel A de waarde 4.
Laten we het nu hebben over de vraag of functies lookup() en delete() een gewone (plain) of variabele (volatile) pointer naar een matrix van paren in een hash-tabel moeten gebruiken. stelt dat:
De compiler kan naar eigen inzicht lees- en schrijfoperaties in globale of gedeelde geheugen optimaliseren … Deze optimalisaties kunnen worden uitgeschakeld met behulp van het sleutelwoord
volatile: … elke referentie naar deze variabele wordt gecompileerd naar een daadwerkelijke lees- of schrijf-instructie in het geheugen.
Overwegingen met betrekking tot correctheid vereisen geen toepassing volatile. Als de uitvoerthread een gecachet waarde gebruikt van een eerdere leesoperatie, betekent dit dat hij een iets verouderde informatie zal gebruiken. Maar het is nog steeds informatie uit de correcte staat van de hash-tabel op een bepaald moment van de kernel-aanroep. Als je de meest actuele informatie nodig hebt, kun je een pointer gebruiken volatile, maar dan zal de prestaties iets worden verminderd: volgens mijn tests — bij het verwijderen van 32 miljoen elementen daalde de snelheid van 500 miljoen verwijderingen/sec naar 450 miljoen verwijderingen/sec.
Prestaties
In de test voor het invoegen van 64 miljoen elementen en het verwijderen van 32 miljoen daarvan was de concurrentie tussen std::unordered_map en de hash-tabel voor GPU eigenlijk niet aanwezig:
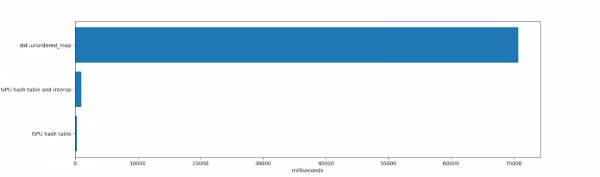
std::unordered_map het kostte 70.691 ms om elementen in te voegen en te verwijderen met daarna vrijgeven van unordered_map (het vrijgeven van miljoenen elementen kost veel tijd, omdat er talrijke geheugentoewijzingen binnen worden uitgevoerd). Eerlijk gezegd, bij unordered_map std:unordered_map std:unordered_map volledig andere beperkingen. Dit is één enkele CPU-executiestroom, die sleutel-waardeparen van elke grootte ondersteunt, goed presteert bij hoge gebruikspercentages en stabiele prestaties toont na talrijke verwijderingen.
De uitvoeringstijd van de hashtabel voor GPU en interprocescommunicatie was 984 ms. Dit omvat de tijd die nodig is om de tabel in het geheugen te plaatsen en deze te verwijderen (een enkele toewijzing van 1 GB geheugen, die enige tijd in CUDA kost), het invoegen en verwijderen van elementen, evenals het itereren door deze elementen. Ook zijn alle kopieën naar en van het videokaartgeheugen meegerekend.
De uitvoering van de hashtabel zelf duurde 271 ms. Dit omvat de tijd die de videokaart heeft besteed aan het invoegen en verwijderen van elementen, en telt de tijd voor kopiëren naar het geheugen en het itereren door de resulterende tabel niet mee. Als de GPU-tabel lang meegaat, of als de hashtabel volledig in het videokaartgeheugen is opgenomen (bijvoorbeeld voor het creëren van een hashtabel die door andere GPU-code zal worden gebruikt, en niet door de centrale processor), dan is het testresultaat relevant.
De hashtabel voor videokaarten toont hoge prestaties dankzij de grote bandbreedte en actieve parallelisering.
Nadelen
De architectuur van de hashtabel heeft een paar problemen waar men rekening mee moet houden:
- Lineaire probing wordt belemmerd door clustering, waardoor sleutels in de tabel niet ideaal worden geplaatst.
- Sleutels worden niet verwijderd met de functie
Verwijder afbeeldingenen verstoppen de tabel na verloop van tijd.
Als resultaat kan de prestatie van de hashtabel geleidelijk afnemen, vooral als deze lang bestaat en er veel invoegen en verwijderen plaatsvinden. Een manier om deze tekortkomingen te verzachten, is door te rehashen naar een nieuwe tabel met een voldoende laag gebruikspercentage en het filteren van verwijderde sleutels bij het rehashen.
Om de beschreven problemen te illustreren, gebruik ik de bovenstaande code om een tabel te creëren met 128 miljoen elementen, en ga ik cyclisch 4 miljoen elementen invoegen totdat 124 miljoen slots zijn gevuld (gebruikspercentage van ongeveer 0,96). Hier zijn de resultaten, elke regel is een aanroep van een CUDA-kernel met het invoegen van 4 miljoen nieuwe elementen in één hashtabel:
gebruikspercentage
De duur van het invoegen van 4 194 304 elementen
0,00
11,608448 ms (361,314798 miljoen sleutels/seconde)
0,03
11,751424 ms (356,918799 miljoen sleutels/seconde)
0,06
11,942592 ms (351,205515 miljoen sleutels/seconde)
0,09
12,081120 ms (347,178429 miljoen sleutels/seconde)
0,12
12,242560 ms (342,600233 miljoen sleutels/seconde)
0,16
12,396448 ms (338,347235 miljoen sleutels/seconde)
0,19
12,533024 ms (334,660176 miljoen sleutels/seconde)
0,22
12,703328 ms (330,173626 miljoen sleutels/seconde)
0,25
12,884512 ms (325,530693 miljoen sleutels/seconde)
0,28
13,033472 ms (321,810182 miljoen sleutels/seconde)
0,31
13,239296 ms (316,807174 miljoen sleutels/seconde)
0,34
13,392448 ms (313,184256 miljoen sleutels/seconde)
0,37
13,624000 ms (307,861434 miljoen sleutels/seconde)
0,41
13,875520 ms (302,280855 miljoen sleutels/seconde)
0,44
14,126528 ms (296,909756 miljoen sleutels/seconde)
0,47
14,399328 ms (291,284699 miljoen sleutels/seconde)
0,50
14,690304 ms (285,515123 miljoen sleutels/seconde)
0,53
15,039136 ms (278,892623 miljoen sleutels/seconde)
0,56
15,478656 ms (270,973402 miljoen sleutels/seconde)
0,59
15,985664 ms (262,379092 miljoen sleutels/seconde)
0,62
16,668673 ms (251,627968 miljoen sleutels/seconde)
0,66
17,587200 ms (238,486174 miljoen sleutels/seconde)
0,69
18,690048 ms (224,413765 miljoen sleutels/seconde)
0,72
20,278816 ms (206,831789 miljoen sleutels/seconde)
0,75
22,545408 ms (186,038058 miljoen sleutels/seconde)
0,78
26,053312 ms (160,989275 miljoen sleutels/seconde)
0,81
31,895008 ms (131,503463 miljoen sleutels/seconde)
0,84
42,103294 ms (99,619378 miljoen sleutels/seconde)
0,87
61,849056 ms (67,815164 miljoen sleutels/seconde)
0,90
105,695999 ms (39,682713 miljoen sleutels/seconde)
0,94
240,204636 ms (17,461378 miljoen sleutels/seconde)
Naarmate de benuttingsgraad stijgt, neemt de prestaties af. Dit is in de meeste gevallen ongewenst. Als een applicatie elementen in een tabel invoegt en deze vervolgens weggooit (bijvoorbeeld bij het tellen van woorden in een boek), dan is dat geen probleem. Maar als een applicatie een langdurige hashtabel gebruikt (bijvoorbeeld in een grafisch bewerkingsprogramma om niet-lege delen van afbeeldingen op te slaan, wanneer de gebruiker vaak informatie invoegt en verwijdert), dan kan dit gedrag ongewenst zijn.
En ik heb de doorzoekdiepte van de hashtabel gemeten na 64 miljoen invoegen (benuttingsgraad 0,5). De gemiddelde diepte was 0,4774, zodat de meeste sleutels zich in ofwel de beste mogelijke slots bevonden, of slechts één slot van de beste positie. De maximale doorzoekdiepte was 60.
Vervolgens heb ik de doorzoekdiepte gemeten in een tabel met 124 miljoen invoegen (benuttingsgraad 0,97). De gemiddelde diepte was al 10,1757, en de maximale - 6474 (!!). De prestaties van lineair doorzoeken dalen sterk bij hoge benuttingsgraden.
Het is het beste om een lage gebruikscoëfficiënt voor deze hashtabel te behouden. Maar dan verhogen we de prestaties ten koste van het geheugenverbruik. Gelukkig kan dit in het geval van 32-bits sleutels en waarden gerechtvaardigd zijn. Als we in het bovenstaande voorbeeld een gebruikscoëfficiënt van 0,25 in de tabel met 128 miljoen elementen behouden, kunnen we niet meer dan 32 miljoen elementen opslaan, terwijl de overige 96 miljoen slots verloren gaan — 8 bytes voor elk paar, wat resulteert in 768 MB verloren geheugen.
Houd er rekening mee dat het hier gaat om het geheugenverlies van de videokaart, dat een waardevollere hulpbron is dan het systeemgeheugen. Hoewel de meeste moderne desktop videokaarten die CUDA ondersteunen, minstens 4 GB geheugen hebben (op het moment van schrijven heeft de NVIDIA 2080 Ti 11 GB), is het nog steeds niet verstandig om zulke hoeveelheden te verliezen.
Later zal ik meer schrijven over het maken van hashtabellen voor videokaarten die geen problemen hebben met de diepte van probing, en over manieren om verwijderde slots opnieuw te gebruiken.
Diepte van probing meten
Om de diepte van probing van een sleutel te bepalen, kunnen we de hash van de sleutel (zijn ideale index in de tabel) extraheren uit zijn werkelijke tabelindex:
// get_key_index() -> index of key in hash table
uint32_t probelength = (get_key_index(key) - hash(key)) & (hashtablecapacity-1);
Vanwege de magie van twee binaire getallen in de aangevulde code en het feit dat de capaciteit van de hashtabel een macht van twee is, zal deze aanpak zelfs werken wanneer de sleutelindex naar het begin van de tabel is verplaatst. Laten we zeggen dat een sleutel hash naar 1, maar is ingevoegd in slot 3. Voor een tabel met een capaciteit van 4 krijgen we: (3 — 1) & 3, wat gelijk is aan 2.
Conclusie
Als je vragen of opmerkingen hebt, kun je me schrijven op of open een nieuw onderwerp in.
Deze code is geschreven onder invloed van de prachtige artikelen:
In de toekomst zal ik blijven schrijven over implementaties van hashtabellen voor videokaarten en hun prestaties analyseren. Ik ben van plan kettingverknoping, Robin Hood hashing en cuckoo hashing met behulp van atomische operaties in datastructuren die geschikt zijn voor videokaarten te onderzoeken.
Bron: habr.com
