

Deze post is geschreven omdat we veel gesprekken met klanten hadden over het ontwikkelen van applicaties op Kubernetes en de specifieke aspecten van deze ontwikkeling op OpenShift.
We beginnen meestal met de stelling dat Kubernetes gewoon Kubernetes is, terwijl OpenShift een Kubernetes-platform is, net als Microsoft AKS of Amazon EKS. Elke van deze platforms heeft zijn eigen voordelen, gericht op een specifieke doelgroep. En na dit gesprek vloeit het al snel over in een vergelijking van de sterke en zwakke punten van specifieke platforms.
In feite dachten we deze post te schrijven met de conclusie: 'Luister, het maakt niet uit waar je de code draait, op OpenShift of op AKS, op EKS, op een aangepaste Kubernetes, zelfs op elk soort Kubernetes.' (Om het kort te houden noemen we het KUK) – het is immers echt eenvoudig, zowel daar als daar.
Daarna was het plan om een eenvoudige 'Hello World' te nemen en aan de hand daarvan te laten zien wat gemeenschappelijk is en wat de verschillen zijn tussen KUK en Red Hat OpenShift Container Platform (hierna OCP of gewoon OpenShift).
Maar tijdens het schrijven van deze post beseften we dat we zo lang en zo sterk gewend zijn geraakt aan het gebruik van OpenShift, dat we gewoon niet doorhadden hoe het is gegroeid en veranderd in een geweldige platform dat veel meer is geworden dan alleen een Kubernetes-distributie. We beschouwen de volwassenheid en eenvoud van OpenShift als vanzelfsprekend, waardoor we zijn pracht uit het oog verliezen.
Over het algemeen is het tijd voor constructieve berusting, en nu zullen we stap voor stap de implementatie van onze 'Hello World' op KUK en OpenShift vergelijken, en we zullen dit maximaal objectief doen (zij het af en toe met een persoonlijke voorkeur voor het onderwerp). Als je een puur subjectieve mening over dit onderwerp wilt, kun je die lezen . Maar in deze post zullen we ons uitsluitend aan de feiten houden.
Clusters
Dus, voor onze 'Hello World' hebben we clusters nodig. Laten we meteen 'nee' zeggen tegen publieke clouds, om geen kosten te maken voor servers, registries, netwerken, datatransmissie, enz. Daarom kiezen we voor een eenvoudige single-node cluster op (voor KUK) en (voor de OpenShift-cluster). Beide opties zijn echt eenvoudig te installeren, maar vereisen behoorlijk wat middelen op je laptop.
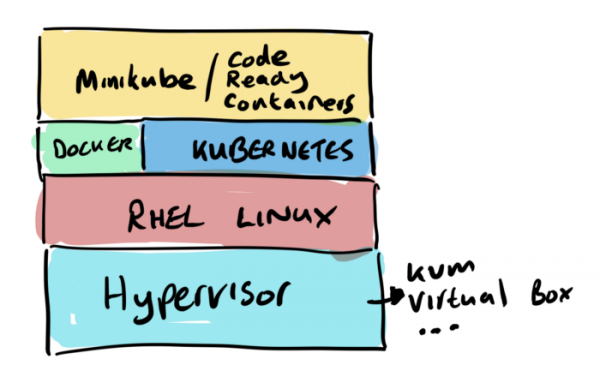
Bouwen op KUK
Laten we beginnen.
Stap 1 – we bouwen ons containerbeeld
Ik begin met het uitrollen van onze 'Hello World' op minikube. Hiervoor heb je nodig:
- 1. Geïnstalleerde Docker.
- 2. Geïnstalleerde Git.
- 3. Geïnstalleerde Maven (in dit project wordt eigenlijk de mvnw-binaire gebruikt, dus dit is niet noodzakelijk).
- 4. Eigenlijk de broncode, dat wil zeggen, een kloon van de repository
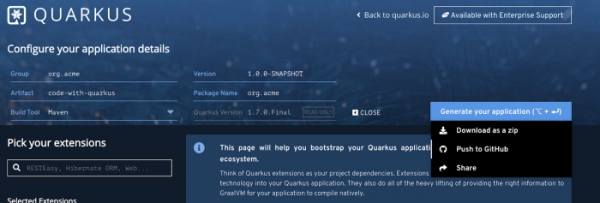
Als eerste moeten we een Quarkus-project creëren. Maak je geen zorgen als je nog nooit met de site Quarkus.io gewerkt hebt – het is eenvoudig. Je kiest gewoon de componenten die je in je project wilt gebruiken (RestEasy, Hibernate, Amazon SQS, Camel, enzovoort), en verder configureert Quarkus zelf, zonder jouw tussenkomst, het Maven-archetype en plaatst alles op GitHub. Eén muisklik – en klaar. Dat is waarom we van Quarkus houden.
De eenvoudigste manier om onze "Hello World" in een containerafbeelding te bouwen, is door gebruik te maken van de quarkus-maven extensies voor Docker, die al het nodige werk doen. Met de komst van Quarkus is dit echt gemakkelijk geworden: je voegt de extensie container-image-docker toe en je kunt afbeeldingen maken met Maven-commando's.
./mvnw quarkus:add-extension -Dextensions="container-image-docker"
En tenslotte bouwen we onze afbeelding met Maven. Het resultaat is dat onze broncode verandert in een kant-en-klare containerafbeelding die al kan worden uitgevoerd in een container-omgeving.
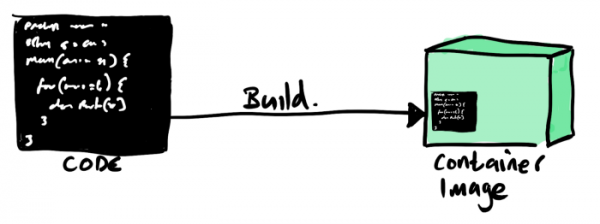
./mvnw -X clean package -Dquarkus.container-image.build=true
Dat is het eigenlijk, nu kun je de container starten met het commando docker run, door onze service op poort 8080 te mappen zodat deze benaderbaar is.
docker run -i --rm -p 8080:8080 gcolman/quarkus-hello-world
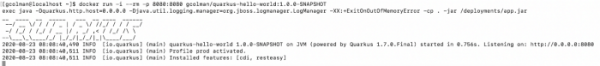
Nadat de containerinstantie is gestart, hoef je alleen nog maar met het commando curl te controleren of onze service werkt:

Dus, alles werkt, en het was echt gemakkelijk en simpel.
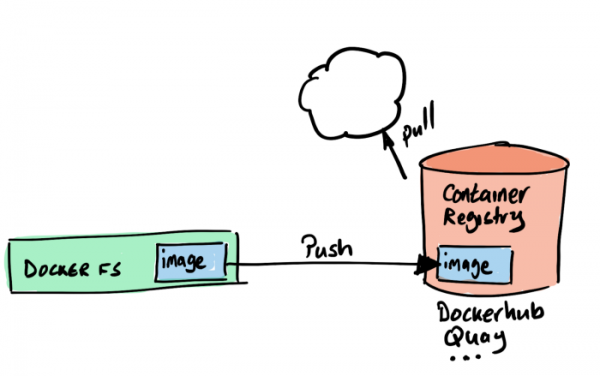
Stap 2 – we sturen onze container naar de containerafbeeldingsrepository
Tot nu toe wordt de afbeelding die we hebben aangemaakt lokaal opgeslagen in onze lokale containeropslag. Als we deze afbeelding willen gebruiken in onze K8s-omgeving, moet deze in een andere repository worden geplaatst. Kubernetes heeft geen dergelijke functies, dus we zullen dockerhub gebruiken. Omdat het ten eerste gratis is, en ten tweede, (bijna) iedereen dat doet.
Dit is ook heel eenvoudig, je hebt hier alleen een account op dockerhub nodig.
Dus, we loggen in op dockerhub en sturen onze afbeelding daarheen.
Stap 3 – we starten Kubernetes
Er zijn veel manieren om de Kubernetes-configuratie voor het draaien van onze "Hello World" samen te stellen, maar we zullen de eenvoudigste gebruiken, want zo zijn we...
We starten met het opzetten van de minikube-cluster:
minikube start
Stap 4 – we zetten ons containerbeeld uit
Nu moeten we onze code en het containerbeeld omzetten naar Kubernetes-configuraties. Met andere woorden, we hebben een pod en deployment-definitie nodig die verwijst naar ons containerbeeld op Docker Hub. Een van de eenvoudigste manieren om dit te doen, is door het commando create deployment uit te voeren en ons beeld op te geven:
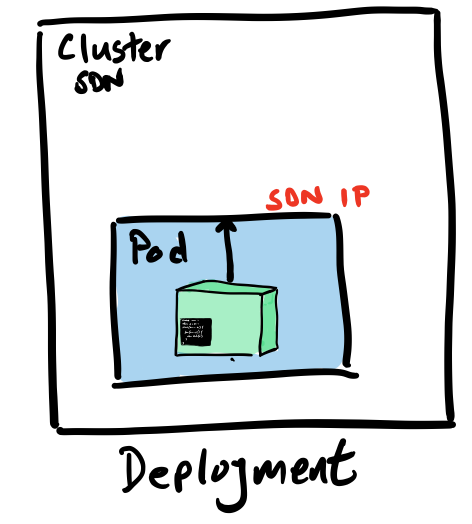
kubectl create deployment hello-quarkus --image=gcolman/quarkus-hello-world:1.0.0-SNAPSHOT
Met dit commando hebben we onze K8s gezegd dat het een deployment-configuratie moet maken, die een pod-specificatie voor ons containerbeeld moet bevatten. Dit commando past ook deze configuratie toe op onze minikube-cluster en creëert een deployment die ons containerbeeld downloadt en een pod in de cluster opstart.
Stap 5 – we openen toegang tot onze service
Nu we een uitgerold containerbeeld hebben, is het tijd om te denken aan hoe we externe toegang kunnen configureren tot deze RESTful-service, die in feite in onze code is geprogrammeerd.
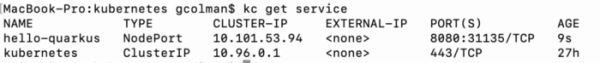
Er zijn veel manieren om dit te doen. We kunnen bijvoorbeeld het commando expose gebruiken om automatisch de benodigde Kubernetes-componenten zoals services en endpoints te creëren. Dat is precies wat we gaan doen door het expose-commando voor ons deployment object uit te voeren:
kubectl expose deployment hello-quarkus --type=NodePort --port=8080
Laten we even stilstaan bij de optie "--type" van het expose-commando.
Wanneer we expose maken en de noodzakelijke componenten creëren om onze service uit te voeren, moeten we, onder andere, ervoor zorgen dat we van buitenaf verbinding kunnen maken met de hello-quarkus service, die zich binnen ons softwaregedefinieerde netwerk bevindt. En de parameter type maakt het mogelijk om dingen zoals load balancers aan te maken en verbinding te maken met dat netwerk.
Bijvoorbeeld, door te specificeren type=LoadBalancer, initialiseren we automatisch een load balancer in de openbare cloud om verbinding te maken met onze Kubernetes-cluster. Dit is natuurlijk geweldig, maar we moeten begrijpen dat deze configuratie stevig is verbonden aan een specifieke openbare cloud en moeilijker te migreren zal zijn tussen Kubernetes-instanties in verschillende omgevingen.
In ons voorbeeld type=NodePort, dat wil zeggen dat de toegang tot onze service verloopt via het IP-adres van de node en het poortnummer. Deze optie maakt het mogelijk om geen gebruik te maken van publieke clouds, maar vereist een aantal extra stappen. Ten eerste is er een eigen load balancer nodig, dus we zullen een load balancer NGINX in onze cluster opzetten.
Stap 6 - Laten we de load balancer opzetten
Minikube heeft verschillende platformfuncties die het creëren van de benodigde componenten voor externe toegang vergemakkelijken, zoals ingress-controllers. Minikube wordt geleverd met de Nginx ingress-controller, en we hoeven deze alleen maar in te schakelen en te configureren.
minikube addons enable ingress
Nu creëren we met één commando de Nginx ingress-controller, die binnen onze minikube-cluster zal draaien:
ingress-nginx-controller-69ccf5d9d8-j5gs9 1/1 Running 1 33m
Stap 7 - We configureren de ingress
Nu moeten we de Nginx ingress-controller configureren, zodat deze de verzoeken naar hello-quarkus kan verwerken.
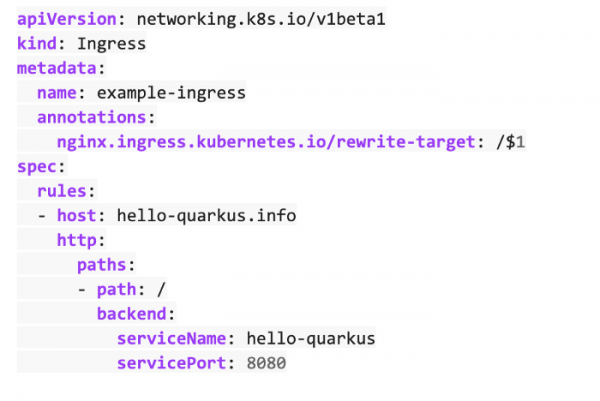
En tot slot moeten we deze configuratie toepassen.
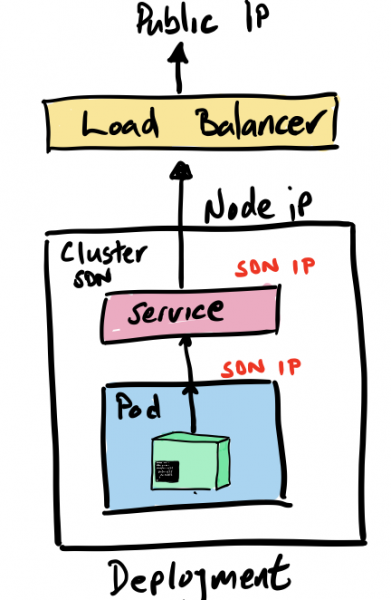
kubectl apply -f ingress.yml

Omdat we dit allemaal op onze computer doen, voegen we eenvoudigweg het IP-adres van onze node toe aan het bestand /etc/hosts, zodat http-verzoeken naar onze minikube naar de load balancer NGINX worden geleid.
192.168.99.100 hello-quarkus.info
Dat is het, nu is onze minikube-service extern toegankelijk via de Nginx ingress-controller.
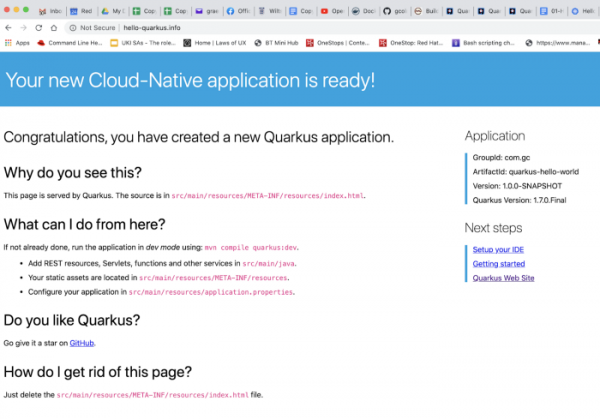
Nou, dat was toch eenvoudig, nietwaar? Of niet echt?
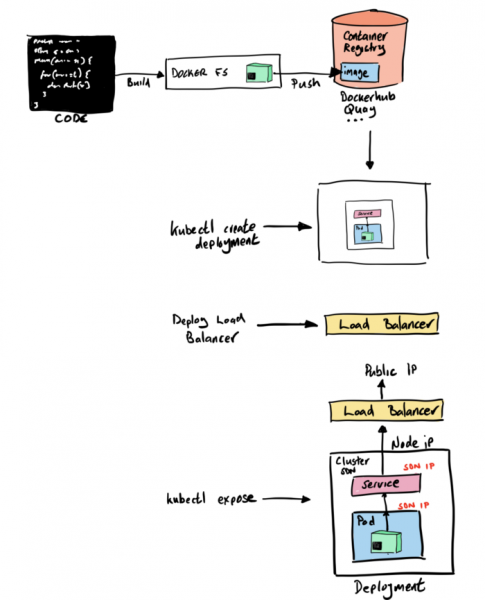
Laten we het uitrollen op OpenShift (Code Ready Containers)
Laten we eens bekijken hoe dit allemaal werkt op het Red Hat OpenShift Container Platform (OCP).
Net als bij minikube kiezen we voor de enkel-node clusterconfiguratie van OpenShift in de vorm van Code Ready Containers (CRC). Dit heette eerder minishift en was gebaseerd op het OpenShift Origin-project, en nu is het CRC, gebouwd op het Red Hat OpenShift Container Platform.
Hier kunnen we het niet laten om te zeggen: "OpenShift is prachtig!"
Oorspronkelijk dachten we te schrijven dat de ontwikkeling op OpenShift niet verschilt van de ontwikkeling op Kubernetes. En in wezen is dat ook zo. Maar tijdens het schrijven van deze post herinnerden we ons hoeveel extra stappen er nodig zijn als je geen OpenShift hebt, en daarom is het, herhaal ik, prachtig. We houden ervan als alles eenvoudig is, en de manier waarop ons voorbeeld op OpenShift veel eenvoudiger wordt uitgerold en gestart in vergelijking met minikube, motiveerde ons om deze post te schrijven.
Laten we het proces doorlopen en kijken wat we nodig hebben.
Dus, in het minikube-voorbeeld zijn we begonnen met Docker... Stop, we hebben niet meer nodig dat Docker op de machine is geïnstalleerd.
En lokale git hebben we niet nodig.
Maven is ook niet nodig.
En we hoeven geen containerimage handmatig te maken.
En we hoeven geen enkele containerimage repository te zoeken.
En we hoeven geen ingress-controller te installeren.
En we hoeven ook geen ingress te configureren.
Begrijp je het? Om onze applicatie op OpenShift te implementeren en uit te voeren, is niets van het bovenstaande nodig. En het proces ziet er als volgt uit.
Stap 1 – Start je OpenShift-cluster
We gebruiken Code Ready Containers van Red Hat, dat in wezen dezelfde is als Minikube, maar met een volledige enkele-node OpenShift-cluster.
crc start
Stap 2 – Bouw en implementeer de applicatie in het OpenShift-cluster
Op deze stap komen de eenvoud en het gemak van OpenShift helemaal tot uiting. Zoals in alle Kubernetes-distributies hebben we veel manieren om een applicatie in het cluster te starten. En, net als in het geval van K8s, kiezen we opzettelijk de aller eenvoudigste.
OpenShift is altijd gebouwd als een platform voor het creëren en uitvoeren van containerapplicaties. Het bouwen van containers is altijd een integraal onderdeel van dit platform geweest, dus er zijn hier tal van extra Kubernetes-resources voor de relevante taken.
We gaan het OpenShift Source 2 Image (S2I) proces gebruiken, dat verschillende manieren biedt om onze bron (code of binaire bestanden) te nemen en deze om te zetten in een containerimage die in het OpenShift-cluster kan draaien.
Hiervoor hebben we twee dingen nodig:
- Onze broncode in een git-repository
- Een builder-image waarvan het bouwen zal plaatsvinden.
Er zijn veel van dergelijke images, ondersteund zowel door Red Hat als door de gemeenschap, en we zullen de OpenJDK-image gebruiken, omdat ik namelijk een Java-applicatie bouw.
We kunnen de S2I-build zowel vanuit de grafische interface van OpenShift Developer als vanuit de commandoregel starten. We gaan de new-app opdracht gebruiken en deze vertellen waar de builder-image en onze broncode vandaan moeten komen.
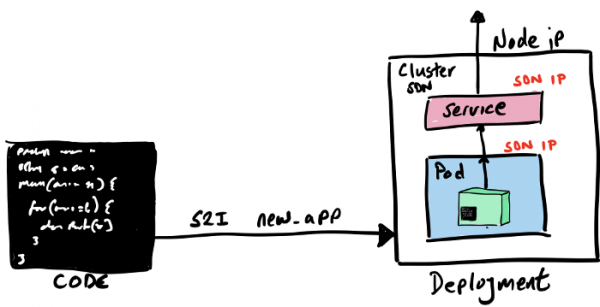
oc new-app registry.access.redhat.com/ubi8/openjdk-11:latest~https://github.com/gcolman/quarkus-hello-world.git
Dat is het, onze applicatie is gemaakt. Tijdens het proces heeft S2I de volgende dingen uitgevoerd:
- Een build-pod gemaakt voor allerlei zaken die met de applicatiebouw te maken hebben.
- Een OpenShift Build-config geraadpleegd.
- De builder-image gedownload naar de interne docker-register van OpenShift.
- ‘Hello World’ naar de lokale repository gekloond.
- Ik zag dat er een maven pom is, dus ik heb de applicatie gecompileerd met maven.
- Ik heb een nieuw containerafbeelding gemaakt die de gecompileerde Java-applicatie bevat en deze afbeelding in de interne containerregistry geplaatst.
- Ik heb een Kubernetes Deployment gemaakt met specificaties voor pod, service, enz.
- Ik heb de implementatie van de containerafbeelding gestart.
- Ik heb de tijdelijke build-pod verwijderd.
Er staat veel op deze lijst, maar het belangrijkste is dat de hele build puur binnen OpenShift gebeurt, de interne Docker-registry zich ook binnen OpenShift bevindt en het buildproces alle Kubernetes-componenten creëert en ze in de cluster start.
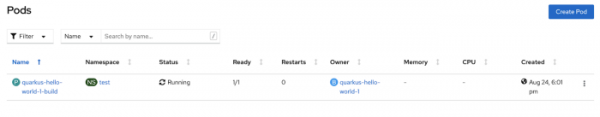
Als je visueel de S2I-implementatie in de console volgt, kun je zien hoe de build pod gestart wordt tijdens het bouwen.
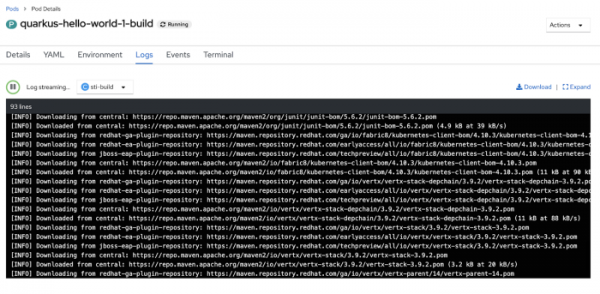
Laten we nu de logs van de builder pod bekijken: daar kun je zien hoe maven zijn werk doet en afhankelijkheden voor onze java-applicatie downloadt.
Nadat de maven-build is voltooid, start de bouw van de containerafbeelding en vervolgens wordt deze gebouwde afbeelding naar de interne repository gestuurd.
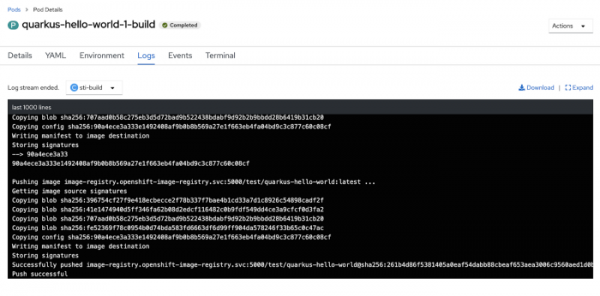
Dat is het, het buildproces is voltooid. Laten we controleren of de pods en services van onze applicatie in de cluster zijn gestart.
oc get service
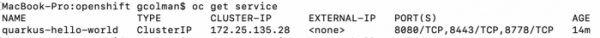
Dat is het. Slechts één commando. We hoeven alleen maar deze service te exposen voor externe toegang.
Stap 3 - we exposen de service voor externe toegang
Net zoals bij KUK heeft onze 'Hello World' op het OpenShift-platform ook een router nodig om extern verkeer naar de service binnen de cluster te sturen. In OpenShift is dit heel eenvoudig. Ten eerste is de HAProxy-router component standaard in de cluster geïnstalleerd (dit kan worden vervangen door dezelfde NGINX). Ten tweede zijn er speciale resources met uitgebreide configuratiemogelijkheden die Routes worden genoemd en lijken op Ingress-objecten in het oude vertrouwde Kubernetes (in feite hebben de OpenShift Routes een grote invloed gehad op het ontwerp van Ingress-objecten, die nu ook in OpenShift kunnen worden gebruikt), maar voor onze 'Hello World', en eigenlijk bijna in alle andere gevallen, hebben we genoeg aan de standaard Route zonder aanvullende configuratie.
Om een routbare FQDN voor 'Hello World' te creëren (ja, in OpenShift is er eigen DNS voor naamroutering naar services), voeren we eenvoudigweg expose uit voor onze service:
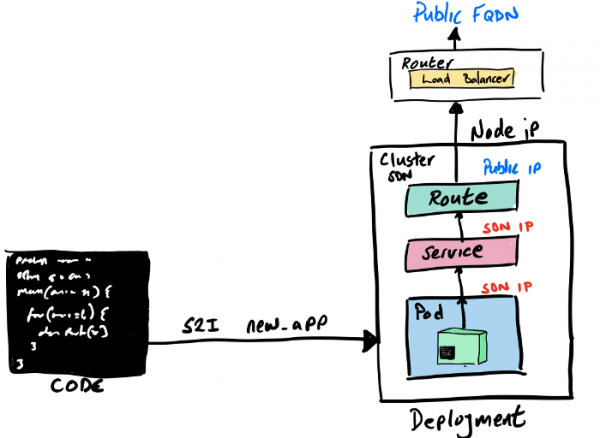
oc expose service quarkus-hello-world
Als je naar de net gecreëerde Route kijkt, kun je de FQDN en andere routeringsinformatie vinden:
oc get route

En tot slot, we benaderen onze service vanuit de browser:
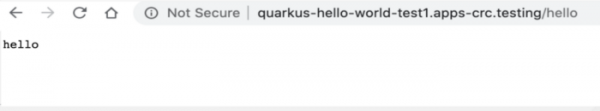
En dat was echt gemakkelijk!
We houden van Kubernetes en alles wat deze technologie mogelijk maakt, en we houden van eenvoud en gebruiksgemak. Kubernetes is ontwikkeld om het beheer van gedistribueerde, schaalbare containers enorm te vereenvoudigen, maar om toepassingen in gebruik te nemen, is die eenvoud vandaag de dag niet genoeg. Hier komt OpenShift in beeld, dat met zijn tijd meegaat en Kubernetes biedt dat vooral op de ontwikkelaar is gericht. Er is veel moeite gestoken in het afstemmen van het OpenShift-platform op de ontwikkelaar, inclusief de creatie van tools zoals S2I, ODI, Developer Portal, OpenShift Operator Framework, integratie met IDE's, Developer Catalogues, integratie met Helm, monitoring en nog veel meer.
We hopen dat dit artikel interessant en nuttig was voor u. U kunt aanvullende bronnen, materiaal en andere nuttige dingen voor de ontwikkeling op het OpenShift-platform vinden op de portal .
Bron: habr.com
