

– Oh, geen enkele schuilplaats kan een meteorietinslag weerstaan. Maar net als iedereen heeft u een reserve, dus maak u geen zorgen.
Stanislaw Lem, "De Sterren Dagboeken van Ijon Tichy"
Een back-up betekent het opslaan van een kopie van gegevens op een andere locatie dan de hoofdopslagplaats.
De belangrijkste functie van een back-up is het herstellen van gegevens na verlies. Daarom hoort men vaak zeggen dat als er een replica van de database is, de gegevens altijd daaruit hersteld kunnen worden en een back-up niet nodig is. In werkelijkheid biedt een back-up echter minstens drie oplossingen die niet met een replica kunnen worden opgelost, en bovendien kan een replica niet zonder back-up worden geïnitialiseerd.
Ten eerste stelt een back-up u in staat om gegevens te herstellen na een logische fout. Bijvoorbeeld, de boekhouder heeft een reeks boekingen verwijderd of de database administrator heeft een tabbelruimte vernietigd. Beide handelingen zijn volkomen legitiem vanuit het perspectief van de database, en het replicatieproces zal deze in de replica-database reproduceren.
Ten tweede zijn moderne DBMS-systemen nogal betrouwbare softwarepakketten, maar af en toe komt het voor dat de interne structuren van de database beschadigd raken, waarna de toegang tot de gegevens verloren gaat. Wat bijzonder frustrerend is, is dat dergelijke schendingen meestal optreden bij hoge belasting of tijdens de installatie van een bepaalde update. Maar zowel hoge belasting als regelmatige updates geven aan dat de database geen testdatabase is en dat de gegevens daarin waardevol zijn.
Tot slot, de derde taak waarvan de oplossing een back-up vereist, is het klonen van de database, bijvoorbeeld voor testdoeleinden.
Het back-uppen van databases is op de een of andere manier gebaseerd op een van de twee principes:
- Selectie van gegevens met daaropvolgend opslaan in een willekeurig formaat;
- Snapshot van de status van databasebestanden en het opslaan van logboeken.
Laten we deze principes en de tools die ze implementeren, nader bekijken.
Gegevensuitvoer
In de set van hulpprogramma's die bij elke DBMS worden geleverd, zijn er altijd tools voor gegevensuitvoer en -invoer. Gegevens worden opgeslagen in een tekstformaat of in een binaire indeling die specifiek is voor de betreffende DBMS. In de onderstaande tabel is een lijst van dergelijke tools opgenomen:
Binaire indeling
Tekstformaat
Oracle
DataPump Export/DataPump Import
Exporteren/Importeren
SQL*Plus/SQL*Loader
PostgreSQL
pg_dump, pg_dumpall/pg_restore
pg_dump, pg_dumpall/psql
Microsoft SQL Server
bcp
bcp
DB2
unload/load
unload/load
MySQL
mysqldump, mysqlpump/mysql, mysqlimport
MongoDB
mongodump/mongorestore
mongoexport/mongoimport
Cassandra
nodetool snapshot/sstableloader
cqlsh
Het tekstformaat heeft als voordeel dat het kan worden bewerkt of zelfs kan worden aangemaakt door externe programma's, terwijl het binaire formaat daarentegen sneller gegevens kan exporteren en importeren door middelen te besparen op het converteren van formaten.
Ondanks de eenvoud en voor de hand liggende ideeën over het exporteren van gegevens, wordt deze methode zelden toegepast voor het back-uppen van druk belaste industriële databases. Hier zijn de redenen waarom exporteren niet geschikt is voor volwaardige back-ups:
- het exportproces legt een aanzienlijke belasting op de bronsysteem;
- exporteren kost veel tijd - tegen de tijd dat de export is voltooid, is deze al niet meer actueel;
- het is praktisch onmogelijk om een consistente export van de volledige database te maken onder hoge belasting, aangezien het DBMS genoodzaakt is een snapshot van zijn toestand te bewaren op het moment dat de export begint. Hoe meer transacties er zijn uitgevoerd sinds de export begon, hoe groter het volume van de snapshot (verouderde kopieën van gegevens in PostgreSQL, undo-ruimten in Oracle, tempdb in Microsoft SQL Server, enz.);
- exporteren behoudt de logische structuur van de gegevens, maar niet de fysieke structuur - parameters van de fysieke opslag van tabellen, indexen, enz.
Toch heeft exporteren ook voordelen:
- hoge selectiviteit: je kunt afzonderlijke tabellen, afzonderlijke velden en zelfs afzonderlijke records exporteren;
- geëxporteerde gegevens kunnen worden geladen in een database van een andere versie, en als de export is gedaan in het tekstformaat, ook in een andere database.
Daarom wordt exporteren voornamelijk gebruikt voor taken zoals het back-uppen van kleine tabellen (bijvoorbeeld naslagwerken) of de distributie van datasets met een volgende release van de applicatie.
De meest voorkomende methode voor het maken van back-ups van databases is echter het kopiëren van databasebestanden.
‘Koude’ opslag van databasebestanden
Het voor de hand liggende idee is om de database te stoppen en al zijn bestanden te kopiëren. Een dergelijke back-up wordt een 'koude' back-up genoemd. Deze methode is uiterst betrouwbaar en eenvoudig, maar heeft twee duidelijke nadelen:
- Met een 'koude' back-up kan alleen de status van de database worden hersteld die er was op het moment van stopzetten; transacties die na de herstart zijn uitgevoerd, worden niet opgenomen in de 'koude' back-up.
- Niet elke database heeft een technologisch venster waarin de database kan worden gestopt.
Als 'koude' back-ups u aanspreken, moet u zich realiseren dat
- een 'koude' kopie soms ook logboeken moet bevatten. De methoden voor het bepalen van de logboeken die in de 'koude' kopie moeten worden opgenomen, zijn individueel voor elke DBMS. In Oracle moet bijvoorbeeld de zogenaamde online redo worden gekopieerd, dat wil zeggen een vast aantal logbestanden in een speciale map, zelfs wanneer de database correct is gestopt. In PostgreSQL moeten alle logboeken worden bewaard, beginnend met het logboek dat het laatste controlepunt bevat, waarvan de informatie in het beheersbestand staat.
- de catalogus van de database kan vrij grote bestanden van tijdelijke tabellenruimtes bevatten die niet noodzakelijkerwijs in de back-up moeten worden opgenomen. Overigens geldt deze opmerking ook voor 'hete' back-ups.
'Hete' bestandsback-up
De meeste back-ups van moderne databases worden uitgevoerd door de databestanden te kopiëren zonder de database te stoppen. Er zijn hier verschillende problemen zichtbaar:
- Op het moment van starten van de kopie kan de inhoud van de database niet overeenkomen met de inhoud van de bestanden, omdat een deel van de informatie zich in de cache bevindt en nog niet op de schijf is geschreven.
- Tijdens het kopiëren kan de inhoud van de database veranderen. Als veranderlijke datastructuren worden gebruikt, verandert de inhoud van de bestanden, en bij onveranderlijke structuren verandert de set bestanden: nieuwe bestanden verschijnen en oude worden verwijderd.
- Aangezien het schrijven van gegevens naar de database en het lezen van DB-bestanden niet op elkaar zijn afgestemd, kan het back-upprogramma een onjuiste pagina lezen, waarbij de helft van de oude versie van de pagina en de andere helft van de nieuwe is.
Om een consistente back-up te verkrijgen, heeft elke DBMS een opdracht die aangeeft dat het back-upproces is gestart. Deze opdracht kan syntactisch verschillend zijn:
- in Oracle is dit een aparte opdracht ALTER DATABASE/TABLESPACE BEGIN BACKUP;
- in PostgreSQL – functie pg_start_backup();
- In Microsoft SQL Server and DB2, the backup preparation is implicitly carried out during the execution of the BACKUP DATABASE command.
- In MySQL Enterprise, Cassandra, and MongoDB, the preparation is implicitly handled by external utilities – mysqlbackup, OpsCenter, and Ops Manager, respectively.
Despite syntactical differences, the backup preparation process looks the same.
Here’s what backup preparation looks like in databases with mutable disk structures, i.e., in all traditional disk-based relational systems:
- The moment the backup begins is recorded; the backup must include database logs starting from this moment.
- A checkpoint is executed, meaning that all changes that occurred on the data pages before the recorded moment are flushed to disk. This ensures that logs prior to the backup start time will not be needed during recovery.
- A special logging mode is enabled: if a data page is modified for the first time after loading from disk, instead of logging the page changes, the entire page will be recorded in the log. During the preparation process, all pages are flushed to disk, so upon the first modification, the block will always be logged entirely. However, if the page is flushed to disk again during backup, the next modification will also result in a complete copy of the page being logged. This ensures that if a page becomes corrupted when copying a data file, applying the log will restore it to a valid state.
- Changes to data file headers are blocked, meaning that part of it which is not reflected in the logs. This guarantees that the header will be copied correctly, and then the logs will be applied correctly to the data file.
Nadat alle bovengenoemde procedures zijn uitgevoerd, kunnen de gegevensbestanden worden gekopieerd met behulp van het besturingssysteem – cp, rsync en anderen. Het inschakelen van de back-upmodus vermindert de prestaties van de database: ten eerste neemt de hoeveelheid logs toe, en ten tweede, als er tijdens de back-upmodus een fout optreedt, zal het herstel langer duren, omdat de headers van de gegevensbestanden niet worden bijgewerkt. Hoe sneller de back-up is voltooid, hoe beter het is voor de database, daarom is het hier relevant om hulpmiddelen zoals een snapshot van het bestandssysteem of een mirror break (BCV) in de opslagarray te gebruiken. Sommige DBMS'en (Oracle, PostgreSQL) laten de beheerder de back-upmethode zelf kiezen, terwijl andere (Microsoft SQL Server) een interface bieden voor de integratie van eigen back-uptools met de mechanismen van bestandssystemen of opslagoplossingen.
Na het voltooien van de back-up moet de database weer in een normale staat worden gebracht. In Oracle gebeurt dit met de opdracht ALTER DATABASE/TABLESPACE END BACKUP, in PostgreSQL met de functie pg_stop_backup(), en in andere databases met interne subroutines van de bijbehorende opdrachten of externe diensten.
Zo ziet het tijdschema van het back-upproces eruit:
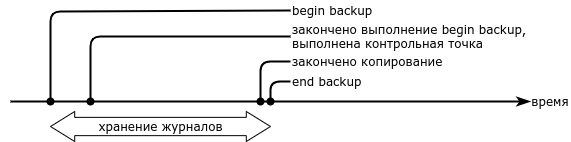
- De voorbereiding op de back-up (begin backup) kost tijd, soms veel tijd. Ook al worden spiegelvolumes of bestandssystemen met snapshot-mogelijkheid gebruikt, het back-upproces zal niet onmiddellijk zijn.
- Samen met de gegevensbestanden moeten de logs worden bewaard vanaf het moment dat de voorbereiding op de back-up begint tot het moment dat de database zijn normale toestand herstelt.
- Het is mogelijk om van deze back-up te herstellen op het moment dat de database zijn normale toestand herstelt. Herstel naar een eerder moment is niet mogelijk.
Bij databases die onveranderlijke datastructuren gebruiken (geheugensnapshots, LSM-bomen) is de situatie eenvoudiger. De voorbereiding op de back-up bestaat uit de volgende stappen:
- Gegevens uit het geheugen worden naar de schijf weggeschreven.
- Er wordt een lijst van bestanden vastgelegd die in de back-up terechtkomen. Totdat het back-upproces is voltooid, is het de database verboden om deze bestanden te verwijderen, zelfs niet als ze niet langer nodig zijn.
Bij het signaal van het einde van de back-up kan de database met onveranderlijke structuren opnieuw onnodige bestanden verwijderen.
Herstel naar punt
Een back-up maakt het mogelijk om de staat van de database te herstellen naar het moment waarop de terugkeer uit de back-upmodus is voltooid. Een storing, waarbij herstel nodig is, kan op elk moment optreden. De taak om de staat van de database naar een willekeurig moment te herstellen, wordt "herstel naar punt" (point-in-time recovery) genoemd.
Om deze mogelijkheid te waarborgen, moeten de DB-logboeken vanaf het moment van beëindiging van de back-up worden opgeslagen, en tijdens het herstel moeten de logboeken op de herstelde kopie worden toegepast. Nadat de database uit de back-up is hersteld op het moment van de beëindiging van de kopie, is de staat van de database (bestanden en gecachte pagina's) gegarandeerd correct, waardoor een speciale loggingmodus niet nodig is. Door logboeken tot het gewenste moment toe te passen, kan de staat van de database op elk tijdstip worden verkregen.
Als de snelheid van het herstel van de back-up alleen wordt beperkt door de schijfdoorvoer, wordt de snelheid waarmee de logboeken worden toegepast meestal beperkt door de prestaties van de processor. Als er in de hoofd-database gelijktijdig wijzigingen plaatsvinden, worden bij het herstel alle wijzigingen sequentieel uitgevoerd – in de volgorde waarin ze uit het logboek worden gelezen. Hierdoor hangt de hersteltijd lineair af van hoe ver het herstelpunt van het einde van de back-up is verwijderd. Om deze reden moeten er vrij vaak volledige back-ups worden gemaakt – minimaal één keer per week voor databases met een lage transactielast en tot dagelijkse kopieën voor databases met een hoge belasting.
Incrementele back-up
Om het herstel naar punt te versnellen, zou het wenselijk zijn om zo vaak mogelijk back-ups te maken, zonder daarbij onnodige schijfruimte in beslag te nemen en de database niet te belasten met back-upstaken.
De oplossing voor deze taak is incrementele back-up, dat wil zeggen het kopiëren van alleen die gegevenspagina's die zijn gewijzigd sinds de vorige back-up.
Incrementele back-up is alleen zinvol voor DBMS-systemen die veranderlijke datastructuren gebruiken.
Een increment kan worden geteld vanaf een volledige back-up (cumulatieve back-up) of vanaf elke vorige back-up (differentiële back-up).
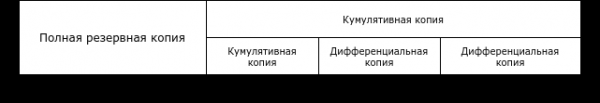
Helaas bestaat er geen uniforme terminologie, en verschillende fabrikanten gebruiken verschillende termen:
Differentiële
Cumulatieve
Oracle
Differential
Cumulative
PostgresPro
Incremental
—
Microsoft SQL Server
—
Differential
IBM DB2
Delta
Incremental
Bij het hebben van incrementele back-ups ziet het herstelproces er als volgt uit:
- de laatste volledige back-up die vóór het herstel is gemaakt, wordt hersteld;
- incrementele back-ups worden bovenop de volledige back-up hersteld;
- de logs worden vanuit het begin van de back-up tot het herstelpunt toegepast.
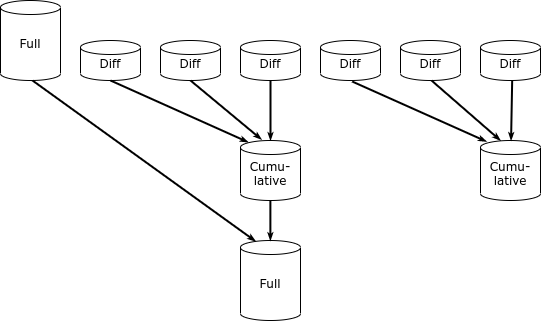
De beschikbaarheid van een cumulatieve back-up versnelt het herstelproces. Voor het herstellen van de database naar een punt tussen T3 en T4 moeten twee incrementele back-ups worden hersteld, terwijl voor het herstel naar een punt na T4 slechts één nodig is.
Het is duidelijk dat de omvang van één cumulatieve back-up kleiner is dan de omvang van meerdere differentiële back-ups, omdat sommige pagina's meerdere keren zijn veranderd en elke incrementele back-up zijn versie van de pagina bevat.
Er zijn drie manieren om een incrementele back-up te maken:
- een volledige back-up maken en het verschil met de vorige volledige back-up berekenen;
- logs analyseren, een lijst van gewijzigde pagina's maken en de pagina's uit de lijst back-uppen;
- gewijzigde pagina's opvragen in de database.
De eerste methode bespaart schijfruimte, maar lost niet het probleem van de belasting op de database op. Bovendien is het zinloos om een volledige back-up in een incrementele om te zetten, omdat het herstellen van een volledige back-up sneller is dan het herstellen van een vorige volledige back-up en een increment. De taak van het besparen van schijfruimte bij deze aanpak kan beter worden overgelaten aan speciale componenten met ingebouwde deduplicatiemechanismen. Dit kunnen speciale opslag-systemen zijn (EMC DataDomain, HPE StorageWorks VLS, de volledige NetApp-reeks) of softwareproducten (ZFS, Veritas NetBackup PureFile, Windows Server Data Deduplication).
De tweede en derde methode verschillen in de manier waarop de lijst met gewijzigde pagina's wordt vastgesteld. Het analyseren van logboeken is resource-intensiever en vereist bovendien kennis van de structuur van logbestanden. Het vragen aan de database welke pagina's zijn gewijzigd is het eenvoudigst, maar daarvoor moet de kern van het DBMS functionaliteit voor het bijhouden van gewijzigde blokken (block change tracking) hebben.
De functionaliteit voor incrementele back-ups werd voor het eerst geïntroduceerd in Oracle Recovery Manager (RMAN), dat beschikbaar kwam in de release van Oracle 8i. Oracle implementeerde meteen het bijhouden van gewijzigde blokken, zodat er geen noodzaak was voor het analyseren van logboeken.
PostgreSQL houdt geen gewijzigde blokken bij, daarom bepaalt de tool pg_probackup, ontwikkeld door het Russische bedrijf Postgres Professional, gewijzigde pagina's via het analyseren van logboeken. Het bedrijf levert echter ook het DBMS PostgresPro, dat de ptrack-extensie bevat, welke de wijziging van pagina's bijhoudt. Wanneer pg_probackup wordt gebruikt met het DBMS PostgresPro, vraagt de tool om gewijzigde pagina's bij de database – net zoals RMAN doet.
Microsoft SQL Server, net als Oracle, houdt gewijzigde pagina's bij, maar de BACKUP-commando's staan alleen volledige en cumulatieve back-ups toe.
DB2 heeft de mogelijkheid om gewijzigde pagina's bij te houden, maar is standaard uitgeschakeld. Wanneer het is ingeschakeld, kan DB2 volledige, differentiële en cumulatieve back-ups maken.
Een belangrijk verschil tussen de in dit gedeelte beschreven middelen (behalve pg_probackup) en bestandgebaseerde back-upmiddelen is dat ze de pagina-afbeeldingen bij de database opvragen in plaats van de gegevens zelf vanaf de schijf te lezen. Dit benadering heeft een klein nadeel door de extra belasting van de database. Dit nadeel wordt echter ruimschoots gecompenseerd door het feit dat de gelezen pagina altijd correct is, waardoor er geen speciale modus voor logging nodig is tijdens de back-up.
Let nogmaals op dat het beschikbaar hebben van incrementele kopieën de eisen voor het bijhouden van logboeken voor herstel naar een willekeurig tijdstip niet annuleert. Daarom worden in industriële databases logboeken voortdurend herschreven naar externe opslag en worden back-ups, zowel volledig als/of incrementeel, volgens een schema aangemaakt.
De beste implementatie van het idee van incrementele back-up is het software-hardwarecomplex (in de terminologie van Oracle – engineered system) Zero Data Loss Recovery Appliance – een gespecialiseerde oplossing van Oracle voor het back-uppen van de eigen database. Het complex is een cluster servers met een grote hoeveelheid schijven, waarop een gemodificeerde versie van de software Recovery Manager is geïnstalleerd, en het kan werken met andere software-hardwarecomplexen van Oracle (Database Appliance, Exadata, SPARC Supercluster), evenals met Oracle-databases op traditionele infrastructuur. In tegenstelling tot gewone RMAN, is in ZDLRA het concept van 'eeuwige incrementen' (incremental forever) geïmplementeerd. Het systeem maakt één keer een volledige kopie van de database en maakt daarna alleen incrementele kopieën. Extra RMAN-modules maken het mogelijk om kopieën te combineren, zodat er nieuwe volledige kopieën uit incrementele wordt gemaakt.
Ter ere van de Russische ontwikkelaars moet worden opgemerkt dat ook pg_probackup in staat is om incrementele kopieën te combineren.
In tegenstelling tot veel vergelijkbare vragen, heeft de vraag 'welke back-upmethode is beter' een eenduidig antwoord – de beste optie is de native tool voor de gebruikte database die de mogelijkheid van incrementele back-up biedt.
Voor de databasebeheerder zijn de vragen over de keuze van de back-upstrategie en de integratie van databasemiddelen in de bedrijfsinfrastructuur veel belangrijker. Maar deze vragen gaan buiten het bestek van dit artikel.
Bron: habr.com
