

Veel mensen denken dat het genoeg is om een applicatie naar Kubernetes te verplaatsen (of met Helm, of handmatig) — en dan is er geluk. Maar zo eenvoudig is het niet.
Opdracht Dit is een vertaling van het artikel van DevOps-engineer Julian Gindi. Hij vertelt welke obstakels zijn bedrijf tegenkwam tijdens de migratie, zodat u niet dezelfde fouten maakt.
Stap één: het instellen van podverzoeken en limieten
Laten we beginnen met het instellen van een schone omgeving waarin onze pods zullen draaien. Kubernetes is geweldig in het plannen van pods en het afhandelen van storingsscenario's. Maar het bleek dat de scheduler soms niet in staat is om een pod te plaatsen als het moeilijk kan inschatten hoeveel middelen nodig zijn voor succesvolle werking. Hier komen de verzoeken om middelen en limieten in beeld. Er is veel discussie over de beste aanpak om verzoeken en limieten in te stellen. Soms lijkt het meer kunst dan wetenschap. Dit is onze aanpak.
Podverzoeken zijn de belangrijkste waarden die door de scheduler worden gebruikt voor de optimale plaatsing van een pod.
Uit : in de filterfase wordt een set knooppunten bepaald waar de pod kan worden gepland. Bijvoorbeeld, de filter PodFitsResources controleert of er voldoende middelen op de knoop zijn om aan de specifieke podverzoeken te voldoen.
We gebruiken appverzoeken zodat we kunnen inschatten hoeveel middelen hebben we echt de applicatie nodig heeft voor een normale werking. Dit stelt de scheduler in staat om realistisch knooppunten te plaatsen. Oorspronkelijk wilden we de verzoeken met een speling instellen, zodat we voldoende middelen voor elke pod konden garanderen, maar we merkten dat de planningsduur aanzienlijk toenam en sommige pods nooit volledig werden gepland, alsof er voor hen geen middelenverzoeken waren ingediend.
In dit geval "duwde" de scheduler vaak pods en kon ze niet opnieuw plannen omdat het beheerniveau totaal niet wist hoeveel middelen de applicatie nodig had, en dat is een sleutelelement van het planningsalgoritme.
Podlimieten zijn een duidelijkere beperking voor de pod. Dit is het maximale aantal middelen dat de cluster aan de container toewijst.
Nogmaals, uit : als er een geheugengrens van 4 GiB voor de container is ingesteld, zal de kubelet (en de container runtime) dit afdwingen. De runtime staat de container niet toe om meer middelen te gebruiken dan het opgegeven limiet. Bijvoorbeeld, wanneer een proces in de container probeert meer geheugen dan toegestaan te gebruiken, beëindigt de kernel het proces met de foutmelding 'out of memory' (OOM).
Een container kan altijd meer middelen gebruiken dan in de aanvraag is opgegeven, maar nooit meer dan het gespecificeerde limiet. Het is moeilijk om deze waarde correct in te stellen, maar het is zeer belangrijk.
Idealiter willen we dat de vereisten voor de bronnen van de pod in de loop van de levenscyclus van het proces veranderen zonder andere processen in het systeem te verstoren — dit is het doel van het instellen van limieten.
Helaas kan ik geen concrete richtlijnen geven over welke waarden moeten worden ingesteld, maar wij houden ons aan de volgende regels:
- Met behulp van een belastingstesttool simuleren we een basisverkeersniveau en monitoren we het gebruik van de pod-bronnen (geheugen en CPU).
- We stellen de aanvragen van de pod in op een willekeurig laag niveau (met een hulpbronlimiet van ongeveer 5 keer de waarde van de aanvragen) en houden dit in de gaten. Wanneer de aanvragen te laag zijn, kan het proces niet worden gestart, wat vaak leidt tot mysterieuze runtime-fouten in Go.
Ik wil benadrukken dat hogere hulpbronlimieten de planning bemoeilijken, omdat de pod een doelknooppunt nodig heeft met voldoende beschikbare middelen.
Stel je een situatie voor waarin je een lichte webserver hebt met een zeer hoge hulpbronlimiet, bijvoorbeeld 4 GB geheugen. Waarschijnlijk moet dit proces horizontaal worden geschaald en moet elke nieuwe module op een knooppunt met minimaal 4 GB beschikbare geheugen worden gepland. Als er geen dergelijk knooppunt is, moet het cluster een nieuw knooppunt introduceren om deze pod te verwerken, wat enige tijd kan duren. Het is belangrijk om een minimale kloof te bereiken tussen de aanvragen voor bronnen en de limieten, om een snelle en soepele schaalvergroting te waarborgen.
Stap twee: het instellen van Liveness- en Readiness-tests
Dit is nog een subtiele kwestie die vaak wordt besproken binnen de Kubernetes-gemeenschap. Het is belangrijk om goed inzicht te hebben in Liveness- en Readiness-tests, aangezien ze een mechanisme bieden voor de stabiele werking van software en de downtime minimaliseren. Echter, als ze niet goed zijn ingesteld, kunnen ze ernstige gevolgen hebben voor de prestaties van uw applicatie. Hieronder volgt een beknopte samenvatting van wat beide probes inhouden.
Liveness geeft aan of de container draait. Als deze niet functioneert, doodt kubelet de container en wordt het herstartbeleid ingeschakeld. Als de container geen Liveness-probe heeft, is de standaardstatus success — zoals vermeld in .
Liveness-probes moeten goedkoop zijn, dat wil zeggen niet veel middelen verbruiken, omdat ze vaak worden uitgevoerd en Kubernetes moeten informeren dat de applicatie actief is.
Als u de parameter instelt om elke seconde uit te voeren, voegt dat 1 verzoek per seconde toe, houd er dus rekening mee dat er extra middelen nodig zijn om dit verkeer af te handelen.
Bij ons in het bedrijf controleren Liveness-tests de kerncomponenten van de applicatie, zelfs als de gegevens (bijvoorbeeld uit een externe database of cache) niet volledig beschikbaar zijn.
We hebben in de applicaties een "gezondheids"-endpoint ingesteld dat gewoon een 200-statuscode retourneert. Dit geeft aan dat het proces draait en in staat is om verzoeken te verwerken (maar nog geen verkeer).
Probe Readiness geeft aan of de container klaar is om verzoeken te verwerken. Als de readiness-probe faalt, verwijdert de endpointcontroller het IP-adres van de pod uit de endpoints van alle services die aan de pod zijn gekoppeld. Dit staat ook vermeld in de Kubernetes-documentatie.
Readiness-probes verbruiken meer middelen, omdat ze op een manier de backend moeten raken, zodat ze de gereedheid van de applicatie om verzoeken te accepteren kunnen aantonen.
In de gemeenschap bestaat veel discussie of er rechtstreeks toegang tot de database moet zijn. Gezien de overhead (de controles worden vaak uitgevoerd, maar kunnen worden geregeld), hebben we besloten dat voor sommige applicaties de gereedheid om verkeer te verwerken alleen wordt erkend na verificatie dat er records uit de database worden teruggegeven. Goed doordachte gereedheidschecks zorgden voor een hoger niveau van beschikbaarheid en elimineerden stilstand tijdens de implementatie.
Als u besluit om een databasequery te maken om de gereedheid van de applicatie te verifieren, zorg er dan voor dat deze zo goedkoop mogelijk is. Laten we zo'n query nemen:
SELECT small_item FROM table LIMIT 1Hier is een voorbeeld van hoe we deze twee waarden instellen in Kubernetes:
livenessProbe:
 httpGet:
   path: /api/liveness
   port: http
readinessProbe:
 httpGet:
   path: /api/readiness
   port: http  periodSeconds: 2
U kunt enkele extra configuratieparameters toevoegen:
initialDelaySeconds— hoeveel seconden er verstrijkt tussen het starten van de container en het starten van de probes.periodSeconds— wachttijd tussen het uitvoeren van de probes.timeoutSeconds— aantal seconden waarna de pod als defect wordt beschouwd. De normale timeout.failureThreshold— aantal mislukte tests voordat een herstartsignaal naar de pod wordt verzonden.successThreshold— aantal succesvolle probes voordat de pod overgaat naar de gereedtoestand (na een fout, wanneer de pod opnieuw wordt gestart of hersteld).
Stap drie: standaard netwerknormen voor de pod instellen
In Kubernetes is er een 'platte' netwerkstructuur, waarbij alle pods standaard direct met elkaar communiceren. In sommige gevallen is dit ongewenst.
Een potentieel beveiligingsprobleem is dat een aanvaller een enkel kwetsbaar applicatie kan gebruiken om verkeer naar alle pods in het netwerk te sturen. Zoals in veel beveiligingsgebieden geldt hier het principe van de minste privileges. Idealiter moeten netwerknormen expliciet aangeven welke verbindingen tussen pods zijn toegestaan en welke niet.
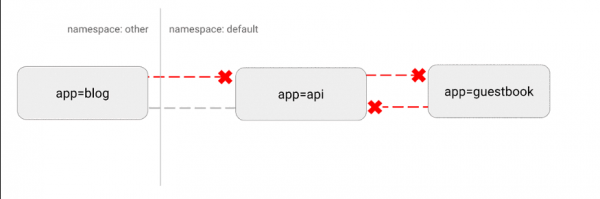
Bijvoorbeeld, hieronder staat een eenvoudige regel die al het inkomende verkeer voor een specifieke naamruimte verbiedt:
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
 name: default-deny-ingress
spec:
 podSelector: {}
 policyTypes:
   - Ingress
Visualisatie van deze configuratie:
(https://miro.medium.com/max/875/1*-eiVw43azgzYzyN1th7cZg.gif)
Meer gedetailleerd .
Stap vier: ongewone gedragingen met hooks en init-containers
Een van onze belangrijkste taken was het mogelijk maken van deploys in Kubernetes zonder downtime voor ontwikkelaars. Dit is moeilijk omdat er veel manieren zijn om applicaties af te sluiten en de gebruikte middelen vrij te geven.
Bijzondere moeilijkheden ontstonden met . We merkten dat bij de opeenvolgende implementatie van deze pods, actieve verbindingen werden verbroken voordat ze succesvol konden afsluiten.
Na uitgebreid online onderzoek bleek dat Kubernetes niet wacht tot de verbindingen van Nginx zijn uitgeput voordat het de pod afsluit. Met behulp van de pre-stop hook introduceerden we deze functionaliteit en elimineerden we volledig downtime:
lifecycle:
 preStop:
   exec:
     command: ["/usr/local/bin/nginx-killer.sh"]
Hier nginx-killer.sh:
#!/bin/bash
sleep 3
PID=$(cat /run/nginx.pid)
nginx -s quit
while [ -d /proc/$PID ]; do
   echo "Waiting while shutting down nginx..."
   sleep 10
done
Een andere uiterst nuttige paradigma is het gebruik van init-containers voor het opstarten van specifieke applicaties. Dit is vooral nuttig als u een resource-intensievere database-migratieproces heeft dat moet worden uitgevoerd voordat de applicatie wordt gestart. Voor dit proces kunt u ook een hogere resource-limiet opgeven zonder zo'n limiet voor de hoofdapplicatie in te stellen.
Een andere veelvoorkomende aanpak is toegang tot geheimen in de init-container, die deze inloggegevens aan de hoofdmodule verstrekt, waardoor ongeautoriseerde toegang tot geheimen vanuit de hoofdmodule van de applicatie wordt voorkomen.
Zoals gebruikelijk, een citaat uit de documentatie: init-containers voeren veilig gebruikerscode of hulpprogramma's uit die anders de beveiliging van de applicatiecontainer zouden verlagen. Door onnodige tools apart op te slaan, beperkt u het aanvaloppervlak van de applicatiecontainer.
Stap vijf: het kernsysteem configureren
Tot slot willen we een geavanceerdere techniek bespreken.
Kubernetes is een uiterst flexibele platform waarmee je workloads kunt draaien zoals je dat nodig acht. We hebben een aantal zeer efficiënte applicaties die extreem veel middelen vereisen. Na uitgebreid belastings testen, ontdekten we dat een van de applicaties moeite had met de verwachte verkeersbelasting wanneer de standaard Kubernetes-instellingen van kracht waren.
Kubernetes maakt het echter mogelijk om een privileged container te starten die de kernelparameters alleen voor een specifieke pod wijzigt. Dit is wat we hebben gebruikt om het maximale aantal open verbindingen te wijzigen:
initContainers:
  - name: sysctl
     image: alpine:3.10
     securityContext:
         privileged: true
      command: ['sh', '-c', "sysctl -w net.core.somaxconn=32768"]
Dit is een geavanceerdere techniek die vaak niet nodig is. Maar als je applicatie moeite heeft om grote belastingen aan te kunnen, kun je proberen enkele van deze parameters aan te passen. Meer gedetailleerde informatie over dit proces en het instellen van verschillende waarden is, zoals altijd, .
Ter conclusie
Hoewel Kubernetes een kant-en-klaar oplossing lijkt, zijn er een aantal belangrijke stappen die moeten worden ondernomen voor een ononderbroken werking van de applicaties.
Gedurende de migratie naar Kubernetes is het belangrijk om de "cyclus van belastingstests" te volgen: je start de applicatie, test deze onder belasting, observeert de metrics en het gedrag bij schaling, past de configuratie aan op basis van deze gegevens, en herhaalt dan opnieuw deze cyclus.
Evalueer realistisch het verwachte verkeer en probeer buiten deze grenzen te gaan om te zien welke componenten als eerste zullen falen. Met zo'n iteratieve aanpak kunnen slechts enkele van de genoemde aanbevelingen al voldoende zijn voor succes. Het kan ook nodig zijn om diepere aanpassingen te doen.
Stel jezelf altijd de volgende vragen:
- Hoeveel middelen verbruiken de applicaties en hoe zal ditvolume veranderen?
- Wat zijn de werkelijke vereisten voor schaling? Hoeveel verkeer zal de applicatie gemiddeld verwerken? En hoe zit het met piekverkeer?
- Hoe vaak zal de service horizontaal geschaald moeten worden? Hoe snel moeten nieuwe pods in gebruik worden genomen om verkeer te kunnen verwerken?
- Hoe correct beëindigen de pods? Is dit überhaupt nodig? Kan er een uitrol zonder downtime worden bereikt?
- Hoe kunnen risico’s voor de veiligheid worden geminimaliseerd en kan schade door gecompromitteerde pods worden beperkt? Hebben bepaalde services rechten of toegang die ze niet nodig hebben?
Kubernetes biedt een ongelooflijk platform dat de beste praktijken mogelijk maakt voor het implementeren van duizenden services in een cluster. Niettemin zijn alle applicaties verschillend. Soms vereist de implementatie net iets meer werk.
Gelukkig biedt Kubernetes de noodzakelijke instellingen om al uw technische doelen te bereiken. Door een combinatie van resource-aanvragen en limieten, Liveness en Readiness probes, init-containers, netwerkkaders en aangepaste kernelconfiguraties te gebruiken, kunt u zowel hoge prestaties als veerkracht en snelle schaalbaarheid bereiken.
Wat verder te lezen:
- .
- .
- .
Bron: habr.com
