

Package tidyr maakt deel uit van de kern van een van de populairste bibliotheken in de R-taal — tidyverse.
Het belangrijkste doel van het pakket is om data netjes te formatteren.
Op Habr is er al een artikel gewijd aan dit pakket, maar het dateert uit 2015. Ik wil de meest actuele wijzigingen bespreken die de auteur Hadley Wickham enkele dagen geleden heeft aangekondigd.
SJK: Zullen de functies gather() en spread() als verouderd worden beschouwd?
Hadley Wickham: In zekere zin. We zullen het gebruik van deze functies niet langer aanraden en fouten in deze functies niet meer corrigeren, maar ze zullen in hun huidige staat nog steeds in het pakket aanwezig zijn.
Inhoud
Als u geïnteresseerd bent in data-analyse, is het mogelijk dat mijn en kanalen misschien interessant voor je. Het merendeel van de content is gewijd aan de programmeertaal R.
Het concept van TidyData
Doel tidyr — om u te helpen uw data in een zogenaamde nette vorm te brengen. Nette data zijn data waarin:
- Elke variabele zich in een kolom bevindt.
- Elke observatie is een rij.
- Elke waarde is een cel.
Het is veel gemakkelijker en handiger om met nette data te werken bij het uitvoeren van analyses.
Belangrijkste functies die in het tidyr-pakket zijn opgenomen
tidyr bevat een set functies die bedoeld zijn voor het transformeren van tabellen:
fill()— vult ontbrekende waarden in een kolom met de vorige waarden;separate()— splitst één veld in meerdere velden met behulp van een scheidingsteken;unite()— voegt meerdere velden samen tot één, de tegenovergestelde actie van de functieseparate();pivot_longer()— functie die data omzet van een breed formaat naar een lang formaat;pivot_wider()— functie die data omzet van een lang formaat naar een breed formaat. De omgekeerde operatie van die welke door de functiepivot_longer().gather()is verouderd — functie die data omzet van een breed formaat naar een lang formaat;spread()is verouderd — functie die data omzet van een lang formaat naar een breed formaat. De omgekeerde operatie van die welke door de functiegather().
Een nieuw concept voor het omzetten van data van een breed formaat naar een lang formaat en omgekeerd
Eerder werden functies gebruikt voor dit soort transformaties. gather() en spread()In de loop der jaren is het duidelijk geworden dat voor de meeste gebruikers, inclusief de auteur van het pakket, de namen van deze functies en hun argumenten niet erg duidelijk waren, en dat ze moeilijk te vinden en te begrijpen waren, vooral welke van deze functies een data frame van wijd naar lang formaat en vice versa omvormt.
Daarom zijn in tidyr twee nieuwe, belangrijke functies toegevoegd die zijn ontworpen voor de transformatie van data frames.
De nieuwe functies pivot_longer() en pivot_wider() zijn geïnspireerd door enkele functies uit het pakket cdata, gemaakt door John Mount en Nina Zumel.
Installatie van de meest recente versie van tidyr 0.8.3.9000
Om de nieuwste versie van het pakket te installeren, tidyr 0.8.3.9000, waarin de nieuwe functies beschikbaar zijn, kunt u de volgende code gebruiken.
devtools::install_github("tidyverse/tidyr")
Op het moment van schrijven zijn deze functies alleen beschikbaar in de dev-versie van het pakket op GitHub.
Overstappen op nieuwe functies
Het is in feite eenvoudig om oude scripts aan te passen voor gebruik met de nieuwe functies. Voor een beter begrip zal ik een voorbeeld uit de documentatie van de oude functies nemen en laten zien hoe deze bewerkingen worden uitgevoerd met de nieuwe pivot_*() functies.
Transformatie van wijd formaat naar lang.
Voorbeeldcode uit de documentatie van de functie gather.
# example
library(dplyr)
stocks <- data.frame(
  time = as.Date('2009-01-01') + 0:9,
  X = rnorm(10, 0, 1),
  Y = rnorm(10, 0, 2),
  Z = rnorm(10, 0, 4)
)

# old
stocks_gather <- stocks %>% gather(key   = stock,
                                   value = price,
                                   -time)

# new
stocks_long   <- stocks %>% pivot_longer(cols      = -time,
                                       names_to  = "stock",
                                       values_to = "price")
Transformatie van lang formaat naar wijd.
Voorbeeldcode uit de documentatie van de functie spread.
# old
stocks_spread <- stocks_gather %>% spread(key = stock,
                                          value = price)

# new
stock_wide    <- stocks_long %>% pivot_wider(names_from  = "stock",
                                            values_from = "price")
Omdat in de bovenstaande voorbeelden met pivot_longer() en pivot_wider(), in de oorspronkelijke tabel stocks geen kolommen staan die in de argumenten names_to en values_to worden genoemd, moeten hun namen tussen aanhalingstekens staan.
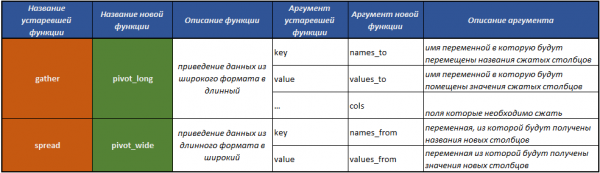
Een tabel waarmee u het gemakkelijkst kunt begrijpen hoe u over kunt stappen naar de nieuwe concepten. tidyr.
Opmerking van de auteur
De onderstaande tekst is een aangepaste, ik zou zelfs zeggen vrije vertaling van de van de officiële website van de tidyverse-bibliotheek.
Een eenvoudig voorbeeld van het omzetten van data van een breed formaat naar een lang formaat
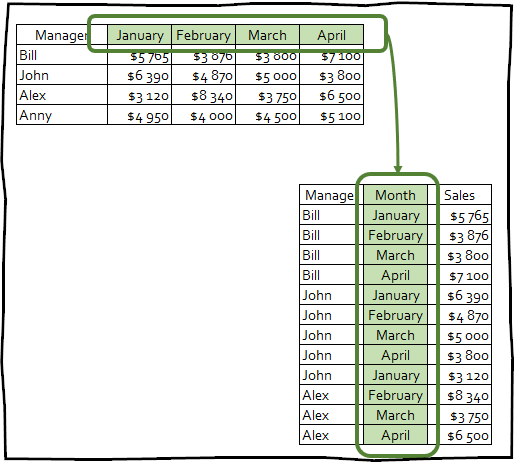
pivot_longer () maakt datasets langer door het aantal kolommen te verminderen en het aantal rijen te verhogen.
Voor het uitvoeren van de voorbeelden die in het artikel worden gepresenteerd, is het aanvankelijk noodzakelijk om de benodigde pakketten te laden:
library(tidyr)
library(dplyr)
library(readr)
Stel dat we een tabel hebben met de resultaten van een enquête waarin mensen (onder andere) naar hun religie en jaarinkomen werd gevraagd:
#> # A tibble: 18 x 11
#>    religion `<$10k` `$10-20k` `$20-30k` `$30-40k` `$40-50k` `$50-75k`
#>    <chr>      <dbl>     <dbl>     <dbl>     <dbl>     <dbl>     <dbl>
#>  1 Agnostic      27        34        60        81        76       137
#>  2 Atheist       12        27        37        52        35        70
#>  3 Buddhist      27        21        30        34        33        58
#>  4 Catholic     418       617       732       670       638      1116
#>  5 Don’t k…      15        14        15        11        10        35
#>  6 Evangel…     575       869      1064       982       881      1486
#>  7 Hindu          1         9         7         9        11        34
#>  8 Histori…     228       244       236       238       197       223
#>  9 Jehovah…      20        27        24        24        21        30
#> 10 Jewish        19        19        25        25        30        95
#> # … with 8 more rows, and 4 more variables: `$75-100k` <dbl>,
#> #   `$100-150k` <dbl>, `>150k` <dbl>, `Don't know/refused` <dbl>
Deze tabel bevat gegevens over de religie van de respondenten in de rijen, terwijl het inkomen verspreid is over de naamgeving van de kolommen. Het aantal respondenten in elke categorie wordt opgeslagen in de celwaarden op het snijpunt van religie en inkomensniveau. Om de tabel in een nette, correcte indeling te brengen, is het voldoende om pivot_longer():
pew %>%
  pivot_longer(cols = -religion, names_to = "income", values_to = "count")
pew %>%
pivot_longer(cols = -religion, names_to = "income", values_to = "count")
#> # Een tibble: 180 x 3
#> religion income count
#>
#> 1 Agnostic 2 Agnostic $10-20k 34
#> 3 Agnostic $20-30k 60
#> 4 Agnostic $30-40k 81
#> 5 Agnostic $40-50k 76
#> 6 Agnostic $50-75k 137
#> 7 Agnostic $75-100k 122
#> 8 Agnostic $100-150k 109
#> 9 Agnostic >150k 84
#> 10 Agnostic Don't know/refused 96
#> # … met nog 170 rijenDe argumenten van de functie pivot_longer()
- Het eerste argument cols, beschrijft welke kolommen moeten worden samengevoegd. In dit geval alle kolommen, behalve met behulp van de mutate-plugin, de vereiste tijdzone instellen en deze tijdstempel plaatsen in.
- Het argument names_to geeft de naam van de variabele die wordt aangemaakt uit de namen van de samengevoegde kolommen.
- values_to geeft de naam van de variabele die wordt aangemaakt uit de waarden die in de cellen van de samengevoegde kolommen staan.
Specificaties
Dit is een nieuwe functie van het pakket tidyr, die eerder niet beschikbaar was bij het gebruik van verouderde functies.
De specificatie is een gegevensraam, waarbij elke rij overeenkomt met één kolom in de nieuwe uitvoerdataframe, en twee speciale kolommen die beginnen met:
- .naam bevat de oorspronkelijke naam van de kolom.
- .value bevat de naam van de kolom waar de waarden van de cellen in zullen komen.
De overige kolommen in de specificatie weerspiegelen hoe de naam van de samengevoegde kolommen in de nieuwe kolom zal worden weergegeven. .naam.
De specificatie beschrijft de metadata die opgeslagen zijn in de kolomnaam, met één rij voor elke kolom en één kolom voor elke variabele die is samengevoegd met de kolomnaam. Dit kan nu verwarrend lijken, maar na het bekijken van een aantal voorbeelden zal het veel duidelijker worden.
Het doel van de specificatie is dat je metadata kunt extraheren, wijzigen en nieuwe metadata kunt toewijzen aan de te transformeren dataframe.
De functie die wordt gebruikt voor het werken met specificaties bij de conversie van een tabel vanuit een brede naar een lange indeling is pivot_longer_spec().
Hoe deze functie werkt, is dat het elk dataframe neemt en de metadata op de hierboven beschreven manier vormt.
Als voorbeeld nemen we de who-dataset die wordt meegeleverd met het pakket. tidyrDeze dataset bevat informatie van de wereldgezondheidsorganisatie over tuberculose-incidentie.
who
#> # A tibble: 7.240 x 60
#>    country iso2  iso3   year new_sp_m014 new_sp_m1524 new_sp_m2534
#>        &
#>  1 Afghan… AF    AFG    1980          NA           NA           NA
#>  2 Afghan… AF    AFG    1981          NA           NA           NA
#>  3 Afghan… AF    AFG    1982          NA           NA           NA
#>  4 Afghan… AF    AFG    1983          NA           NA           NA
#>  5 Afghan… AF    AFG    1984          NA           NA           NA
#>  6 Afghan… AF    AFG    1985          NA           NA           NA
#>  7 Afghan… AF    AFG    1986          NA           NA           NA
#>  8 Afghan… AF    AFG    1987          NA           NA           NA
#>  9 Afghan… AF    AFG    1988          NA           NA           NA
#> 10 Afghan… AF    AFG    1989          NA           NA           NA
#> # … met nog 7.230 rijen en 53 extra variabelen
Laten we de specificatie opstellen.
spec %
  pivot_longer_spec(new_sp_m014:newrel_f65, values_to = "count")
#> # A tibble: 56 x 3
#> .name .value name
#> <chr> <chr> <chr>
#> 1 new_sp_m014 count new_sp_m014
#> 2 new_sp_m1524 count new_sp_m1524
#> 3 new_sp_m2534 count new_sp_m2534
#> 4 new_sp_m3544 count new_sp_m3544
#> 5 new_sp_m4554 count new_sp_m4554
#> 6 new_sp_m5564 count new_sp_m5564
#> 7 new_sp_m65 count new_sp_m65
#> 8 new_sp_f014 count new_sp_f014
#> 9 new_sp_f1524 count new_sp_f1524
#> 10 new_sp_f2534 count new_sp_f2534
#> # … with 46 more rowsVelden country, iso2, iso3 zijn al variabelen. Onze taak is om de kolommen om te draaien met new_sp_m014 voor newrel_f65.
In de namen van deze kolommen is de volgende informatie opgeslagen:
- Prefix
new_geeft aan dat de kolom gegevens bevat over nieuwe gevallen van tuberculose; de huidige dataframe bevat alleen informatie over nieuwe ziekten, dus deze prefix heeft in de huidige context geen betekenis. sp/rel/sp/epbeschrijft de diagnosemethode.m/fgeslacht van de patiënt.014/1524/2535/3544/4554/65leeftijdsbereik van de patiënt.
We kunnen deze kolommen scheiden met de functie extract(), met behulp van reguliere expressies.
spec %
        extract(name, c("diagnosis", "gender", "age"), "new_?(.*)_(.)(.*)")
#> # A tibble: 56 x 5
#> .name .value diagnosis gender age
#> <chr> <chr> <chr> <chr> <chr>
#> 1 new_sp_m014 count sp m 014
#> 2 new_sp_m1524 count sp m 1524
#> 3 new_sp_m2534 count sp m 2534
#> 4 new_sp_m3544 count sp m 3544
#> 5 new_sp_m4554 count sp m 4554
#> 6 new_sp_m5564 count sp m 5564
#> 7 new_sp_m65 count sp m 65
#> 8 new_sp_f014 count sp f 014
#> 9 new_sp_f1524 count sp f 1524
#> 10 new_sp_f2534 count sp f 2534
#> # … with 46 more rowsLet op, de kolom .naam moet onveranderd blijven, aangezien dit onze index is in de kolomnamen van de oorspronkelijke dataset.
Geslacht en leeftijd (de kolommen gender en age) hebben vaste en bekende waarden, daarom wordt aanbevolen deze kolommen om te zetten in factoren:
spec %
            mutate(
              gender = factor(gender, levels = c("f", "m")),
              age = factor(age, levels = unique(age), ordered = TRUE)
            )
Ten slotte, om de door ons gemaakte specificatie op de oorspronkelijke dataframe toe te passen who moeten we het argument gebruiken spec in de functie pivot_longer().
who %>% pivot_longer(spec = spec)
#> # A tibble: 405,440 x 8
#>    country     iso2  iso3   year diagnosis gender age   count
#>    <chr>       <chr> <chr> <int> <chr>     <fct>  <ord> <int>
#>  1 Afghanistan AF    AFG    1980 sp        m      014      NA
#>  2 Afghanistan AF    AFG    1980 sp        m      1524     NA
#>  3 Afghanistan AF    AFG    1980 sp        m      2534     NA
#>  4 Afghanistan AF    AFG    1980 sp        m      3544     NA
#>  5 Afghanistan AF    AFG    1980 sp        m      4554     NA
#>  6 Afghanistan AF    AFG    1980 sp        m      5564     NA
#>  7 Afghanistan AF    AFG    1980 sp        m      65       NA
#>  8 Afghanistan AF    AFG    1980 sp        f      014      NA
#>  9 Afghanistan AF    AFG    1980 sp        f      1524     NA
#> 10 Afghanistan AF    AFG    1980 sp        f      2534     NA
#> # … with 405,430 more rows
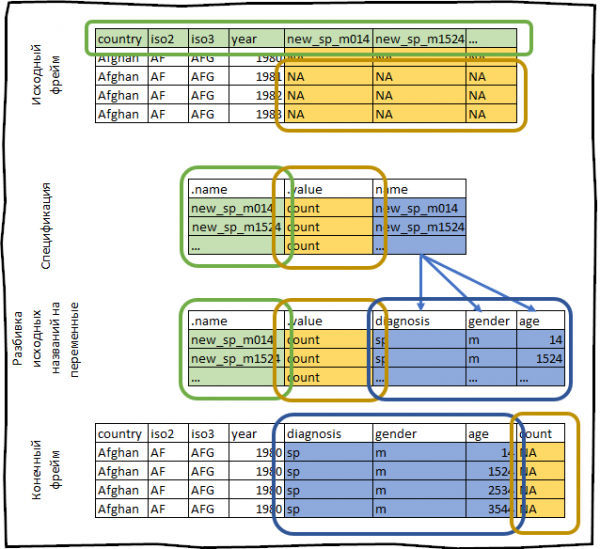
Alles wat we net hebben gedaan kan schematisch als volgt worden weergegeven:
Specificatie met meerdere waarden (.value)
In het bovenstaande voorbeeld bevatte de specificatiekolom .value slechts één waarde, wat in de meeste gevallen ook zo is.
Maar af en toe kan er een situatie ontstaan waarin je gegevens uit kolommen met verschillende datatypes moet verzamelen. Met de verouderde functie spread() zou dat behoorlijk moeilijk zijn om te doen.
Het onderstaande voorbeeld is ontleend aan het pakket data.table.
Laten we een trainingsdataframe maken.
family <- tibble::tribble(
  ~family,  ~dob_child1,  ~dob_child2, ~gender_child1, ~gender_child2,
       1L, "1998-11-26", "2000-01-29",             1L,             2L,
       2L, "1996-06-22",           NA,             2L,             NA,
       3L, "2002-07-11", "2004-04-05",             2L,             2L,
       4L, "2004-10-10", "2009-08-27",             1L,             1L,
       5L, "2000-12-05", "2005-02-28",             2L,             1L,
)
family % mutate_at(vars(starts_with("dob")), parse_date)
#> # A tibble: 5 x 5
#> family dob_child1 dob_child2 gender_child1 gender_child2
#> <int> <date> <date> <int> <int>
#> 1 1 1998-11-26 2000-01-29 1 2
#> 2 2 1996-06-22 NA 2 NA
#> 3 3 2002-07-11 2004-04-05 2 2
#> 4 4 2004-10-10 2009-08-27 1 1
#> 5 5 2000-12-05 2005-02-28 2 1Het gecreëerde dataframe bevat in elke rij gegevens over de kinderen van één gezin. In gezinnen kan er één of twee kinderen zijn. Voor elk kind worden gegevens over de geboortedatum en het geslacht verschaft, waarbij de gegevens per kind in aparte kolommen komen. Onze taak is om deze gegevens naar het juiste formaat voor analyse te brengen.
Let op dat we twee variabelen hebben met informatie over elk kind: hun geslacht en geboortedatum (de kolommen met de prefix dop bevatten de geboortedatum, de kolommen met de prefix gender bevatten het geslacht van het kind). In het verwachte resultaat moeten ze in aparte kolommen staan. We kunnen dit doen door een specificatie te genereren waarin de kolom .value twee verschillende waarden zal hebben.
spec %
  pivot_longer_spec(-family) %>%
  separate(col = name, into = c(".value", "child"))%>%
  mutate(child = parse_number(child))
#> # A tibble: 4 x 3
#>   .name         .value child
#>   <chr>         <chr>  <dbl>
#> 1 dob_child1    dob        1
#> 2 dob_child2    dob        2
#> 3 gender_child1 gender     1
#> 4 gender_child2 gender     2
Laten we dus stap voor stap de acties doornemen die door de bovenstaande code worden uitgevoerd.
pivot_longer_spec(-family)— we creëren een specificatie die alle bestaande kolommen behalve de kolom family samenvoegt.separate(col = name, into = c(".value", "child"))— we splitsen de kolom .naam, die de namen van de oorspronkelijke velden bevat, op basis van het underscore en brengen de verkregen waarden in de kolommen .value en kind.mutate(child = parse_number(child))— we converteer de waarden van het veld kind van tekst naar numerieke datatype.
Nu kunnen we de verkregen specificatie toepassen op het oorspronkelijke dataframe, om de tabel in de gewenste vorm te brengen.
family %>%
    pivot_longer(spec = spec, na.rm = T)
#> # A tibble: 9 x 4
#> family child dob gender
#> <int> <dbl> <date> <int>
#> 1 1 1 1998-11-26 1
#> 2 1 2 2000-01-29 2
#> 3 2 1 1996-06-22 2
#> 4 3 1 2002-07-11 2
#> 5 3 2 2004-04-05 2
#> 6 4 1 2004-10-10 1
#> 7 4 2 2009-08-27 1
#> 8 5 1 2000-12-05 2
#> 9 5 2 2005-02-28 1We gebruiken de parameter na.rm = TRUE, omdat de huidige datavorm ons dwingt om extra rijen te creëren voor niet-bestaande waarnemingen. Aangezien gezin 2 slechts één kind heeft, na.rm = TRUE garandeert dat gezin 2 één rij in de uitvoergegevens zal hebben.
Conversie van dataframes van een lang formaat naar een breed formaat
pivot_wider() — is a reverse transformation, and conversely increases the number of columns in the data frame by reducing the number of rows.
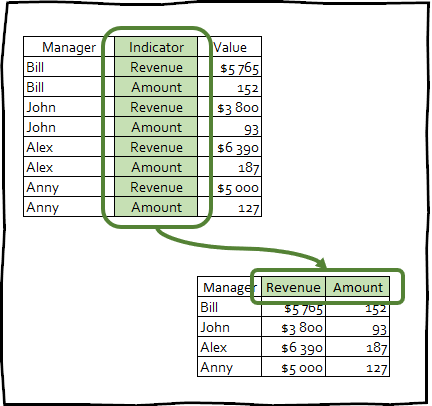
Such transformations are rarely used to tidy up data, however, this method can be useful for creating summary tables used in presentations, or for integration with other tools.
In fact, the functions pivot_longer() en pivot_wider() are symmetric, performing inverse actions on each other, i.e.: df %>% pivot_longer(spec = spec) %>% pivot_wider(spec = spec) en df %>% pivot_wider(spec = spec) %>% pivot_longer(spec = spec) will return the original df.
Een eenvoudig voorbeeld van het netjes formatteren van een tabel naar een breed formaat
To demonstrate the function's operation, pivot_wider() we will use the dataset fish_encounters, which contains information about how various stations track fish movement in the river.
#> # A tibble: 114 x 3
#>    fish  station  seen
#>    <fct> <fct>   <int>
#>  1 4842  Release     1
#>  2 4842  I80_1       1
#>  3 4842  Lisbon      1
#>  4 4842  Rstr        1
#>  5 4842  Base_TD     1
#>  6 4842  BCE         1
#>  7 4842  BCW         1
#>  8 4842  BCE2        1
#>  9 4842  BCW2        1
#> 10 4842  MAE         1
#> # … with 104 more rows
In most cases, this table will be more informative and convenient if the information for each station is presented in a separate column.
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
#> # A tibble: 19 x 12
#>    fish  Release I80_1 Lisbon  Rstr Base_TD   BCE   BCW  BCE2  BCW2   MAE
#>        &;
#>  1 4842        1     1      1     1       1     1     1     1     1     1
#>  2 4843        1     1      1     1       1     1     1     1     1     1
#>  3 4844        1     1      1     1       1     1     1     1     1     1
#>  4 4845        1     1      1     1       1    NA    NA    NA    NA    NA
#>  5 4847        1     1      1    NA      NA    NA    NA    NA    NA    NA
#>  6 4848        1     1      1     1      NA    NA    NA    NA    NA    NA
#>  7 4849        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#>  8 4850        1     1     NA     1       1     1     1    NA    NA    NA
#>  9 4851        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> 10 4854        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> # … with 9 more rows, and 1 more variable: MAW
This dataset only records information when a fish has been detected by a station, i.e., if any fish was not recorded by a certain station, that data will not be present in the table. This means that the output will be filled with NA.
However, in this case, we know that the absence of a record means the fish was not observed, so we can use the argument values_fill in de functie pivot_wider() and fill these missing values with zeros:
fish_encounters %>% pivot_wider(
  names_from = station,
  values_from = seen,
  values_fill = list(seen = 0)
)
#> # A tibble: 19 x 12
#> fish Release I80_1 Lisbon Rstr Base_TD BCE BCW BCE2 BCW2 MAE
#> <fct> <int> <int> <int> <int> <int> <int> <int> <int> <int> <int>
#> 1 4842 1 1 1 1 1 1 1 1 1 1
#> 2 4843 1 1 1 1 1 1 1 1 1 1
#> 3 4844 1 1 1 1 1 1 1 1 1 1
#> 4 4845 1 1 1 1 1 0 0 0 0 0
#> 5 4847 1 1 1 0 0 0 0 0 0 0
#> 6 4848 1 1 1 1 0 0 0 0 0 0
#> 7 4849 1 1 0 0 0 0 0 0 0 0
#> 8 4850 1 1 0 1 1 1 1 0 0 0
#> 9 4851 1 1 0 0 0 0 0 0 0 0
#> 10 4854 1 1 0 0 0 0 0 0 0 0
#> # … with 9 more rows, and 1 more variable: MAW <int>Genereren van een kolomnaam uit meerdere oorspronkelijke variabelen
Stel je voor dat we een tabel hebben met een combinatie van product, land en jaar. Om een test datakader te genereren, kun je de volgende code uitvoeren:
df %
  filter((product == "A" & country == "AI") | product == "B") %>%
  mutate(value = rnorm(nrow(.)))
#> # A tibble: 45 x 4
#> product country year value
#> <chr> <chr> <int> <dbl>
#> 1 A AI 2000 -2.05
#> 2 A AI 2001 -0.676
#> 3 A AI 2002 1.60
#> 4 A AI 2003 -0.353
#> 5 A AI 2004 -0.00530
#> 6 A AI 2005 0.442
#> 7 A AI 2006 -0.610
#> 8 A AI 2007 -2.77
#> 9 A AI 2008 0.899
#> 10 A AI 2009 -0.106
#> # … with 35 more rowsOnze taak is om het datakader uit te breiden zodat één kolom gegevens bevat voor elke combinatie van product en land. Hiervoor hoef je alleen maar door te geven in het argument names_from vector die de namen van de samen te voegen velden bevat.
df %>% pivot_wider(names_from = c(product, country),
                 values_from = "value")
#> # A tibble: 15 x 4
#> year A_AI B_AI B_EI
#> <int> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 0.607 1.20
#> 2 2001 -0.676 1.65 -0.114
#> 3 2002 1.60 -0.0245 0.501
#> 4 2003 -0.353 1.30 -0.459
#> 5 2004 -0.00530 0.921 -0.0589
#> 6 2005 0.442 -1.55 0.594
#> 7 2006 -0.610 0.380 -1.28
#> 8 2007 -2.77 0.830 0.637
#> 9 2008 0.899 0.0175 -1.30
#> 10 2009 -0.106 -0.195 1.03
#> # … with 5 more rowsJe kunt ook specificaties toepassen op de functie pivot_wider(). Maar bij het indienen in pivot_wider() de specificatie voert een conversie uit, die het tegenovergestelde is van pivot_longer(): kolommen worden gemaakt, zoals opgegeven in .naam, met gebruik van waarden uit .value en andere kolommen.
Voor deze dataset kun je een aangepaste specificatie genereren als je wilt dat elke mogelijke combinatie van land en product een eigen kolom krijgt, niet alleen de aanwezige in de gegevens:
spec %
  expand(product, country, .value = "value") %>%
  unite(".name", product, country, remove = FALSE)
#> # A tibble: 4 x 4
#> .name product country .value
#> <chr> <chr> <chr> <chr>
#> 1 A_AI A AI value
#> 2 A_EI A EI value
#> 3 B_AI B AI value
#> 4 B_EI B EI valuedf %>% pivot_wider(spec = spec) %>% head()#> # A tibble: 6 x 5
#> year A_AI A_EI B_AI B_EI
#> <int> <dbl> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 NA 0.607 1.20
#> 2 2001 -0.676 NA 1.65 -0.114
#> 3 2002 1.60 NA -0.0245 0.501
#> 4 2003 -0.353 NA 1.30 -0.459
#> 5 2004 -0.00530 NA 0.921 -0.0589
#> 6 2005 0.442 NA -1.55 0.594Enkele geavanceerde voorbeelden van werken met het nieuwe concept van tidyr
Het netjes formatteren van data aan de hand van de dataset over inkomen en huurprijzen in de VS
Dataset us_rent_income bevat informatie over het gemiddelde inkomen en de huurprijzen voor elke staat in de VS in 2017 (de dataset is beschikbaar in het pakket tidycensus).
us_rent_income
#> # A tibble: 104 x 5
#>    GEOID NAME       variable estimate   moe
#>
#>  1 01    Alabama    income      24476   136
#>  2 01    Alabama    rent          747     3
#>  3 02    Alaska     income      32940   508
#>  4 02    Alaska     rent         1200    13
#>  5 04    Arizona    income      27517   148
#>  6 04    Arizona    rent          972     4
#>  7 05    Arkansas   income      23789   165
#>  8 05    Arkansas   rent          709     5
#>  9 06    California income      29454   109
#> 10 06    California rent         1358     3
#> # … met 94 meer rijen
In de vorm waarin de gegevens zijn opgeslagen in de dataset us_rent_income is het uiterst ongemakkelijk om ermee te werken, dus we willen een dataset maken met de kolommen: rent, rent_moe, inkomen, income_moe. Er zijn veel manieren om deze specificatie te maken, maar het belangrijkste is dat we elke combinatie van waarden voor de variabele en estimate/moe, en vervolgens een kolomnaam genereren.
  spec %
    expand(variable, .value = c("estimate", "moe")) %>%
    mutate(
      .name = paste0(variable, ifelse(.value == "moe", "_moe", ""))
    )
#> # A tibble: 4 x 3
#> variable .value .name
#> <chr> <chr> <chr>
#> 1 income estimate income
#> 2 income moe income_moe
#> 3 rent estimate rent
#> 4 rent moe rent_moeHet verstrekken van deze specificatie pivot_wider() geeft ons het resultaat dat we zoeken:
us_rent_income %>% pivot_wider(spec = spec)
#> # A tibble: 52 x 6
#>    GEOID NAME                 income income_moe  rent rent_moe
#>    <chr> <chr>                 <dbl>      <dbl> <dbl>    <dbl>
#>  1 01    Alabama               24476        136   747        3
#>  2 02    Alaska                32940        508  1200       13
#>  3 04    Arizona               27517        148   972        4
#>  4 05    Arkansas              23789        165   709        5
#>  5 06    California            29454        109  1358        3
#>  6 08    Colorado              32401        109  1125        5
#>  7 09    Connecticut           35326        195  1123        5
#>  8 10    Delaware              31560        247  1076       10
#>  9 11    District of Columbia  43198        681  1424       17
#> 10 12    Florida               25952         70  1077        3
#> # … with 42 more rows
Wereldbank
Soms vereist het omzetten van een dataset naar de juiste vorm meerdere stappen.
Dataset world_bank_pop bevat gegevens van de Wereldbank over de bevolking van elk land van 2000 tot 2018.
#> # A tibble: 1,056 x 20
#>    country indicator `2000` `2001` `2002` `2003`  `2004`  `2005`   `2006`
#>    <chr>   <chr>      <dbl>  <dbl>  <dbl>  <dbl>   <dbl>   <dbl>    <dbl>
#>  1 ABW     SP.URB.T… 4.24e4 4.30e4 4.37e4 4.42e4 4.47e+4 4.49e+4  4.49e+4
#>  2 ABW     SP.URB.G… 1.18e0 1.41e0 1.43e0 1.31e0 9.51e-1 4.91e-1 -1.78e-2
#>  3 ABW     SP.POP.T… 9.09e4 9.29e4 9.50e4 9.70e4 9.87e+4 1.00e+5  1.01e+5
#>  4 ABW     SP.POP.G… 2.06e0 2.23e0 2.23e0 2.11e0 1.76e+0 1.30e+0  7.98e-1
#>  5 AFG     SP.URB.T… 4.44e6 4.65e6 4.89e6 5.16e6 5.43e+6 5.69e+6  5.93e+6
#>  6 AFG     SP.URB.G… 3.91e0 4.66e0 5.13e0 5.23e0 5.12e+0 4.77e+0  4.12e+0
#>  7 AFG     SP.POP.T… 2.01e7 2.10e7 2.20e7 2.31e7 2.41e+7 2.51e+7  2.59e+7
#>  8 AFG     SP.POP.G… 3.49e0 4.25e0 4.72e0 4.82e0 4.47e+0 3.87e+0  3.23e+0
#>  9 AGO     SP.URB.T… 8.23e6 8.71e6 9.22e6 9.77e6 1.03e+7 1.09e+7  1.15e+7
#> 10 AGO     SP.URB.G… 5.44e0 5.59e0 5.70e0 5.76e0 5.75e+0 5.69e+0  4.92e+0
#> # … with 1,046 more rows, and 11 more variables: `2007` <dbl>,
#> #   `2008` <dbl>, `2009` <dbl>, `2010` <dbl>, `2011` <dbl>, `2012` <dbl>,
#> #   `2013` <dbl>, `2014` <dbl>, `2015` <dbl>, `2016` <dbl>, `2017` <dbl>
Ons doel is om een nette dataset te creëren, waarbij elke variabele in een aparte kolom staat. Het is nog onduidelijk welke stappen precies nodig zijn, maar we beginnen met het meest voor de hand liggende probleem: het jaar is verdeeld over meerdere kolommen.
Om dit op te lossen, is het nodig om de functie te gebruiken pivot_longer().
pop2 %
  pivot_longer(`2000`:`2017`, names_to = "jaar")
#> # A tibble: 19,008 x 4
#> country indicator year value
#> <chr> <chr> <chr> <dbl>
#> 1 ABW SP.URB.TOTL 2000 42444
#> 2 ABW SP.URB.TOTL 2001 43048
#> 3 ABW SP.URB.TOTL 2002 43670
#> 4 ABW SP.URB.TOTL 2003 44246
#> 5 ABW SP.URB.TOTL 2004 44669
#> 6 ABW SP.URB.TOTL 2005 44889
#> 7 ABW SP.URB.TOTL 2006 44881
#> 8 ABW SP.URB.TOTL 2007 44686
#> 9 ABW SP.URB.TOTL 2008 44375
#> 10 ABW SP.URB.TOTL 2009 44052
#> # … with 18,998 more rowsDe volgende stap is om de indicatorvariabele te bekijken.
pop2 %>% count(indicator)
#> # A tibble: 4 x 2
#>   indicator       n
#>   <chr>       <int>
#> 1 SP.POP.GROW  4752
#> 2 SP.POP.TOTL  4752
#> 3 SP.URB.GROW  4752
#> 4 SP.URB.TOTL  4752
Waar SP.POP.GROW de bevolkingsgroei is, SP.POP.TOTL de totale bevolking, en SP.URB. * hetzelfde, maar alleen voor stedelijke gebieden. Laten we deze waarden splitsen in twee variabelen: area — gebied (totaal of stedelijk) en een variabele die de feitelijke gegevens bevat (bevolking of groei):
pop3 %
  separate(indicator, c(NA, "gebied", "variabele"))
#> # A tibble: 19,008 x 5
#> country area variable year value
#> <chr> <chr> <chr> <chr> <dbl>
#> 1 ABW URB TOTL 2000 42444
#> 2 ABW URB TOTL 2001 43048
#> 3 ABW URB TOTL 2002 43670
#> 4 ABW URB TOTL 2003 44246
#> 5 ABW URB TOTL 2004 44669
#> 6 ABW URB TOTL 2005 44889
#> 7 ABW URB TOTL 2006 44881
#> 8 ABW URB TOTL 2007 44686
#> 9 ABW URB TOTL 2008 44375
#> 10 ABW URB TOTL 2009 44052
#> # … with 18,998 more rowsNu hoeven we alleen nog maar de variabele variabele in twee kolommen te splitsen:
pop3 %>%
  pivot_wider(names_from = variabele, values_from = waarde)
#> # A tibble: 9,504 x 5
#> country area year TOTL GROW
#> <chr> <chr> <chr> <dbl> <dbl>
#> 1 ABW URB 2000 42444 1.18
#> 2 ABW URB 2001 43048 1.41
#> 3 ABW URB 2002 43670 1.43
#> 4 ABW URB 2003 44246 1.31
#> 5 ABW URB 2004 44669 0.951
#> 6 ABW URB 2005 44889 0.491
#> 7 ABW URB 2006 44881 -0.0178
#> 8 ABW URB 2007 44686 -0.435
#> 9 ABW URB 2008 44375 -0.698
#> 10 ABW URB 2009 44052 -0.731
#> # … with 9,494 more rowsContactlijst
Als laatste voorbeeld, stel je voor dat je een lijst met contacten hebt die je van een website hebt gekopieerd en geplakt:
contacts <- tribble(
  ~veld, ~waarde,
  "naam", "Jiena McLellan",
  "bedrijf", "Toyota",
  "naam", "John Smith",
  "bedrijf", "google",
  "email", "john@google.com",
  "naam", "Huxley Ratcliffe"
)
Deze lijst naar een tabelvorm brengen is vrij moeilijk, omdat er geen variabele is die aangeeft welke gegevens bij welk contact horen. We kunnen dit oplossen door op te merken dat de gegevens van elk nieuw contact beginnen met een naam ("naam"), dus we kunnen een unieke identificator maken die met één wordt verhoogd telkens wanneer de waarde “naam” in de kolom veld verschijnt:
contacts %
  mutate(
    person_id = cumsum(veld == "naam")
  )
contacts
#> # A tibble: 6 x 3
#> field value person_id
#> <chr> <chr> <int>
#> 1 name Jiena McLellan 1
#> 2 company Toyota 1
#> 3 name John Smith 2
#> 4 company google 2
#> 5 email john@google.com 2
#> 6 name Huxley Ratcliffe 3Nu we een unieke identificator voor elk contact hebben, kunnen we het veld en de waarde in kolommen draaien:
contacts %>%
  pivot_wider(names_from = veld, values_from = waarde)
#> # A tibble: 3 x 4
#> person_id name company email
#> <int> <chr> <chr> <chr>
#> 1 1 Jiena McLellan Toyota <NA>
#> 2 2 John Smith google john@google.com
#> 3 3 Huxley Ratcliffe <NA> <NA>Conclusie
Persoonlijk vind ik dat het nieuwe concept tidyr daadwerkelijk intuïtiever is en aanzienlijk beter presteert dan de verouderde functies. spread() en gather()Ik hoop dat dit artikel je heeft geholpen om te begrijpen met pivot_longer() en pivot_wider().
Bron: habr.com
