

De vertaling van het artikel is voorbereid ter voorbereiding op de start van de cursus
Gedistribueerd trainen op meerdere krachtige computereenheden kan de trainingstijd van moderne diepe neurale netwerken op grote gegevenssets verkorten van enkele weken tot uren of zelfs minuten, waardoor deze leermethode dominant wordt in praktische toepassingen van diep leren. Gebruikers moeten begrijpen hoe ze gegevens kunnen delen en synchroniseren op meerdere eenheden, wat op zijn beurt een grote impact heeft op de efficiëntie van schaalvergroting. Daarnaast moeten gebruikers ook weten hoe ze een trainingsscript kunnen implementeren op meerdere eenheden die op één eenheid draaien.
In dit artikel bespreken we een snelle en gemakkelijke manier van gedistribueerd leren met behulp van de open-source bibliotheek voor diep leren Apache MXNet en het framework voor gedistribueerd leren Horovod. We zullen de voordelen van het Horovod-framework op het gebied van prestaties illustreren en demonstreren hoe je een MXNet-trainingsscript kunt schrijven dat gedistribueerd werkt met Horovod.
Wat is Apache MXNet
is een open-source framework voor diep leren dat wordt gebruikt voor het bouwen, trainen en implementeren van diepe neurale netwerken. MXNet abstraheert de complexiteiten die gepaard gaan met de implementatie van neurale netwerken, biedt hoge prestaties en schaalbaarheid, en biedt API's voor populaire programmeertalen zoals , , , , , , en nog veel meer.
Gedistribueerd leren in MXNet met een parameterserver
maakt gebruik van een parameterserverbenadering. Het maakt gebruik van een set parameterservers om de gradaties van elke worker te verzamelen, aggregatie uit te voeren en de bijgewerkte gradaties terug te sturen naar de workers voor de volgende optimalisatie-iteratie. Het bepalen van de juiste verhouding van servers tot workers is de sleutel tot effectieve schaalwerking. Als er slechts één parameterserver is, kan dit een knelpunt vormen in de berekeningen. Aan de andere kant kan het gebruik van te veel servers de 'veel-naar-veel'-verbindingen verstoppen.
Wat is Horovod
– een open framework voor gedistribueerd diep leren, ontwikkeld door Uber. Het maakt gebruik van effectieve technologieën voor interactie tussen meerdere GPU's en knooppunten, zoals de NVIDIA Collective Communications Library (NCCL) en Message Passing Interface (MPI), om de modelparameters tussen de werkramen te verdelen en te aggregeren. Het optimaliseert het gebruik van netwerkbandbreedte en schaalt goed bij het werken met diepe neurale netwerkmodellen. Momenteel ondersteunt het verschillende populaire machine learning frameworks, namelijk , Tensorflow, Keras, en PyTorch.
Integratie van MXNet en Horovod
MXNet integreert met Horovod via de API voor gedistribueerd leren, zoals gedefinieerd in Horovod. In Horovod zijn de communicatieve API's horovod.broadcast(), horovod.allgather() en horovod.allreduce() geïmplementeerd met behulp van asynchrone callbacks van de MXNet-engine, als onderdeel van zijn taakgrafiek. Op deze manier worden datadependencies tussen communicatie en berekeningen gemakkelijk door de MXNet-engine afgehandeld om prestatieverlies door synchronisatie te voorkomen. Het object distributed optimizer, gedefinieerd in Horovod horovod.DistributedOptimizer breidt Optimizer in MXNet uit op een manier die het de overeenkomstige API's van Horovod aanroept voor de gedistribueerde updates van parameters. Al deze implementatiedetails zijn transparant voor eindgebruikers.
Snelle Start
Je kunt snel beginnen met het trainen van een klein convolutioneel neuraal netwerk op de MNIST-dataset met MXNet en Horovod op je MacBook.
Om te beginnen, installeer mxnet en horovod vanuit PyPI:
pip install mxnet
pip install horovod
Opmerking: Als je een fout ondervindt bij het pip install horovod, moet je mogelijk de variabele MACOSX_DEPLOYMENT_TARGET=10.vv, waar vv – dit is de versie van je MacOS-versie, bijvoorbeeld voor MacOSX Sierra moet je schrijven MACOSX_DEPLOYMENT_TARGET=10.12 pip install horovod
Installeer vervolgens OpenMPI .
Download ten slotte het testscript mxnet_mnist.py en voer de volgende commando's in de terminal van je MacBook uit in de werkdirectory:
mpirun -np 2 -H localhost:2 -bind-to none -map-by slot python mxnet_mnist.pyOp deze manier start je de training op twee kernen van je processor. De uitvoer zal als volgt zijn:
INFO:root:Epoch[0] Batch [0-50] Snelheid: 2248.71 monsters/sec      nauwkeurigheid=0.583640
INFO:root:Epoch[0] Batch [50-100] Snelheid: 2273.89 monsters/sec      nauwkeurigheid=0.882812
INFO:root:Epoch[0] Batch [50-100] Snelheid: 2273.39 monsters/sec      nauwkeurigheid=0.870000
Prestatie demonstratie
Bij het trainen van het ResNet50-v1 model op de ImageNet dataset met 64 GPU's met acht instanties p3.16xlarge Met EC2, waarbij elke instance 8 NVIDIA Tesla V100 GPU's in de AWS cloud bevat, hebben we een trainingsdoorvoer van 45000 beelden/seconde bereikt (dit is het aantal getrainde voorbeelden per seconde). De training werd na 90 epochs met de beste nauwkeurigheid van 75,7% in 44 minuten voltooid.
We vergeleken dit met gedistribueerde training met MXNet met een aanpak die parameterservers gebruikt op 8, 16, 32 en 64 GPU's tegen een server met één parameter en een verhouding van servers tot workers van 1:1 en 2:1 respectievelijk. Het resultaat kunt u zien in Figuur 1 hieronder. Op de y-as links tonen de kolommen het aantal beelden dat per seconde wordt getraind, terwijl de lijnen de schaalbaarheidsefficiëntie (oftewel de verhouding van de werkelijke doorvoer tot de ideale) op de rechter y-as weergeven. Zoals u kunt zien, heeft de keuze van het aantal servers invloed op de schaalbaarheidsefficiëntie. Als er slechts één parameterserver is, daalt de schaalbaarheidsefficiëntie tot 38% bij 64 GPU's. Om dezelfde schaalbaarheidsefficiëntie te bereiken als met Horovod, moet het aantal servers verdubbeld worden ten opzichte van het aantal workers.
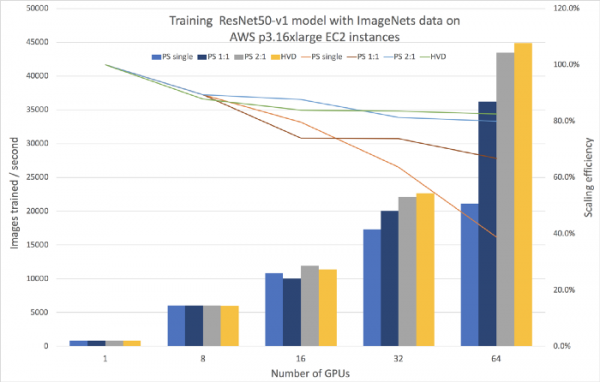
Figuur 1. Vergelijking van gedistribueerde training met MXNet met Horovod en met een parameterserver
In Tabel 1 hieronder vergelijken we de totale kosten van de instances tijdens de experimenten met 64 GPU's. Het gebruik van MXNet samen met Horovod biedt de beste doorvoer tegen de laagste kosten.
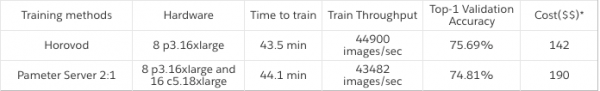
Tabel 1. Vergelijking van kosten tussen Horovod en een parameterserver met een verhouding van servers tot workers van 2:1.
Stappen voor replicatie
In de volgende stappen leggen we uit hoe u de resultaten van de gedistribueerde training met MXNet en Horovod kunt repliceren. Voor meer informatie over gedistribueerde training met MXNet lees .
Stap 1
Maak een cluster van homogene instances met MXNet versie 1.4.0 of hoger en Horovod versie 0.16.0 of hoger om gedistribueerde training te gebruiken. U moet ook bibliotheken installeren voor training op GPU's. Voor onze instances hebben we gekozen voor Ubuntu 16.04 Linux, met GPU Driver 396.44, CUDA 9.2, cuDNN library 7.2.1, communicator NCCL 2.2.13 en OpenMPI 3.1.1. U kunt ook gebruikmaken van , waar deze bibliotheken al zijn voorgeïnstalleerd.
Stap 2
Voeg aan je trainingsscript voor MXNet de mogelijkheid toe om met het Horovod-API te werken. Het onderstaande script, gebaseerd op de MXNet Gluon API, kan als een eenvoudig sjabloon worden gebruikt. De vetgedrukte regels zijn nodig als je al een bijbehorend trainingsscript hebt. Hier zijn enkele kritische wijzigingen die moeten worden aangebracht voor training met Horovod:
- Stel de context in op basis van de lokale rang van Horovod (regel 8), om te begrijpen dat de training op de juiste GPU wordt uitgevoerd.
- Geef de beginparameters door van één worker naar alle (regel 18), om ervoor te zorgen dat alle workers beginnen met dezelfde beginparameters.
- Maak Horovod DistributedOptimizer (regel 25), om de parameters verdeeld bij te werken.
Voor het volledige script, verwijs naar de voorbeelden van Horovod-MXNet en .
1  import mxnet as mx
2  import horovod.mxnet as hvd
3
4  # Horovod: initialiseer Horovod
5  hvd.init()
6
7  # Horovod: pin een GPU om te gebruiken voor lokale rang
8  context = mx.gpu(hvd.local_rank())
9
10 # Bouw model
11 model = ...
12
13 # Initialiseer parameters
14 model.initialize(initializer, ctx=context)
15 params = model.collect_params()
16
17 # Horovod: broadcast parameters
18 hvd.broadcast_parameters(params, root_rank=0)
19
20 # Creëer optimizer
21 optimizer_params = ...
22 opt = mx.optimizer.create('sgd', **optimizer_params)
23
24 # Horovod: wikkel optimizer met DistributedOptimizer
25 opt = hvd.DistributedOptimizer(opt)
26
27 # Creëer trainer en verliesfunctie
28 trainer = mx.gluon.Trainer(params, opt, kvstore=None)
29 loss_fn = ...
30
31 # Train model
32 for epoch in range(num_epoch):
33    ...
Stap 3
Log in op een van de workers om de gedistribueerde training te starten met behulp van de MPI-instructie. In dit voorbeeld wordt de gedistribueerde training gestart op vier instanties met 4 GPU's elk, en met 16 GPU's in totaal in het cluster. De stochastic gradient descent (SGD) optimizer zal worden gebruikt met de volgende hyperparameters:
- mini-batch grootte: 256
- leersnelheid: 0.1
- momentum: 0.9
- gewicht verval: 0.0001
Naarmate we opschalen van één GPU naar 64 GPU's, hebben we de leersnelheid lineair opgeschaald in overeenstemming met het aantal GPU's (van 0,1 voor 1 GPU tot 6,4 voor 64 GPU's), terwijl we het aantal beelden dat per GPU wordt behandeld op 256 hielden (van een batch van 256 beelden voor 1 GPU tot 16.384 voor 64 GPU's). De parameters gewicht verval en momentum werden aangepast naarmate het aantal GPU's toenam. We hebben gemengde precisie training gebruikt met de datatype float16 voor de forward pass en float32 voor de gradiënten, om de float16-berekeningen, ondersteund door NVIDIA Tesla GPU's, te versnellen.
$ mpirun -np 16
    -H server1:4,server2:4,server3:4,server4:4
    -bind-to none -map-by slot
    -mca pml ob1 -mca btl ^openib
    python mxnet_imagenet_resnet50.py
Conclusie
In dit artikel hebben we een schaalbare benadering van gedistribueerd modeltrainen besproken met Apache MXNet en Horovod. We hebben de effectiviteit van schaalvergroting en de kosteneffectiviteit in vergelijking met de aanpak met behulp van een parameter server op de ImageNet-dataset, waarop het ResNet50-v1-model werd getraind, aangetoond. Ook hebben we de stappen beschreven waarmee u een bestaand script kunt aanpassen om training op meerdere instanties met behulp van Horovod te starten.
Als u net begint met MXNet en diepe leermethoden, ga dan naar de installatiepagina , om eerst MXNet te bouwen. We raden ook sterk aan om het artikel te lezen , om aan de slag te gaan.
Als u al met MXNet hebt gewerkt en gedistribueerd leren met Horovod wilt uitproberen, kijk dan op de , bouw het met MXNet en volg het voorbeeld of .
*de kosten zijn berekend op basis van AWS voor EC2-instanties
Theorie en praktijk van het gebruik van ClickHouse in echte applicaties. Alexander Zaijcev (2018)
Bron: habr.com
