

Hallo, Habr-Bewohner. Zoals we al eerder hebben vermeld, lanceert OTUS deze maand twee cursussen over machine learning, namelijk en . Daarom blijven we nuttig materiaal delen.
Het doel van dit artikel is om onze eerste ervaringen met .
te delen. We beginnen met een overzicht van de tracking-server en loggen alle iteraties van het onderzoek. Vervolgens delen we onze ervaringen met het verbinden van Spark met MLflow via UDF.
Context
Wij bij gebruikt machine learning en kunstmatige intelligentie om mensen in staat te stellen voor hun gezondheid en welzijn te zorgen. Daarom zijn machine learning-modellen de basis van de dataverwerkingsproducten die we ontwikkelen, en daarom werd MLflow onze aandacht getrokken - een open-source platform dat alle aspecten van de levenscyclus van machine learning bestrijkt.
MLflow
Het belangrijkste doel van MLflow is om een extra laag bovenop machine learning te bieden, zodat data scientists met vrijwel elke machine learning-bibliotheek kunnen werken (, , , , en ), en zo de functionaliteit naar een hoger niveau tillen.
MLflow biedt drie componenten:
- Tracking – het vastleggen en opvragen van experimenten: code, data, configuratie en resultaten. Het volgen van het modelleerproces is erg belangrijk.
- Projecten – een verpakkingsformaat voor uitvoering op elk platform (bijvoorbeeld, )
- Modellen – een algemeen formaat voor het verzenden van modellen naar verschillende implementatietools.
MLflow (ten tijde van schrijven in alpha-versie) is een open-source platform dat het beheer van de levenscyclus van machine learning mogelijk maakt, inclusief experimenten, hergebruik en implementatie.
Instelling van MLflow
Om MLflow te gebruiken, moet je eerst de hele Python-omgeving instellen; hiervoor maken we gebruik van (om Python op Mac te installeren, kijk dan ). Op deze manier kunnen we een virtuele omgeving creëren waarin we alle noodzakelijke bibliotheken voor uitvoering installeren.
```
pyenv install 3.7.0
pyenv global 3.7.0 # Gebruik Python 3.7
mkvirtualenv mlflow # Maak een Virtuele Omgeving met Python 3.7
workon mlflow
```
Laten we de vereiste bibliotheken installeren.
```
pip install mlflow==0.7.0
            Cython==0.29
            numpy==1.14.5
            pandas==0.23.4
            pyarrow==0.11.0
```
Opmerking: we gebruiken PyArrow voor het uitvoeren van modellen zoals UDF. De versies van PyArrow en Numpy moesten worden aangepast, omdat de laatste versies conflicteerden.
We starten de Tracking UI
MLflow Tracking stelt ons in staat om experimenten te loggen en vragen te stellen via Python en API. Daarnaast kunnen we bepalen waar de modelartefacten worden opgeslagen (localhost, , , of ). Aangezien we bij Alpha Health gebruikmaken van AWS, zal S3 als opslag voor de artefacten dienen.
# Running a Tracking Server
mlflow server
    --file-store /tmp/mlflow/fileStore
    --default-artifact-root s3://<bucket>/mlflow/artifacts/
    --host localhost
    --port 5000
MLflow raadt aan om een permanente bestandsopslag te gebruiken. Bestandsopslag is de plek waar de server metadata van uitvoeringen en experimenten opslaat. Zorg ervoor dat de server bij het starten naar een permanente bestandsopslag wijst. Voor dit experiment maken we eenvoudig gebruik van /tmp.
Houd er rekening mee dat als we de mlflow-server willen gebruiken voor oude experimenten, deze aanwezig moeten zijn in de bestandsopslag. Maar zelfs zonder dit kunnen we ze gebruiken in UDF, omdat we alleen het pad naar het model nodig hebben.
Opmerking: Houd er rekening mee dat de Tracking UI en de modelclient toegang moeten hebben tot de locatie van het artefact. Dat wil zeggen, ongeacht of de Tracking UI zich op een EC2-instantie bevindt, moet de machine bij lokaal draaien van MLflow directe toegang tot S3 hebben om modelartefacten te schrijven.
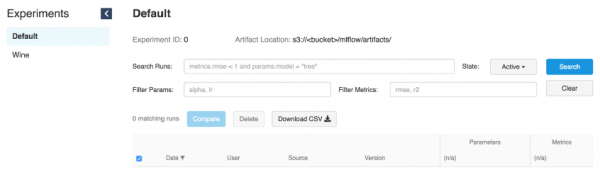
Tracking UI slaat artefacten op in een S3-bucket
Modellen draaien
Zodra de Tracking-server operationeel is, kunnen we beginnen met het trainen van modellen.
Als voorbeeld gebruiken we de aanpassing van wijn uit het MLflow-voorbeeld in .
MLFLOW_TRACKING_URI=http://localhost:5000 python wine_quality.py
  --alpha 0.9
  --l1_ratio 0.5
  --wine_file ./data/winequality-red.csv
Zoals we al zeiden, stelt MLflow ons in staat om parameters, metrics en modelartefacten te loggen, zodat we kunnen volgen hoe ze zich ontwikkelen over iteraties. Deze functie is zeer nuttig, omdat we zo het beste model kunnen reproduceren door naar de Tracking-server te gaan of te begrijpen welke code de benodigde iteratie heeft uitgevoerd, door gebruik te maken van de git hash commit logs.
with mlflow.start_run():

    ... model ...

    mlflow.log_param("source", wine_path)
    mlflow.log_param("alpha", alpha)
    mlflow.log_param("l1_ratio", l1_ratio)

    mlflow.log_metric("rmse", rmse)
    mlflow.log_metric("r2", r2)
    mlflow.log_metric("mae", mae)

    mlflow.set_tag('domain', 'wine')
    mlflow.set_tag('predict', 'quality')
mlflow.sklearn.log_model(lr, "model") 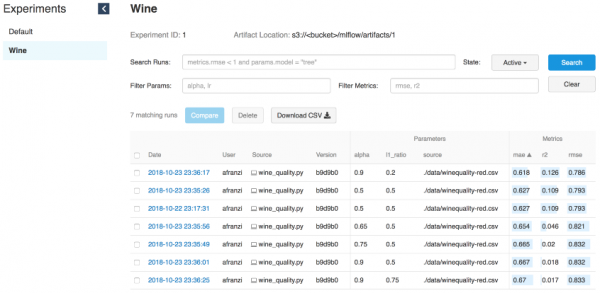
Wijniteraties
Servergedeelte voor het model
De trackingserver van MLflow, gestart met het commando “mlflow server”, heeft een REST API voor het volgen van runs en het vastleggen van gegevens in het lokale bestandssysteem. U kunt het adres van de trackingserver opgeven met de omgevingsvariabele «MLFLOW_TRACKING_URI» en de tracking API van MLflow zal automatisch verbinding maken met de trackingserver op dit adres om informatie over runs, log metrics, enz. te creëren/verkrijgen.
Bron:
Om het model te voorzien van een server, hebben we een actieve trackingserver (zie opstartinterface) en het Run ID van het model nodig.
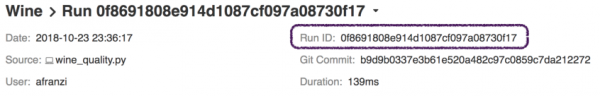
Run ID
# Serve a sklearn model through 127.0.0.0:5005
MLFLOW_TRACKING_URI=http://0.0.0.0:5000 mlflow sklearn serve
  --port 5005
  --run_id 0f8691808e914d1087cf097a08730f17
  --model-path model
Voor het beheren van modellen met de functionaliteit MLflow serve, hebben we toegang tot de Tracking UI nodig om informatie over het model te verkrijgen door eenvoudig --run_id.
Zodra het model verbinding maakt met de trackingserver, kunnen we een nieuwe eindpunt van het model verkrijgen.
# Query Tracking Server Endpoint
curl -X POST
  http://127.0.0.1:5005/invocations
  -H 'Content-Type: application/json'
  -d '[
	{
		"fixed acidity": 3.42,
		"volatile acidity": 1.66,
		"citric acid": 0.48,
		"residual sugar": 4.2,
		"chloridessssss": 0.229,
		"free sulfur dsioxide": 19,
		"total sulfur dioxide": 25,
		"density": 1.98,
		"pH": 5.33,
		"sulphates": 4.39,
		"alcohol": 10.8
	}
]'

> {"predictions": [5.825055635303461]}
Modellen uitvoeren vanuit Spark
Hoewel de trackingserver krachtig genoeg is om modellen in real-time te beheren, zoals training en het gebruik van de serve-functionaliteit (bron: ), is het gebruik van Spark (batch of streaming) een nog krachtiger oplossing door de gedistribueerde aard.
Stelt u zich voor dat u net een training offline heeft uitgevoerd en vervolgens het getrainde model op al uw gegevens hebt toegepast. Dit is waar Spark en MLflow hun beste prestaties tonen.
Installeer PySpark + Jupyter + Spark
Bron:
Om te laten zien hoe we MLflow-modellen op Spark-dataframes toepassen, moeten we Jupyter notebooks instellen om samen te werken met PySpark.
Begin met het installeren van de nieuwste stabiele versie :
cd ~/Downloads/
tar -xzf spark-2.4.3-bin-hadoop2.7.tgz
mv ~/Downloads/spark-2.4.3-bin-hadoop2.7 ~/
ln -s ~/spark-2.4.3-bin-hadoop2.7 ~/spark
Installeer PySpark en Jupyter in een virtuele omgeving:
pip install pyspark jupyterStel de omgevingsvariabelen in:
export SPARK_HOME=~/spark
export PATH=$SPARK_HOME/bin:$PATH
export PYSPARK_DRIVER_PYTHON=jupyter
export PYSPARK_DRIVER_PYTHON_OPTS="notebook --notebook-dir=${HOME}/Projects/notebooks"
Door notebook-dir, kunnen we onze notebooks in de gewenste map opslaan.
Jupyter starten vanuit PySpark
Aangezien we Jupiter als de PySpark-driver hebben ingesteld, kunnen we nu Jupyter notebook in de context van PySpark starten.
(mlflow) afranzi:~$ pyspark
[I 19:05:01.572 NotebookApp] sparkmagic extensie ingeschakeld!
[I 19:05:01.573 NotebookApp] Notebooks worden bediend vanuit lokale directory: /Users/afranzi/Projects/notebooks
[I 19:05:01.573 NotebookApp] De Jupyter Notebook draait op:
[I 19:05:01.573 NotebookApp] http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745
[I 19:05:01.573 NotebookApp] Gebruik Control-C om deze server te stoppen en alle kernels af te sluiten (twee keer om bevestiging over te slaan).
[C 19:05:01.574 NotebookApp]

    Kopieer/plak deze URL in uw browser wanneer u voor de eerste keer verbinding maakt,
    om in te loggen met een token:
http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745 
Zoals hierboven vermeld, biedt MLflow de functie voor het loggen van modelartefacten naar S3. Zodra we het geselecteerde model in handen hebben, kunnen we het importeren als UDF met behulp van de module mlflow.pyfunc.
import mlflow.pyfunc

model_path = 's3:///mlflow/artifacts/1/0f8691808e914d1087cf097a08730f17/artifacts/model'
wine_path = '/Users/afranzi/Projects/data/winequality-red.csv'
wine_udf = mlflow.pyfunc.spark_udf(spark, model_path)

df = spark.read.format("csv").option("header", "true").option('delimiter', ';').load(wine_path)
columns = [ "fixed acidity", "volatile acidity", "citric acid",
            "residual sugar", "chlorides", "free sulfur dioxide",
            "total sulfur dioxide", "density", "pH",
            "sulphates", "alcohol"
          ]

df.withColumn('prediction', wine_udf(*columns)).show(100, False) 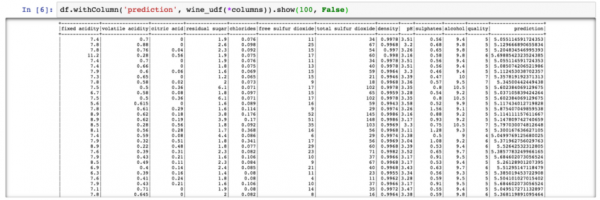
PySpark – Voorspelling van wijnkwaliteit
Tot nu toe hebben we besproken hoe PySpark te gebruiken met MLflow door de wijnkwaliteitsvoorspelling op de gehele dataset uit te voeren. Maar wat te doen als we Python MLflow-modules vanuit Scala Spark willen gebruiken?
We hebben dit getest door de Spark-context tussen Scala en Python te delen. Dat wil zeggen, we hebben MLflow UDF in Python geregistreerd en deze uit Scala gebruikt (ja, het is misschien niet de beste oplossing, maar wat we hebben).
Scala Spark + MLflow
Voor dit voorbeeld voegen we toe aan de bestaande Jupyter.
Installeren van Spark + Toree + Jupyter
pip install toree
jupyter toree install --spark_home=${SPARK_HOME} --sys-prefix
jupyter kernelspec list
```
```
Beschikbare kernels:
  apache_toree_scala    /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/apache_toree_scala
  python3               /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/python3
```
Zoals te zien is in de bijgevoegde notebook, wordt UDF samen met Spark en PySpark gebruikt. We hopen dat dit deel nuttig zal zijn voor degenen die van Scala houden en machine learning-modellen in productie willen implementeren.
import org.apache.spark.sql.functions.col
import org.apache.spark.sql.types.StructType
import org.apache.spark.sql.{Column, DataFrame}
import scala.util.matching.Regex

val FirstAtRe: Regex = "^_".r
val AliasRe: Regex = "[\s_.:@]+".r

def getFieldAlias(field_name: String): String = {
    FirstAtRe.replaceAllIn(AliasRe.replaceAllIn(field_name, "_"), "")
}

def selectFieldsNormalized(columns: List[String])(df: DataFrame): DataFrame = {
    val fieldsToSelect: List[Column] = columns.map(field =>
        col(field).as(getFieldAlias(field))
    )
    df.select(fieldsToSelect: _*)
}

def normalizeSchema(df: DataFrame): DataFrame = {
    val schema = df.columns.toList
    df.transform(selectFieldsNormalized(schema))
}

FirstAtRe = ^_
AliasRe = [s_.:@]+

getFieldAlias: (field_name: String)String
selectFieldsNormalized: (columns: List[String])(df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
normalizeSchema: (df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
Out[1]:
[s_.:@]+
In [2]:
val winePath = "~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv"
val modelPath = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"

winePath = ~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv
modelPath = \/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
Out[2]:
\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
In [3]:
val df = spark.read
              .format("csv")
              .option("header", "true")
              .option("delimiter", ";")
              .load(winePath)
              .transform(normalizeSchema)

df = [fixed_acidity: string, volatile_acidity: string ... 10 more fields]
Out[3]:
[fixed_acidity: string, volatile_acidity: string ... 10 more fields]
In [4]:
%%PySpark
import mlflow
from mlflow import pyfunc

model_path = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"
wine_quality_udf = mlflow.pyfunc.spark_udf(spark, model_path)

spark.udf.register("wineQuality", wine_quality_udf)
Out[4]:
<function spark_udf..predict at 0x1116a98c8>
In [6]:
df.createOrReplaceTempView("wines")
In [10]:
%%SQL
SELECT
    quality,
    wineQuality(
        fixed_acidity,
        volatile_acidity,
        citric_acid,
        residual_sugar,
        chlorides,
        free_sulfur_dioxide,
        total_sulfur_dioxide,
        density,
        pH,
        sulphates,
        alcohol
    ) AS prediction
FROM wines
LIMIT 10
Out[10]:
+-------+------------------+
|quality|        prediction|
+-------+------------------+
|      5| 5.576883967129615|
|      5|  5.50664776916154|
|      5| 5.525504822954496|
|      6| 5.504311247097457|
|      5| 5.576883967129615|
|      5|5.5556903912725755|
|      5| 5.467882654744997|
|      7| 5.710602976324739|
|      7| 5.657319539336507|
|      5| 5.345098606538708|
+-------+------------------+

In [17]:
spark.catalog.listFunctions.filter('name like "%wineQuality%").show(20, false)

+-----------+--------+-----------+---------+-----------+
|name       |database|description|className|isTemporary|
+-----------+--------+-----------+---------+-----------+
|wineQuality|null    |null       |null     |true       |
+-----------+--------+-----------+---------+-----------+
Volgende stappen
Hoewel MLflow op het moment van schrijven zich nog in de Alpha-fase bevindt, ziet het er veelbelovend uit. Alleen al de mogelijkheid om meerdere machine learning-frameworks te draaien en deze vanuit één eindpunt te gebruiken, tilt aanbevelingssystemen naar een hoger niveau.
Bovendien brengt MLflow data-engineers en data scientists dichter bij elkaar door een gemeenschappelijke laag tussen hen te leggen.
Na dit onderzoek naar MLflow zijn we ervan overtuigd dat we verder zullen gaan en het zullen gebruiken voor onze Spark-pijplijnen en in aanbevelingssystemen.
Het zou handig zijn om de bestandsopslag te synchroniseren met de database in plaats van met het bestandssysteem. Zo zouden we meerdere eindpunten moeten kunnen krijgen die dezelfde bestandsopslag kunnen gebruiken. Bijvoorbeeld, meerdere instanties gebruiken en met dezelfde Glue metastore.
Terugkijkend, willen we de MLFlow-community bedanken voor het interessanter maken van ons werk met gegevens.
Als je met MLflow speelt, aarzel dan niet om ons te schrijven en ons te vertellen hoe je het gebruikt, vooral als je het in productie gebruikt.
Meer informatie over de cursussen:
Lees meer:
Bron: habr.com
