

Deze twee trendy termen, die verband houden met Data Science, verwarren veel mensen. Data Mining wordt vaak verkeerd begrepen als het extraheren en verkrijgen van gegevens, maar in werkelijkheid is het veel complexer. In deze post zullen we de zaken helder maken en het verschil tussen Data Mining en Data Extraction uitleggen.
Wat is Data Mining?
Data mining, ook wel genoemd Kennisontdekking in databases (KDD), is een methode die vaak wordt gebruikt voor het analyseren van grote hoeveelheden gegevens met behulp van statistische en wiskundige methoden om verborgen patronen of trends te vinden en waarde eruit te extraheren.
Wat kan er gedaan worden met Data Mining?
Door het proces te automatiseren, kunnen databases doorbladeren en effectief verborgen patronen identificeren. Voor bedrijven wordt data mining vaak gebruikt om patronen en relaties in gegevens te ontdekken, wat helpt bij het nemen van optimale zakelijke beslissingen.
Voorbeelden van toepassingen
Nadat data mining in de jaren '90 wijdverbreid werd, begonnen bedrijven in een breed scala van sectoren, waaronder detailhandel, financiën, gezondheidszorg, transport, telecommunicatie, e-commerce, enz., methoden van data mining te gebruiken om inzichten op basis van gegevens te verkrijgen. Data mining kan helpen bij het segmenteren van klanten, het identificeren van fraude, het voorspellen van verkopen en meer.
- Klantssegmentatie
Door klantgegevens te analyseren en kenmerken van doelklanten te identificeren, kunnen bedrijven hen in aparte groepen indelen en speciale aanbiedingen doen die aan hun behoeften voldoen. - Marktonderzoekanalyse
Deze methode is gebaseerd op de theorie dat als je een bepaalde groep producten koopt, je waarschijnlijk ook een andere groep producten zult kopen. Een bekend voorbeeld: wanneer vaders luiers kopen voor hun baby’s, kopen ze doorgaans ook bier samen met de luiers. - Verkoopvoorspelling
Dit lijkt misschien op een analyse van de marktkorf, maar deze keer wordt data-analyse gebruikt om te voorspellen wanneer een koper in de toekomst opnieuw een product zal aankopen. Bijvoorbeeld, een coach koopt een blik eiwitpoeder dat 9 maanden moet meegaan. De winkel die deze eiwitpoeder verkoopt, is van plan om over 9 maanden een nieuw product uit te brengen, zodat de coach het opnieuw kan kopen. - Fraudedetectie
Data mining helpt bij het bouwen van modellen voor fraudedetectie. Door monsters van frauduleuze en legitieme rapporten te verzamelen, krijgen bedrijven het recht om te bepalen welke transacties verdacht zijn. - Patroonherkenning in de productie
In de verwerkende industrie wordt data mining gebruikt om te helpen bij het ontwerpen van systemen, door de relaties tussen productarchitectuur, klantprofielen en behoeften te onthullen. Data mining kan ook de ontwikkelingstijd en kosten van producten voorspellen.
En dit zijn slechts enkele gebruiksscenario's voor data mining.
Fases van Data Mining
Data mining is een holistisch proces van verzamelen, selecteren, schoonmaken, transformeren en extraheren van gegevens om patronen te evalueren en uiteindelijk waarde te halen.
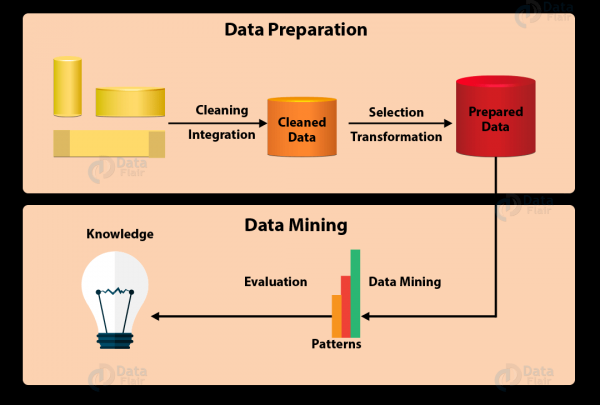
In het algemeen kan het hele data mining-proces worden samengevat in 7 fasen:
- Gegevensschoonmaak
In de echte wereld zijn gegevens niet altijd schoon en gestructureerd. Vaak zijn ze rommelig, onvolledig en kunnen ze fouten bevatten. Om ervoor te zorgen dat de resultaten van data mining nauwkeurig zijn, moeten de gegevens eerst worden schoongemaakt. Sommige schoonmaakmethoden omvatten het invullen van ontbrekende waarden, automatische en handmatige controle, enz. - Gegevensintegratie
Dit is de fase waarin gegevens uit verschillende bronnen worden geëxtraheerd, gecombineerd en geïntegreerd. Bronnen kunnen databases, tekstbestanden, spreadsheets, documenten, multidimensionale datamatrices, internet, enz. zijn. - Gegevenssampling
Normaal gesproken zijn niet alle geïntegreerde gegevens nodig in data mining. Gegevenssampling is de fase waarin alleen relevante gegevens uit een grote database worden geselecteerd en geëxtraheerd. - Gegevenstransformatie
Na het selecteren van gegevens worden deze getransformeerd in vormen die geschikt zijn voor mining. Dit proces omvat normalisatie, aggregatie, generalisatie, enz. - Intelligent datanalyse
Hier begint het belangrijkste deel van data mining - het gebruik van intelligente methoden om patronen te ontdekken. Het proces omvat regressie, classificatie, voorspelling, clustering, associatiestudies en meer. - Modelbeoordeling
Deze fase is gericht op het identificeren van potentieel nuttige, eenvoudig te begrijpen patronen, evenals patronen die hypotheses bevestigen. - Kennisrepresentatie
In de laatste fase wordt de verkregen informatie gepresenteerd in een aantrekkelijke vorm met behulp van kennisrepresentatie- en visualisatietechnieken.
Nadelen van Data Mining
- Grote investeringen in tijd en moeite
Aangezien data mining een langdurig en complex proces is, vereist het veel werk van productieve en gekwalificeerde mensen. Data-analyse-experts kunnen gebruikmaken van krachtige data mining-tools, maar hebben specialisten nodig voor data voorbereiding en begrip van de resultaten. Hierdoor kan het tijd kosten om alle informatie te verwerken. - Privacy en databeveiliging
Omdat data mining informatie over klanten verzamelt via marktmethoden, kan het de privacy van gebruikers schenden. Bovendien kunnen hackers toegang krijgen tot gegevens die in data mining-systemen zijn opgeslagen. Dit vormt een bedreiging voor de beveiliging van klantgegevens. Als gestolen gegevens verkeerd worden gebruikt, kan dit andere schade toebrengen.
Bovenstaande is een korte inleiding tot data mining. Zoals ik al eerder heb vermeld, omvat data mining het proces van gegevensverzameling en -integratie, waarbij het proces van data-extractie (data extraction) inbegrepen is. In dit geval kan met zekerheid worden gesteld dat data-extractie een onderdeel kan zijn van het langdurige proces van data mining.
Wat is Data Extractie?
Ook wel bekend als ‘webdata-extractie’ en ‘webscraping’, is dit proces de daad van het extraheren van gegevens uit (meestal ongestructureerde of slecht gestructureerde) gegevensbronnen naar gecentraliseerde locaties en het centraliseren op één plek voor opslag of verdere verwerking. Ongestructureerde gegevensbronnen omvatten in het bijzonder webpagina's, e-mails, documenten, PDF-bestanden, gescande tekst, mainframe-rapporten, spoolbestanden, advertenties, enzovoort. Gecentraliseerde opslag kan lokaal, in de cloud of hybride zijn. Het is belangrijk te onthouden dat data-extractie geen verwerking of andere analyse omvat die later kan plaatsvinden.
Wat kan er gedaan worden met Data Extractie?
Over het algemeen worden de doelen van data-extractie onderverdeeld in 3 categorieën.
- Archivering
Data-extractie kan gegevens uit fysieke formaten zoals boeken, kranten en facturen omzetten naar digitale formaten, zoals databases voor opslag of back-up. - Gegevensformaat veranderen
Wanneer u gegevens wilt overzetten van uw huidige website naar een nieuwe, die in ontwikkeling is, kunt u gegevens van uw eigen website verzamelen door deze te extraheren. - Gegevensanalyse
Het is gebruikelijk om extra analyses van de geëxtraheerde gegevens uit te voeren om inzicht hierin te krijgen. Dit kan lijken op gegevensanalyse bij data mining, maar houd in gedachten dat gegevensanalyse het doel van extractie is, maar niet een onderdeel ervan. Bovendien worden de gegevens op een andere manier geanalyseerd. Een voorbeeld is dat eigenaren van webwinkels informatie over producten van e-commerce websites, zoals Amazon, extraheren om concurrentiestrategieën in realtime te monitoren. Net als data mining is data-extractie een geautomatiseerd proces met vele voordelen. Voorheen copieerden mensen gegevens handmatig van de ene naar de andere plaats, wat veel tijd kostte. Data-extractie versnelt de verzameling en verhoogt aanzienlijk de nauwkeurigheid van de geëxtraheerde gegevens.
Enkele voorbeelden van toepassingen van Data Extractie
Net als data mining wordt data-extractie op grote schaal gebruikt in verschillende industrieën. Naast prijsmonitoring in de e-commerce kan data-extractie helpen bij eigen onderzoek, aggregatie van nieuws, marketing, vastgoed, reizen en toerisme, consultancy, financiën en veel meer.
- Leadgeneratie
Bedrijven kunnen gegevens extraheren uit directory's zoals Yelp, Crunchbase, Yellowpages en leads genereren voor de ontwikkeling van hun bedrijf. Bekijk de video hieronder om te leren hoe je gegevens uit Yellowpages kunt extraheren met behulp van . - Inhouds- en nieuwsaggregatie
Aggregator-websites kunnen reguliere gegevensstromen uit verschillende bronnen ontvangen en hun sites actueel houden. - Sentimentanalyse
Na het extraheren van beoordelingen, opmerkingen en feedback van sociale media zoals Instagram en Twitter, kunnen professionals de onderliggende meningen analyseren en inzicht krijgen in hoe het merk, product of fenomeen wordt waargenomen.
Stappen voor Data-extractie
Data-extractie is de eerste stap in ETL (Extract, Transform, Load) en ELT (Extract, Load, Transform). ETL en ELT maken zelf deel uit van een complete data-integratiestrategie. Met andere woorden, data-extractie kan een onderdeel zijn van hun winning.
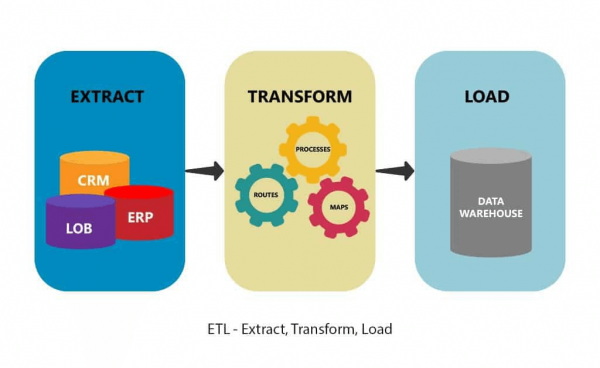
Extraheren, transformeren, laden
Terwijl data mining het verkrijgen van informatie uit grote hoeveelheden gegevens is, is data-extractie een veel korter en eenvoudiger proces. Het kan worden teruggebracht tot drie stappen:
- Kies een gegevensbron
Selecteer de bron waarvan je gegevens wilt extraheren, bijvoorbeeld een website. - Gegevensverzameling
Stuur een 'GET'-verzoek naar de site en analyseer het ontvangen HTML-document met programmeertalen zoals Python, PHP, R, Ruby, enz. - Gegevensopslag
Sla de gegevens op in je lokale database of in cloudopslag voor toekomstig gebruik. Als je een ervaren programmeur bent die gegevens wilt extraheren, kunnen de bovengenoemde stappen eenvoudig lijken. Maar als je niet programmeert, is er een kortere weg: gebruik dataraextractietools, zoals . Data extraction-tools, net als data mining-tools, zijn ontworpen om energie te besparen en het gegevensverwerkingsproces eenvoudig te maken voor iedereen. Deze tools zijn niet alleen kosteneffectief, maar ook gebruiksvriendelijk voor beginners. Ze stellen gebruikers in staat om gegevens binnen enkele minuten te verzamelen, deze in de cloud op te slaan en te exporteren naar verschillende formaten: Excel, CSV, HTML, JSON of naar databases op de website via API.
Nadelen van Data Extraction
- Serverfout
Bij het extraheren van gegevens op grote schaal kan de webserver van de doelwebsite overbelast raken, wat kan leiden tot serveruitval. Dit schaadt de belangen van de website-eigenaar. - IP-blokkering
Wanneer iemand te vaak gegevens verzamelt, kunnen websites zijn IP-adres blokkeren. De bron kan het IP-adres volledig verbieden of de toegang beperken, waardoor de gegevens incompleet worden. Om gegevens te extraheren en blokkering te vermijden, moet dit met een gematigde snelheid gebeuren en moeten er enkele anti-blokkeringsmethoden worden toegepast. - Juridische problemen
Gegevensextractie van het web valt in de grijze zone wat betreft legaliteit. Grote websites zoals LinkedIn en Facebook vermelden duidelijk in hun gebruiksvoorwaarden dat automatische gegevensextractie verboden is. Tussen bedrijven hebben veel rechtszaken plaatsgevonden vanwege botactiviteiten.
Belangrijke verschillen tussen Data Mining en Data Extraction
- Data mining staat ook bekend als kennisontdekking in databases, kennisextractie, data/patroonanalyse, informatieverzameling. Data extraction wordt uitwisselbaar gebruikt met webdata-extractie, webscraping, gegevensverzameling, enzovoort.
- Onderzoek naar data mining is voornamelijk gebaseerd op gestructureerde gegevens, terwijl bij gegevensextractie meestal gegevens uit ongestructureerde of slecht gestructureerde bronnen worden gehaald.
- Het doel van data mining is om gegevens nuttiger te maken voor analyse. Data extraction is het verzamelen van gegevens op één plaats waar ze kunnen worden opgeslagen of verwerkt.
- Analyse bij data mining is gebaseerd op wiskundige methoden voor het identificeren van patronen of trends. Data extraction is gebaseerd op programmeertalen of tools voor gegevensextractie om bronnen te doorzoeken.
- Het doel van data mining is om feiten te vinden die eerder onbekend of genegeerd waren, terwijl data extraction zich bezighoudt met bestaande informatie.
- Data mining is complex and requires significant investment in training people. Data extraction can be extremely simple and economical when using the right tool.
We help beginners not get lost in Data. Specifically for Hub.ru members, we've created a promo code HABR, die een extra korting van 10% biedt op de korting die op de banner wordt aangegeven.
Meer cursussen
Aanbevolen artikelen
Bron: habr.com
