

Hallo allemaal! Enkele maanden geleden hebben we ons nieuwe open-source project in productie genomen — een Grafana-plugin voor het monitoren van Kubernetes, die we hebben genoemd . De broncode van de plugin is beschikbaar in . In dit artikel willen we onze ervaring delen over hoe we de plugin hebben ontwikkeld, welke tools we hebben gebruikt en met welke obstakels we tijdens het ontwikkelingsproces zijn geconfronteerd. Laten we beginnen!
Deel 0 — inleiding: hoe zijn we hier gekomen?
Het idee om onze eigen plugin voor Grafana te schrijven ontstond volkomen toevallig. Ons bedrijf houdt zich al meer dan 10 jaar bezig met het monitoren van webprojecten van verschillende complexiteitsniveaus. In de loop van deze tijd hebben we veel expertise, interessante casestudy's en ervaring met het gebruik van verschillende monitoringsystemen opgedaan. En op een gegeven moment vroegen we ons af: 'Bestaat er een magische tool voor het monitoren van Kubernetes, zodat je het kunt insteken en vergeten?'... De standaard voor het monitoren van k8s is uiteraard al lang de combinatie van Prometheus + Grafana. Voor deze stack bestaan verschillende kant-en-klare oplossingen: prometheus-operator, een set dashboards kubernetes-mixin, grafana-kubernetes-app.
De meest interessante optie voor ons leek de grafana-kubernetes-app plugin, maar deze wordt al meer dan een jaar niet meer ondersteund en kan bovendien niet werken met nieuwe versies van node-exporter en kube-state-metrics. Op een gegeven moment besloten we: 'Waarom maken we niet onze eigen oplossing?'
Welke ideeën hebben we besloten te implementeren in onze plugin:
- visualisatie van de 'applicatiekaart': een handige weergave van applicaties in de cluster, gegroepeerd op namespace, deployments…;
- visualisatie van de relaties in de vorm van 'deployment — service (+ports)'.
- visualisatie van de distributie van applicaties in de cluster over de nodes van de cluster.
- verzamelen van metrics en informatie uit meerdere bronnen: Prometheus en k8s api server.
- monitoring van zowel de infrastructuur (gebruik van CPU-tijd, geheugen, opslag, netwerk) als de logica van de applicaties — health-status van pods, aantal beschikbare replicas, informatie over liveness/readyness probes.
Deel 1: Wat is een 'plugin voor Grafana'?
Technisch gezien is een plugin voor Grafana een Angular-controller die wordt opgeslagen in de data-directory van Grafana (/var/grafana/plugins/<your_plugin_name>/dist/module.js) en kan worden geladen als een SystemJS-module. Daarnaast moet er in deze directory een bestand plugin.json aanwezig zijn, dat alle metadata van je plugin bevat: naam, versie, type plugin, links naar repository/site/licentie, afhankelijkheden, enzovoort.
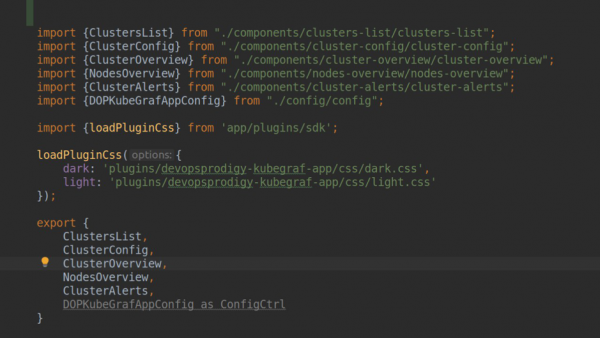
module.ts
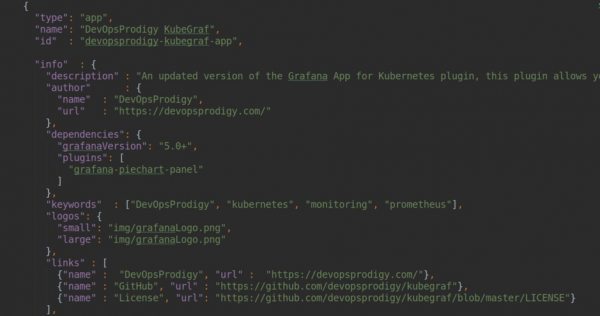
plugin.json
Zoals te zien is op de screenshot, hebben we plugin.type = app opgegeven. Plugins voor Grafana kunnen van drie soorten zijn:
paneel: het meest voorkomende type plugin – stelt een paneel voor voor de visualisatie van bepaalde metrics, wordt gebruikt voor het maken van verschillende dashboards.
datasource: een plugin-connector naar een bepaalde dataset (bijvoorbeeld Prometheus-datasource, ClickHouse-datasource, ElasticSearch-datasource).
app: een plugin waarmee je je eigen frontend-applicatie binnen Grafana kunt bouwen, je eigen html-pagina's kunt maken en handmatig naar datasource kunt verwijzen voor de visualisatie van verschillende gegevens. Ook kunnen plugins van andere types (datasource, paneel) en verschillende dashboards als afhankelijkheden worden gebruikt.
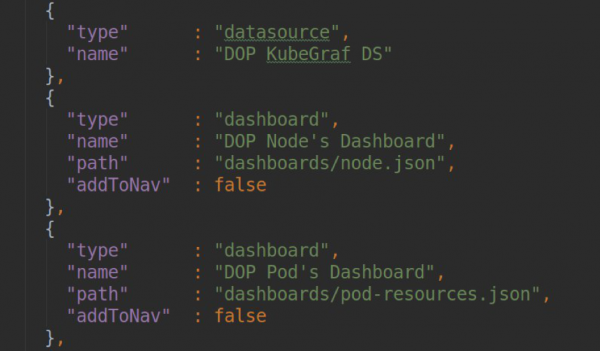
Voorbeeld van afhankelijkheden van een plugin met type = app.
Als programmeertaal kan zowel JavaScript als TypeScript worden gebruikt (wij hebben voor deze laatste gekozen). Vooraf gemaakte starters voor hello-world plugins van elk type kun je : in deze repository is een grote hoeveelheid starter-packs beschikbaar (er is zelfs een experimenteel voorbeeld van een plugin in React) met vooraf geïnstalleerde en geconfigureerde bundlers.
Deel 2: voorbereiding van de lokale omgeving
Voor het werken aan de plugin hebben we natuurlijk een Kubernetes-cluster nodig met alle vooraf geïnstalleerde tools: prometheus, node-exporter, kube-state-metrics, grafana. De omgeving moet snel, eenvoudig en ongecompliceerd worden opgezet, en om hot-reload mogelijk te maken, moet de data-directory van Grafana direct vanaf de ontwikkelaarsmachine worden gemonteerd.
De meest handige manier om lokaal met Kubernetes te werken, naar onze mening, is . De volgende stap is het installeren van de koppeling Prometheus + Grafana met behulp van prometheus-operator. In wordt het installatieproces van prometheus-operator op minikube uitgebreid beschreven. Om persistentie in te schakelen, moet de parameter persistence: true in het bestand charts/grafana/values.yaml worden ingesteld, je eigen PV en PVC toevoegen en deze opgeven in de parameter persistence.existingClaim
Het uiteindelijke script voor het opstarten van minikube ziet er als volgt uit:
minikube start --kubernetes-version=v1.13.4 --memory=4096 --bootstrapper=kubeadm --extra-config=scheduler.address=0.0.0.0 --extra-config=controller-manager.address=0.0.0.0
minikube mount
/home/sergeisporyshev/Projects/Grafana:/var/grafana --gid=472 --uid=472 --9p-version=9p2000.L
Deel 3: ontwikkeling
Objectmodel
Als voorbereiding op de implementatie van de plugin hebben we besloten om alle basisentiteiten van Kubernetes te beschrijven waarmee we zullen werken in de vorm van TypeScript-klassen: pod, deployment, daemonset, statefulset, job, cronjob, service, node, namespace. Elke van deze klassen is afgeleid van de algemene klasse BaseModel, waarin de constructor, destructor, en methoden voor het bijwerken en wisselen van zichtbaarheid zijn beschreven. In elk van de klassen zijn geneste relaties met andere entiteiten beschreven, bijvoorbeeld de lijst van pods bij de entiteit van het type deployment.
import {Pod} from "./pod";
import {Service} from "./service";
import {BaseModel} from './traits/baseModel';

export class Deployment extends BaseModel{
   pods: Array;
   services: Array;

   constructor(data: any){
       super(data);
       this.pods = [];
       this.services = [];
   }
}
Met behulp van getters en setters kunnen we de benodigde metrics van entiteiten op een handige en leesbare manier weergeven of instellen. Bijvoorbeeld, de geformatteerde output van allocatable cpu van een node:
get cpuAllocatableFormatted(){
   let cpu = this.data.status.allocatable.cpu;
   if(cpu.indexOf('m') > -1){
       cpu = parseInt(cpu)/1000;
   }
   return cpu;
}
Pagina's
De lijst van alle pagina's van onze plugin wordt in eerste instantie beschreven in ons pluing.json in het onderdeel afhankelijkheden:
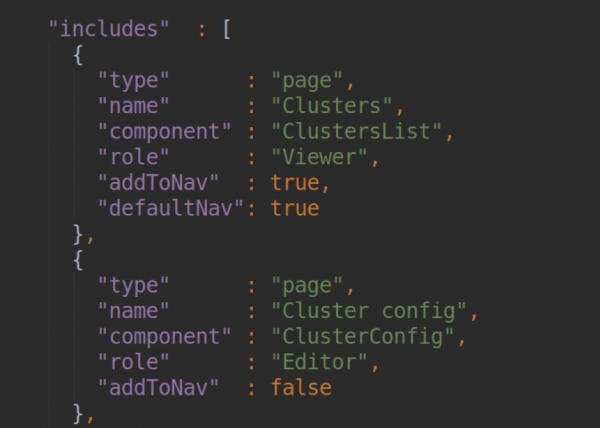
In het blok voor elke pagina moeten we de NAAM VAN DE PAGINA opgeven (deze wordt vervolgens omgezet in een slug, waardoor deze pagina toegankelijk is); de naam van de component die verantwoordelijk is voor deze pagina (de lijst van componenten wordt geëxporteerd in module.ts); de rol van de gebruiker voor wie toegang is tot het werken met deze pagina en de navigatie-instellingen voor de zijbalk.
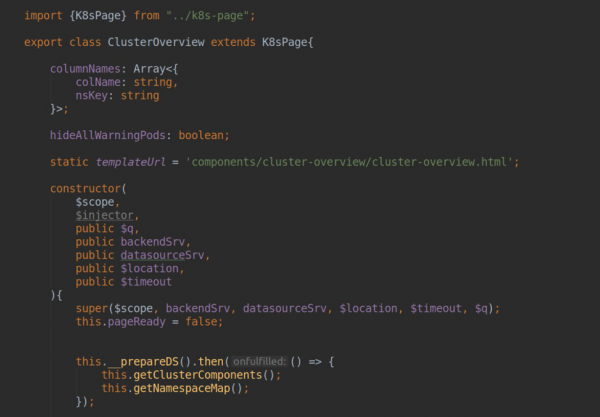
In de component die verantwoordelijk is voor de pagina moeten we templateUrl instellen, waarbij we het pad naar het html-bestand met de markup doorgeven. Binnen de controller hebben we via dependency injection toegang tot twee belangrijke Angular-diensten:
- backendSrv — de service die zorgt voor interactie met de Grafana API-server;
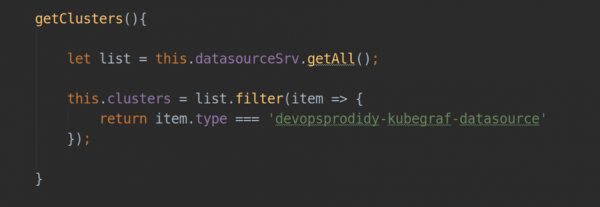
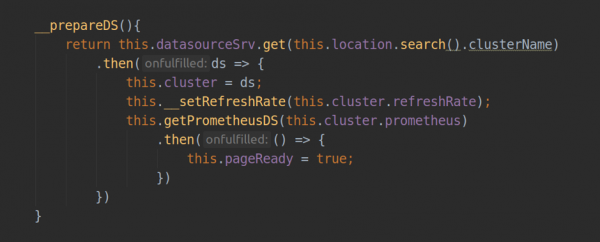
- datasourceSrv — de service die zorgt voor lokale interactie met alle datasource die in uw Grafana zijn geïnstalleerd (bijvoorbeeld, de methode .getAll() — retourneert een lijst van alle geïnstalleerde datasources; .get() — retourneert het object-instantie van een specifieke datasource.
Deel 4: datasource
Vanuit het perspectief van Grafana is een datasource precies hetzelfde als elke andere plug-in: het heeft zijn eigen toegangspunt module.js en er is een bestand met meta-informatie plugin.json. Bij het ontwikkelen van een plug-in met type = app kunnen we zowel interfacing met bestaande datasources (zoals prometheus-datasource) als met onze eigen datasources, die we direct in de plug-in directory (dist/datasource/*) kunnen opslaan of als afhankelijkheid kunnen installeren. In ons geval wordt de datasource geleverd met de code van de plug-in. Ook is een sjabloon config.html en een controller ConfigCtrl vereist, die zullen worden gebruikt voor de configuratiepagina van de datasource-instantie en de datasource-controller, waarin de logica voor de werking van uw datasource is geïmplementeerd.
In de KubeGraf-plug-in, vanuit het perspectief van de gebruikersinterface, is een datasource een instantie van een Kubernetes-cluster waarin de volgende mogelijkheden zijn geïmplementeerd (de broncode is beschikbaar ):
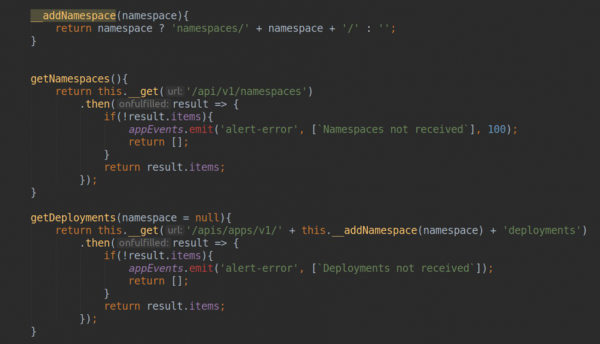
- gegevens ophalen uit de api-server van k8s (vermelding van namespaces, deployments...)
- verzoekproxies naar prometheus-datasource (die in de plug-in instellingen voor elk specifiek cluster wordt geselecteerd) en antwoorden formatteren voor gebruik van gegevens zowel in statische pagina's als in dashboards.
- gegevens bijwerken op statische pagina's van de plug-in (met een ingesteld refresh rate).
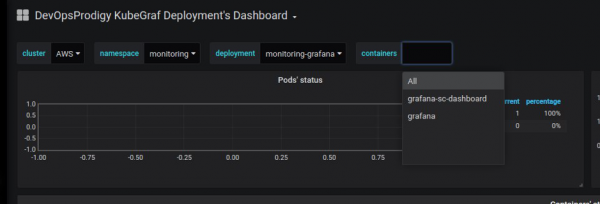
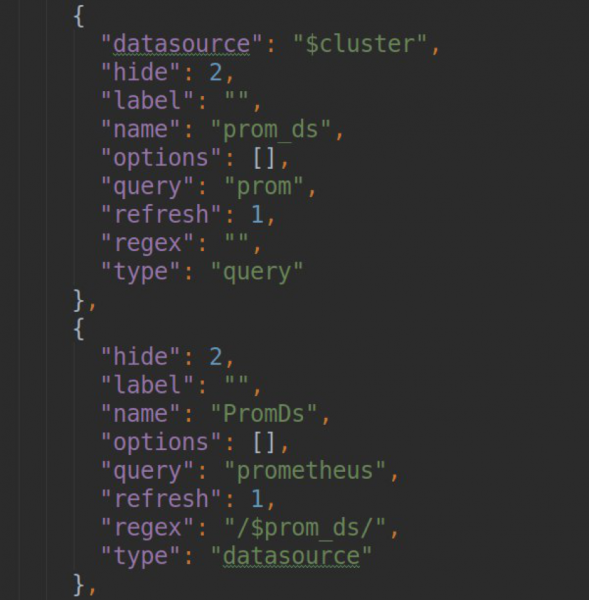
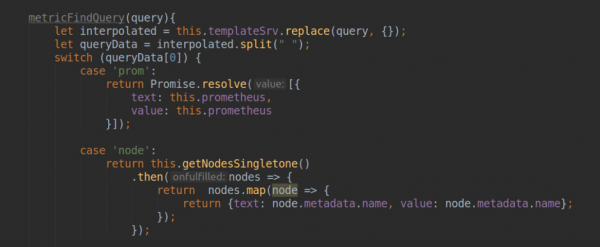
- verwerking van verzoeken voor het genereren van een template-lijst in grafana-dashboards (methode .metriFindQuery())
- test van de verbinding met het eindige k8s-cluster.
testDatasource(){
   let url = '/api/v1/namespaces';
   let _url = this.url;
   if(this.accessViaToken)
       _url += '/__proxy';
   _url += url;
   return this.backendSrv.datasourceRequest({
       url: _url,
       method: "GET",
       headers: {"Content-Type": 'application/json'}
   })
       .then(response => {
           if (response.status === 200) {
               return {status: "success", message: "Databron is OK", title: "Succes"};
           }else{
               return {status: "error", message: "Databron is niet OK", title: "Fout"};
           }
       }, error => {
           return {status: "error", message: "Databron is niet OK", title: "Fout"};
       })
}
Een interessant aspect is naar onze mening de implementatie van het authenticatie- en autorisatiemechanisme voor de datasource. Gewoonlijk kunnen we voor de toegang tot de einddatabron de ingebouwde component van Grafana gebruiken - datasourceHttpSettings. Met deze component kunnen we de toegang tot de http-databron configureren door de url en basisinstellingen voor authenticatie/autorisatie op te geven: gebruikersnaam-wachtwoord, of client-cert/client-key. Om toegang met behulp van een bearer-token (de facto standaard voor k8s) mogelijk te maken, moest er een beetje 'geknutseld' worden.
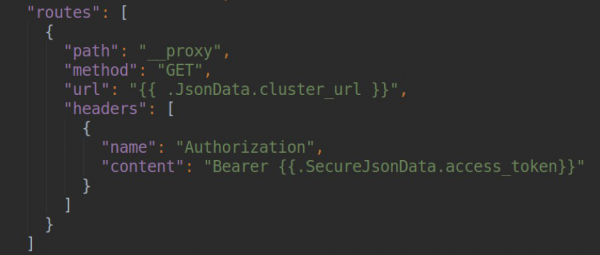
Voor het oplossen van deze taak kan de ingebouwde mechanismen van Grafana 'Plugin Routes' worden gebruikt (meer hierover op ). In de instellingen van onze datasource kunnen we een set routeringsregels declareren die door de proxyserver van Grafana zullen worden verwerkt. Bijvoorbeeld, voor elke afzonderlijke endpoint is er de mogelijkheid om headers of url's op te geven met sjablonering, waarbij de gegevens afkomstig kunnen zijn uit de jsonData en secureJsonData-velden (voor het veilig opslaan van wachtwoorden of tokens in versleutelde vorm). In ons voorbeeld zullen aanvragen van de vorm /__proxy/api/v1/namespaces worden geproxied naar een url van de vorm
/api/v1/namespaces met de header Authorization: Bearer.
Natuurlijk hebben we voor de interactie met de k8s api-server een gebruiker met alleen-lezen toegang nodig; de manifesten voor het creëren daarvan kunt u ook vinden in .
Deel 5: release
Nadat je je eigen plugin voor Grafana hebt geschreven, wil je deze uiteraard openbaar maken. In Grafana is er een pluginbibliotheek beschikbaar via de link
Om je plugin beschikbaar te maken in de officiële winkel, moet je een PR indienen in , door inhoud van de volgende vorm aan het bestand repo.json toe te voegen:
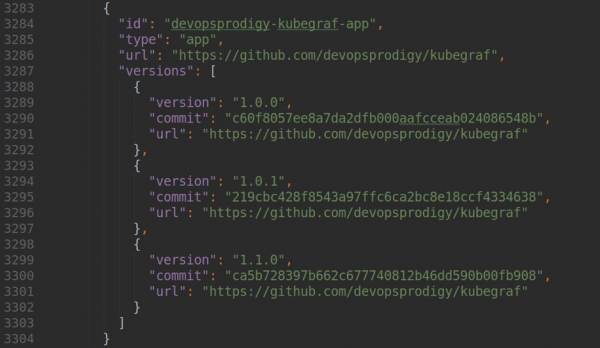
waarbij version - de versie van je plugin is, url - de link naar de repository, en commit - de hash van de commit waarmee de specifieke versie van de plugin beschikbaar zal zijn.
En aan het einde zul je een prachtig plaatje zien dat eruitziet als:
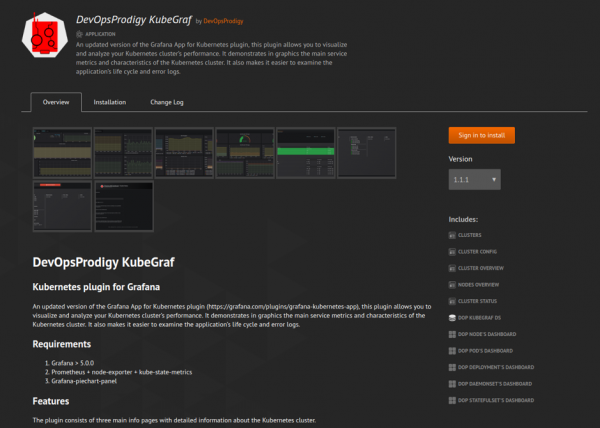
De gegevens hiervoor worden automatisch verzameld uit je Readme.md, Changelog.md en het bestand plugin.json met de beschrijving van de plugin.
Deel 6: conclusie
We hebben de ontwikkeling van onze plugin na de release niet stopgezet. Op dit moment werken we aan een correcte monitoring van het gebruik van de cluster nodes, de implementatie van nieuwe functies voor een verbeterde gebruikerservaring, en we verwerken een groot aantal reacties die we na de installatie van de plugin hebben ontvangen, zowel van onze klanten als via issues op GitHub (als je je issue of pull request achterlaat, ben ik daar erg blij mee 🙂 ).
We hopen dat dit artikel je helpt om de prachtige tool Grafana te begrijpen en mogelijk je eigen plugin te schrijven.
Dank je! :)
Bron: habr.com
