

We had 2 bags of grass, 75 tablets of mescaline unix environment, docker repository, and the task to implement docker pull and docker push commands without the docker client.
UPD:
Question: What is all this for?
Answer: Load testing the product (NOT using bash, scripts provided for educational purposes). It was decided not to use the docker client to reduce additional layers (within reasonable limits) and thus emulate higher loads. As a result, we eliminated all system delays of the docker client. We obtained a relatively clean load directly on the product.
The article used GNU version tools.
First, let's figure out what these commands do.
So, what is docker pull used for? According to :
"Pull an image or a repository from a registry."
There we find a link to .
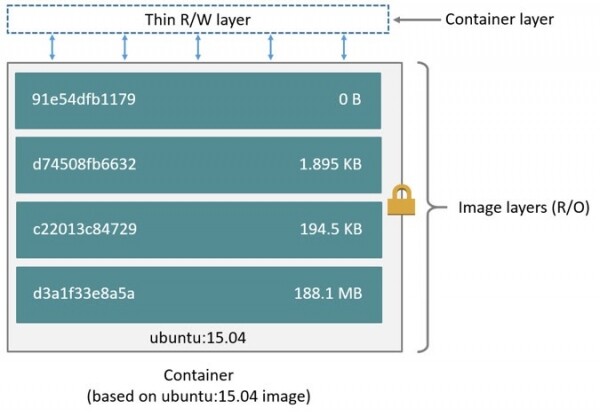
From this, we can understand that a docker image is a set of layers that contain information about the latest changes in the image, which we obviously need. Next, we look at the .
Here it says the following:
"An 'image' is a combination of a JSON manifest and individual layer files. The process of pulling an > image centers around retrieving these two components."
So the first step according to the documentation is “Pulling an Image Manifest.”.
We certainly won't be pulling it, but we need the data from it. Next, an example of the request is given: GET /v2/{name}/manifests/{reference}
"The name and reference parameter identify the image and are required. The reference may include a tag or digest."
Our docker repository is deployed locally, let's try to make the request:
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/manifests/1.1.1" -H "header_if_needed"
In response, we get json from which we are currently only interested in the layers, or rather their hashes. Having received them, we can go through each one and perform the next request: "GET /v2/{name}/blobs/{digest}".
"Access to a layer will be gated by the name of the repository but is identified uniquely in the registry by digest."
digest in this case is the hash we obtained.
Laten we het proberen.
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/blobs/sha256:f972d139738dfcd1519fd2461815651336ee25a8b54c358834c50af094bb262f" -H "header_if_needed" --output firstLayer
Let's see what file we ultimately got as the first layer.
file firstLayer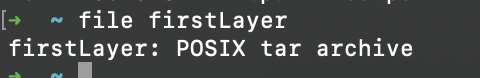
i.e., layers are tar archives, unpacking which in the corresponding order we will get the contents of the image.
Let's write a small bash script to automate this process.
#!/bin/bash -eu

downloadDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
imageName=$3
tag=$4

# array of layers
layers=($(curl -s -X GET "$url/v2/$imageName/manifests/$tag" | grep -oP '(?<=blobSum" : ").+(?=")'))

# download each layer from array
for layer in "${layers[@]}"; do
    echo "Downloading ${layer}"
    curl -v -X GET "$url/v2/$imageName/blobs/$layer" --output "$downloadDir/$layer.tar"
done

# find all layers, untar them and remove source .tar files
cd "$downloadDir" && find . -name "sha256:*" -exec tar xvf {} ;
rm sha256:*.tar
exit 0
Nu kunnen we het met de gewenste parameters starten en de inhoud van het benodigde image ontvangen.
.\/script.sh dirName "http:\/\/localhost:8081\/link\/to\/docker\/registry" myAwesomeImage 1.0Deel 2 — docker push
Hier wordt het iets ingewikkelder.
Laten we weer beginnen met . Dus we moeten elke laag uploaden, het bijbehorende manifest samenstellen en dat ook uploaden. Klinkt eenvoudig.
Na het bestuderen van de documentatie kunnen we het uploadproces in verschillende stappen verdelen:
- Initialisatie van het proces — "POST \/v2\/{repoName}\/?blobs\/uploads\/"
- Laag uploaden (we zullen monolithische upload gebruiken, dat wil zeggen, elke laag versturen we in zijn geheel) — "PUT \/v2\/{repoName}\/?blobs\/uploads\/{uuid}?digest={digest}"
Content-Length: {size of layer}
Content-Type: application\/octet-stream
Laag Binaire Gegevens." - Manifest uploaden — "PUT \/v2\/{repoName}\/?manifests\/{reference}".
Maar in de documentatie ontbreekt een stap, zonder welke niets zal lukken. Voor monolithische upload, net zoals voor gedeeltelijke (chunked) upload, moet een PATCH-verzoek worden uitgevoerd voordat je de laag uploadt:
"PATCH \/v2\/{repoName}\/?blobs\/uploads\/{uuid}
Content-Length: {size of chunk}
Content-Type: application\/octet-stream
{Layer Chunk Binary Data}".
Anders kom je niet verder dan de eerste stap, omdat je in plaats van de verwachte 202-respons code een 4xx-code krijgt.
Nu ziet het algoritme eruit als:
- Initialisatie
- Laag patchen
- Laag uploaden
- Manifest uploaden
Punten 2 en 3 zullen respectievelijk zoveel keer herhaald worden als laag geïncubeerd moet worden.
Voor nu hebben we een image nodig. Ik zal archlinux:latest gebruiken.
docker pull archlinux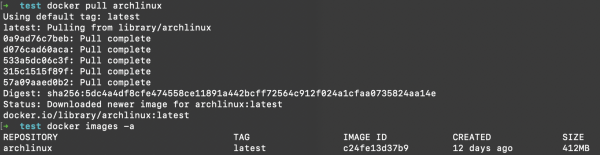
Laten we het nu lokaal opslaan voor verdere analyse.
docker save c24fe13d37b9 -o savedArch
Laten we het verkregen archief uitpakken in de huidige directory.
tar xvf savedArch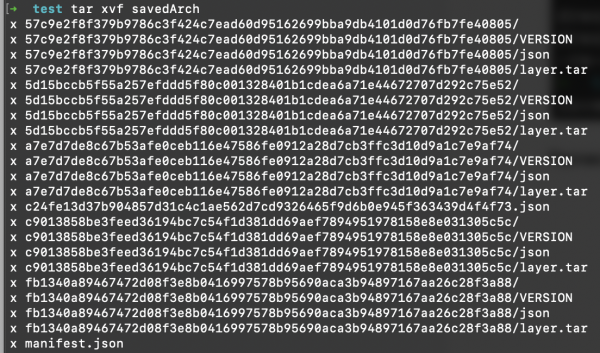
Zoals we zien ligt elke laag in een aparte map. Laten we nu de structuur van het manifest bekijken dat we hebben ontvangen.
cat manifest.json | json_pp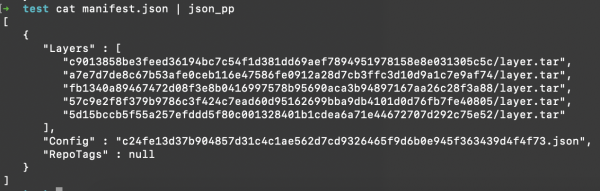
Niet veel. Laten we kijken welk manifest nodig is voor de upload, volgens .
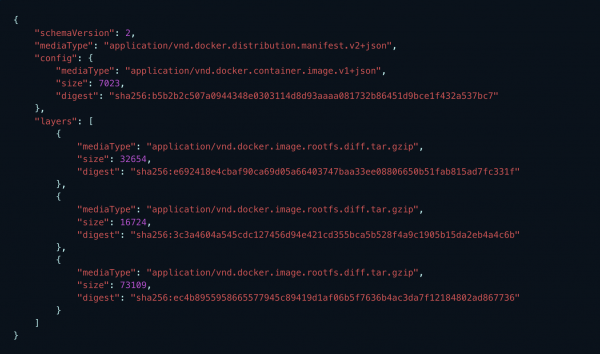
Het is duidelijk dat het bestaande manifest niet geschikt is, dus laten we onze eigen maken met blackjack en kurven en configuraties.
We zullen altijd minimaal één config-bestand en een array van lagen hebben. Schema versie 2 (actueel op het moment van schrijven), mediaType laten we onveranderd:
echo ‘{
   "schemaVersion": 2,
   "mediaType": "application/vnd.docker.distribution.manifest.v2+json",
   "config": {
      "mediaType": "application/vnd.docker.container.image.v1+json",
      "size": config_size,
      "digest": "config_hash"
   },
   "layers": [
      ’ > manifest.json
Na het maken van het basismanifest moeten we dit aanvullen met geldige gegevens. Hiervoor gebruiken we een sjabloon van een json-object voor de laag:
{
         "mediaType": "application\/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      },
Deze zullen we aan het manifest toevoegen voor elke laag.
Vervolgens moeten we de grootte van het configuratiebestand achterhalen en de placeholders in het manifest vervangen door de echte gegevens.
sed -i "s/config_size/$configSize/g; s/config_hash/$configName/g" $manifestFileNu kunnen we het uploadproces starten en de uuid opslaan, die alle verdere verzoeken moet begeleiden.
Het volledige script ziet er ongeveer zo uit:
#!/bin/bash -eux

imageDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
repoName=$3
tag=$4
manifestFile=$(readlink -f ${imageDir}/manifestCopy)
configFile=$(readlink -f $(find $imageDir -name "*.json" ! -name "manifest.json"))

# calc layers sha 256 sum, rename them accordingly, and add info about each to manifest file
function prepareLayersForUpload() {
  info_file=$imageDir/info
  # lets calculate layers sha256 and use it as layers names further
  layersNames=($(find $imageDir -name "layer.tar" -exec shasum -a 256 {} ; | cut -d" " -f1))

  # rename layers according to shasums. !!!Set required amount of fields for cut command!!!
  # this part definitely can be done easier but i didn't found another way, sry
  find $imageDir -name "layer.tar" -exec bash -c 'mv {} "$(echo {} | cut -d"/" -f1,2)/$(shasum -a 256 {} | cut -d" " -f1)"' ;

  layersSizes=($(find $imageDir -name "*.tar" -exec ls -l {} ; | awk '{print $5}'))

  for i in "${!layersNames[@]}"; do
    echo "{
         "mediaType": "application/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      }," >> $manifestFile
  done
  # remove last ','
  truncate -s-2 $manifestFile
  # add closing brakets to keep json consistent
  printf "nt]n}" >> $manifestFile
}

# calc config sha 256 sum and add info about it to manifest
function setConfigProps() {
  configSize=$(ls -l $configFile | awk '{print $5}')
  configName=$(basename $configFile | cut -d"." -f1)

  sed -i "s/config_size/$configSize/g; s/config_hash/$configName/g" $manifestFile
}

#prepare manifest file
prepareLayersForUpload
setConfigProps
cat $manifestFile

# initiate upload and get uuid
uuid=$(curl -s -X POST -I "$url/v2/$repoName/blobs/uploads/" | grep -oP "(?<=Docker-Upload-Uuid: ).+")

# patch layers
# in data-binary we're getting absolute path to layer file
for l in "${!layersNames[@]}"; do
  pathToLayer=$(find $imageDir -name ${layersNames[$l]} -exec readlink -f {} ;)
    curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: ${layersSizes[$i]}"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$pathToLayer"

# put layer
  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:${layersNames[$i]}"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: ${layersSizes[$i]}"
  --data-binary "@$pathToLayer"
done

# patch and put config after all layers
curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: $configSize"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$configFile"

  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:$configName"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: $configSize"
  --data-binary "@$configFile"

# put manifest
curl -v -X PUT "$url/v2/$repoName/manifests/$tag"
  -H 'Content-Type: application/vnd.docker.distribution.manifest.v2+json'
  --data-binary "@$manifestFile"

exit 0
we kunnen een kant-en-klaar script gebruiken:
./uploadImage.sh "~\/path\/to\/saved\/image" "http:\/\/localhost:8081\/link\/to\/docker\/registry" myRepoName 1.0UPD:
Wat hebben we in het resultaat gekregen?
Ten eerste, echte gegevens voor analyse, aangezien de tests draaien in Blazemeter en de gegevens van het Docker-clientverzoek behoorlijk niet-informatief zijn in tegenstelling tot pure HTTP-verzoeken.
Ten tweede heeft de overstap ons in staat gesteld om het aantal virtuele gebruikers voor Docker-upload met ongeveer 150% te verhogen, met een gemiddelde responstijd die 20-25% sneller is. Voor Docker-download hebben we het aantal gebruikers met 500% kunnen verhogen, terwijl de gemiddelde responstijd met ongeveer 60% daalde.
Bedankt voor uw aandacht.
Bron: habr.com
