

In dit artikel willen we de kenmerken van de All Flash arrays van AccelStor belichten in combinatie met een van de meest populaire virtualisatieplatforms – VMware vSphere. In het bijzonder willen we de aandacht vestigen op de parameters die helpen om het maximale effect te behalen uit het gebruik van zo'n krachtig instrument als All Flash.
De All Flash arrays AccelStor NeoSapphire™ zijn of node-apparaten die zijn gebaseerd op SSD-opslag met een fundamenteel andere benadering in de implementatie van gegevensopslagconcepten en de organisatie van toegang ertoe met behulp van een eigen technologie in plaats van de vrij populaire RAID-algoritmen. De arrays bieden bloktoegang voor hosts via de interfaces Fibre Channel of iSCSI. Eerlijkheidshalve moeten we opmerken dat de modellen met de iSCSI-interface ook bestandsmatige toegang hebben als een aangename bonus. Maar in dit artikel zullen we ons concentreren op het gebruik van blokprotocollen als de meest prestatiegerichte optie voor All Flash.
Het hele proces van de implementatie en de daaropvolgende configuratie van de samenwerking tussen de AccelStor-array en de virtualisatiesysteem VMware vSphere kan in verschillende fasen worden verdeeld:
- Implementatie van de verbindingsarchitectuur en configuratie van het SAN-netwerk;
- Configuratie van de All Flash array;
- Configuratie van de ESXi-hosts;
- Configuratie van de virtuele machines.
Voor de voorbeelden werd gebruikgemaakt van de AccelStor NeoSapphire™ arrays met een Fibre Channel-interface en een iSCSI-interface. Voor de basissoftware – VMware vSphere 6.7U1.
Het wordt ten zeerste aanbevolen om de documentatie van VMware over prestatiekwesties te bekijken voordat u de in dit artikel beschreven systemen implementeert ( ) en configuraties van iSCSI ()
Verbindingsarchitectuur en configuratie van het SAN-netwerk
De belangrijkste componenten van het SAN-netwerk zijn de HBA-adapters in de ESXi-hosts, SAN-switches en de nodes van de array. Een typische topologie van een dergelijk netwerk ziet er als volgt uit:
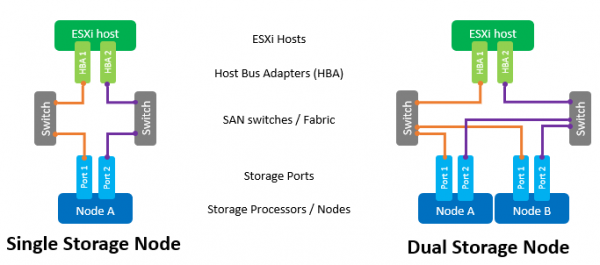
Onder de term Switch wordt hier zowel een afzonderlijke fysieke switch of een set switches (Fabric) als een gedeeld apparaat tussen verschillende diensten verstaan (VSAN in het geval van Fibre Channel en VLAN in het geval van iSCSI). Het gebruik van twee onafhankelijke switches/Fabric voorkomt mogelijke single points of failure.
Rechtstreeks aansluiten van hosts op de array wordt wel ondersteund, maar is ten zeerste af te raden. De prestaties van All Flash-arrays zijn vrij hoog. Voor maximale snelheid moeten alle poorten van de array worden gebruikt. Daarom is het noodzakelijk om minstens één switch tussen de hosts en NeoSapphire™ te hebben.
Het hebben van twee poorten op de HBA-host is ook een vereiste voor het bereiken van maximale prestaties en het waarborgen van de beschikbaarheid.
Bij het gebruik van de Fibre Channel-interface is zonering configuratie vereist om mogelijke conflicten tussen initiators en targets uit te sluiten. Zones worden gebouwd volgens het principe 'één initiatorpoort - één of meerdere poorten van de array'.
Als de verbinding via iSCSI loopt en een switch gebruikt wordt die met andere services wordt gedeeld, is het absoluut noodzakelijk om het iSCSI-verkeer binnen een aparte VLAN te isoleren. Het wordt ook sterk aanbevolen om Jumbo Frames (MTU = 9000) in te schakelen om de pakketgroottes in het netwerk te vergroten en zodoende de hoeveelheid overheadinformatie tijdens de transmissie te verminderen. Houd er echter rekening mee dat voor een correcte werking de MTU-instelling op alle netwerkcomponenten in de keten 'initiator-switch-target' moet worden gewijzigd.
Configuratie van de All Flash-array
De array wordt aan klanten geleverd met reeds gevormde groepen . Daarom hoeven er geen acties te worden ondernomen om de opslagapparaten tot één structuur samen te voegen. Het is voldoende om volumes van de vereiste grootte en in het benodigde aantal te creëren.
Voor het gemak is er een functie voor het massaal aanmaken van meerdere volumes van een opgegeven omvang. Standaard worden 'thin' volumes aangemaakt, omdat dit het mogelijk maakt om de beschikbare opslagruimte efficiënter te benutten (ook dankzij ondersteuning voor Space Reclamation). Qua prestaties is het verschil tussen 'thin' en 'thick' volumes niet meer dan 1%. Maar als het nodig is om alles uit de array te halen, kan elk 'thin' volume altijd worden omgezet naar een 'thick' volume. Houd echter rekening met het feit dat deze operatie onomkeerbaar is.
Vervolgens moet je de gemaakte volumes «publiceren» en de toegangsrechten van de hosts instellen via ACL (IP-adressen voor iSCSI en WWPN voor FC) en fysieke scheiding via de poorten van de array. Voor iSCSI-modellen gebeurt dit door het aanmaken van een Target.
Voor FC-modellen vindt de publicatie plaats door een LUN voor elke poort van de array aan te maken.
Om het instellingsproces te versnellen, kunnen hosts in groepen worden samengevoegd. Als er op de host een multi-port FC HBA wordt gebruikt (wat in de praktijk meestal het geval is), dan herkent het systeem automatisch dat de poorten van deze HBA tot dezelfde host behoren door WWPN's die één eenheid van elkaar verschillen. Voor beide interfaces wordt ook batch-creatie van Target/LUN ondersteund.
Een belangrijk punt bij het gebruik van de iSCSI-interface is het aanmaken van meerdere targets voor volumes om de prestaties te verhogen, omdat de wachtrij op de target niet kan worden gewijzigd en deze feitelijk een bottleneck zal zijn.
Configuratie van ESXi-hosts
Vanuit de ESXi-hosts wordt de basisondersteuning uitgevoerd volgens een vrij verwachte scenario. De volgorde van acties voor iSCSI-verbinding:
- Voeg een Software iSCSI Adapter toe (niet nodig als deze al is toegevoegd, of als een Hardware iSCSI Adapter wordt gebruikt);
- Maak een vSwitch aan, waardoor iSCSI-verkeer zal gaan, en voeg fysieke uplinks en VMkernels toe;
- Voeg de adressen van de array toe aan Dynamic Discovery;
- Maak een Datastore aan
Enkele belangrijke opmerkingen:
- In het algemeen kan natuurlijk ook een bestaande vSwitch worden gebruikt, maar in het geval van een aparte vSwitch zal het beheer van de instellingen van de host veel eenvoudiger zijn.
- Het is noodzakelijk om het Management-verkeer en iSCSI via aparte fysieke lijnen en/of VLAN's te scheiden om prestatieproblemen te voorkomen.
- IP-adressen van VMkernels en de bijbehorende poorten van de All Flash-array moeten zich binnen hetzelfde subnet bevinden, wederom in verband met prestatiekwesties.
- Om redundantie te waarborgen volgens VMware-regels moet de vSwitch minstens twee fysieke uplinks hebben.
- Als Jumbo Frames worden gebruikt, is het nodig om de MTU zowel bij de vSwitch als bij de VMkernel te wijzigen.
- Het is nuttig om te herinneren dat volgens de aanbevelingen van VMware voor fysieke adapters die zullen worden gebruikt voor iSCSI-verkeer, het absoluut noodzakelijk is om Teaming en Failover in te stellen. Concreet moet elke VMkernel alleen via één uplink werken, de tweede uplink moet in de ongebruikte modus worden gezet. Voor betrouwbaarheid moeten er twee VMkernels worden toegevoegd, elk werkend via zijn eigen uplink.
VMkernel Adapter (vmk#)
Fysieke Netwerkadapter (vmnic#)
vmk1 (Storage01)
Actieve Adapters
vmnic2
Ongebruikte Adapters
vmnic3
vmk2 (Storage02)
Actieve Adapters
vmnic3
Ongebruikte Adapters
vmnic2
Voor verbinding via Fibre Channel zijn er geen voorafgaande acties vereist. U kunt onmiddellijk een Datastore maken.
Na het aanmaken van de Datastore moet u ervoor zorgen dat de Round Robin-beleid wordt gebruikt voor de paden naar Target/LUN als de meest efficiënte optie.
Standaard voorziet VMware in het gebruik van deze beleidsinstelling volgens het schema: 1000 aanvragen via het eerste pad, de volgende 1000 aanvragen via het tweede pad, enzovoort. Een dergelijke interactie van de host met een tweecontroller-array zal niet in balans zijn. Daarom raden we aan het parameter Round Robin-beleid = 1 in te stellen via Esxcli/PowerCLI.
Instellingen
Voor Esxcli:
- LUN's weergeven
esxcli storage nmp device list
- Kopieer de Device Name
- Wijzig het Round Robin-beleid
esxcli storage nmp psp roundrobin deviceconfig set —type=iops —iops=1 —device=«Device_ID»
De meeste moderne applicaties zijn ontworpen voor het uitwisselen van grote datapunten om de bandbreedte maximaal te benutten en de belasting op de centrale processor te verlagen. Daarom verzendt ESXi standaard invoer-/uitvoerverzoeken naar het opslagapparaat in porties tot 32767KB. Voor bepaalde scenario's kan het echter efficiënter zijn om kleinere porties uit te wisselen. Voor AccelStor-arrays zijn dit de volgende scenario's:
- De virtuele machine gebruikt UEFI in plaats van Legacy BIOS
- VSphere Replication wordt gebruikt
Voor dergelijke scenario's wordt aangeraden de waarde van het parameter Disk.DiskMaxIOSize op 4096 in te stellen.
Voor iSCSI-verbindingen wordt aangeraden de parameter Login Timeout op 30 (standaard 5) in te stellen om de stabiliteit van de verbinding te verhogen en de vertraagde bevestiging van verzonden pakketten DelayedAck uit te schakelen. Beide opties zijn te vinden in de vSphere Client: Host → Configure → Storage → Storage Adapters → Advanced Options voor de iSCSI-adapter.
Een belangrijke factor is het aantal gebruikte volumes voor de datastore. Het is begrijpelijk dat men uit oogpunt van gebruiksgemak de neiging heeft om één groot volume voor de volledige capaciteit van de array te creëren. Echter, het hebben van meerdere volumes en, bijgevolg, datastores heeft een gunstige invloed op de algehele prestaties (meer over queues verderop in de tekst). Daarom raden we aan om minimaal twee volumes aan te maken.
Nog niet zo lang geleden adviseerde VMware het aantal virtuele machines op één datastore te beperken, opnieuw met het doel de best mogelijke prestaties te behalen. Maar tegenwoordig, vooral met de opkomst van VDI, is dit probleem minder urgent. Dit ontslaat ons echter niet van de oude regel: verdeel virtuele machines die intensieve IO vereisen over verschillende datastores. Om het optimale aantal virtuele machines op één volume te bepalen, is er niets beter dan het uitvoeren van binnen uw eigen infrastructuur.
Configuratie van virtuele machines
Bij de configuratie van virtuele machines zijn er geen bijzondere eisen, of beter gezegd, ze zijn vrij standaard:
- Gebruik de meest actuele versie van VM (compatibiliteit)
- Wees voorzichtig bij het instellen van het RAM-grootte bij dichte plaatsing van virtuele machines, bijvoorbeeld in VDI (aangezien bij de start standaard een swapbestand van vergelijkbare grootte als het RAM wordt aangemaakt, wat nuttige capaciteit verbruikt en effect heeft op de uiteindelijke prestaties)
- Gebruik de meest IO-prestatiegerichte versies van adapters: netwerkadapter type VMXNET 3 en SCSI type PVSCSI
- Gebruik het type schijf Thick Provision Eager Zeroed voor maximale prestaties en Thin Provisioning voor een optimale benutting van de opslagcapaciteit
- Beperk indien mogelijk de werking van machines die niet kritisch zijn voor invoer/uitvoer met behulp van Virtual Disk Limit
- Zorg ervoor dat VMware Tools is geïnstalleerd
Opmerkingen over queues
Een wachtrij (of Outstanding I/Os) is het aantal invoer-/uitvoerverzoeken (SCSI-commando's) dat op elk moment wacht op verwerking door een specifiek apparaat/toepassing. Bij een volle wachtrij treedt de fout QFULL op, wat uiteindelijk resulteert in een toename van de latentie. Bij het gebruik van schijf (spindle) opslagsystemen geldt theoretisch: hoe hoger de wachtrij, hoe hoger hun prestaties. Echter, overdrijf het niet, want je kunt gemakkelijk tegen QFULL aanlopen. Bij All Flash-systemen is het iets eenvoudiger: de arrays hebben immers latenties die beduidend lager zijn, waardoor het vaak niet nodig is om de grootte van wachtrijen apart aan te passen. Aan de andere kant, in sommige gebruiksscenario's (bijvoorbeeld een sterke scheefgroei in de IO-eisen voor bepaalde virtuele machines, prestatietests, enz.) is het noodzakelijk, als je de wachtrijparameters niet kunt wijzigen, tenminste te begrijpen welke waarden haalbaar zijn en, belangrijker nog, op welke manieren.
Op de All Flash-array van AccelStor zijn er geen limieten met betrekking tot volumes of invoer-/uitvoerpoorten. Indien nodig kan zelfs één enkel volume alle bronnen van de array ontvangen. Het enige bezwaar op wachtrijen is voor iSCSI-doelen. Daarom werd hierboven de noodzaak aangegeven om meerdere (idealiter tot 8) doelen per volume aan te maken om deze limiet te overschrijden. We herhalen ook dat AccelStor-arrays zeer prestatiegerichte oplossingen zijn. Daarom moet je alle interfacepoorten van het systeem inzetten om maximale snelheid te bereiken.
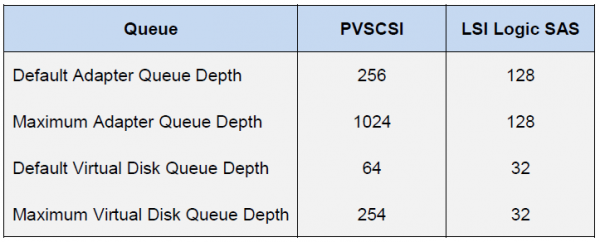
Vanuit het perspectief van de ESXi-host is de situatie compleet anders. De host hanteert de praktijk van gelijke toegang tot middelen voor alle deelnemers. Daarom zijn er aparte IO-wachtrijen voor de gast-OS en de HBA. De wachtrijen voor de gast-OS worden samengesteld uit de wachtrijen voor de virtuele SCSI-adapter en de virtuele schijf:
De wachtrij naar de HBA hangt af van het specifieke type/merk:
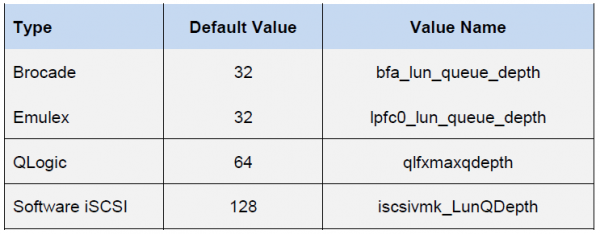
De uiteindelijke prestatie van de virtuele machine wordt bepaald door de laagste waarde van de wachtrijparameter (Queue Depth limit) onder de componenten van de host.
Met deze waarden kunnen we de prestatie-indicatoren beoordelen die we in een bepaalde configuratie kunnen behalen. Bijvoorbeeld, we willen de theoretische prestaties van een virtuele machine (zonder de schijf te koppelen) met een latency van 0,5 ms weten. Dan is de IOPS = (1.000/latency) * Outstanding I/Os (Queue Depth limit)
Voorbeelden
Voorbeeld 1
- FC Emulex HBA-adapter
- Één VM op datastore
- VMware Paravirtual SCSI-adapter
Hier wordt de Queue Depth limit bepaald door de Emulex HBA. Daarom IOPS = (1000/0.5)*32 = 64K
Voorbeeld 2
- VMware iSCSI Software-adapter
- Één VM op datastore
- VMware Paravirtual SCSI-adapter
Hier wordt de Queue Depth limit bepaald door de Paravirtual SCSI-adapter. Daarom IOPS = (1000/0.5)*64 = 128K
Topmodellen van All Flash-opslag AccelStor (bijvoorbeeld, ) kunnen 700K IOPS bij schrijven leveren met een blokgrootte van 4K. Bij deze blokgrootte is het volkomen duidelijk dat een enkele virtuele machine een dergelijke opslag niet kan belasten. Hiervoor zijn 11 (voor voorbeeld 1) of 6 (voor voorbeeld 2) virtuele machines nodig.
Uiteindelijk kan men, bij een goede configuratie van alle beschreven componenten van het virtuele datacenter, zeer indrukwekkende resultaten behalen wat betreft prestaties.
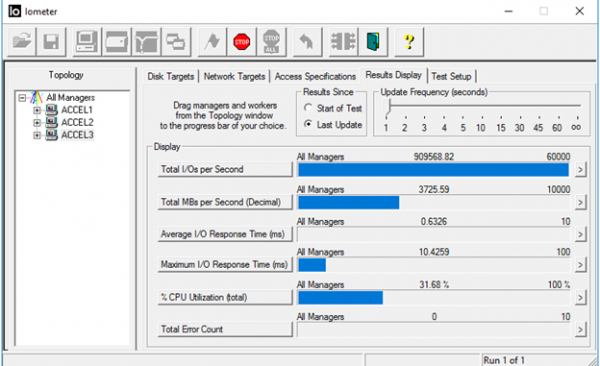
4K Random, 70% Lezen/30% Schrijven
In werkelijkheid is de echte wereld veel complexer om met een eenvoudige formule te beschrijven. Op één host bevinden zich altijd meerdere virtuele machines met verschillende configuraties en IO-eisen. Bovendien is de hostprocessor verantwoordelijk voor de input/output-verwerking, waarvan de kracht niet eindeloos is. Dus om het volledige potentieel van de in werkelijkheid te benutten, zijn minimaal drie hosts vereist. Daarnaast hebben applicaties die binnen de virtuele machines draaien hun eigen invloed. Daarom raden we voor een exacte sizing aan om All Flash-opslag binnen de infrastructuur van de klant voor actuele, lopende taken.
Bron: habr.com
