

Vandaag zal ik jullie een verhaal vertellen. Een verhaal over de evolutie van computertechnologie en de opkomst van thuiswerkplekken van de oudheid tot nu.
De ontwikkeling van IT
Het belangrijkste dat uit de geschiedenis van IT kan worden afgeleid, is...
Natuurlijk ontwikkelt IT zich in spiralen. Dezelfde oplossingen en concepten die tientallen jaren geleden werden afgewezen, krijgen een nieuwe betekenis en beginnen succesvol te functioneren onder nieuwe omstandigheden, met nieuwe taken en nieuwe capaciteiten. In dit opzicht verschilt IT niet van enig ander kennisgebied van de mensheid en de geschiedenis van de aarde als geheel.
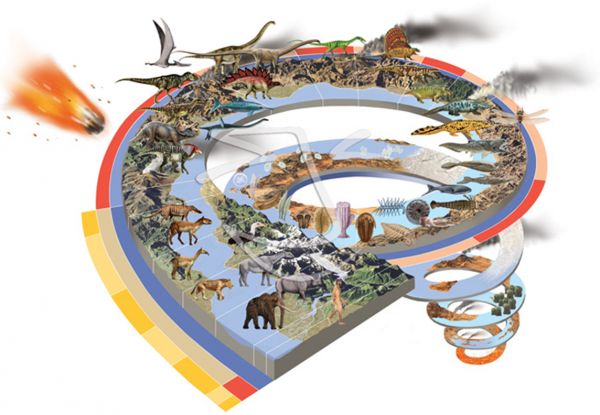
Lang geleden, toen computers nog groot waren
"Ik denk dat er in de wereld een markt is voor ongeveer vijf computers," zei IBM-voorzitter Thomas Watson in 1943.
Vroege computertechnologie was groot. Nee, dat is niet correct; vroege technologie was monsterlijk, cyclopisch. Een volledige computeroccupatie nam een oppervlak in dat vergelijkbaar was met een sporthal en kostte volstrekt onrealistische bedragen. Ter illustratie kan een geheugenm blok op ferrietringen (1964) worden genoemd.
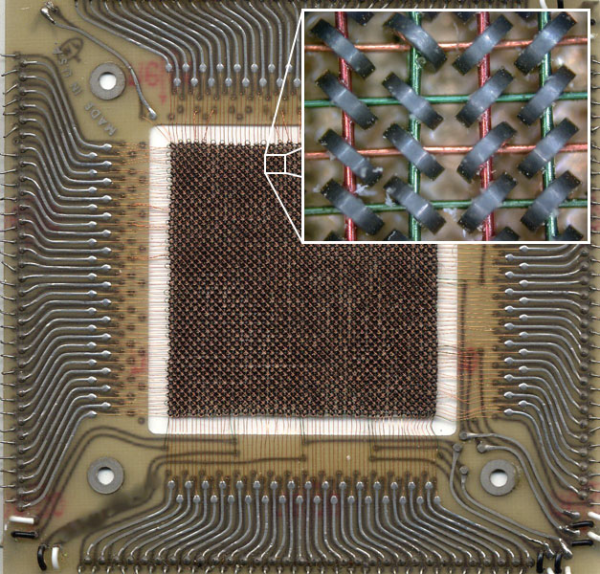
Dit blok heeft een afmeting van 11 cm x 11 cm en een capaciteit van 512 byte (4096 bits). Een kast vol met deze blokken had nauwelijks de capaciteit van een destijds al antieke 3,5" floppy disk (1,44 MB = 2950 blokken), maar consumeerde een aanzienlijke hoeveelheid elektrische energie en werd net zo heet als een stoomlocomotief.
Juist door de enorme afmetingen is de Engelse term voor het debuggen van software ontstaan — “debugging”. Een van de eerste programmeurs in de geschiedenis, Grace Hopper (ja, een vrouw), een overofficier van de marine, maakte in 1945 een aantekening in het logboek na het onderzoeken van een fout in een programma.
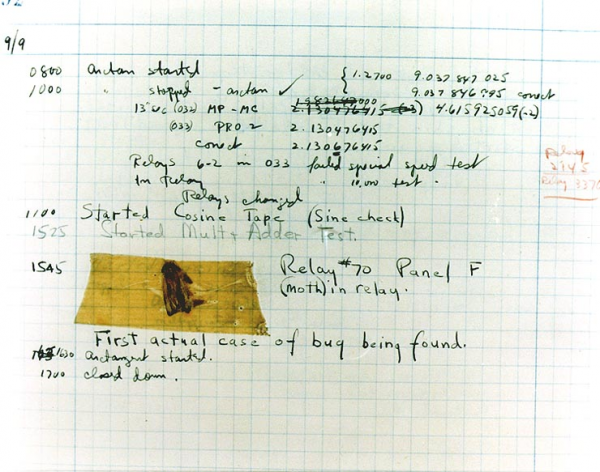
Aangezien moth (mot) in het algemeen een bug (insect) is, rapporteerde het personeel alle verdere problemen en acties als "debugging" (letterlijk ongediertebestrijding), dus de naam voor een softwarefout en een bug raakte voor altijd verbonden, en debugging werd debuggin.
Naarmate de elektronica en met name de halfgeleidertechnologie zich ontwikkelden, begonnen de fysieke afmetingen van machines af te nemen, terwijl de rekenkracht daarentegen toenam. Maar zelfs in dat geval was het niet mogelijk om aan iedereen een computer persoonlijk te geven.
“Er zijn geen redenen waarom iemand een computer thuis zou willen hebben” — Ken Olsen, oprichter van DEC, 1977.
In de jaren '70 verschijnt de term minicomputer. Ik herinner me dat toen ik deze term jaren geleden voor het eerst las, ik me iets voorstelde dat leek op een netbook, praktisch een handcomputer. Ik kon niet verder van de waarheid zijn.
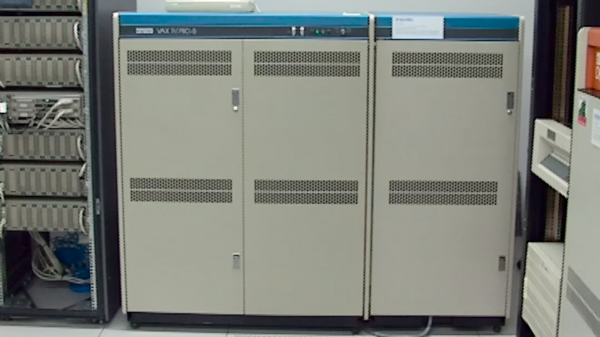
Mini — het is alleen in vergelijking met enorme computerruimtes, maar het zijn nog steeds verschillende kasten met apparatuur ter waarde van honderdduizenden en miljoenen dollars. Echter, de rekenkracht was al zo toegenomen dat deze niet altijd volledig benut werd, en op dat moment begonnen computers toegankelijk te worden voor studenten en docenten aan universiteiten.
En toen kwam HIJ!
Weinigen denken na over de Latijnse wortels in de Engelse taal, maar het is deze taal die ons op afstand toegang gaf zoals we het nu kennen. Terminus (Latijn) — einde, grens, doel. Het doel van de Terminator T800 was om het leven van John Connor te beëindigen. Ook weten we dat transportstations, waar passagiers kunnen in- en uitstappen of waar goederen kunnen worden geladen en gelost, terminals worden genoemd — eindbestemmingen van routes.
Hierdoor ontstond het concept van terminaltoegang, en je kunt de bekendste terminal ter wereld zien, die nog steeds in ons hart leeft.
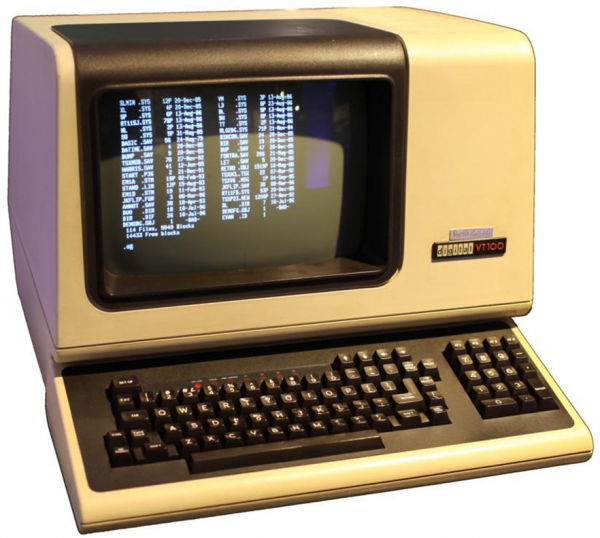
DEC VT100 wordt een terminal genoemd, omdat het de informatie lijn beëindigt. Het heeft feitelijk nul rekenkracht, en zijn enige taak is om de informatie van een grote machine weer te geven en invoer van het toetsenbord naar de machine te verzenden. En hoewel VT100's fysiek al lang overleden zijn, maken we er nog steeds volop gebruik van.
Onze Dagen
“Onze dagen” zou ik laten beginnen vanaf het begin van de jaren '80, met de opkomst van de eerste voor het grote publiek toegankelijke processors met enige significante rekenkracht. Het wordt traditioneel beschouwd dat de belangrijkste processor van dit tijdperk de Intel 8088 (x86-familie) was, als de grondlegger van de winnende architectuur. Wat is het principiële verschil met het concept van de jaren '70?
Voor het eerst zien we de trend van het verplaatsen van gegevensverwerking van het centrum naar de rand. Niet alle taken vereisen de enorme (in vergelijking met zwakke x86) kracht van een mainframe of zelfs een mini-computer. Intel staat niet stil en bracht in de jaren '90 de Pentium-serie uit, die de eerste echt massale thuiscomputer in Rusland werd. Deze processoren konden al veel meer dan alleen een brief schrijven — ze ondersteunden ook multimedia en het werken met kleine databases. Voor kleine bedrijven is de noodzaak voor servers feitelijk volledig vervallen — alles kan worden uitgevoerd aan de rand, op de clientmachines. Jaar na jaar worden processoren krachtiger en het verschil tussen servers en persoonlijke computers wordt steeds kleiner qua rekenkracht, vaak beperkt tot energie-reservering, ondersteuning voor hot-swap en speciale behuizingen voor installatie in racks.
Wanneer we moderne clientprocessoren vergelijken met de 'grappige' zware servers van de jaren '90 van Intel en met supercomputers uit het verleden, voelt het echt een beetje ongemakkelijk aan.
Laten we een blik werpen op een oude bekende, die bijna even oud is als ik. De Cray X-MP/24 uit 1984.
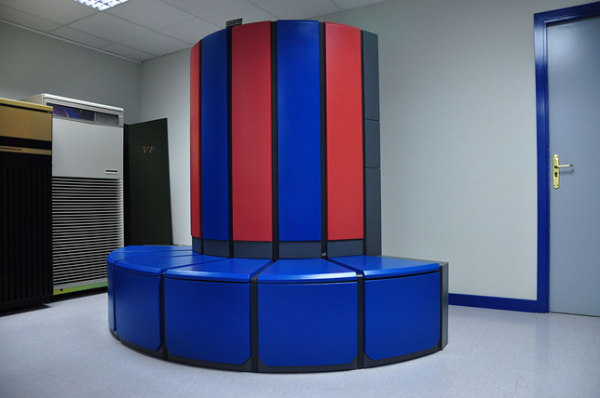
Deze machine was een van de top supercomputers in 1984 en had 2 processoren van 105 MHz met een piek rekencapaciteit van 400 MFlops (miljoen floating point operaties). De specifieke machine op de foto stond in het cryptografie-laboratorium van de NSA in de VS en werd gebruikt voor het kraken van codes. Als je 15 miljoen dollar uit 1984 omzet naar dollars van 2020, komt de waarde uit op 37,4 miljoen, of 93.500 dollar/MFlops.
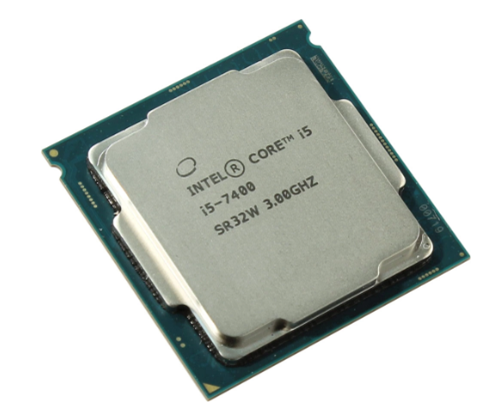
In de machine waarop ik deze zinnen schrijf, zit een Core i5-7400 processor uit 2017, die helemaal niet meer nieuw is, en zelfs in het jaar van zijn release de jongste 4-core was van alle midrange desktop-processoren. 4 cores met een basisfrequentie van 3,0 GHz (3,5 met Turbo Boost) en de verdubbeling van threads door HyperThreading levert tussen de 19 en 47 GFlops aan kracht in verschillende tests, met een prijs van 16.000 roebel voor de processor. Als je de machine helemaal samenstelt, zou je de prijs kunnen aannemen op 750 dollar (op basis van prijzen en wisselkoersen op 1 maart 2020).
Uiteindelijk krijgen we een overwicht van een redelijk gemiddelde desktopprocessor van vandaag met 50-120 keer dat van een supercomputer uit de top 10 van een vrij recent verleden, en de daling van de specifieke kosten van MFlops wordt echt verbijsterend, namelijk 93.500 / 25 = 3.700 keer.
Waarom hebben we nog steeds servers en centralisatie van berekeningen nodig met zulke krachtige mogelijkheden aan de rand — dat is volkomen onduidelijk!
De terugslag — de spiraal heeft een draai gemaakt
Schijfloze stations
Het eerste signaal dat het verplaatsen van berekeningen naar de rand niet definitief zal zijn, was de opkomst van de technologie van schijfloze werkstations. Bij een aanzienlijke spreiding van werkstations over de terrein van het bedrijf, en vooral in vervuilde ruimtes, wordt de vraag naar beheer en ondersteuning van deze stations zeer urgent.
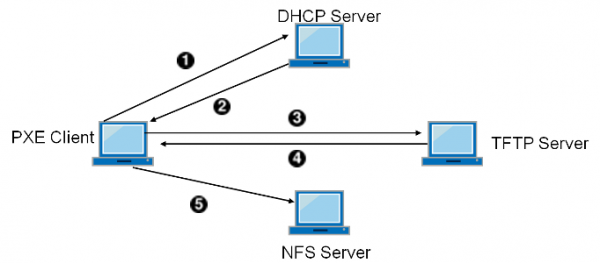
Het begrip 'corridortijd' verschijnt — het percentage van de tijd dat een ondersteuningsmedewerker in de gang is, onderweg naar de medewerker met een probleem. Deze tijd is betaald, maar volkomen onproductief. Niet in de laatste plaats, vooral in vervuilde ruimtes, speelde de uitval van harde schijven een grote rol. Laten we de schijf uit het werkstation halen, en alles netwerkgestuurd doen, inclusief de opstart. De netwerkaansluiting ontvangt naast het adres van de DHCP-server ook aanvullende informatie — het adres van de TFTP-server (een vereenvoudigde bestandservice) en de naam van het opstartimage, laadt dit in het RAM-geheugen en start de machine.
Naast een verminderd aantal storingen en een afname van de corridortijd, kan de machine nu niet ter plaatse worden afgestemd, maar kan eenvoudig een nieuwe worden meegenomen en de oude voor diagnose naar een uitgeruste werkplek worden gebracht. Maar dat is nog niet alles!
Een schijfloos station wordt aanzienlijk veiliger — als iemand toevallig het gebouw binnenkomt en alle computers meeneemt, zijn dat slechts verliezen van hardware. Er worden geen gegevens opgeslagen op schijfloze stations.
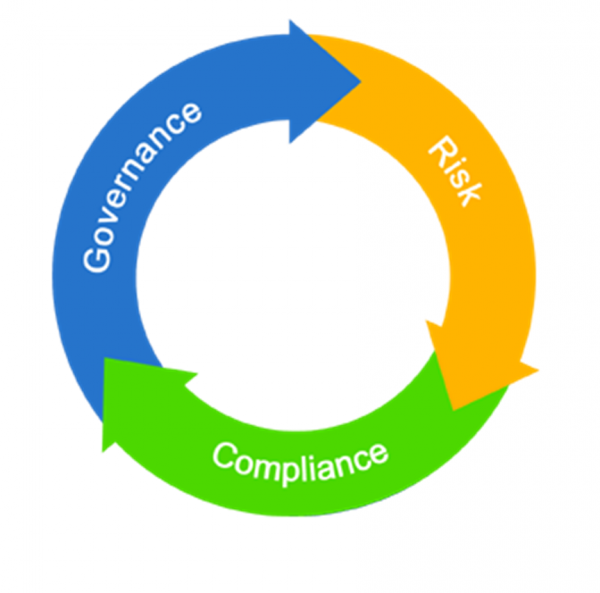
Laten we dit moment onthouden; informatiebeveiliging begint een steeds belangrijkere rol te spelen na de 'zorgeloze kindertijd' van de informatietechnologie. En in IT dringen de angstaanjagende en belangrijke 3 letters steeds sterker door — GRC (Governance, Risk, Compliance), of in het Nederlands 'Beheer, Risico, Naleving'.
Terminalservers
De wijdverspreide adoptie van steeds krachtiger persoonlijke computers aan de rand had de ontwikkeling van openbare netwerken aanzienlijk achterhaald. De klassieke client-serverapplicaties uit de jaren '90 en begin jaren '00 functioneerden niet goed via een dunne verbinding, vooral wanneer de data-uitwisseling enige significante waarden vertegenwoordigde. Dit was vooral problematisch voor externe kantoren die via een modem en telefoonlijn waren verbonden, die bovendien periodiek vastliepen of waarmee de verbinding werd verbroken. En...
De spiraal heeft een draai gemaakt en is weer in de terminalmodus terechtgekomen met het concept van terminalservers.
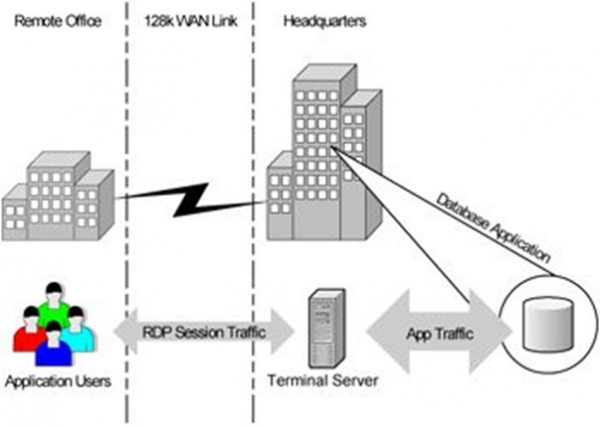
Feitelijk zijn we teruggekeerd naar de jaren '70 met hun nulclients en centralisatie van rekenkracht. Het werd al snel duidelijk dat naast puur economische overwegingen terminaltoegang enorme mogelijkheden biedt voor het organiseren van veilige externe toegang, inclusief thuiswerken voor werknemers of sterk beperkte en gecontroleerde toegang voor contractanten vanuit onbetrouwbare netwerken en onbetrouwbare/niet gecontroleerde apparaten.
Echter, terminalservers hadden, ondanks al hun voordelen en vooruitstrevendheid, ook een aantal nadelen - beperkte flexibiliteit, het probleem van een luidruchtige buur, strikt servergebaseerde Windows, enzovoort.
De geboorte van proto-VDI
In de begin- en midden jaren '00 kwam industriële virtualisatie van x86-platforms al op de voorgrond. Iemand bracht simpelweg de in de lucht zwevende gedachte naar voren: waarom zouden we in plaats van alle clients te centraliseren op servergebaseerde terminalclusters, niet elke gebruiker zijn eigen persoonlijke VM met client-Windows en zelfs administratieve rechten geven?
Afzien van dikke clients
Gelijktijdig met de virtualisatie van sessies en besturingssystemen ontstond er een benadering gericht op het verlichten van de clientfunctie op applicatieniveau.
De logica hierachter was vrij eenvoudig, want persoonlijke laptops waren nog niet wijdverbreid, net zoals internet niet voor iedereen beschikbaar was, en velen konden zich alleen vanuit internetcafés met zeer beperkte, zacht gezegd, rechten verbinden. In feite was het enige wat kon worden uitgevoerd, de browser. De browser werd een onmiskenbaar attribuut van het besturingssysteem, het internet drong hard onze levens binnen.
Met andere woorden, gelijktijdig was er een trend om logica van de client naar het centrum te verplaatsen in de vorm van webapplicaties, waarvoor alleen het eenvoudigste client, internet en een browser vereist zijn.
En we bevonden ons niet zomaar weer waar we begonnen waren - met nul klanten en centrale servers. We zijn daarheen gekomen via verschillende onafhankelijke wegen.
Virtuele Desktop Infrastructuur
Broker
In 2007 bracht de marktleider in industriële virtualisatie, VMware, zijn eerste versie van het product VDM (Virtual Desktop Manager) uit, dat feitelijk de eerste was op de pas beginnende markt van virtuele desktops. Het duurde niet lang voordat er een reactie kwam van de terminalserver-leider Citrix, en in 2008, met de overname van XenSource, werd XenDesktop geïntroduceerd. Er waren zeker ook andere aanbieders met hun voorstellen, maar laten we niet te veel in de geschiedenis duiken en van het concept afwijken.
En tot op de dag van vandaag blijft het concept bestaan. De sleutelcomponent van VDI is de verbindingsbroker.
Dit is het hart van de virtuele desktopinfrastructuur.
De broker is verantwoordelijk voor de belangrijkste processen in de werking van VDI:
- Bepaalt de beschikbare middelen voor de verbinding makende cliënt (machines/sessies);
- Balanceert indien nodig cliënten over de pools van machines/sessies;
- Verbindt de cliënt met de gekozen resource.
Tegenwoordig kan de cliënt (terminal) voor VDI feitelijk alles zijn wat een scherm heeft - een laptop, smartphone, tablet, kiosk, dunne of nul-client. En de responsieve kant, diegene die de operationele belasting uitvoert - een terminalserver-sessie, fysieke machine, virtuele machine. Moderne, volwassen VDI-producten zijn nauw geïntegreerd met de virtuele infrastructuur en beheren deze zelfstandig in een automatisch modus, waarbij ze onnodige virtuele machines uitrollen of juist verwijderen.
Een beetje aan de zijlijn, maar voor sommige klanten is hardware-acceleratie van 3D-grafics voor het werk van ontwerpers of designers een uiterst belangrijke technologie binnen VDI.
Protocol
Een tweede uiterst belangrijke component van een volwassen VDI-oplossing is het protocol voor toegang tot virtuele resources. Als we het hebben over werken binnen een bedrijfsnetwerk met een uitstekende betrouwbare verbinding van 1 Gbps naar de werkplek en een latency van 1 ms, dan kan men feitelijk elk protocol gebruiken zonder erover na te denken.
Je moet nadenken wanneer de verbinding verloopt via een oncontroleerbaar netwerk, waarvan de kwaliteit volkomen variabel kan zijn, tot snelheden van tientallen kilobits en onvoorspelbare vertragingen. Dit is juist voor het organiseren van echte thuiswerken, vanuit huis, vanuit luchthavens en eetgelegenheden.
Terminalservers vs client VM's
Toen VDI verscheen, leek het tijd om afscheid te nemen van terminalservers. Waarom zijn ze nodig als iedereen zijn eigen persoonlijke VM heeft?
Echter, vanuit een puur economische invalshoek blijkt dat voor standaard massawerkplekken, die tot vervelens toe hetzelfde zijn, er voorlopig niets efficiënter is dan terminalservers qua prijs / sessie. Met al hun voordelen verbruikt de benadering “1 gebruiker = 1 VM” aanzienlijk meer middelen voor virtuele hardware en een volwaardige OS, waardoor de economie van standaard werkplekken verslechtert.
In het geval van werkplekken voor topmanagers, niet-standaard en zwaar belaste werkplekken, en de noodzaak om hoge rechten te hebben (tot aan administrator), heeft een toegewezen VM per gebruiker de voorkeur. Binnen deze VM kunnen middelen individueel worden toegewezen, kunnen rechten van elk niveau worden verleend en kunnen VM's tussen virtualisatiehosts worden gebalanceerd bij hoge belasting.
VDI en economie
Jarenlang hoor ik dezelfde vraag - hoezo, is VDI goedkoper dan gewoon laptops aan iedereen geven? En jarenlang moet ik precies hetzelfde antwoord geven: in het geval van gewone kantoormedewerkers is VDI niet goedkoper als je de netto kosten voor het voorzien van apparatuur meerekent. Hoe je het ook wendt of keert, laptops worden goedkoper, maar servers, opslagarrays en systeemsoftware kosten behoorlijk veel geld. Als het tijd is om je apparatuur te vernieuwen en je denkt te besparen met VDI - nee, je bespaart niet.
Ik heb hierboven de verschrikkelijke drie letters GRC genoemd - welnu, VDI gaat over GRC. Het gaat over risicobeheer, over veiligheid en het gemak van gecontroleerde toegang tot gegevens. En dit kost meestal behoorlijk wat geld om te implementeren op een hoop verschillende apparatuur. Met VDI wordt controle eenvoudiger, de veiligheid verhoogd en worden de haren zacht en zijdezacht.
HPE-oplossingen voor thuiswerken
Afstands- en cloudbeheer
iLO
HPE is certainly not a newcomer in remote server infrastructure management; it's been 18 years since the legendary iLO (Integrated Lights Out) was introduced in March. Looking back on my admin days in the 2000s, I can’t help but feel nostalgic. The initial setup in racks and connecting cables was all that needed to be done in the noisy, cold data center. Everything else, including the OS installation, could be done from my desk with two monitors and a cup of hot coffee. And that was 13 years ago!
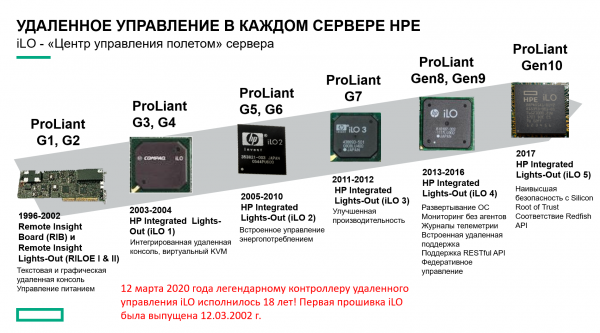
Today, HPE servers are rightly considered an undisputed long-standing quality standard — and the gold standard of remote management systems, iLO, plays a significant role in this.
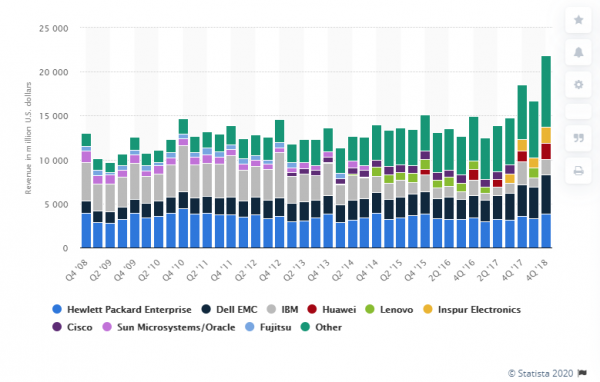
I want to specifically highlight HPE’s actions in maintaining human control over the coronavirus. , that until the end of 2020 (at least) the iLO Advanced license is available for free to everyone.
Infosight
If you have more than 10 servers in your infrastructure and your administrator isn't bored to death, then the cloud-based HPE Infosight AI monitoring system will certainly be a great addition to standard monitoring tools. The system not only monitors the status and creates graphs, but also independently recommends further actions based on the current situation and trends.
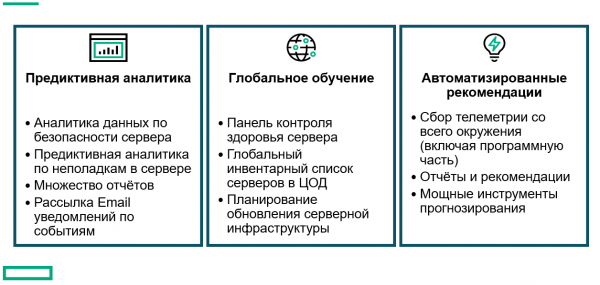
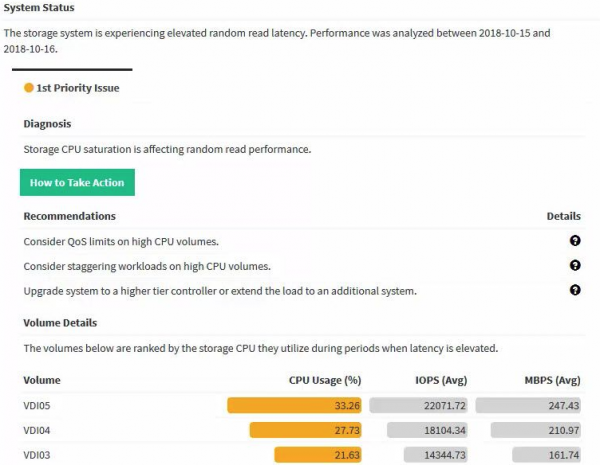
Be smart, , try Infosight!
OneView
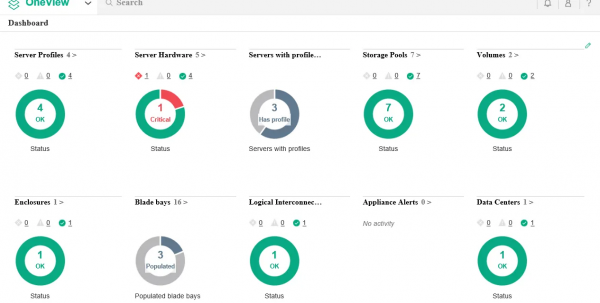
Last but not least, I want to mention HPE OneView — a whole product portfolio with immense capabilities for monitoring and managing the entire infrastructure. And all this without getting up from your desk, which you may well be using currently at your dacha.
Storage systems are no slouches either!
Of course, all storage systems are remotely managed and monitored — that has been the case for many years. Therefore, I want to talk today about something else, namely metro-clusters.
Metro-clusters are not a novelty in the market, but this is precisely why they are still not very popular — inertia of thought and first impressions play a role. Of course, they existed ten years ago, but they were as expensive as a cast-iron bridge. The years since the first metro-clusters have changed the industry and made the technology more accessible to the general public.
Ik herinner me projecten waarin de onderdelen van de opslaginfrastructuur speciaal verspreid werden — apart voor zeer kritische diensten in een metrocluster, apart voor synchronisatie-replicatie (veel goedkoper).
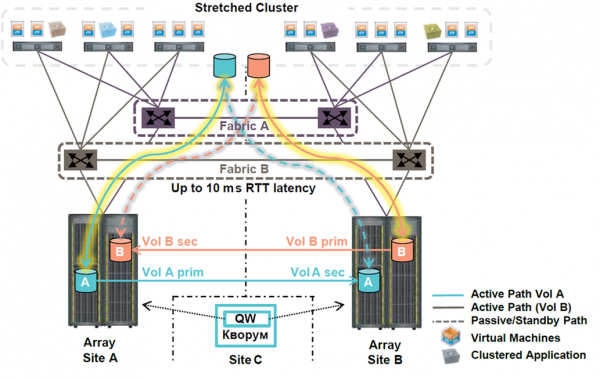
Feitelijk, in 2020 kost een metrocluster u niets, als u in staat bent om twee locaties en kanalen te organiseren. En de kanalen voor synchronisatie-replicatie zijn precies dezelfde als die voor metroclusters. De softwarelicenties worden al lange tijd in pakketten aangeboden — en synchronisatie-replicatie komt als een set met het metrocluster, en het enige dat voorlopig de eenrichtingsreplicatie in leven houdt, is de noodzaak om een uitgestrekt L2-netwerk te organiseren. En toch, L2 over L3 is al volop in het land in opmars.
Wat is dan het fundamentele verschil tussen synchronisatie-replicatie en een metrocluster vanuit het oogpunt van afstandswerk?
Het is heel eenvoudig. Een metrocluster werkt zelf, automatisch, altijd, praktisch onmiddellijk.
Hoe ziet het proces van het overschakelen van de belasting op synchronisatie-replicatie eruit op een infrastructuur met enkele honderden VM's?
- Er komt een signaal over een storing.
- De wachtende ploeg analyseert de situatie — u kunt gerust 10 tot 30 minuten reserveren alleen voor het ontvangen van het signaal en het nemen van een besluit.
- In het geval dat de wachtende ingenieurs niet het mandaat hebben om de overschakeling zelfstandig te starten — nogmaals gerust 30 minuten om contact op te nemen met iemand die de bevoegdheid heeft, en formele bevestiging van het begin van de overschakeling.
- Het indrukken van de Grote Rode Knop.
- 10-15 minuten voor time-outs en het opnieuw inrichten van volumes, herregistratie van VM's.
- 30 minuten voor het wijzigen van het IP-adres — een optimistische schatting.
- En tenslotte de start van de VM en de lancering van productieve diensten.
Samengevat kan de RTO (tijd tot herstel van bedrijfsprocessen) gerust op 4 uur worden geschat.
Laten we het vergelijken met de situatie op het metrocluster.
- De opslaginfrastructuur begrijpt dat de verbinding met de schouder van het metrocluster verloren is — 15-30 seconden.
- De virtualisatiehosts begrijpen dat de eerste datacentrum verloren is — 15-30 seconden (gelijktijdig met punt 1).
- Automatisch herstarten van de helft tot een derde van de VM's in het tweede datacentrum — 10-15 minuten tot de diensten zijn geladen.
- Ongeveer op dat moment begrijpt de wachtende ploeg wat er is gebeurd.
Samengevat: RTO = 0 voor individuele diensten, 10-15 minuten in het algemeen geval.
Waarom echter herstarten van slechts de helft tot een derde van de VM's? Kijk naar het volgende:
- U doet alles slim en schakelt de automatische balans van VM's in. Daardoor draait gemiddeld slechts de helft van de VM's in een van de datacenters. Het hele idee van een metrocluster is het minimaliseren van downtime, en het is dus in uw belang om ook het aantal VM's dat onder druk staat te minimaliseren.
- Een deel van de services kan op applicatieniveau worden geclusterd, verspreid over verschillende VM's. Deze paren VM's worden ofwel met spijkers vastgezet of met een lint aan verschillende datacenters vastgemaakt, zodat de service niet hoeft te wachten op het herstarten van de VM in geval van een storing.
Met een goed ontworpen infrastructuur met verspreide metroclustermanagement kunnen zakelijke gebruikers vanuit elke locatie met minimale vertraging werken, zelfs in het geval van een storing op datacenter niveau. In het slechtste geval bedraagt de vertraging de tijd voor een kop koffie.
En natuurlijk werken metroclustermanagement perfect met de HPE 3Par-systemen die naar Valinor gaan, evenals met de gloednieuwe Primera!
Infrastructuur voor thuiswerken
Terminalservers
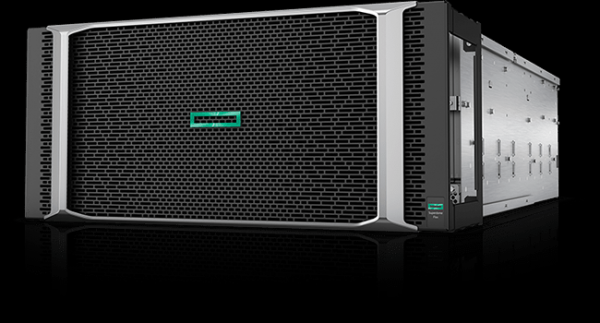
Voor terminalservers is er niets nieuws uit te vinden; HPE levert al jaren een van de beste servers ter wereld hiervoor. Tijdloze klassiekers zijn de DL360 (1U) of DL380 (2U), en voor AMD-liefhebbers is er de DL385. Natuurlijk zijn er ook blade servers, zowel de klassieke C7000 als het nieuwe modulaire platform Synergy.
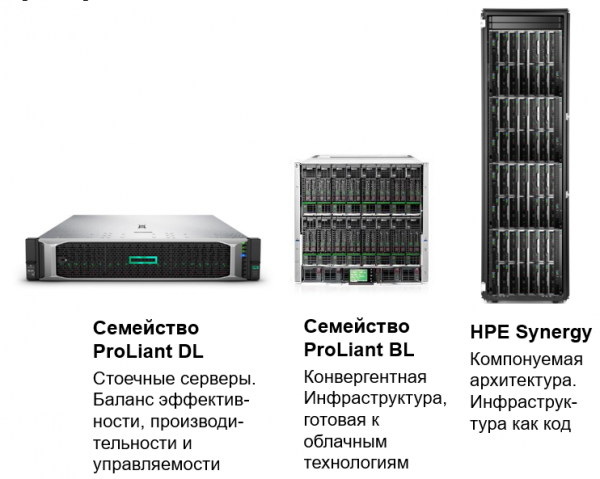
Voor elke smaak, voor elke kleur, maximaal aantal sessies per server!
“Klassieke” VDI + HPE Simplivity
In dit geval bedoel ik met “klassieke VDI” het concept 1 gebruiker = 1 VM met de client Windows. En er is natuurlijk geen VDI-belasting die dichter bij hyper-geconvergeerde systemen komt, vooral niet met deduplicatie en compressie.
Hier kan HPE zowel de eigen hyper-geconvergeerde platform Simplivity als servers/gecertificeerde nodes aanbieden voor partneroplossingen, zoals VSAN Ready Nodes voor het opbouwen van VDI op VMware VSAN-infrastructuur.
Laten we iets dieper ingaan op de eigen oplossing Simplivity. De focus ligt, zoals de naam al doet vermoeden, op eenvoud (Engels: simple). Eenvoud in implementatie, eenvoud in beheer, eenvoud in schaalbaarheid.
Hyper-converged systemen zijn vandaag de dag een van de heetste onderwerpen in de IT, en het aantal leveranciers van verschillende niveaus bedraagt ongeveer 40. Volgens de magische vierkant van Gartner staat HPE wereldwijd in de top 5 en behoort het tot de leiders — bedrijven die begrijpen waar de industrie naartoe gaat en dit begrip in hardware kunnen omzetten.
Architectonisch gezien is Simplivity een klassieke hyperconverged systeem met controller virtuele machines, wat betekent dat het verschillende hypervisors kan ondersteunen, in tegenstelling tot systemen die in hypervisors zijn geïntegreerd. En inderdaad, in april 2020 worden VMware vSphere en Microsoft Hyper-V ondersteund, en er zijn plannen aangekondigd om KVM te ondersteunen. Een belangrijk kenmerk van Simplivity sinds zijn lancering op de markt is de hardwarematige versnelling van compressie en deduplicatie met behulp van een speciale acceleratorkaart.
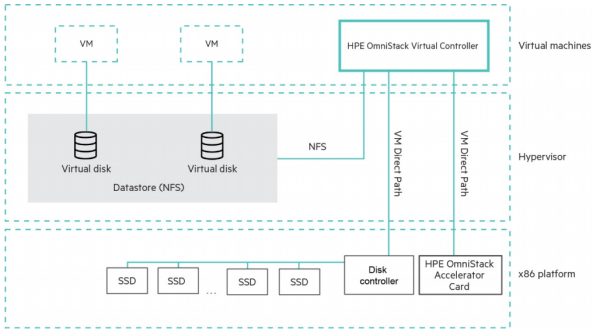
Het moet worden opgemerkt dat compressie met deduplicatie globaal en continu is ingeschakeld, wat betekent dat dit geen optionele functie is, maar een architectuur van de oplossing.
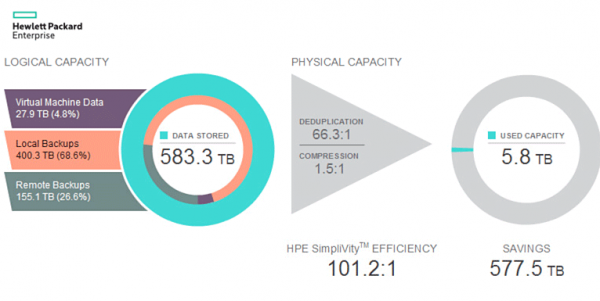
HPE is natuurlijk een beetje huichelen als het de effectiviteit van 100:1 beweert, dit berekend volgens een speciale methode, maar de efficiëntie van het ruimtegebruik is inderdaad zeer hoog. Het cijfer 100:1 is gewoon te mooi. Laten we bekijken hoe Simplivity technisch is gerealiseerd om zulke cijfers te kunnen tonen.
Snapshot. Snapshots zijn 100% correct geïmplementeerd als RoW (Redirect-on-Write), waardoor ze onmiddellijk plaatsvinden en geen prestatiepenalty opleveren, in tegenstelling tot sommige andere systemen. Waarom hebben we lokale snapshots zonder penalties nodig? Heel simpel, om de RPO van 24 uur (de gemiddelde RPO voor back-ups) te verlagen tot tientallen of zelfs enkele minuten.
Back-up. Een snapshot verschilt van een back-up alleen in de manier waarop het wordt waargenomen door het beheer van virtuele machines. Als bij het verwijderen van de machine alles anders ook wordt verwijderd - dan was het een snapshot. Als er iets overblijft - dan is het een back-up. Op deze manier kan elke snapshot als een volledige back-up worden beschouwd, als het in het systeem wordt gemarkeerd en niet wordt verwijderd.
Natuurlijk zullen velen bezwaar maken — hoe kan dit een backup zijn als het op hetzelfde systeem wordt opgeslagen? En hier is een heel eenvoudig antwoord in de vorm van een tegenvraag: heeft u een formeel dreigingsmodel dat de regels voor het opslaan van een back-up vastlegt? Dit is een volledig eerlijke back-up tegen het verwijderen van een bestand binnen de VM, dit is een back-up tegen het verwijderen van de VM zelf. In het geval van de noodzaak om een backup uitsluitend op een aparte standalone systeem op te slaan, zijn er opties: replicatie van deze snapshot naar een tweede Simplivity-cluster of naar HPE StoreOnce.
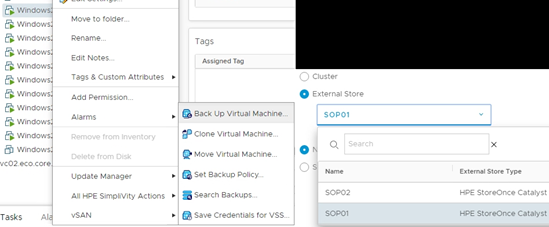
En hier blijkt dat zo'n architectuur gewoon perfect geschikt is voor elk type VDI. Want VDI zijn honderden of zelfs duizenden vrijwel identieke machines met hetzelfde besturingssysteem, met dezelfde applicaties. Wereldwijde deduplicatie vermaalt en comprimeert dit alles zelfs niet 100:1, maar veel beter. Het uitrollen van 1000 VM's vanuit één sjabloon? Geen probleem, deze machines zullen langer registreren in vCenter dan dat ze gekloond worden.
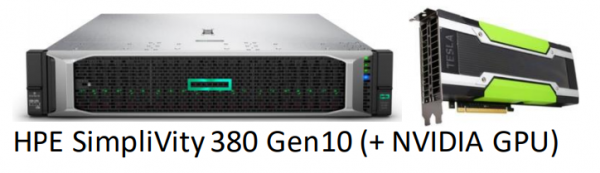
Speciaal voor gebruikers met speciale prestatie-eisen, en voor degenen die 3D-versnellers nodig hebben, is de Simplivity G-serie ontwikkeld.
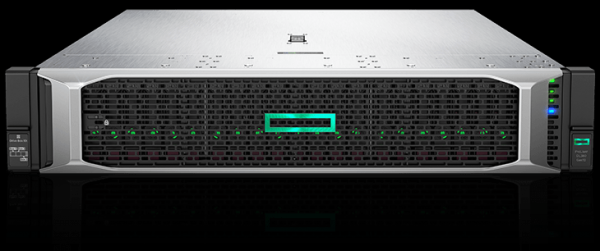
In deze serie wordt er geen hardwarematige deduplicatieversneller gebruikt, waardoor het aantal schijven per node is verminderd, zodat de controller dit softwarematig kan afhandelen. Hierdoor komen er PCIe-slots vrij voor andere versnellers. Ook is het beschikbare geheugen per node verdubbeld tot 3 TB voor de meest veeleisende workloads.
Simplivity is perfect voor het opzetten van geografisch verspreide VDI-infrastructuren met datareplica in een centraal datacentrum.
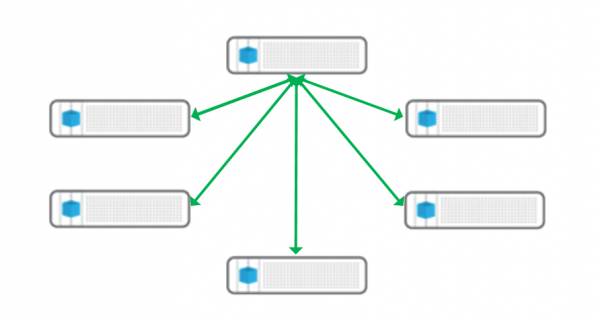
Zo'n VDI-architectuur (en eigenlijk niet alleen VDI) is vooral interessant onder Russische omstandigheden — enorme afstanden (en dus vertragingen) en verre van ideale verbindingen. Regionale centra worden opgericht (of zelfs gewoon 1-2 Simplivity-nodes in een volledig afgelegen kantoor), waar lokale gebruikers verbinding maken via snelle verbindingen, met volledig controle en beheer vanuit het centrum, terwijl in het centrum slechts een beperkte hoeveelheid waardevolle, echte, en geen rommeldata wordt gerepliceerd.
Uiteraard integreert Simplivity volledig met OneView en InfoSight.
Dunne en nul-clients
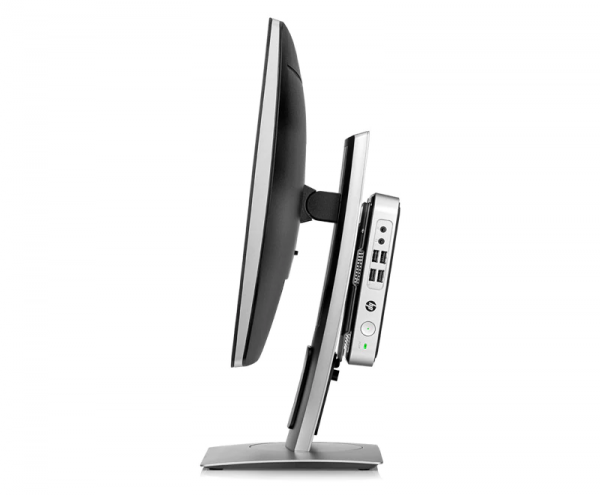
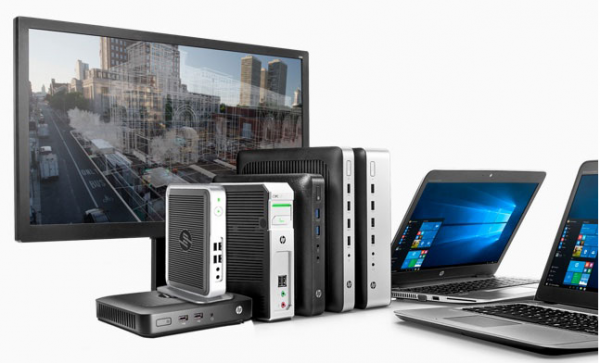
Dunne clients zijn gespecialiseerde oplossingen die uitsluitend als terminals worden gebruikt. Omdat er op de client vrijwel geen belasting is, behalve het onderhouden van de verbinding en het decoderen van video, staat er praktisch altijd een processor met passieve koeling in, een kleine opstartschijf die alleen bedoeld is voor het starten van een speciaal ingebed besturingssysteem, en dat is eigenlijk alles. Er is bijna niets dat kapot kan gaan en stelen heeft geen zin. De kosten zijn laag en er worden geen gegevens in opgeslagen.
Er bestaat een speciale categorie dunne clients, de zogenaamde nul-clients. Het belangrijkste verschil met dunne clients is het ontbreken van zelfs een ingebed algemeen besturingssysteem; ze werken uitsluitend met een microchip met firmware. Vaak worden er speciale hardwareversnellers in geïnstalleerd voor het decoderen van videostreams in terminalprotocols zoals PCoIP of HDX.
Ondanks de splitsing van de grote ‘Hewlett Packard’ in afzonderlijke HPE en HP, moet de productie van dunne clients door HP toch worden genoemd.
De keuze is breed, voor ieder wat wils en behoeften — tot aan multi-monitor werkplekken met hardwarematige versnelling van de videostream.
HPE-service voor uw remote werk
En als laatste, maar zeker niet minder belangrijk, wil ik de HPE-service vermelden. Het zou te lang duren om alle serviceniveaus van HPE en zijn mogelijkheden op te sommen, maar er is minstens één uiterst belangrijk aanbod in het kader van remote werken. Namelijk — een service-engineer van HPE / een geautoriseerd servicecentrum. U blijft werken op afstand, vanaf uw favoriete vakantieadres, terwijl de HPE-engineer in het datacenter de schijven of de defecte voeding in uw servers vervangt.
HPE CallHome
In de huidige tijd, met beperkingen op beweging, wordt de Call Home-functie relevanter dan ooit. Elk HPE-systeem met deze functie kan zelfstandig rapporteren over hardwarematige of softwarematige storingen aan het HPE-supportcentrum. Het is heel goed mogelijk dat het vervangende onderdeel en/of de service-engineer al bij u aankomt voordat u de problemen met de productieve diensten opmerkt.
Persoonlijk raad ik aan deze functie in te schakelen.
Bron: habr.com
