

Mijn naam is Sergey, ik kom van ITSumma en ik wil u vertellen hoe wij het reserveren in Kubernetes benaderen. De laatste tijd houd ik me veel bezig met advieswerk over de implementatie van verschillende devops-oplossingen voor diverse teams, en specifiek werk ik nauw samen aan projecten met K8s. Tijdens de Uptime Day 4-conferentie, die gewijd was aan reserveren in complexe architecturen, presenteerde ik een lezing over het reserveren van de "kubus", en hier is een vrije samenvatting ervan. Maar ik waarschuw u vooraf dat het geen directe handleiding is, maar eerder een samenvatting van gedachten over het onderwerp.
In principe zijn monitoring en reserveren twee essentiële instrumenten voor het verhogen van de fouttolerantie van elk project. Maar u zegt misschien, in K8s balanceert alles zichzelf, alles schaalt vanzelf, en als er iets gebeurt, zal het zichzelf weer opstarten... Dus, bij een oppervlakkig onderzoek van het onderwerp, gaf het internet mij als antwoord op de vraag hoe mensen het reserveren in K8s benaderen: "waarom?" Veel mensen denken dat K8s een soort magische oplossing is die alle infrastructuurproblemen oplost en ervoor zorgt dat een project nooit uitvalt. Maar... de wereld is niet wat ze lijkt.
Hoe zijn we vroeger met het reserveringsproces omgegaan? We hadden identieke platforms voor hosting - of het waren virtuele machines, of het waren fysieke servers servers, waar we drie basale praktijken op toepasten:
- code en statische bestanden synchroniseren
- configuraties synchroniseren
- database replicatie
En voila: op elk moment kunnen we overschakelen naar het reserveplatform, iedereen is blij, we staan op en gaan uiteen.
Wat wordt er voorgesteld om de constante beschikbaarheid van onze Kubernetes-applicatie te vergroten? Het eerste wat de niet-officiële documentatie zegt, is dat je veel machines moet zetten, veel masters moet hebben — het aantal moet voldoen aan de voorwaarden voor quorum binnen de cluster, en op elke master moet etcd, api, MC, scheduler… draaien. En het lijkt geweldig: wanneer een aantal werkknopen of masters uitvalt, wordt onze cluster opnieuw in balans gebracht en blijft de applicatie draaien. Het lijkt opnieuw magie! Maar vaak bevindt onze cluster zich binnen één datacenter en dat kan bepaalde vragen oproepen. Wat als er een graafmachine aan komt rijden en een kabel opgraaft, een bliksem inslaat, of een wereldwijde overstroming plaatsvindt? Alles is verloren, onze cluster is er niet meer. Hoe moeten we het opnemen voor redundantie met het oog op dit probleem?
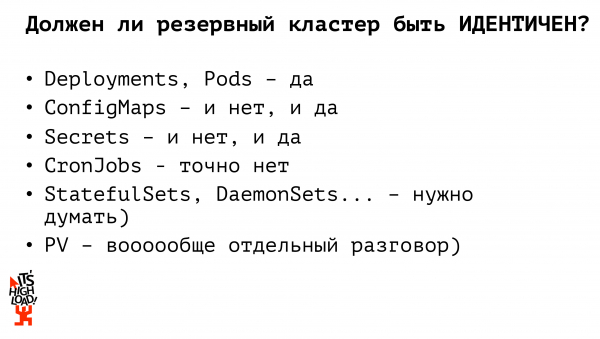
In de eerste plaats moet je een andere cluster in warme reserve hebben, dat wil zeggen een cluster waarop je op elk moment kunt overschakelen. Wat betreft Kubernetes moeten de infrastructuren volledig identiek zijn. Dus als er standaard plugins zijn voor het werken met het bestandssysteem, aangepaste oplossingen voor ingress, moeten deze volledig identiek zijn op je twee (of drie, of tien, afhankelijk van hoeveel geld en middelen de beheerders hebben) clusters. Het is noodzakelijk om twee sets applicaties (deployments, statefulsets, daemonsets, cronjobs, enz.) duidelijk te definiëren: welke daarvan continu op de reserve kunnen draaien, en welke je beter niet kunt starten totdat de daadwerkelijke overschakeling plaatsvindt.
Moet onze reservecluster volledig identiek zijn aan onze productiecluster? Nee. Als we eerder binnen monolithische projecten, met fysieke infrastructuur, vrijwel volledig identieke omgevingen handhaafden, denk ik dat dit binnen Kubernetes niet nodig is. Laten we eens bekijken waarom.
Laten we beginnen met de basisentiteiten van Kubernetes: deployments – deze moeten identiek zijn. Er moeten applicaties draaien die op elk moment het verkeer kunnen verwerken, zodat ons project kan blijven bestaan. Als we het hebben over configuratiebestanden, moeten we kijken of ze identiek moeten zijn of niet. Dus als we, slimme mensen, geen verboden middelen gebruiken en de database niet in K8s hebben, moeten onze configmaps toeganginstellingen bevatten voor de productie database (het proces van back-up is apart opgezet). Voor de toegang tot de reserve database-instance moeten we een apart configuratiebestand (configmap) hebben. Evenzo werken we met secrets: wachtwoorden voor de database toegang, API-sleutels; op elk moment kan we ofwel de productie secret ofwel de reserve secret gebruiken. Tot nu toe hebben we al twee Kubernetes-entiteiten waarvan de reserveversies niet identiek moeten zijn aan de productieversies. De volgende entiteit waarop we moeten focussen is de cronjob. Cronjobs op de reserve moeten zeker niet identiek zijn aan de set cronjobs van de productiecluster! Als we een reserve cluster opzetten en het volledig met alle actieve cronjobs opstarten, zullen mensen bijvoorbeeld twee e-mails tegelijkertijd ontvangen in plaats van één. Of een of andere gegevenssynchronisatie met externe bronnen vindt twee keer plaats, wat ertoe leidt dat we ons onwel voelen, gaan huilen, schreeuwen en klagen.
En hoe stellen mensen op het internet voor om een reserve cluster te organiseren? Het op één na populairste antwoord na "waarom?" is het gebruik van Kubernetes Federation.
Wat is dit? Dit is een grote meta-cluster. Als we de architectuur van Kubernetes voorstellen — waar we een master en meerdere nodes hebben — hebben we ook vanuit het perspectief van federatie een master en meerdere nodes, waarbij elke node een aparte cluster is. Dit betekent dat we met dezelfde entiteiten en primitieven werken als met een enkele Kubernetes-cluster, maar dan niet met onze fysieke machines, maar met complete clusters. Binnen de federatie is er volledige synchronisatie van federatieve resources van ouders naar kinderen. Bijvoorbeeld, als we een bepaalde deployment via de federatie hebben gestart, wordt deze op elke dochtercluster gedeployed. Als we een configmap of secret nemen en deze via de federatie verspreiden, wordt het naar al onze dochterclusters verspreid; tegelijkertijd stelt de federatie ons in staat om onze resources op de kinderen aan te passen. Dit betekent dat we een bepaalde configmap via de federatie hebben gedeployed en als we vervolgens iets willen aanpassen op specifieke clusters, gaan we de wijzigingen aanbrengen op de afzonderlijke cluster en deze wijziging zal niet verder gesynchroniseerd worden.
Kubernetes Federation is a fairly new tool that does not support the full range of resources provided by K8s itself. At the time the first version of the documentation was published, it only mentioned support for config maps, deployment under replica set, and ingress. Secrets were not supported, and working with volumes was also not supported. This limited functionality is especially problematic for those of us who enjoy experimenting; for example, we cannot push our custom resources to the federation via custom resource definitions. It is a solution that feels somewhat accurate but makes us periodically shoot ourselves in the foot. On the other hand, federation allows us to flexibly manage our replicaset. For instance, if we want to run 10 replicas of our application, federation will proportionally distribute this number among the clusters by default. This can also be configured! We can specify that we want to keep 6 replicas of our application on the production cluster, while on the backup cluster, either for resource savings or personal experimentation, we can have only 4 replicas of our application. This is quite convenient as well. However, with federation, we have to rely on new solutions, deploy things on the fly, and think a bit more...
Is there a simpler way to approach the process of reserving Kubernetes? What tools do we actually have?
First of all, we always have some sort of CI/CD system, which means we do not manually access the servers to write create/apply commands. The system generates YAML files for our containers.
Secondly, there are several clusters; we either have one or multiple (if we are smart) registries that we have also reserved. And we have a wonderful utility called kubectl, which can work with multiple clusters simultaneously.
Dus, naar mijn mening is de eenvoudigste en meest betrouwbare oplossing voor het opzetten van een back-upcluster een primitieve parallelle deploy. Er is een pipeline in het CI/CD-systeem; we bouwen eerst onze containers, testen en rollen de applicaties uit via kubectl naar meerdere onafhankelijke clusters. We kunnen gelijktijdige uitrol naar meerdere clusters uitvoeren. Bijgevolg lossen we ook de levering van configuraties op in deze fase. We kunnen vooraf een set configuraties voor ons productieve cluster definiëren, een set configuraties voor het back-upcluster, en op het niveau van het CI/CD-systeem kunnen we de productie-omgeving naar het productiecluster uitrollen, de back-upomgeving naar het back-upcluster. In tegenstelling tot een federatie hoeven we, na het bepalen van de federatieve resource, niet naar elk subcluster te gaan en iets te herdefiniëren. We hebben dit van tevoren gedaan. Wat zijn wij geweldig.
Maar... er is... ik had geschreven, er is de „wortel van alle kwaad“, maar er zijn er eigenlijk twee. Ten eerste het bestandssysteem. Er is een of andere PV, of we gebruiken externe opslag. Als we bestanden binnen het cluster opslaan, moeten we handelen volgens de oude praktijken die zijn overgebleven uit de tijd van fysieke infrastructuren: bijvoorbeeld synchroniseren met lsync. Of met een andere door u persoonlijk verkozen oplossing. We rollen alles uit naar andere machines en leven verder.
Ten tweede, en eigenlijk zelfs een belangrijker knelpunt — de database. Als we slimme mensen zijn en de database niet in Kubernetes houden, dan is het proces van gegevensback-up volgens dezelfde oude methode — master-slave replicatie, dan overschakelen, de replicatie bijwerken en we leven goed. Maar als we onze DB binnen het cluster houden, zijn er in principe veel kant-en-klare oplossingen voor het organiseren van dezelfde master-slave replicatie, veel oplossingen voor het opzetten van een DB binnen Kubernetes.
Er zijn al miljarden presentaties en artikelen geschreven over het back-uppen van databases, er is hier eigenlijk niets nieuws te zeggen. Kortom, volg uw droom, leef zoals u wilt, verzin ook wat ingewikkelde oplossingen voor uzelf, maar denk goed na over hoe u al dit alles gaat back-uppen.
En nu over hoe we het proces van overschakelen naar de reserve locatie in het geval van brand zullen aanpakken. Ten eerste implementeren we parallel stateless applicaties. Ze hebben geen invloed op de bedrijfslogica van onze applicaties, ons project, we kunnen constant twee sets draaiende applicaties hebben, en ze kunnen beginnen met het ontvangen van verkeer. Het is erg belangrijk om tijdens het overschakelen naar de reserve locatie te kijken of de configuraties moeten worden overschreven. Bijvoorbeeld, we hebben een productieklast van Kubernetes, er is een reserve Kubernetes-klaar, er is een externe masterdatabase en er is een reserve masterdatabase. We hebben vier opties hoe deze applicaties in productie met elkaar kunnen gaan interageren. Onze database kan overschakelen, en dan moet het verkeer in de productieklast naar de nieuwe database worden omgeleid, of onze cluster kan uitvallen — dan zijn we overgestapt naar de reserve, maar blijven we werken met de productiedatabase, en de derde optie is dat zowel dit als dat is uitgevallen, en we schakelen beide applicaties over, herschrijven onze configuratie zodat de nieuwe applicaties met de nieuwe database werken.
En wat voor conclusies kunnen we hieruit trekken?
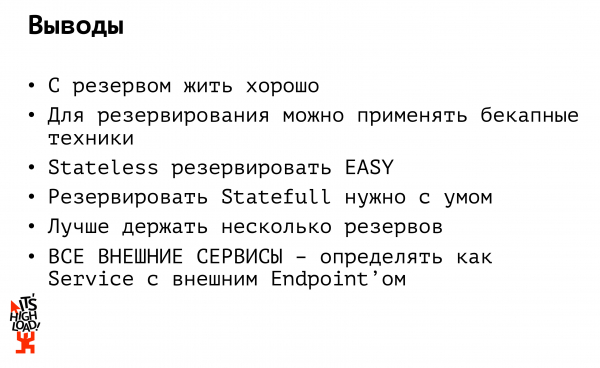
Conclusie één: leven met een reserve is goed. Maar duur. Idealiter zou je niet met één reserve moeten leven. Idealiter zou je met meerdere reserves moeten leven. Ten eerste moet de reserve minstens niet in één datacenter zijn, en ten tweede, bij voorkeur, bij een andere provider. Het is vaak voorgekomen — en dat heb ik zelf meegemaakt. Helaas kan ik de projecten niet noemen, precies toen er een brand was in het datacenter... Ik zei: we schakelen over naar de reserve! Maar de reserve servers stonden in dezelfde rack...
Of stel je voor dat Amazon in Rusland is geblokkeerd (en dat is gebeurd). En dat is het: wat heeft het voor zin dat onze reserve zich in een andere Amazon bevindt? Die is ook niet beschikbaar. Dus ik herhaal: houd een reserve, bij voorkeur in een ander datacenter, maar het liefst bij een andere provider.
Tweede conclusie: als je in Kubernetes een applicatie hebt die met externe bronnen communiceert (dit kan zowel een database zijn als een externe API), zorg er dan voor dat je deze definieert als een service met een externe endpoint. Hierdoor hoef je bij een omschakeling niet 15 van je applicaties opnieuw te implementeren die dezelfde database benaderen. Definieer de database als een aparte service, benader deze alsof deze binnen je cluster zit: als je database faalt, verander je op één plek het IP-adres en ga je verder met je leven.
En tot slot: ik hou van de 'kubus', net als van de experimenten ermee. Ook deel ik graag de resultaten van deze experimenten en mijn persoonlijke ervaringen. Daarom heb ik een serie webinars over K8s opgenomen, welkom op voor meer details.
Bron: habr.com
