

Ideeën en bijeenkomsten over welke processen verder geautomatiseerd kunnen worden, ontstaan dagelijks in bedrijven van verschillende groottes. Maar naast de tijd die nodig is om een model te creëren, moet er ook tijd worden besteed aan de evaluatie en controle of het resultaat geen toevalligheid is. Na implementatie moet elk model onder monitoring worden geplaatst en regelmatig worden gecontroleerd.
Dit zijn allemaal stappen die elke onderneming moet doorlopen, ongeacht hun grootte. Als we het hebben over de schaal en legacy van Sberbank, nemen het aantal verfijningen exponentieel toe. Tegen het einde van 2019 werden binnen Sber al meer dan 2000 modellen gebruikt. Het is niet voldoende om alleen een model te ontwikkelen; integratie met industriële systemen, het ontwikkelen van datastores voor modelopbouw en het waarborgen van de operationele controle op het cluster zijn allemaal noodzakelijk.
Ons team ontwikkelt het platform Sber.DS. Dit platform stelt ons in staat om machine learning-taken op te lossen, versnelt het proces van hypothesevalidatie en vereenvoudigt in het algemeen het ontwikkelings- en validatieproces van modellen, terwijl het ook het resultaat van het model in de productie controleert.
Om uw verwachtingen niet te misleiden, wil ik vooraf zeggen dat deze post een inleiding is en dat er onder de lijn wordt uitgelegd wat er in principe achter het platform Sber.DS schuilgaat. We zullen een apart verhaal vertellen over de levenscyclus van een model, van creatie tot implementatie.
Sber.DS bestaat uit verschillende componenten, waarvan de belangrijkste de bibliotheek, het ontwikkelingssysteem en het uitvoeringssysteem van modellen zijn.
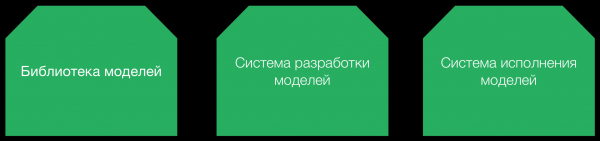
De bibliotheek beheert de levenscyclus van een model, van het moment dat het idee voor de ontwikkeling ontstaat tot de implementatie in de productie, het plaatsen op monitoring en het buiten werking stellen. Veel mogelijkheden van de bibliotheek zijn gedicteerd door de regels van de regulator, zoals rapportage en het opslaan van trainings- en validatiesets. Feitelijk is dit een register van al onze modellen.
Het ontwikkelingssysteem is bedoeld voor visuele ontwikkeling van modellen en validatiemethoden. Ontwikkelde modellen ondergaan een eerste validatie en worden geleverd aan het uitvoeringssysteem om hun zakelijke functies uit te voeren. Ook kan in het uitvoeringssysteem het model op de monitor worden geplaatst om periodiek validatiemethoden te starten ter controle van zijn werking.
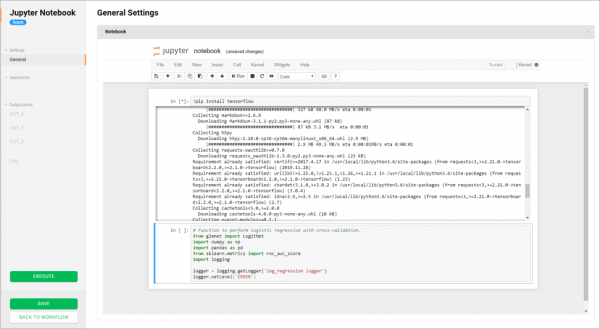
In het systeem zijn er verschillende typen knooppunten. Sommige zijn bedoeld voor verbinding met verschillende gegevensbronnen, andere voor het transformeren van de oorspronkelijke gegevens en het verrijken daarvan (annotatie). Er zijn tal van knooppunten voor het bouwen van verschillende modellen en knooppunten voor hun validatie. De ontwikkelaar kan gegevens uit elke bron laden, transformeren, filteren, tussenresultaten visualiseren en deze in delen splitsen.
Daarnaast bevat het platform al kant-en-klare modules die op het projectgebied kunnen worden gesleept. Alle handelingen worden uitgevoerd via een gevisualiseerde interface. Eigenlijk kan de taak worden opgelost zonder ook maar één regel code te schrijven.
Als de ingebouwde mogelijkheden niet genoeg zijn, biedt het systeem de mogelijkheid om snel eigen modules te maken. We hebben een geïntegreerde ontwikkelingsmodus opgezet op basis van voor degenen die nieuwe modules 'vanaf nul' maken.
De architectuur van Sber.DS is opgebouwd uit microservices. Er zijn veel meningen over wat microservices zijn. Sommigen denken dat het voldoende is om monolithische code in stukken te verdelen, maar ze blijven wel dezelfde database gebruiken. Voor ons moet een microservice met een andere microservice communiceren via REST API. Geen omwegen om direct toegang tot de database te krijgen.
We proberen ervoor te zorgen dat de services niet te groot en log worden: één exemplaar mag niet meer dan 4-8 gigabyte RAM gebruiken en moet de mogelijkheid bieden voor horizontale schaalbaarheid van aanvragen door het starten van nieuwe exemplaren. Elke service communiceert alleen met andere via REST API (). Het team dat verantwoordelijk is voor de service is verplicht om de API achterwaarts compatibel te houden voor de laatste klant die het gebruikt.
De kern van de applicatie is geschreven in Java met gebruik van het Spring Framework. De oplossing is oorspronkelijk ontworpen voor snelle implementatie in cloudinfrastructuur, daarom is de applicatie gebouwd met gebruik van een containerisatie-systeem (). Het platform ontwikkelt zich voortdurend, zowel op het gebied van het uitbreiden van zakelijke functionaliteit (er worden nieuwe connectoren en AutoML toegevoegd) als op het gebied van technologische efficiëntie.
Een van de "kenmerken" van ons platform is dat we code die in de visuele interface is ontwikkeld, kunnen uitvoeren op elk uitvoeringssysteem van Sberbank. Momenteel zijn er al twee: een op Hadoop, de andere - op OpenShift (Docker). We stoppen hier niet en creëren integratiemodules voor het uitvoeren van code op elke infrastructuur, zowel on-premise als in de cloud. Wat betreft de mogelijkheden voor effectieve integratie in het ecosysteem van Sberbank, zijn we ook van plan om ondersteuning te bieden voor bestaande uitvoeringsomgevingen. In de toekomst kan de oplossing flexibel "out-of-the-box" worden ingebed in elk landschap van elke organisatie.
Degenen die ooit geprobeerd hebben om een oplossing te onderhouden die Python op Hadoop in PROD uitvoert, weten dat het niet voldoende is om een gebruikersomgeving voor Python op elke datanode voor te bereiden en te leveren. Een enorm aantal C/C++ bibliotheken voor machine learning die Python-modules gebruiken, maakt dat je niet met een gerust hart kunt slapen. Je moet niet vergeten om pakketten bij te werken bij het toevoegen van nieuwe bibliotheken of servers, terwijl je de achterwaartse compatibiliteit met de al geïmplementeerde code van modellen behoudt.
Er zijn verschillende benaderingen voor hoe dit te doen. Bijvoorbeeld, het vooraf voorbereiden van enkele veelgebruikte bibliotheken en deze in PROD te implementeren. In de Hadoop-distributie van Cloudera wordt hiervoor meestal gebruikt . Daarnaast is er nu in Hadoop de mogelijkheid om -containers te draaien. In sommige eenvoudige gevallen kan de code samen met het pakket .
De bank benadert de veiligheid van het uitvoeren van externe code zeer serieus, daarom maken we zoveel mogelijk gebruik van de nieuwe mogelijkheden van de Linux-kern, waar een proces dat in een geïsoleerde omgeving is uitgevoerd, bijvoorbeeld kan worden beperkt in de toegang tot netwerken en lokale schijven, wat de mogelijkheden voor schadelijke code aanzienlijk vermindert. De datadomeinen van elke afdeling zijn beveiligd en alleen toegankelijk voor de eigenaren van deze gegevens. Het platform garandeert dat gegevens uit een domein alleen in een ander domein kunnen komen via een gegevenspublicatieproces met controle in elke fase, van toegang tot bronnen tot het landen van gegevens in de doelvenster. .
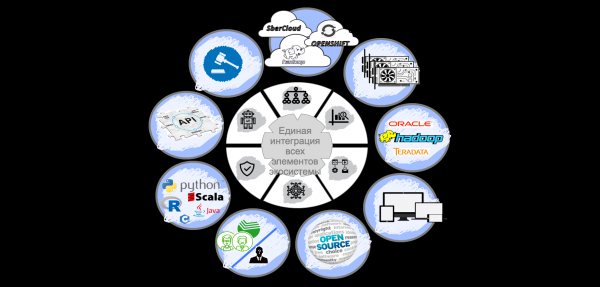
Dit jaar plannen we om de MVP van de lancering van modellen, geschreven in Python/R/Java op Hadoop, af te ronden. We hebben onszelf een ambitieuze doelstelling gesteld om elke gebruikersomgeving op Hadoop te kunnen draaien, zodat we onze gebruikers op ons platform geen beperkingen opleggen.
Bovendien blijkt dat veel DS-specialisten prima wiskunde en statistiek kennen, geweldige modellen maken, maar niet goed zijn in het transformeren van grote data, en ze hebben onze data-engineers nodig om trainingssets voor te bereiden. We hebben besloten om onze collega's te helpen en gebruikersvriendelijke modules te creëren voor standaardtransformaties en het voorbereiden van features voor modellen op de Spark-engine. Dit zal hen in staat stellen meer tijd aan modelontwikkeling te besteden en niet te hoeven wachten tot de data-engineers een nieuwe dataset klaar hebben.
Bij ons werken mensen met kennis op verschillende gebieden: Linux en DevOps, Hadoop en Spark, Java en Spring, Scala en Akka, OpenShift en Kubernetes. De volgende keer zullen we vertellen over de modelbibliotheek, hoe een model door de levenscyclus binnen het bedrijf gaat, en hoe validatie en implementatie plaatsvinden.
Bron: habr.com
