

De directeur van het portal Banki.ru, Andrey Nikolsky, sprak op de conferentie van vorig jaar over weesdiensten: hoe je een weesdienst in de infrastructuur kunt identificeren, wat de nadelen zijn van weesdiensten, wat je ermee kunt doen en wat je moet doen als niets helpt.
Onder de lijn staat de tekstversie van de presentatie.
Hallo collega's! Mijn naam is Andrey, ik leid de operatie bij Banki.ru.
We hebben grote diensten, dat zijn grote monolithische diensten, er zijn diensten in meer klassieke zin, en er zijn ook heel kleine. In mijn dagelijkse terminologie zeg ik dat als een dienst eenvoudig en klein is, deze micro is, en als deze niet al te eenvoudig en niet klein is, dan is het gewoon een dienst.
Voordelen van diensten
Ik zal snel de voordelen van diensten doornemen.
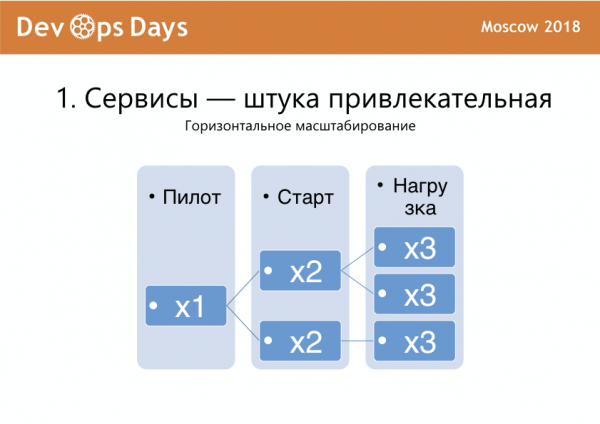
Ten eerste is er schaalbaarheid. Je kunt snel iets met de dienst doen en in productie gaan. Er komt verkeer binnen, je cloneert de dienst. Er komt meer verkeer binnen, je cloneert weer en zo leef je verder. Dit is een goede bonus en in principe werd dit als het belangrijkste beschouwd toen we begonnen, de reden waarom we dit allemaal doen.
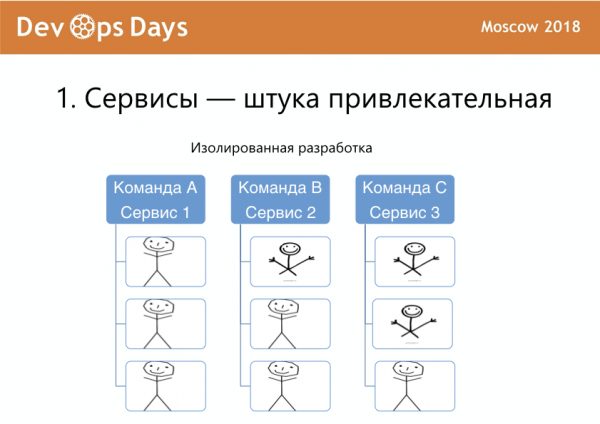
Ten tweede is er geïsoleerde ontwikkeling, wanneer je meerdere teams van ontwikkelaars hebt, verschillende ontwikkelaars in elk team, en elk team bouwt zijn eigen dienst.
Met teams komt er een nuance kijken. Ontwikkelaars zijn niet allemaal gelijk. En er zijn bijvoorbeeld . Ik heb dit voor het eerst gezien bij Maxim Dorofeev. Soms zijn er sneeuwvlokmensen in sommige teams, en in andere niet. Dit maakt de verschillende diensten die binnen het bedrijf worden gebruikt een beetje ongelijkmatig.
Kijk naar de afbeelding: dit is een goede ontwikkelaar, hij heeft grote handen, hij kan veel doen. Het grootste probleem is: waar komen die handen vandaan.
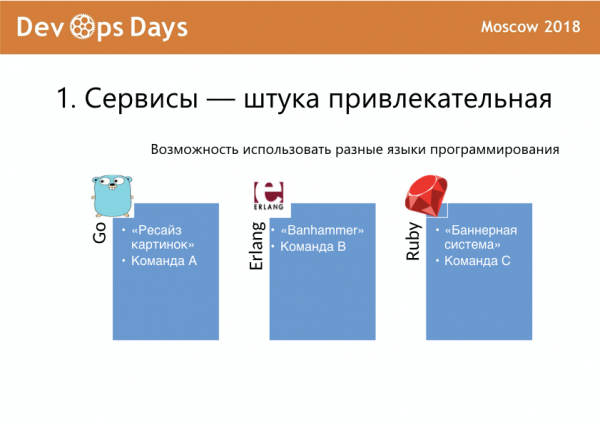
Diensten bieden de mogelijkheid om verschillende programmeertalen te gebruiken, die beter geschikt zijn voor verschillende taken. Een bepaalde dienst in Go, een andere in Erlang, weer een andere in Ruby, iets in PHP, iets in Python. Kortom, je kunt je heel breed uitbreiden. Ook hier zijn er nuances.
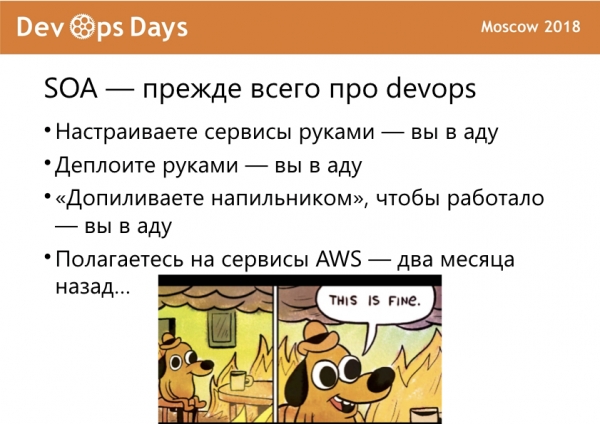
Service-georiënteerde architectuur gaat vooral over devops. Dus als je geen automatisering hebt, geen deployproces, als je alles handmatig instelt, kunnen je configuraties van instantie naar instantie van de dienst verschillen, en dan moet je daarheen gaan om iets te doen, dan zit je in de hel.
Bijvoorbeeld, als je 20 services hebt en je moet handmatig implementeren, heb je 20 consoles, en druk je tegelijkertijd op 'enter', als een ninja. Dat is niet ideaal.
Als je een service hebt na testing (als er natuurlijk getest is) en je moet nog wat bijschaven met een vijl zodat het in productie werkt, heb ik ook slecht nieuws voor je.
Als je afhankelijk bent van specifieke Amazon-services en tegelijkertijd in Rusland werkt, dan had je twee maanden geleden ook 'Alles brandt, ik ben in orde, alles is geweldig'.
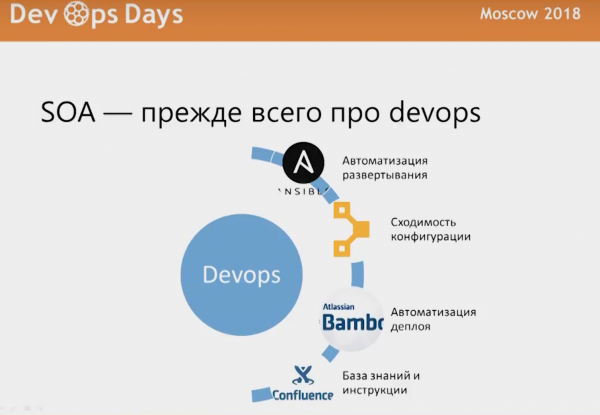
Wij gebruiken Ansible voor de automatisering van implementatie, Puppet voor samenhang, Bamboo voor het automatiseren van deploys, en Confluence om dit allemaal op een of andere manier te documenteren.
Ik zal hier niet in detail op ingaan, omdat de presentatie meer over interactiepraktijken gaat dan over technische implementatie.
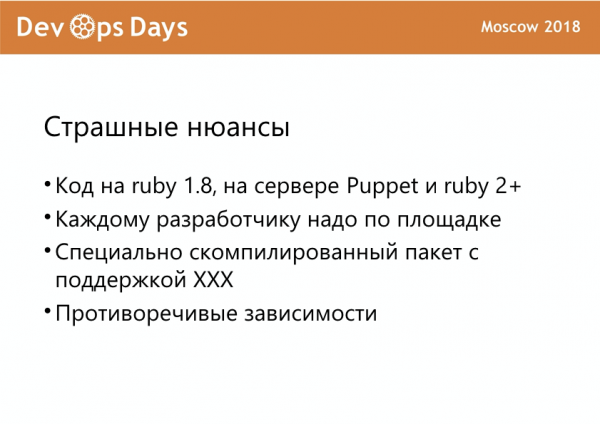
We hebben bijvoorbeeld problemen gehad dat Puppet op de server met Ruby 2 werkt, terwijl een bepaalde applicatie is geschreven voor Ruby 1.8, en samen werken ze niet. Er kan een conflict optreden. En als je op één machine meerdere versies van Ruby moet draaien, ontstaan er meestal problemen.
Wij geven bijvoorbeeld elke ontwikkelaar een omgeving waarin alles is wat wij hebben, alle services die ontwikkeld kunnen worden, zodat er een geïsoleerde omgeving is waarin ze het kunnen breken en opbouwen zoals ze willen.
Soms is er een speciaal gecompileerd pakket nodig met ondersteuning voor iets. Dit is vrij rigide. Ik heb een presentatie gehoord waarin een Docker-image 45 GB weegt. In Linux is het natuurlijk eenvoudiger, het is allemaal iets kleiner, maar alsnog, er is nooit genoeg ruimte.
Daarnaast zijn er tegenstrijdige afhankelijkheden, waarbij een deel van het project afhankelijk is van een bepaalde versie van een bibliotheek, een ander deel van een andere versie, en de bibliotheken samen helemaal niet geïnstalleerd kunnen worden.
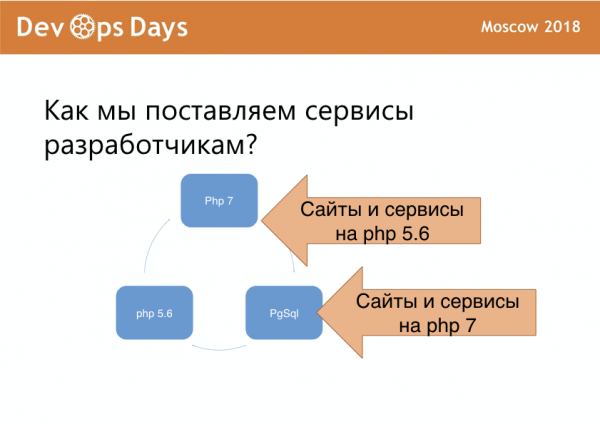
We hebben websites en services die op PHP 5.6 draaien, waar we ons voor schamen, maar wat kun je doen. Dit is één omgeving. Er zijn websites en services op PHP 7, daarvan zijn er meer, en daar schamen we ons niet voor. En elke ontwikkelaar heeft zijn eigen database, waar hij vrolijk aan het werk is.
Als je binnen het bedrijf in één taal schrijft, klinkt drie virtuele machines per ontwikkelaar normaal. Als je verschillende programmeertalen hebt, wordt de situatie moeilijker.
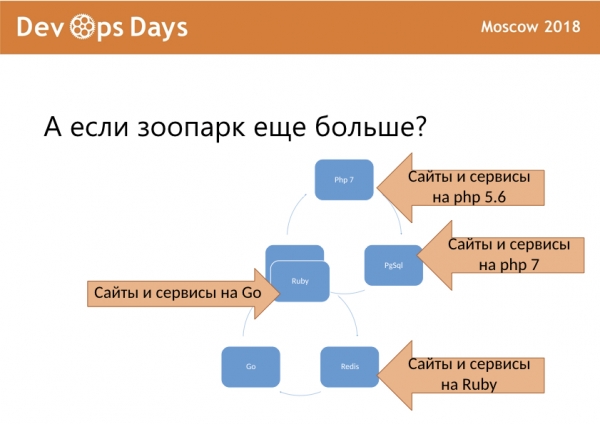
Je hebt websites en diensten, en dan is er ook nog een platform voor Go, een platform voor Ruby, en wellicht nog wat Redis daarnaast. Uiteindelijk verandert dit in een groot gebied voor ondersteuning, en altijd kan er iets kapot gaan.
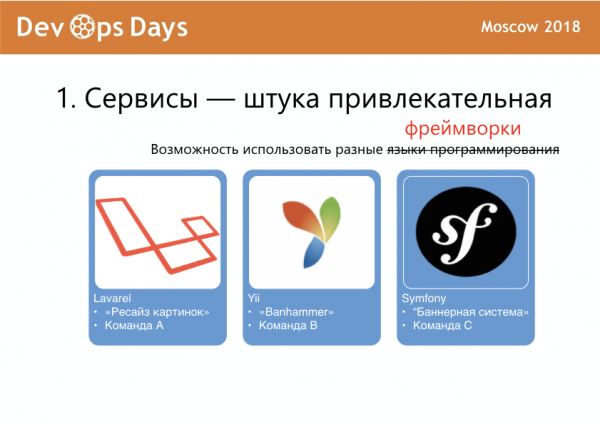
Daarom hebben we de voordelen van programmeertalen vervangen door het gebruik van verschillende frameworks, omdat frameworks in PHP behoorlijk verschillend zijn; ze hebben verschillende mogelijkheden, gemeenschappen en ondersteuning. En je kunt een dienst bouwen zodat je al iets klaar hebt staan.
Elke dienst heeft zijn eigen team.
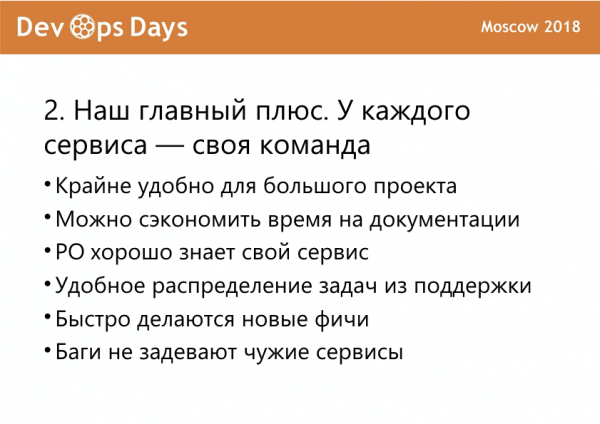
Ons belangrijkste voordeel, dat zich in de loop der jaren heeft bewezen, is dat elke dienst zijn eigen team heeft. Dit is handig voor grote projecten, omdat het tijd kan besparen op documentatie; managers kennen hun project goed.
Ondersteuningstaken kunnen uitstekend worden overgedragen. Bijvoorbeeld, als de verzekeringsdienst kapot is, dan gaat het team dat met verzekeringen bezig is onmiddellijk aan de slag om het te repareren.
Nieuwe functies worden snel ontwikkeld, omdat wanneer je een atomische dienst hebt, je er snel iets aan kunt toevoegen.
En wanneer je jouw dienst hebt kapot gemaakt, en dat gebeurt onvermijdelijk, heb je andere diensten niet geraakt, en komen ontwikkelaars uit andere teams niet met een honkbalknuppel naar je toe om te zeggen: 'Hé, dat moet je niet doen.'
Zoals altijd zijn er nuances. We hebben stabiele teams, de managers zijn goed aan het team gebonden. Er zijn duidelijke documenten en de managers houden nauwlettend in de gaten wat er gebeurt. Elke team heeft meerdere diensten met een manager, en er is een specifieke competentie.
Als teams fluctuerend zijn (wat bij ons ook soms gebeurt), is er een goede methode die de ‘sterkaart’ wordt genoemd.
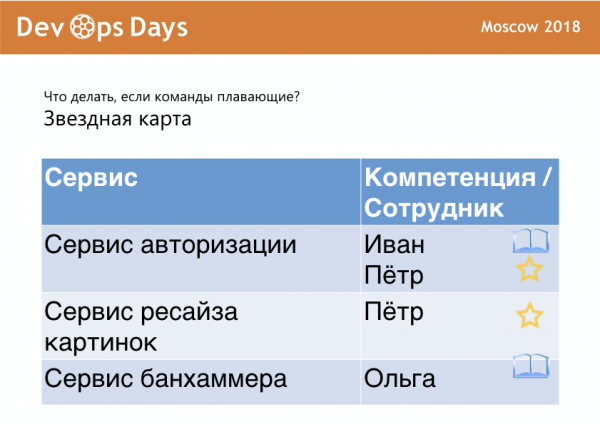
Je hebt een lijst van diensten en mensen. Een sterretje betekent dat iemand een expert is in die dienst, en een boekje betekent dat iemand die dienst aan het bestuderen is. De taak van de persoon is om het boekje in te ruilen voor een sterretje. En als er tegenover een dienst niets staat, beginnen er problemen, waar ik verderop meer over zal vertellen.
Hoe ontstaan er weesdiensten?
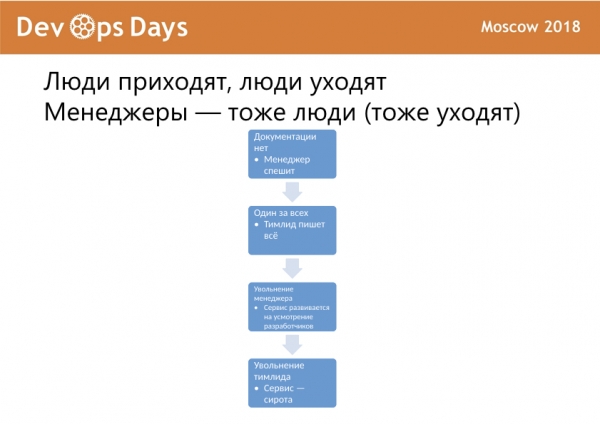
Het eerste probleem, de eerste manier om een service-weeskind in je infrastructuur te krijgen, is het ontslaan van mensen. Heeft iemand ooit meegemaakt dat deadlines vanuit het bedrijf komen nog voordat de taken zijn geëvalueerd? Soms zijn de deadlines zo strak dat er gewoon geen tijd is voor documentatie. "We moeten de service in productie nemen en schrijven later verder aan de documentatie."
Als het team klein is, kan het zijn dat er één ontwikkelaar is die alles schrijft, terwijl de anderen ondersteunen. "Ik heb de belangrijkste architectuur geschreven, jij zorgt voor de interfaces." Vervolgens kan het zijn dat de manager vertrekt. In die periode, wanneer de manager weg is en er nog geen nieuwe is aangesteld, beslissen de ontwikkelaars zelf waar de service naartoe gaat en wat er gebeurt. En zoals we weten (laten we een paar slides teruggaan), zijn er in sommige teams mensen die uniek zijn, soms is er een unieke teamleider. Dan vertrekt hij, en krijgen we een service-weeskind.
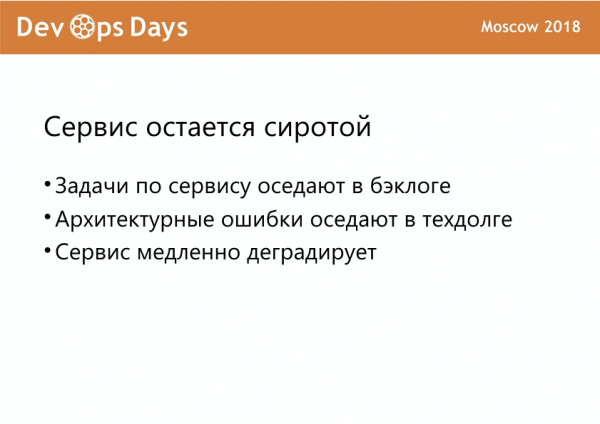
Ondertussen verdwijnen de taken van de ondersteuning en het bedrijf niet, ze blijven in de backlog hangen. Als er tijdens de ontwikkeling van de service architectonische fouten waren, blijven die ook in de backlog. De service degradeert langzaam.
Hoe herken je een weeskind?
Deze lijst beschrijft de situatie goed. Herkent iemand iets uit zijn infrastructuur?
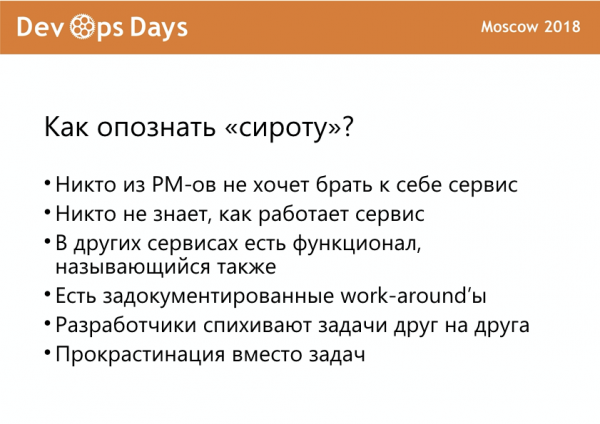
Over gedocumenteerde workarounds: er is een service en in het algemeen werkt hij, er is een handleiding van twee pagina's over hoe ermee te werken, maar hoe hij intern werkt, weet niemand.
Of bijvoorbeeld, er is een linkverkorter. We hebben momenteel drie linkverkorters voor verschillende doeleinden in verschillende diensten. Dit zijn de gevolgen.
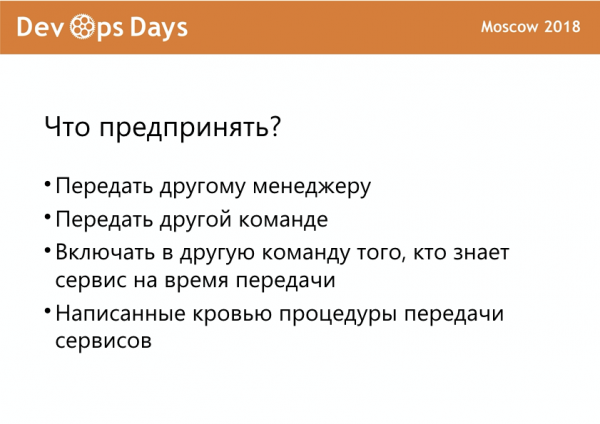
Ik ga nu de captain van de obvious zijn. Wat moet er gedaan worden? Ten eerste moet je de service overdragen aan een andere manager, een ander team. Als je teamleider nog niet is vertrokken, dan moet je in dat andere team iemand opnemen die ook maar iets van die service begrijpt wanneer je je realiseert dat de service op een weeskind lijkt.
De belangrijkste zaak: je moet procedures voor overdracht hebben die met bloed zijn geschreven. In ons geval volg ik dit meestal, omdat ik ervoor moet zorgen dat alles werkt. Managers willen dat het snel wordt afgerond, en wat er daarna mee gebeurt, is voor hen al minder belangrijk.
Een volgende manier om een dry-out te creëren is: 'We doen het uitbesteden, dat gaat sneller, en daarna geven we het door aan het team'. Iedereen heeft wel zijn eigen plannen in het team, zijn eigen wachtlijst. Vaak denkt de zakelijke opdrachtgever dat de uitbesteder hetzelfde zal doen als de technische afdeling in het bedrijf. Hoewel hun motivatie verschillend is. Bij uitbesteding komen soms vreemde technologie- en algoritmische oplossingen voor.
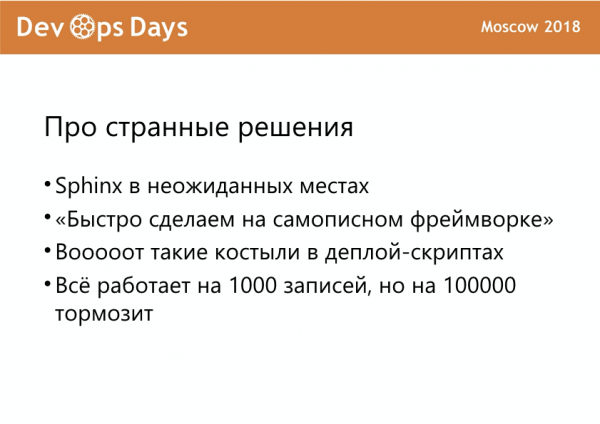
Bij ons hadden we bijvoorbeeld een service waarin Sphinx op verschillende onverwachte plaatsen was. Ik zal later vertellen wat we moesten doen.
Uitbestede diensten hebben soms zelfgeschreven frameworks. Het is gewoon kale PHP met copy-paste van een vorig project, waar je van alles kunt vinden. Grote haken en ogen in de deploy-scripts, wanneer je met complexe Bash-scripts een paar regels in een bepaald bestand moet veranderen, terwijl deze deploy-scripts door een derde script worden aangeroepen. Uiteindelijk pas je het release-systeem aan, kies je iets anders, en hop, werkt je service niet meer. Omdat je nog 8 koppelingen tussen verschillende mappen moest toevoegen. Of het kan gebeuren dat duizend records werken, maar honderdduizend al niet meer.
Ik blijf de leiding nemen. De acceptatie van een service vanuit uitbesteding is een procedure die verplicht is. Wie heeft er wel eens meegemaakt dat een service vanuit uitbesteding arriveert, maar nergens wordt geaccepteerd? Dit is natuurlijk niet zo populair als de dry-out service, maar het komt voor.
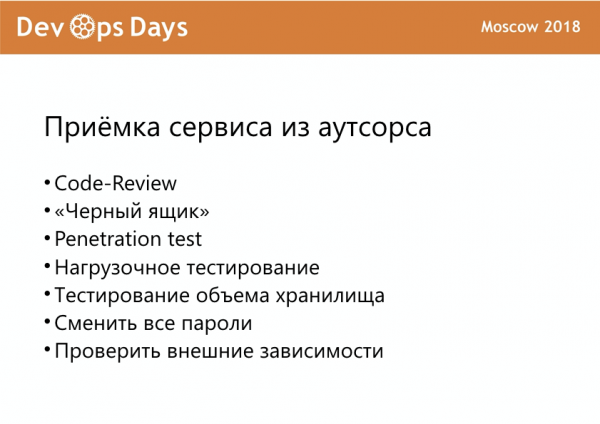
Je moet de service controleren, je moet de service beoordelen, je moet wachtwoorden veranderen. We hadden eens een geval waarin ons een service werd gegeven, daarin stond de admin 'if login == ‘admin’ && password == ‘admin’...' netjes in de code geschreven. We zitten daar en denken, schrijven mensen dit echt in 2018?
Het testen van de opslagcapaciteit is ook belangrijk. Je moet kijken wat er met honderdduizend records gebeurt, nog voordat je deze service live gaat brengen.
Het moet niet beschamend zijn om een service voor verbetering terug te sturen. Wanneer je zegt: 'We accepteren deze service niet, we hebben 20 taken, maak die af en dan accepteren we het', is dat normaal. Je hoeft je niet schuldig te voelen omdat je de manager in de problemen brengt of omdat het bedrijf geld uitgeeft. Het bedrijf zal uiteindelijk meer uitgeven.
We hadden een geval waar we besloten om een pilotproject uit te besteden.
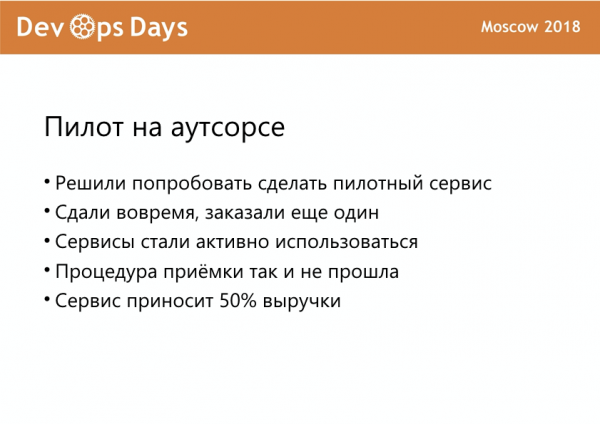
Het werd op tijd opgeleverd, en dat was de enige kwaliteitscriteria. Daarom werd er nog een extra pilotproject gemaakt, dat nu zelfs niet helemaal een pilot was. Deze services werden geaccepteerd, administratief werd er gezegd: dit is jullie code, dit is jullie team, dit is jullie manager. De services beginnen echt winst te genereren. Desondanks zijn ze nog steeds wezen, niemand begrijpt hoe ze werken, en de managers ontdoen zich op allerlei manieren van hun taken.
Er is nog een geweldig concept — guerilla ontwikkeling. Wanneer een bepaalde afdeling, meestal de marketingafdeling, een hypothese wil testen, bestellen ze de service volledig in het uitbesteden. Er begint verkeer naar toe te komen, ze sluiten de documenten af, ondertekenen overeenkomsten met de aannemer, het komt in gebruik en ze zeggen: "Jongens, we hebben een service, er is al verkeer, het brengt ons geld, laten we het aannemen." Wij zijn dan: "Oh, hoe kan dat?"
En weer een manier om een wees-service te verkrijgen: wanneer een team plotseling zwaar belast is, zegt het management: "Laten we deze service van dit team naar een ander team overdragen, dat heeft minder lasten." En dan geven we het door aan een derde team en wisselen we de manager. En uiteindelijk hebben we weer een wees.
Wat is het probleem met weeskinderen?
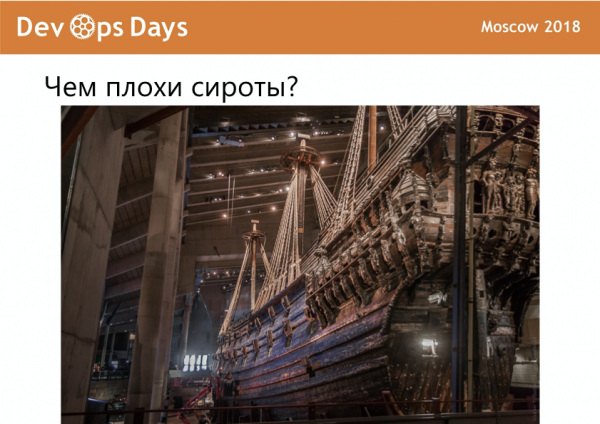
Wie het niet weet, dit is het in Zweden opgetilde slagschip Wasa, beroemd omdat het vijf minuten na de lancering is gezonken. En de koning van Zweden heeft trouwens niemand hiervoor geëxecuteerd. Het werd gebouwd door twee generaties ingenieurs die niet wisten hoe ze zulke schepen moesten bouwen. Een logisch gevolg.
Het schip had overigens veel erger kunnen zinken, bijvoorbeeld als de koning al ergens naartoe zou gaan in een storm. Maar zo zonk het meteen, dat is volgens agile goed — vroeg falen.
Als we vroeg falen, zijn er meestal geen problemen. Bijvoorbeeld, tijdens de acceptatie werd het ter herziening verzonden. Maar als we al in productie zijn gefaald, wanneer er geld in is gestoken, kunnen er problemen zijn. Gevolgen, zoals ze in het bedrijfsleven zeggen.
Waar zijn wees-services gevaarlijk voor:
- De service kan plotseling kapot gaan.
- De service wordt lang gerepareerd of wordt helemaal niet gerepareerd.
- Problemen met de veiligheid.
- Problemen met aanpassingen en updates.
- Als een belangrijke service kapot gaat, lijdt de reputatie van het bedrijf.
Wat te doen met wees-services?
Ik herhaal nogmaals wat er moet gebeuren. Ten eerste moet er documentatie zijn. Na 7 jaar bij Banki.ru heb ik geleerd dat testers de ontwikkelaars niet op hun woord moeten geloven, en dat de exploitatie niet op iedereen moet vertrouwen. Je moet het controleren.
Ten tweede moet je interactieschema's schrijven, omdat het voorkomt dat diensten die niet goed zijn aangenomen, afhankelijkheden bevatten waar niemand het over heeft gehad. Bijvoorbeeld, de ontwikkelaars hebben een dienst gekoppeld aan hun sleutel voor iets zoals Yandex.Maps of Dadata. Je gratis limiet is op, alles is kapot, en je weet helemaal niet wat er is gebeurd. Al deze hobbels moeten worden beschreven: in de dienst wordt Dadata, Sms, of iets dergelijks gebruikt.
Ten derde is er het werken met technische schulden. Wanneer je bepaalde oplossingen maakt of een dienst aanneemt en zegt dat er iets gedaan moet worden, moet je ervoor zorgen dat dit ook echt gebeurt. Want later kan het blijken dat een klein gaatje niet zo klein is, en je erin kunt vallen.
We hebben een verhaal gehad over architectonische taken met Sphinx. In een van de diensten werd Sphinx gebruikt om lijsten in te voeren. Gewoon een lijst met paginering, maar deze werd elke nacht opnieuw geïndexeerd. Hij was samengesteld uit twee indices: één werd elke nacht groot geïndexeerd, en er was nog een kleine index die eraan werd gekoppeld. Elke dag was er bij een kans van 50% of het ging goed of niet, bij het uitrollen ging de index kapot en stopten de nieuwsitems met updaten op de homepage. In het begin duurde het 5 minuten terwijl de index opnieuw werd geïndexeerd, maar later groeide de index en op een gegeven moment begon hij 40 minuten opnieuw te indexeren. Toen we dit eruit haalden, ademden we opgelucht, omdat het duidelijk was dat het niet lang zou duren voordat onze index de volledige werkdag opnieuw zou indexeren. Dit zou een mislukking zijn voor ons portaal, acht uur zonder nieuws — dat betekende dat de business stil stond.
Werkplan voor de weesdienst
In werkelijkheid is het heel moeilijk om dit te doen, omdat DevOps om communicatie gaat. Je wilt goede relaties hebben met je collega's, en wanneer je collega’s en managers met reglementen ‘slagt’ geven, kunnen ze tegenstrijdige gevoelens ervaren jegens de mensen die dat doen.
Naast al deze punten is er nog iets belangrijks: voor elke specifieke dienst en elk specifiek deel van het deploymentproces moeten er specifieke mensen verantwoordelijk zijn. Wanneer er geen mensen zijn en er moeten anderen bij betrokken worden, wordt het lastig om alles te leren.
Als dit alles niet heeft geholpen en de stuurloze service nog steeds niemand wil aannemen, er geen documentatie wordt geschreven en het team dat aan deze service is toegewezen, weigert iets te doen, is er een eenvoudige oplossing: alles opnieuw doen.
Het betekent dat je de eisen voor de service opnieuw neemt en een nieuwe, betere service ontwikkelt, op een betere platform, zonder vreemde technische oplossingen. En je migreert er ter plaatse naartoe.
We hadden een situatie waarin we een service op Yii 1 hebben overgenomen en realizeerden dat we deze niet verder konden ontwikkelen, omdat we geen ontwikkelaars meer hadden die goed konden werken met Yii 1. Alle ontwikkelaars zijn goed in Symfony 3. Wat te doen? We hebben tijd, een team en een manager toegewezen, het project herschreven en geleidelijk het verkeer naar de nieuwe versie omgeleid.
Daarna kan de oude service worden verwijderd. Dit is mijn favoriete procedure, wanneer je uit het configuratiemanagementsysteem een service moet verwijderen en vervolgens moet controleren of alle machines in productie zijn uitgeschakeld, zodat er geen sporen voor ontwikkelaars achterblijven. De repository blijft in git.
Dit is alles wat ik wilde vertellen, ik sta open voor discussie, het is een controversieel onderwerp, velen hebben hierin gezwommen.
Op de dia's werd gesproken over het uniformeren van talen. Een voorbeeld was het resizen van afbeeldingen. Is het werkelijk nodig om strikt tot één taal te gaan? Want het resizen van een afbeelding in PHP, dat had je ook echt in Golang kunnen doen.
In feite is het niet noodzakelijk, net als alle praktijken. In sommige gevallen kan het zelfs ongewenst zijn. Maar je moet begrijpen dat als je in je bedrijf een techteam van 50 mensen hebt, waarvan 45 PHP-ontwikkelaars, 3 DevOps die bekend zijn met Python, Ansible, Puppet en dergelijke, en slechts één van hen schrijft een Go-service voor het resize van afbeeldingen, zodra hij vertrekt, gaat de expertise met hem mee. En dan moet je een specifieke ontwikkelaar op de markt zoeken die deze taal beheerst, vooral als deze zeldzaam is. Dit is organisatorisch problematisch. Vanuit het perspectief van DevOps heb je niet alleen een kant-en-klare set playbooks nodig die je gebruikt om services in te richten, maar je zult ze opnieuw moeten schrijven.
We zijn momenteel een service aan het ontwikkelen in Node.js, en dit zal precies een platform zijn waar elke ontwikkelaar met zijn eigen taal aan de slag kan. Maar we hebben erover nagedacht en besloten dat het de moeite waard is. Dus het is een vraag om even te zitten en na te denken.
Hoe monitor je je services? Hoe verzamel en volg je de logs?
We verzamelen logs in Elasticsearch en plaatsen ze in Kibana, afhankelijk van of het productie- of testomgevingen zijn, worden er verschillende verzamelaars gebruikt. Soms Lumberjack, soms iets anders, dat weet ik niet meer. En er zijn ook enkele plekken in specifieke services waar we Telegraf installeren en de gegevens ergens apart heen sturen.
Hoe leef je met Puppet en Ansible in dezelfde omgeving?
Eigenlijk hebben we momenteel twee omgevingen, één met Puppet, de andere met Ansible. We werken eraan om ze te hybridiseren. Ansible is een goede omgeving voor initiële configuratie, Puppet is niet ideaal voor initiële configuratie omdat het vereisen dat er handmatig met de omgeving gewerkt moet worden, en Puppet waarborgt de configuratieconvergentie. Dit betekent dat de omgeving zichzelf in een actuele staat houdt, en om een met Ansible beheerde machine actueel te houden, moet je regelmatig playbooks uitvoeren. Dit is het grote verschil.
Hoe handhaven jullie compatibiliteit? Hebben jullie configuraties zowel in Ansible als in Puppet?
Dit is onze grote pijn, we handhaven compatibiliteit met de hand en denken aan hoe we van dit alles ergens anders naartoe kunnen gaan. Op een gegeven moment installeren we pakketten met Puppet en onderhouden daar bepaalde koppelingen, terwijl Ansible bijvoorbeeld de code installeert en versies van applicatieconfiguraties aanpast.
In de presentatie ging het over verschillende versies van Ruby. Wat is de oplossing?
We zijn hier op een bepaalde plek tegenaan gelopen, en we moeten dit voortdurend in gedachten houden. We hebben gewoon dat deel dat werkte met de versie van Ruby die niet compatibel was met de applicaties, uitgeschakeld en apart gehouden.
Dit jaar vindt de conferentie plaats op 7 december in 'Technopolis'. Tot 11 november accepteren we voorstellen voor lezingen. als je wilt spreken.
Registratie voor deelnemers is geopend, sluit je aan!
Bron: habr.com
