

Ons team houdt van experimenteren. Elke SRE is geen statische herhaling van de vorige, maar een reflectie van ervaring en een overgang van goed naar beter. Maar met hebben we een totaal nieuw formaat toegepast — deelnemers krijgen omstandigheden die zo dicht mogelijk bij de 'echte' liggen.
Kort samengevat, wat we deden tijdens de intensieve training: 'Bouwen, breken, repareren,
bestuderen'. SRE heeft weinig waarde in blote theorie — alleen praktijk, echte oplossingen, echte problemen.
De deelnemers werden verdeeld in teams, zodat de levendige competitieve geest niemand liet indutten of 'Angry Birds' op de iPhone speelde, zoals Dmitry Anatolievich deed.
Problemen, glitches, bugs en taken werden verzorgd door vier mentoren. Ivan Kruglov, Principal Developer bij Booking.com (Nederland). Ben Tyler, Principal Developer bij Booking.com (VS). Eduard Medvedev, CTO bij Tungsten Labs (Duitsland). Evgeny Varavva, breed profiel ontwikkelaar bij Google (San Francisco).
En bovendien waren de deelnemers verdeeld in teams — en strijden ze tegen elkaar. Interessant?
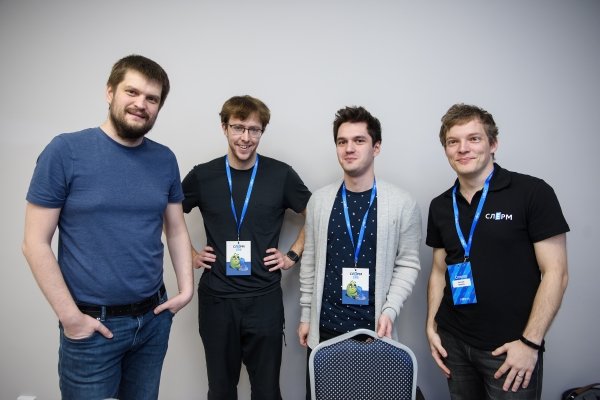
Ivan, Ben, Eduard en Evgeny kijken met een vriendelijke, bijna leninistische blik naar de arme deelnemers van SRE voor de start van de competitie.
Dus de taak:
Wij zullen ons nieuwe wereld opbouwen…
Er is een ticketaggregatorwebsite voor films. De incidenten worden verzonnen door de mentoren volgens een vooraf uitgewerkt scenario (hoewel niemand een verfijnde en sluwe improvisatie uitsluit), de functionaliteit van de website wordt beschreven met verschillende statistieken. De problemen kunnen erg uiteenlopend zijn: tickets voor het theater 'Moulin Rouge' worden niet in de database geladen; film- en theaterposters worden meer dan 10 seconden later in de database geladen; de beschrijving van een specifieke film loopt vast; 0,1% van de bestellingen komt op al gereserveerde plaatsen terecht; periodiek valt het betalingssysteem een minuut of twee uit. En nog veel meer nare dingen die op een deelnemer van SRE kunnen neerkomen in zijn werk.
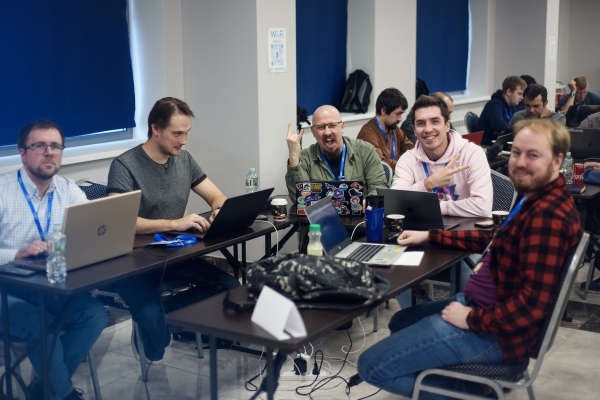
Wij zijn klaar om met alles… en iedereen om te gaan.
Onze doorlopende website bestaat uit verschillende microservices. De taak ervan is het aggregeren van gegevens over vertoningen, prijzen en beschikbare plaatsen van alle bioscopen. Het toont filmaanbiedingen, laat je de bioscoop, vertoning, zaal en plaats kiezen, en boeken en betalen voor tickets. Kortom, alles waar een kijker alleen maar van kan dromen. Maar de gebruiker heeft geen idee van de titanenstrijd voor de stabiliteit en beschikbaarheid van de site die zich binnenin afspeelt.
Voor de site tijdens de intensieve periode hebben we SLO-, SLI- en SLA-parameters gedefinieerd, architectuur en infrastructuur ontwikkeld, de site gedeployed, monitoring en alarmering ingesteld. En daar gingen we.
SLO, SLI, SLA
SLI zijn prestatieniveau-indicatoren. SLO zijn prestatieniveau-doelstellingen. SLA zijn Service Level Agreements.
SLA is een term uit de ITIL-methodologie en verwijst naar een formele overeenkomst tussen de klant van de dienst en de leverancier, die een beschrijving van de dienst, de rechten en plichten van de partijen, en, het belangrijkste, het overeengekomen kwaliteitsniveau van de geleverde dienst bevat.
SLO is de prestatiedoelstelling: een streefwaarde of bereik van waarden voor het prestatieniveau, gemeten door SLI. Een normale waarde voor SLO is "SLI ≤ streefwaarde" of "ondergrens ≤ SLI ≤ bovengrens".
SLI is een prestatieniveau-indicator — een zorgvuldig gedefinieerde kwantitatieve maat voor een van de aspecten van de geleverde dienst. Voor de meeste services wordt de responsetijd als belangrijkste SLI beschouwd — de tijd die nodig is om een antwoord op een verzoek te retourneren. Andere veelvoorkomende SLI's zijn foutfrequentie, vaak uitgedrukt als het percentage van alle ontvangen verzoeken, en de doorvoersnelheid van het systeem, meestal gemeten in verzoeken per seconde.
Als eerste zullen we de vliegtuigen laten neerstorten, en de meisjes, de meisjes komen later…
Interne en externe factoren begonnen vanaf de eerste minuten het SLO te "bederven". Alles viel op de schouders van de beheerders — zowel ontwikkelaarsfouten, infrastructurele storingen, een toestroom van bezoekers, als DDoS-aanvallen. Alles wat het SLO verslechtert.
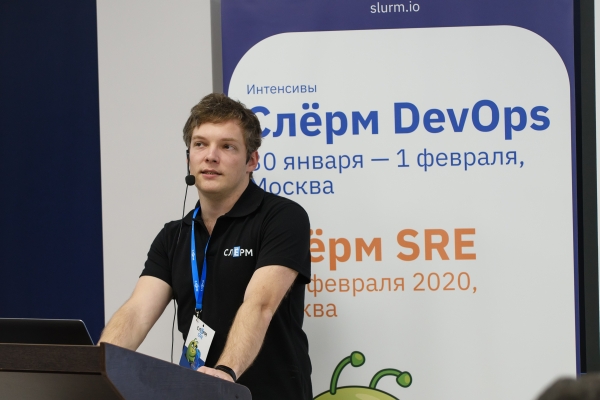
"- Beste deelnemers, ik ben blij jullie te kunnen vertellen dat jullie als eerste… alles zal instorten!"
Onderweg bespraken de sprekers veerkracht, error budget, testpraktijken, het beheer van onderbrekingen en operationele belasting.
We zijn geen kolenkappers, geen timmerlieden…
Hier begonnen de deelnemers met repareren - het belangrijkste is om te begrijpen waarmee we als eerste moeten beginnen.
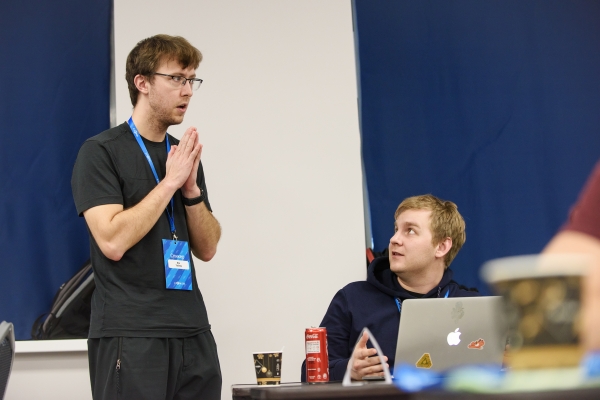
- Mijn God, ik heb nog nooit gezien dat dit zo kapot ging, in deze staat en in deze houding!
Er is een storing opgetreden. De betaalverwerkingsdienst is uitgevallen. Hoe kunnen we zo snel mogelijk weer operationeel zijn?
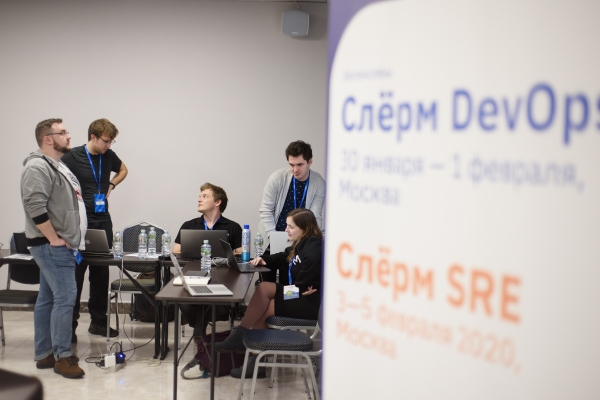
De experts kijken vriendelijk naar de deelnemers en bereiden een nieuwe uitdaging voor.
Elke team organiseert het werk van de groep die de storing verhelpt - zij schakelen collega's in en informeren de belanghebbenden. Tevens worden prioriteiten vastgesteld. Zo zijn de deelnemers getraind om onder druk te werken in situaties van extreem beperkte tijd.
- Wat is dat voor een angstaanjagend iets?!
Haalden adem... en voltooiden de oefening.
Samen met de sprekers bestudeerden de teams na elke opgelost probleem en tijdelijk gestabiliseerde website de incidenten vanuit het perspectief van SRE. Ze analyseerden de problemen gedetailleerd - de oorzaken van optreden, de voortgang van de oplossing. Daarna namen ze, zowel per team als collectief, een beslissing over hoe deze verder te voorkomen: hoe de monitoring te verbeteren, hoe de architectuur goed aan te passen, hoe de benadering van ontwikkeling en exploitatie te corrigeren, en hoe de reglementen te verbeteren. De sprekers demonstreerden de praktijk van post-mortem.
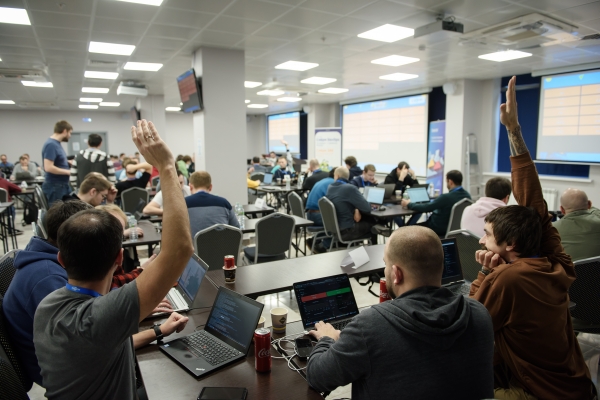
- Wie wil er nog meer lijden! - Ik!
De successen van de teams werden strikt en duidelijk op het elektronische bord genoteerd.
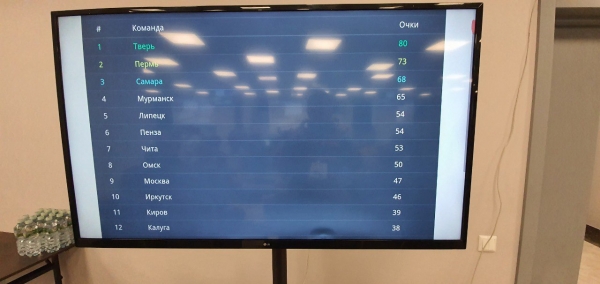
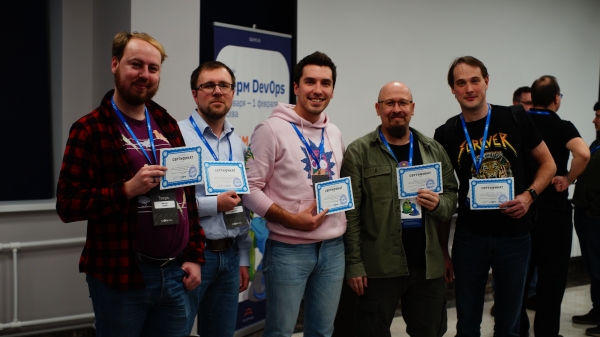
Voor de eerste plaatsen - een prijs van de belanghebbenden.
Bron: habr.com
