

Bij Badoo monitoren we voortdurend nieuwe technologieën en evalueren we of we deze in ons systeem moeten gebruiken. We willen een van deze onderzoeken met de gemeenschap delen. Het is gewijd aan Loki - een systeem voor logaggregatie.
Loki is een oplossing voor het opslaan en bekijken van logs; deze stack biedt ook een flexibele manier voor hun analyse en het verzenden van gegevens naar Prometheus. In mei werd er een nieuwe update uitgebracht die actief wordt gepromoot door de ontwikkelaars. We zijn benieuwd wat Loki kan, welke mogelijkheden het biedt en in hoeverre het kan dienen als een alternatief voor ELK - de stack die we momenteel gebruiken.
Wat is Loki
Grafana Loki is een set componenten voor een complete logwerkingssysteem. In tegenstelling tot andere soortgelijke systemen is Loki gebaseerd op het idee om alleen de metadata van logs te indexeren - labels (net als in Prometheus), terwijl de logs zelf worden gecomprimeerd in aparte chunks.
,
Voordat we ingaan op wat je kunt doen met Loki, wil ik uitleggen wat wordt bedoeld met 'het idee om alleen metadata te indexeren'. Laten we de aanpak van Loki vergelijken met de indexering in traditionele oplossingen, zoals Elasticsearch, aan de hand van een regel uit een nginx-log:
172.19.0.4 - - [01/Jun/2020:12:05:03 +0000] "GET /purchase?user_id=75146478&item_id=34234 HTTP/1.1" 500 8102 "-" "Stub_Bot/3.0" "0.001"Traditionele systemen parseren de hele regel, inclusief velden met veel unieke waarden zoals user_id en item_id, en slaan alles op in grote indexen. Het voordeel van deze aanpak is dat complexe queries snel kunnen worden uitgevoerd, omdat bijna alle gegevens in de index staan. Maar dit heeft als nadeel dat de index groot wordt, wat resulteert in geheugenvereisten. Uiteindelijk is de full-text index van logs vergelijkbaar in grootte met de logs zelf. Om hier snel op te zoeken, moet de index in het geheugen worden geladen. En hoe meer logs er zijn, des te sneller de index groeit en des te meer geheugen deze verbruikt.
De aanpak van Loki vereist dat alleen de noodzakelijke gegevens uit de string worden gehaald, waarvan het aantal waarden beperkt is. Op deze manier krijgen we een kleine index en kunnen we gegevens zoeken door deze te filteren op tijd en op geindexeerde velden, en vervolgens de overgeblevenen te doorzoeken met reguliere expressies of substring-zoekopdrachten. Het proces lijkt niet de snelste, maar Loki verdeelt de aanvraag in meerdere delen en voert deze parallel uit, waardoor een grote hoeveelheid gegevens in korte tijd kan worden verwerkt. Het aantal shards en parallelle aanvragen kan worden geconfigureerd; daarmee hangt de hoeveelheid gegevens die in een bepaalde tijd kan worden verwerkt lineair af van de beschikbare bronnen.
Deze compromis tussen een grote snelle index en een kleine index met parallelle volledige doorzoekingen stelt Loki in staat om de systeekkosten te beheersen. Deze kan flexibel worden ingesteld en uitgebreid op basis van de behoeften.
De Loki-stack bestaat uit drie componenten: Promtail, Loki, Grafana. Promtail verzamelt logs, verwerkt deze en stuurt ze naar Loki. Loki slaat ze op. Grafana kan gegevens uit Loki opvragen en deze tonen. Over het algemeen kan Loki niet alleen worden gebruikt voor het opslaan van logs en het zoeken erin. De hele stack biedt uitgebreide mogelijkheden voor het verwerken en analyseren van binnenkomende gegevens, met behulp van de Prometheus-methode.
Informatie over het installatieproces is te vinden .
Zoeken in logboeken
Zoeken in logs kan in de speciale Grafana-interface — Explorer. Voor aanvragen wordt de LogQL-taal gebruikt, die veel lijkt op PromQL, dat in Prometheus wordt gebruikt. In principe kan het worden beschouwd als een gedistribueerde grep.
De zoekinterface ziet er als volgt uit:
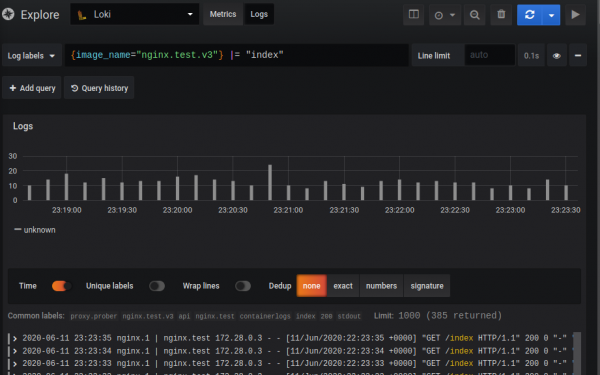
De aanvraag bestaat uit twee delen: selector en filter. De selector is de zoekopdracht naar de geïndexeerde metadata (labels) die aan de logs zijn toegewezen, terwijl de filter de zoekterm of regex is waarmee de records die door de selector zijn gedefinieerd, worden gefilterd. In het gegeven voorbeeld: In de accolades staat de selector, alles wat daarna komt, is de filter.
{image_name="nginx.promtail.test"} |= "index"Vanwege de wijze waarop Loki functioneert, kunnen er geen aanvragen zonder selector worden gedaan, maar de labels kunnen zo algemeen zijn als gewenst.
De selector is een key-value pair in accolades. Selectors kunnen worden gecombineerd en verschillende zoekvoorwaarden worden ingesteld, met behulp van de operatoren =, != of reguliere expressies:
{instance=~"kafka-[23]",name!="kafka-dev"}
// Vindt logs met het label instance, met waarden kafka-2, kafka-3, en sluit dev uit
Een filter is een tekst of regex die alle gegevens affiltert die zijn verkregen via de selector.
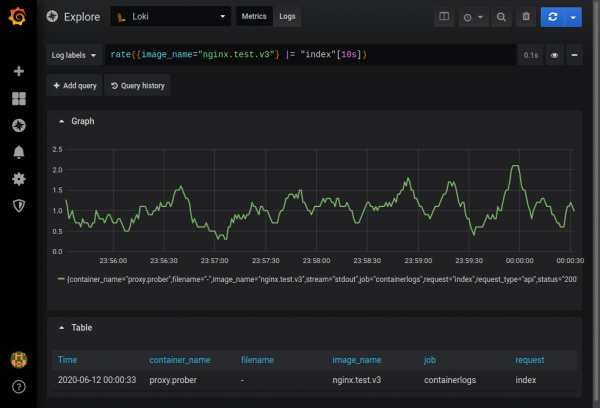
Er is een mogelijkheid om ad-hoc grafieken te genereren op basis van de verkregen gegevens in de metrics modus. Bijvoorbeeld, je kunt de frequentie achterhalen waarmee in de nginx logs een record verschijnt dat de string index bevat:
Een volledige beschrijving van de mogelijkheden is te vinden in de documentatie .
Log parsing
Er zijn verschillende manieren om logs te verzamelen:
- Met Promtail, de standaardcomponent van de stack voor logverzameling.
- Direct vanaf de Docker-container met behulp van
- Gebruik Fluentd of Fluent Bit, die in staat zijn om gegevens naar Loki te verzenden. In tegenstelling tot Promtail hebben ze kant-en-klare parser voor praktisch elk type log en kunnen ook omgaan met multiline logs.
Gewoonlijk wordt Promtail gebruikt voor parsing. Het doet drie dingen:
- Zoekt naar gegevensbronnen.
- Voegt labels toe.
- Verzendt gegevens naar Loki.
Momenteel kan Promtail logs lezen van lokale bestanden en van het systemd journal. Het moet op elke machine worden geïnstalleerd waarvan de logs worden verzameld.
Er is een integratie met Kubernetes: Promtail ontdekt automatisch de status van de cluster via de Kubernetes REST API en verzamelt logs van een node, service of pod, waarbij het onmiddellijk labels toevoegt op basis van metadata uit Kubernetes (naam van de pod, bestandsnaam, enz.).
Het is ook mogelijk om labels toe te voegen op basis van gegevens uit de log met behulp van een Pipeline. De Promtail Pipeline kan uit vier types stadia bestaan. Meer details — in , hier zal ik enkele nuances vermelden.
- Parsing stages. Dit is de RegEx en JSON fase. In deze fase extraheren we gegevens uit de logs naar de zogenaamde extracted map. Gegevens kunnen uit JSON worden geëxtraheerd door de benodigde velden simpelweg naar de extracted map te kopiëren, of via reguliere uitdrukkingen (RegEx), waarbij in de extracted map ‘named groups’ worden gemapt. De extracted map is een key-value opslag, waarbij key de naam van het veld is en value de waarde uit de logs.
- Transform stages. Deze fase heeft twee opties: transform, waar we transformatiespecificaties opgeven, en source — de gegevensbron voor de transformatie uit de extracted map. Als er een veld in de extracted map ontbreekt, wordt het aangemaakt. Zo kunnen labels worden gecreëerd die niet op de extracted map zijn gebaseerd. In deze fase kunnen we de gegevens in de extracted map manipuleren met behulp van een behoorlijk krachtige . Bovendien moet men er rekening mee houden dat de extracted map volledig wordt geladen tijdens het parseren, wat de mogelijkheid biedt om bijvoorbeeld de waarde daarin te controleren: “{{if .tag}tag value exists{end}}”. De sjabloon ondersteunt voorwaarden, lussen en enkele stringfuncties zoals Replace en Trim.
- Actiefasen. In deze fase kan er iets gedaan worden met de extractie:
- Een label aanmaken van de extracted data dat zal worden geïndexeerd in Loki.
- De tijd van de gebeurtenis in het logboek veranderen of instellen.
- De data (logtekst) die naar Loki gaat wijzigen.
- Metrics aanmaken.
- Filterstadia. De matchfase, waarin je ofwel records die we niet nodig hebben naar /dev/null kunt sturen, of ze voor verdere verwerking kunt doorsturen.
Ik laat aan de hand van een voorbeeld van de verwerking van gewone nginx-logs zien hoe je logs kunt parseren met Promtail.
Voor de test nemen we als nginx-proxy een gemodificeerde afbeelding van nginx jwilder/nginx-proxy:alpine en een kleine daemon die zichzelf via HTTP kan bevragen. De daemon heeft verschillende eindpunten waarop hij antwoorden van verschillende grootte kan geven, met verschillende HTTP-statussen en verschillende vertragingen.
We zullen logs verzamelen van Docker-containers, die te vinden zijn op het pad /var/lib/docker/containers//-json.log
In docker-compose.yml configureren we Promtail en geven we het pad naar de configuratie op:
promtail:
  image: grafana/promtail:1.4.1
 // ...
 volumes:
   - /var/lib/docker/containers:/var/lib/docker/containers:ro
   - promtail-data:/var/lib/promtail/positions
   - ${PWD}/promtail/docker.yml:/etc/promtail/promtail.yml
 command:
   - '-config.file=/etc/promtail/promtail.yml'
 // ...
We voegen in promtail.yml het pad naar de logs toe (in de configuratie is er een optie "docker", die hetzelfde doet met één regel, maar dit zou niet zo duidelijk zijn):
scrape_configs:
 - job_name: containers

   static_configs:
       labels:
         job: containerlogs
         __path__: /var/lib/docker/containers/*/*log  # alleen voor linux
Wanneer deze configuratie wordt ingeschakeld, komen de logs van alle containers in Loki terecht. Om dit te vermijden, veranderen we de instellingen van de test-nginx in docker-compose.yml — we voegen logging toe met het veld tag:
proxy:
 image: nginx.test.v3
//…
 logging:
   driver: "json-file"
   options:
     tag: "{{.ImageName}}|{{.Name}}"
We passen promtail.yml aan en configureren de pipeline. De logs van de volgende aard komen binnen:
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] \"GET /api/index HTTP/1.1\" 200 0 \"-\" \"Stub_Bot/0.1\" \"0.096\"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.66740443Z"}
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] \"GET /200 HTTP/1.1\" 200 0 \"-\" \"Stub_Bot/0.1\" \"0.000\"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.702925272Z"}
Pipelinedfase:
 - json:
     expressions:
       stream: stream
       attrs: attrs
       tag: attrs.tag
We extract the fields stream, attrs, attrs.tag (if they exist) from the incoming JSON and place them in the extracted map.
 - regex:
     expression: ^(?P([^|]+))|(?P([^|]+))$
     source: "tag"
If we successfully placed the field tag in the extracted map, we use regex to extract the names of the image and the container.
 - labels:
     image_name:
     container_name:
We assign labels. If the extracted data contains the keys image_name and container_name, their values will be assigned to the corresponding labels.
 - match:
     selector: '{job="docker",container_name="",image_name=""}'
     action: drop
We drop all logs where the image_name and container_name labels are not found.
  - match:
     selector: '{image_name="nginx.promtail.test"}'
     stages:
       - json:
           expressions:
             row: log
For all logs where image_name equals nginx.promtail.test, we extract the log field from the original log and place it in the extracted map with the key row.
  - regex:
         # suppress forego colors
         expression: .+nginx.+|.+[0m(?P[a-z_.-]+) +(?P.+)
         source: logrow
We clean the input string using regular expressions and extract the nginx virtual host and the nginx log line.
     - regex:
         source: nginxlog
         expression: ^(?P[w.]+) - (?P[^ ]*) [(?P[^ ]+).*] "(?P[^ ]*) (?P[^ ]*) (?P[^ ]*)" (?P[d]+) (?P[d]+) "(?P[^"]*)" "(?P[^"]*)"( "(?P[d.]+)")?
We parse the nginx log with regular expressions.
    - regex:
           source: request_url
           expression: ^.+\.(?Pjpg|jpeg|gif|png|ico|css|zip|tgz|gz|rar|bz2|pdf|txt|tar|wav|bmp|rtf|js|flv|swf|html|htm)$
     - regex:
           source: request_url
           expression: ^/photo/(?P[^/?.]+).*$
       - regex:
           source: request_url
           expression: ^/api/(?P[^/?.]+).*$
We analyze request_url. Using regex, we determine the purpose of the request: for static files, photos, or API, and set the corresponding key in the extracted map.
       - template:
           source: request_type
           template: "{{if .photo}}photo{{else if .static_type}}static{{else if .api_request}}api{{else}}other{{end}}"
Using conditional operators in Template, we check the established fields in the extracted map and set the appropriate values for the request_type field: photo, static, API. We assign other if none are found. Now request_type contains the request type.
       - labels:
           api_request:
           virtual_host:
           request_type:
           status:
We set the labels api_request, virtual_host, request_type, and status (HTTP status) based on what was successfully placed in the extracted map.
       - output:
           source: nginx_log_row
We change the output. Now the cleaned nginx log goes to Loki from the extracted map.
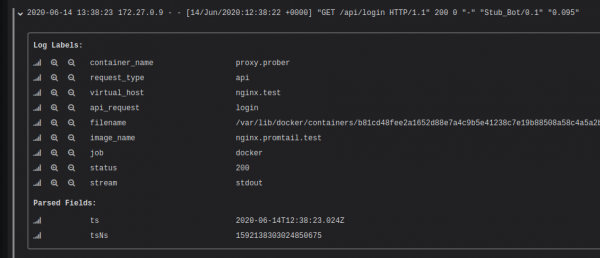
After starting the provided config, we can see that each entry has been assigned labels based on the data from the log.
Houd er rekening mee dat het extraheren van labels met een hoge cardinaliteit de prestaties van Loki aanzienlijk kan vertragen. Dit betekent dat je bijvoorbeeld user_id niet in de index moet opnemen. Meer hierover lees je in het artikel “”. Maar dit betekent niet dat je niet naar user_id kunt zoeken zonder indexen. Je moet filters gebruiken bij het zoeken (door de gegevens 'greppen'), terwijl de index hier fungeert als stroomidentificator.
Visualisatie van logs
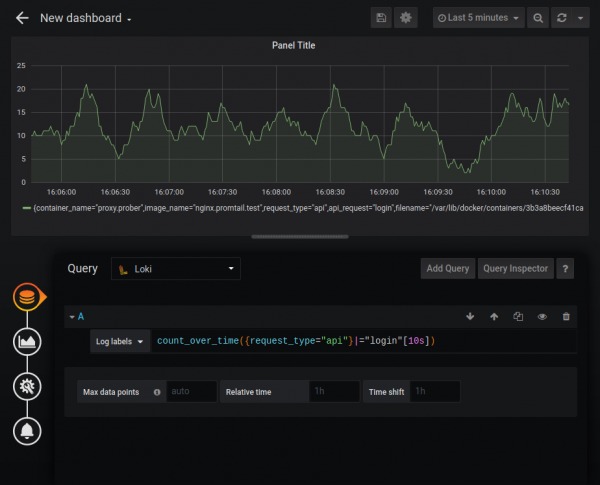
Loki kan fungeren als gegevensbron voor Grafana-diagrammen via LogQL. De volgende functies worden ondersteund:
- rate — aantal registraties per seconde;
- count over time — aantal registraties in een opgegeven bereik.
Daarnaast zijn er aggregatiefuncties zoals Sum, Avg en anderen. Je kunt vrij complexe diagrammen bouwen, bijvoorbeeld een diagram van het aantal HTTP-fouten:
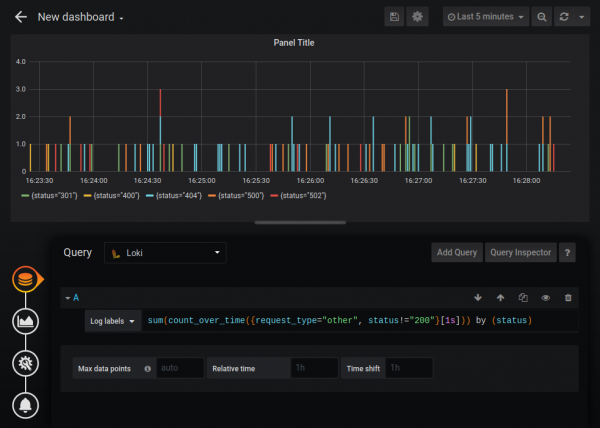
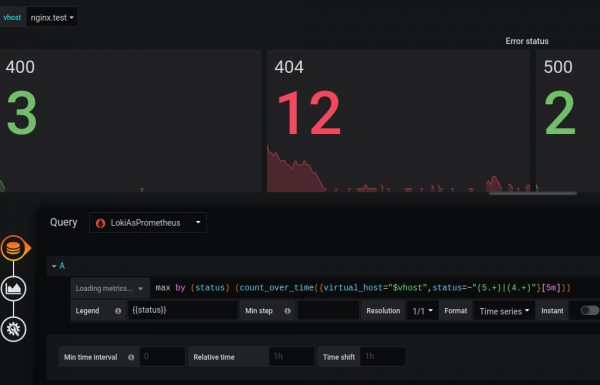
De standaardgegevensbron Loki heeft enkele beperkingen qua functionaliteit in vergelijking met de gegevensbron Prometheus (bijv. je kunt de legenda niet wijzigen), maar Loki kan als een gegevensbron van het type Prometheus worden aangesloten. Ik weet niet zeker of dit gedocumenteerd gedrag is, maar, gezien het antwoord van de ontwikkelaars “”, bijvoorbeeld, is dit heel goed mogelijk, en Loki is volledig compatibel met PromQL.
Voeg Loki toe als gegevensbron van het type Prometheus en voeg de URL /loki toe:

En je kunt diagrammen maken, alsof we met metrics uit Prometheus werkten:
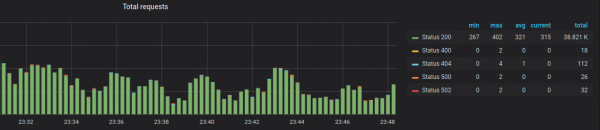
Ik denk dat de discrepantie in functionaliteit tijdelijk is en dat de ontwikkelaars dit in de toekomst zullen oplossen.
Statistieken
In Loki is het mogelijk om numerieke metrics uit logs te extraheren en deze naar Prometheus te sturen. Bijvoorbeeld, in de nginx-log staat het aantal bytes in de reactie, en met een bepaalde aanpassing van het standaard logformaat ook de tijd in seconden die nodig was voor de reactie. Deze gegevens kunnen worden geëxtraheerd en verzonden naar Prometheus.
Voeg nog een sectie toe aan promtail.yml:
- match:
   selector: '{request_type="api"}'
   stages:
     - metrics:
         http_nginx_response_time:
           type: Histogram
           description: "reactietijd ms"
           source: response_time
           config:
             buckets: [0.010,0.050,0.100,0.200,0.500,1.0]
- match:
   selector: '{request_type=~"static|photo"}'
   stages:
     - metrics:
         http_nginx_response_bytes_sum:
           type: Counter
           description: "totaal aantal bytes in reactie"
           source: bytes_out
           config:
             action: add
         http_nginx_response_bytes_count:
           type: Counter
           description: "aantal bytes in reactie"
           source: bytes_out
           config:
             action: inc
Deze optie maakt het mogelijk om metrics te definiëren en bij te werken op basis van gegevens uit de extracted map. Deze metrics worden niet naar Loki gestuurd — ze verschijnen in de Promtail /metrics endpoint. Prometheus moet zo worden geconfigureerd dat het gegevens ontvangt die in deze fase zijn verkregen. In het gegeven voorbeeld voor request_type="api" verzamelen we een histogram-metric. Met dit type metrics kunnen percentielen eenvoudig worden verkregen. Voor statische en foto’s verzamelen we de som van bytes en het aantal regels waarin we bytes hebben ontvangen, om de gemiddelde waarde te berekenen.
Lees meer over metrics .
Open de poort op Promtail:
promtail:
     image: grafana/promtail:1.4.1
     container_name: monitoring.promtail
     expose:
       - 9080
     ports:
       - "9080:9080"
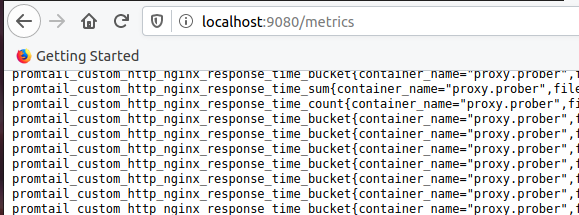
Zorg ervoor dat de metrics met de prefix promtail_custom zijn verschenen:
Configureer Prometheus. Voeg de job promtail toe:
- job_name: 'promtail'
 scrape_interval: 10s
 static_configs:
   - targets: ['promtail:9080']
En teken de grafiek:
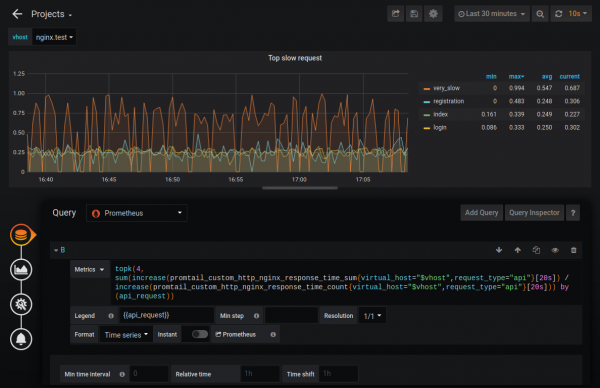
Zo kun je bijvoorbeeld de vier traagste verzoeken ontdekken. Ook kan monitoring voor deze metrics worden ingesteld.
Schaalbaarheid
Loki kan zowel in single binary mode als in sharded (horizontally-scalable mode) draaien. In het laatste geval kan het gegevens opslaan in de cloud, waarbij chunks en indexen apart worden opgeslagen. In versie 1.5 is de mogelijkheid van opslag op één plek geïmplementeerd, maar het wordt nog niet aanbevolen om deze in productie te gebruiken.
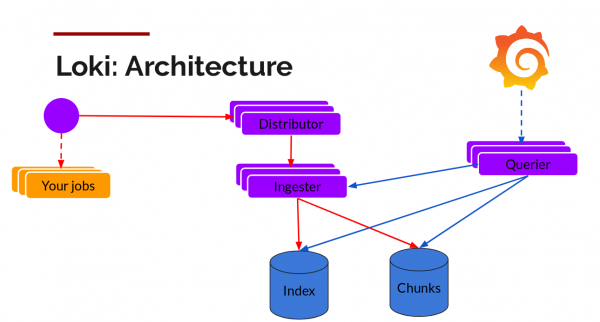
Chunks kunnen worden opgeslagen in een S3-compatibele opslag, voor het opslaan van indexen kunnen horizontaal schaalbare databases worden gebruikt: Cassandra, BigTable of DynamoDB. Andere delen van Loki — Distributors (voor schrijven) en Querier (voor aanvragen) — zijn stateless en kunnen ook horizontaal worden geschaald.
Tijdens de DevOpsDays Vancouver 2019 verklaarde een van de deelnemers, Callum Styan, dat zijn project met Loki petabytes aan logs heeft met een index kleiner dan 1% van de totale grootte: “”.
Vergelijking tussen Loki en ELK
Grootte van de index
Voor het testen van de verkregen grootte van de index heb ik logs van de nginx-container genomen, waarvoor de Pipeline werd ingesteld die hierboven is beschreven. Het logbestand bevatte 406.624 regels met een totale grootte van 109 MB. De logs werden gedurende een uur gegenereerd, ongeveer 100 records per seconde.
Voorbeeld van twee regels uit de log:
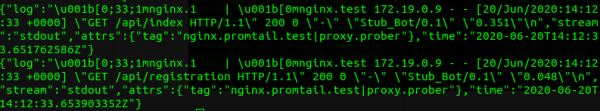
Bij het indexeren in ELK resulteerde dit in een indexgrootte van 30,3 MB:
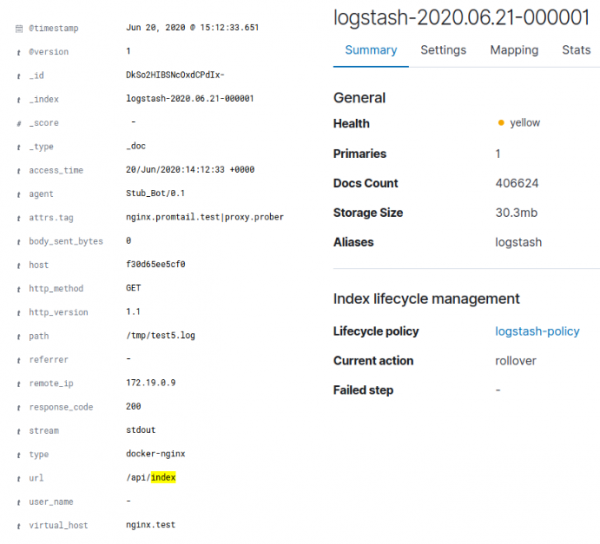
In het geval van Loki resulteerde dit in ongeveer 128 KB aan index en ongeveer 3,8 MB aan gegevens in chunks. Het is vermeldenswaardig dat de log kunstmatig was gegenereerd en niet veel variatie in gegevens vertoonde. Gewone gzip-compressie op de oorspronkelijke Docker JSON-log met gegevens gaf 95,4% compressie, en gezien het feit dat alleen de opgeschoonde nginx-log naar Loki werd gestuurd, is de compressie tot 4 MB begrijpelijk. Het totale aantal unieke waarden voor de labels in Loki was 35, wat de kleine grootte van de index verklaart. Voor ELK werd de log ook opgeschoond. Aldus compressie door Loki van de oorspronkelijke gegevens was 96%, terwijl ELK 70% compressie bereikte.
Geheugengebruik
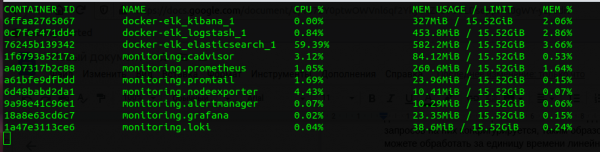
Als we de volledige stack van Prometheus en ELK vergelijken, verbruikt Loki 'veel' minder. Het is duidelijk dat een service geschreven in Go minder verbruikt dan een service in Java, en de vergelijking van de JVM Heap-grootte van Elasticsearch met het toegewezen geheugen voor Loki is onjuist, maar het is toch belangrijk om op te merken dat Loki aanzienlijk minder geheugen gebruikt. Het voordeel in CPU-gebruik is niet zo voor de hand liggend, maar bestaat ook.
Snelheid
Loki 'verorbert' logs sneller. De snelheid hangt van veel factoren af — wat voor soort logs, hoe geavanceerd we ze parseren, netwerk, schijf, enz. — maar is zeker hoger dan die van ELK (in mijn test was het ongeveer twee keer zo snel). Dit is te verklaren doordat Loki veel minder gegevens in de index plaatst en daardoor minder tijd besteedt aan indexeren. Bij de zoekprestaties is de situatie daarentegen omgekeerd: Loki gaat merkbaar trager bij gegevens van meer dan enkele gigabytes, terwijl de zoek snelheid van ELK niet afhankelijk is van de grootte van de gegevens.
Zoeken in logboeken
Loki is aanzienlijk minder capabel dan ELK als het gaat om zoekmogelijkheden binnen logs. Grep met reguliere expressies is een krachtige tool, maar het kan niet tippen aan een volwassen database. Het ontbreken van range-queries, aggregatie alleen op labels, en de onmogelijkheid om zonder labels te zoeken, beperkt ons in het vinden van de gewenste informatie in Loki. Dit betekent niet dat je met Loki niets kunt vinden, maar het bepaalt de flow van het werken met logs, waarbij je eerst een probleem op de grafieken van Prometheus localiseert en vervolgens op basis van deze labels zoekt wat er in de logs is gebeurd.
Interface
Ten eerste is het mooi (sorry, ik kon het niet laten). Grafana heeft een aantrekkelijke interface, maar Kibana is veel functioneler.
Voordelen en nadelen van Loki
Een van de voordelen is dat Loki integreert met Prometheus, wat betekent dat we metrics en alerting direct kunnen gebruiken. Het is handig voor het verzamelen en opslaan van logs van Kubernetes Pods, aangezien het geërfde service discovery van Prometheus heeft en automatisch labels toevoegt.
De nadelen zijn de zwakke documentatie. Sommige dingen, zoals de kenmerken en mogelijkheden van Promtail, ontdekte ik pas tijdens het bestuderen van de code, gelukkig is het open-source. Een ander nadeel zijn de beperkte parsingmogelijkheden. Bijvoorbeeld, Loki kan geen multiline-logs parseren. Daarnaast is het een relatief nieuwe technologie (de release 1.0 was in november 2019).
Conclusie
Loki is een 100% interessante technologie die geschikt is voor kleine en middelgrote projecten, waarbij het een scala aan taken voor logaggregatie, logsearch, monitoring en loganalyse mogelijk maakt.
We gebruiken Loki niet in Badoo, omdat we een ELK-stack hebben die ons bevalt en die in de loop der jaren is uitgebreid met verschillende op maat gemaakte oplossingen. Voor ons is logsearch een belangrijk punt. Met bijna 100 GB logs per dag is het voor ons cruciaal om alles en nog wat snel te kunnen vinden. Voor het maken van grafieken en monitoring gebruiken we andere oplossingen die zijn afgestemd op onze behoeften en met elkaar zijn geïntegreerd. De Loki-stack heeft duidelijke voordelen, maar het zal ons niet meer bieden dan we al hebben, en de voordelen zullen de migratiekosten zeker niet opwegen.
En hoewel het na onderzoek duidelijk werd dat we Loki niet kunnen gebruiken, hopen we dat deze post je helpt bij je keuze.
De repository met de code die in het artikel is gebruikt, bevindt zich .
Bron: habr.com
