

Hallo iedereen. Vrienden, we delen met jullie de vertaling van een artikel, speciaal voorbereid voor studenten van de cursus . Laten we beginnen!
Apache Beam en DataFlow voor real-time pijplijnen
De post van vandaag is gebaseerd op een taak waar ik recentelijk mee bezig ben geweest op het werk. Ik was erg blij om het te implementeren en het werk dat ik heb gedaan in de vorm van een blogpost te beschrijven, omdat dit me de kans gaf om me te verdiepen in data-engineering en ook iets te doen dat zeer nuttig zou zijn voor mijn team. Niet zo lang geleden ontdekte ik dat we in onze systemen een behoorlijk grote gebruikerslog hadden, gerelateerd aan een van onze producten voor gegevensverwerking. Het bleek dat niemand deze gegevens gebruikte, dus ik was meteen geïnteresseerd in wat we zouden kunnen leren als we ze regelmatig zouden analyseren. Er waren echter verschillende problemen op het pad. Het eerste probleem was dat de gegevens in veel verschillende tekstbestanden waren opgeslagen, die niet toegankelijk waren voor directe analyse. Het tweede probleem was dat ze waren opgeslagen in een gesloten systeem, waardoor ik geen van mijn favoriete analysetools kon gebruiken.
Ik moest beslissen hoe ik het voor ons gemakkelijker kon maken en enige waarde kon toevoegen door deze gegevensbron te integreren in enkele van onze gebruikersinteractie-oplossingen. Na er enige tijd over nagedacht te hebben, besloot ik een pijplijn te ontwerpen om deze gegevens naar een clouddatabase te versturen, zodat ik en het team toegang konden krijgen en we wat inzichten konden genereren. Nadat ik enige tijd geleden de specialisatie Data Engineering op Coursera had afgerond, was ik enthousiast om enkele tools uit de cursus in het project te gebruiken.
Dus het opslaan van gegevens in een cloud-database leek een verstandige oplossing voor mijn eerste probleem, maar wat kon ik doen met probleem nummer 2? Gelukkig was er een manier om deze gegevens over te zetten naar een omgeving waar ik toegang had tot tools zoals Python en Google Cloud Platform (GCP). Het was echter een langdurig proces, dus ik moest iets doen waardoor ik door kon gaan met ontwikkelen terwijl ik wachtte op de overdracht van de gegevens. De oplossing die ik bedacht was om nepgegevens te genereren met behulp van de bibliotheek Faker in Python. Ik had deze bibliotheek nog nooit eerder gebruikt, maar begreep al snel hoe nuttig deze is. Door deze benadering kon ik beginnen met coderen en de pijplijn testen zonder echte gegevens.
Gelet op het bovenstaande, zal ik in deze post uitleggen hoe ik de hierboven beschreven pijplijn heb opgebouwd met behulp van enkele van de technologieën die beschikbaar zijn in GCP. In het bijzonder zal ik gebruik maken van Apache Beam (de Python-versie), Dataflow, Pub/Sub en BigQuery om gebruikerslogboeken te verzamelen, gegevens te transformeren en deze naar de database te verzenden voor verdere analyse. In mijn geval had ik alleen de batchfunctionaliteit van Beam nodig, aangezien mijn gegevens niet in real-time binnenkwamen, dus Pub/Sub was niet nodig. Ik zal echter ook de streamingversie bespreken, aangezien dit iets is waar je in de praktijk mee te maken kunt krijgen.
Introductie tot GCP en Apache Beam
Google Cloud Platform biedt een reeks echt nuttige tools voor het verwerken van big data. Hier zijn enkele van de tools die ik zal gebruiken:
- is een berichtenservice die gebruikmaakt van het Publish-Subscribe patroon en ons in staat stelt om gegevens in real-time te ontvangen.
- is een service die het creëren van datapunten vereenvoudigt en automatisch taken zoals infrastructuurschaling oplost, wat betekent dat we ons alleen kunnen concentreren op het schrijven van code voor onze pijplijn.
- is een cloud-database. Als je bekend bent met andere SQL-databases, zul je niet veel moeite hebben met BigQuery.
- En tot slot gaan we Apache Beam gebruiken, met name focussen we op de Python-versie voor het creëren van onze pipeline. Deze tool stelt ons in staat om een pipeline voor streaming of batchverwerking te maken, die integreert met GCP. Het is bijzonder handig voor parallelle verwerking en geschikt voor taken zoals extractie, transformatie en laden (ETL), dus als we gegevens van de ene plaats naar de andere moeten verplaatsen met transformaties of berekeningen, is Beam een goede keuze.
Er is een grote verscheidenheid aan tools beschikbaar op GCP, dus het kan moeilijk zijn om ze allemaal bij te houden en wat hun doel is, maar hier is een samenvatting ter referentie.
Er zijn veel tools beschikbaar in GCP, dus het kan een uitdaging zijn om ze allemaal te dekken, inclusief hun doel, maar niettemin een korte samenvatting ter referentie.
Visualisatie van onze pipeline
Laten we de componenten van onze pipeline visualiseren op afbeelding 1. Op hoog niveau willen we realtime gebruikersgegevens verzamelen, deze verwerken en naar BigQuery verzenden. Logs worden aangemaakt wanneer gebruikers interactie hebben met het product, door verzoeken naar de server te sturen, die vervolgens worden gelogd. Deze gegevens kunnen bijzonder nuttig zijn om te begrijpen hoe gebruikers met ons product omgaan en of ze goed werken. Over het algemeen zal de pipeline de volgende stappen bevatten:
Beam maakt dit proces heel eenvoudig, ongeacht of we een streaming gegevensbron hebben of een CSV-bestand en we batchverwerking willen uitvoeren. Later zult u zien dat er in de code slechts minimale wijzigingen nodig zijn om tussen hen te schakelen. Dit is een van de voordelen van het gebruik van Beam.
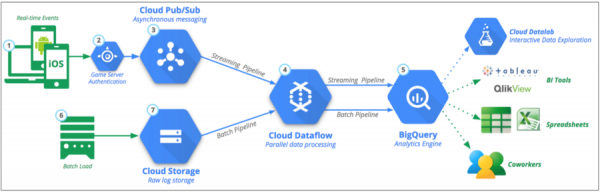
Afbeelding 1: Basis gegevenspipeline: Bron:
Pseudogegevens genereren met Faker
Zoals ik eerder al zei, besloot ik vanwege beperkte toegang tot gegevens om pseudogegevens te creëren in hetzelfde formaat als de werkelijke. Dit was een zeer nuttige oefening, omdat ik de code kon schrijven en de pipeline kon testen terwijl ik op de gegevens wachtte. Laten we eens kijken naar Faker, als je wilt weten wat deze bibliotheek nog meer te bieden heeft. Onze gebruikersgegevens zullen in grote lijnen vergelijkbaar zijn met het onderstaande voorbeeld. Op basis van dit formaat kunnen we gegevens regel voor regel genereren om realtime gegevens na te bootsen. Deze logs geven ons informatie zoals datum, type verzoek, antwoord van de server, IP-adres enzovoort.
192.52.197.161 - - [30/Apr/2019:21:11:42] "PUT /tag/category/tag HTTP/1.1" [401] 155 "https://harris-lopez.com/categories/about/" "Mozilla/5.0 (Macintosh; PPC Mac OS X 10_11_2) AppleWebKit/5312 (KHTML, like Gecko) Chrome/34.0.855.0 Safari/5312"
Gebaseerd op de bovenstaande regel willen we onze variabele maken LINE, met 7 variabelen in de onderstaande accolades. We zullen ze ook gebruiken als namen voor onze variabelen in ons tabelschema iets later.
LIJN = """
 {remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
 """
Als we batchverwerking uitvoerden, zou de code erg vergelijkbaar zijn, hoewel we een set voorbeelden in een bepaald tijdsbestek zouden moeten creëren. Om faker te gebruiken, creëren we eenvoudig een object en roepen we de benodigde methoden aan. In het bijzonder was Faker nuttig voor het genereren van IP-adressen en ook van websites. Ik heb de volgende methoden gebruikt:
fake.ipv4()
 fake.uri_path()
 fake.uri()
 fake.user_agent()
from faker import Faker
import time
import random
import os
import numpy as np
from datetime import datetime, timedelta


LINE = """
{remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
"""


def generate_log_line():
    fake = Faker()
    now = datetime.now()
    remote_addr = fake.ipv4()
    time_local = now.strftime('%d/%b/%Y:%H:%M:%S')
    request_type = random.choice(["GET", "POST", "PUT"])
    request_path = "/" + fake.uri_path()

    status = np.random.choice([200, 401, 404], p = [0.9, 0.05, 0.05])
    body_bytes_sent = random.choice(range(5, 1000, 1))
    http_referer = fake.uri()
    http_user_agent = fake.user_agent()

    log_line = LINE.format(
        remote_addr=remote_addr,
        time_local=time_local,
        request_type=request_type,
        request_path=request_path,
        status=status,
        body_bytes_sent=body_bytes_sent,
        http_referer=http_referer,
        http_user_agent=http_user_agent
    )

    return log_line
Einde van het eerste deel.
In de komende dagen delen we de vervolg van het artikel met je, en nu wachten we zoals gebruikelijk op reacties ;-).
Bron: habr.com
