

In de afgelopen ongeveer zes maanden heb ik me beziggehouden met het opzetten van een systeem voor fraudebestrijding (frauduleuze activiteit, fraude, enz.) zonder enige initiële infrastructuur hiervoor. De ideeën die we vandaag hebben gevonden en geïmplementeerd in ons systeem helpen ons om verschillende frauduleuze activiteiten te detecteren en te analyseren. In dit artikel wil ik de principes toelichten die we hebben gevolgd en wat we hebben gedaan om de huidige staat van ons systeem te bereiken, zonder in technische details te duiken.
Principes van ons systeem
Wanneer je termen zoals "automatic" en "fraud" hoort, begin je waarschijnlijk te denken aan machine learning, Apache Spark, Hadoop, Python, Airflow en andere technologieën binnen het Apache Foundation-ecosysteem en de Data Science-veld. Ik denk dat er één aspect van het gebruik van deze hulpmiddelen is dat doorgaans niet wordt genoemd: ze vereisen bepaalde voorwaarden in je bedrijfssystemen voordat je ze kunt gebruiken. Kortom, je hebt een bedrijfsdata-platform nodig dat een datameer en een data warehouse omvat. Maar wat als je zo'n platform niet hebt en je toch deze praktijk wilt ontwikkelen? De volgende principes waarover ik hieronder zal vertellen, hebben ons geholpen om op het punt te komen dat we ons kunnen richten op het verbeteren van onze ideeën in plaats van op het vinden van een werkende oplossing. Dit is echter geen "plateau" van het project. Er zijn nog veel dingen te doen vanuit technologisch en productperspectief.
Principe 1: waarde voor het bedrijf staat voorop
Bij al onze inspanningen hebben we "waarde voor het bedrijf" als prioriteit gesteld. Over het algemeen valt elk systeem voor automatische analyse onder de categorie complexe systemen met een hoog niveau van automatisering en technische complexiteit. Het creëren van een compleet systeem kost veel tijd als je het vanaf nul opbouwt. We hebben besloten om waarde voor het bedrijf op de eerste plaats te zetten en technologische completering op de tweede. In de praktijk betekent dit dat we geavanceerde technologieën niet als dogma accepteren. We kiezen de technologie die op dit moment het beste voor ons werkt. In de loop van de tijd kan het lijken alsof we sommige modules opnieuw moeten implementeren. Dit is een compromis dat we hebben geaccepteerd.
Principe 2: Versterkte intelligentie (augmented intelligence)
Ik wed dat de meeste mensen die niet diep betrokken zijn bij de ontwikkeling van machine learning-oplossingen, kunnen denken dat het vervangen van mensen het doel is. In werkelijkheid zijn machine learning-oplossingen verre van perfect en is vervanging alleen in bepaalde gebieden mogelijk. We hebben dit idee vanaf het begin afgewezen om verschillende redenen: onevenwichtige gegevens over fraude en de onmogelijkheid om een uitputtende lijst met functies voor machine learning-modellen te bieden. In plaats daarvan hebben we gekozen voor een optie met uitgebreide intelligentie. Dit is een alternatieve conceptie van kunstmatige intelligentie die zich richt op de ondersteunende rol van AI, en benadrukt dat cognitieve technologieën bedoeld zijn om menselijke intelligentie te verbeteren en niet te vervangen. [1]
Gezien dit feit zou de ontwikkeling van een volledige machine learning-oplossing vanaf het begin enorme inspanningen vereisen, wat de waardecreatie voor ons bedrijf zou vertragen. We hebben besloten om een systeem te bouwen met een iteratief groeiend aspect van machine learning onder leiding van onze domeinexperts. Het complexe deel van het ontwikkelen van zo'n systeem is dat het onze analisten casestudy's moet bieden, niet alleen vanuit het perspectief of het al dan niet fraude is. Over het algemeen is elke anomalie in het gedrag van klanten een verdachte zaak die door de specialisten moet worden onderzocht en waarop moet worden gereageerd. Slechts een klein deel van deze vastgelegde gevallen kan daadwerkelijk als fraude worden geclassificeerd.
Principe 3: platform voor uitgebreide data-analyse
Het moeilijkste onderdeel van ons systeem is de end-to-end workflowcontrole. Analisten en ontwikkelaars moeten eenvoudig datasets van vorige periodes kunnen ophalen met alle metrics die zijn gebruikt voor analyse. Bovendien moet het dataplatfrom een eenvoudige manier bieden om een bestaande metriekenset aan te vullen met nieuwe. De processen die we creëren, en dat zijn niet alleen softwareprocessen, moeten het gemakkelijk maken om eerdere periodes opnieuw te berekenen, nieuwe metrics toe te voegen en dataprognoses aan te passen. We zouden dit kunnen bereiken door alle data te verzamelen die ons productiesysteem genereert. In dat geval zouden de data geleidelijk een obstakel worden. We zouden een groeiende hoeveelheid data moeten opslaan die we niet gebruiken en deze beschermen. In dat scenario zouden de data na verloop van tijd steeds irrelevanter worden, maar nog steeds onze inspanningen vereisen om ze te beheren. Voor ons had dataverzameling (data hoarding) geen zin, en we besloten een andere benadering te gebruiken. We besloten om real-time datalakes te organiseren rondom de doelentiteiten die we willen classificeren en alleen die data op te slaan die het mogelijk maken om de meest recente en relevante periodes te verifiëren. De complexiteit van deze inspanningen ligt in het feit dat ons systeem heterogeen is met meerdere datalakes en softwaremodules die zorgvuldige planning vereisen voor coherente werking.
Constructieve concepten van ons systeem
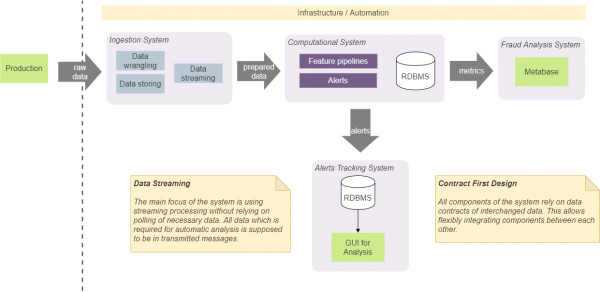
We hebben vier kerncomponenten in ons systeem: het ingestiesysteem (ingestion system), de rekenmodules (computational), de analyse (BI analysis) en het volgsysteem (tracking system). Ze dienen specifieke geïsoleerde doelen, en we houden ze gescheiden door bepaalde ontwikkelingsbenaderingen te volgen.
Contract-gebaseerd ontwerp
Allereerst hebben we afgesproken dat de componenten alleen op bepaalde datastructuren (contracten) moeten vertrouwen die tussen hen worden doorgegeven. Dit maakt het gemakkelijk om tussen hen te integreren en dwingt geen specifieke samenstelling (en volgorde) van componenten op. In sommige gevallen stelt dit ons bijvoorbeeld in staat om een ontvangstsysteem rechtstreeks te integreren met een waarschuwingvolgsysteem. In dat geval zal dit gebeuren overeenkomstig het afgesproken contract voor waarschuwingen. Dit betekent dat beide componenten geïntegreerd zullen worden met behulp van een contract dat door elke andere component kan worden gebruikt. We zullen geen extra contract toevoegen voor het toevoegen van waarschuwingen aan het volgsysteem vanuit het invoersysteem. Deze aanpak vereist het gebruik van een vooraf bepaald minimum aantal contracten en vereenvoudigt het systeem en de communicatie. In wezen gebruiken we een benadering die 'Contract First Design' wordt genoemd en passen we deze toe op de contracten voor datastreaming. [2]
Streaming overal
Het opslaan en beheren van de status in het systeem zal onvermijdelijk leiden tot complicaties in de implementatie ervan. In het algemeen moet de status toegankelijk zijn vanuit elk component, moet deze consistent zijn en de meest actuele waarde voor alle componenten bieden, en het moet betrouwbaar zijn met correcte waarden. Bovendien zal het hebben van oproepen naar permanente opslag om de laatste status te verkrijgen het aantal invoer-uitvoerbewerkingen en de complexiteit van de algoritmes die in onze real-time pipelines worden gebruikt, verhogen. Daarom hebben we besloten om de opslag van de status, waar mogelijk, volledig uit ons systeem te verwijderen. Deze aanpak vereist dat alle noodzakelijke gegevens in het verzonden datablok (bericht) worden opgenomen. Bijvoorbeeld, als we het totale aantal bepaalde waarnemingen (het aantal bewerkingen of gevallen met bepaalde kenmerken) moeten berekenen, berekenen we dit in het geheugen en genereren we een stroom van dergelijke waarden. Afhankelijke modules zullen partitioneren en batchen gebruiken om de stroom op entiteiten te splitsen en met de laatste waarden te werken. Deze aanpak heeft de noodzaak geëlimineerd om permanente schijfopslag voor dergelijke gegevens te hebben. Ons systeem gebruikt Kafka als berichtenbroker, en het kan worden gebruikt als database met KSQL. [3] Maar het gebruik ervan zou onze oplossing sterk aan Kafka hebben gekoppeld, en we hebben besloten dit niet te doen. De door ons gekozen aanpak stelt ons in staat om Kafka door een andere berichtenbroker te vervangen zonder significante interne veranderingen in het systeem.
Dit concept betekent niet dat we geen schijfopslag en databases gebruiken. Voor het testen en analyseren van de prestaties van het systeem is het noodzakelijk om een aanzienlijk deel van de gegevens op schijf op te slaan, die verschillende statistieken en staten vertegenwoordigen. Een belangrijk punt hier is dat real-time algoritmes niet afhankelijk zijn van dergelijke gegevens. In de meeste gevallen gebruiken we de opgeslagen gegevens voor autonome analyse, debugging en het volgen van specifieke gevallen en resultaten die het systeem produceert.
Problemen van ons systeem
Er zijn bepaalde problemen die we tot op zekere hoogte hebben opgelost, maar die meer doordachte oplossingen vereisen. Op dit moment wil ik ze gewoon hier vermelden, omdat elk punt een apart artikel waard is.
- We moeten nog steeds de processen en beleidslijnen bepalen die bijdragen aan het verzamelen van significante en relevante gegevens voor onze automatische analyse, detectie en onderzoek van gegevens.
- De integratie van menselijk geleide analyses in het proces van automatische systeemafstemming voor updates met de meest recente gegevens. Dit is niet alleen een update van ons model, maar ook een update van processen en een verbeterd begrip van onze gegevens.
- Een balans vinden tussen een deterministische aanpak IF-ELSE en ML. Iemand zei: "ML is een hulpmiddel voor de wanhopigen". Dit betekent dat je ML wilt gebruiken wanneer je niet meer begrijpt hoe je je algoritmen moet optimaliseren en verbeteren. Aan de andere kant staat de deterministische aanpak geen anomaliedetectie toe van gevallen die niet werden voorzien.
- We hebben een eenvoudige manier nodig om onze hypothesen of correlaties tussen metrics in de gegevens te testen.
- Het systeem moet verschillende niveaus van waar echte positieven (true positives) resultaten hebben. Frauduleuze gevallen zijn slechts een deel van alle gevallen die als positief voor het systeem kunnen worden beschouwd. Analisten willen bijvoorbeeld alle verdachte gevallen ontvangen voor controle, en slechts een klein deel daarvan is fraude. Het systeem moet analisten in staat stellen om alle gevallen effectief te bekijken, ongeacht of dit daadwerkelijke fraude of gewoon verdacht gedrag is.
- Het data platform moet het mogelijk maken om datasets van eerdere perioden te verkrijgen met berekeningen die on-the-fly zijn gemaakt en berekend.
- Eenvoudige en automatische uitrol van elk van de systeemcomponenten in ten minste drie verschillende omgevingen: productie, experimenteel (bèta) en voor ontwikkelaars.
- Tot slot, maar zeker niet het minst belangrijke. We moeten een uitgebreid platform voor prestatievalidatie creëren waarop we onze modellen kunnen analyseren. [4]
Links
Bron: habr.com
