

Af en toe is er de taak om gerelateerde gegevens te zoeken op basis van een set sleutels, totdat we het gewenste totaal aantal records hebben verzameld.
Het meest "levendige" voorbeeld is om de 20 oudste taken, die staan geregistreerd op de lijst van medewerkers (bijvoorbeeld binnen een enkele afdeling). Voor verschillende management "dashboards" met korte samenvattingen van werkgebieden is een dergelijk onderwerp vaak vereist.
In dit artikel bekijken we de implementatie op PostgreSQL van een "naïeve" variant van het oplossen van een dergelijke taak, een "slimmere" en een echt complexe algoritme "cyclus" op SQL met een stopvoorwaarde op basis van de gevonden gegevens, die nuttig kan zijn zowel voor algemene ontwikkeling als voor toepassing in andere soortgelijke gevallen.
Laten we een testdataset nemen uit . Om ervoor te zorgen dat de weergegeven records niet van keer tot keer "springen" bij overeenkomstige gesorteerde waarden, vergroten we de onderwerpindex door de primaire sleutel toe te voegen. Dit geeft het ook direct uniciteit en garandeert ons de eenduidigheid van de sorteervolgorde:
CREATE INDEX ON task(owner_id, task_date, id);
-- en we zullen de oude verwijderen
DROP INDEX task_owner_id_task_date_idx;
Zoals het zich laat horen, zo wordt het geschreven
Laten we eerst de eenvoudigste versie van de query schetsen, waarbij we de ID's van de uitvoerders doorgeven :
SELECT
  *
FROM
  task
WHERE
  owner_id = ANY('{1,2,4,8,16,32,64,128,256,512}'::integer[])
ORDER BY
  task_date, id
LIMIT 20; 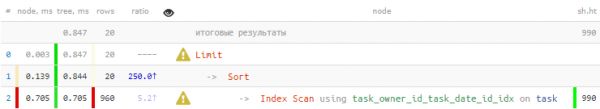
Een beetje treurig — we vroegen om slechts 20 records, maar de Index Scan bracht ons 960 rijen, die we vervolgens nog moesten sorteren… Laten we proberen minder te lezen.
unnest + ARRAY
De eerste overweging die ons zal helpen — als we maar 20 gesorteerde records nodig hebben, dan is het voldoende om te lezen niet meer dan 20 gesorteerde in dezelfde volgorde voor elke sleutel. Gelukkig hebben we de juiste index (owner_id, task_date, id).
We zullen hetzelfde extractiemechanisme en "omkering naar kolommen" gebruiken van de integrale record van de tabel, zoals in . We zullen ook de aggregatie naar een array toepassen met de functie ARRAY():
WITH T AS (
  SELECT
    unnest(ARRAY(
      SELECT
        t
      FROM
        task t
      WHERE
        owner_id = unnest
      ORDER BY
        task_date, id
      LIMIT 20 -- hier beperken we...
    )) r
  FROM
    unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[])
)
SELECT
  (r).*
FROM
  T
ORDER BY
  (r).task_date, (r).id
LIMIT 20; -- ... en hier ook - dat geldt ook 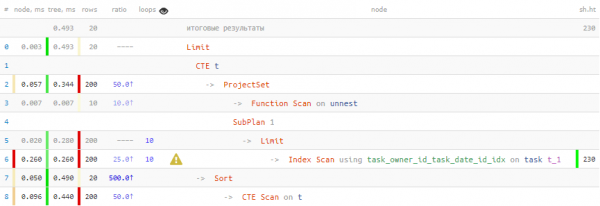
Oh, al veel beter! 40% sneller, en 4,5 keer minder gegevens hoefde we te lezen.
Materialisatie van tabelrecords via CTEIk wil erop wijzen dat in sommige gevallen Een poging om direct met de velden van de record te werken na het zoeken in de subquery, zonder het te 'omwikkelen' in een CTE, kan leiden tot de 'vermenigvuldiging' van InitPlan evenredig aan het aantal van die velden:
SELECT
  ((
    SELECT
      t
    FROM
      task t
    WHERE
      owner_id = 1
    ORDER BY
      task_date, id
    LIMIT 1
  ).*);
Resultaat (kosten=4.77..4.78 rijen=1 breedte=16) (werkelijke tijd=0.063..0.063 rijen=1 loops=1)
Buffers: gedeeld hit=16
InitPlan 1 (geeft $0 terug)
-> Limiet (kosten=0.42..1.19 rijen=1 breedte=48) (werkelijke tijd=0.031..0.032 rijen=1 loops=1)
Buffers: gedeeld hit=4
-> Index Scan met gebruik van task_owner_id_task_date_id_idx op task t (kosten=0.42..387.57 rijen=500 breedte=48) (werkelijke tijd=0.030..0.030 rijen=1 loops=1)
Index Conditie: (owner_id = 1)
Buffers: gedeeld hit=4
InitPlan 2 (geeft $1 terug)
-> Limiet (kosten=0.42..1.19 rijen=1 breedte=48) (werkelijke tijd=0.008..0.009 rijen=1 loops=1)
Buffers: gedeeld hit=4
-> Index Scan met gebruik van task_owner_id_task_date_id_idx op task t_1 (kosten=0.42..387.57 rijen=500 breedte=48) (werkelijke tijd=0.008..0.008 rijen=1 loops=1)
Index Conditie: (owner_id = 1)
Buffers: gedeeld hit=4
InitPlan 3 (geeft $2 terug)
-> Limiet (kosten=0.42..1.19 rijen=1 breedte=48) (werkelijke tijd=0.008..0.008 rijen=1 loops=1)
Buffers: gedeeld hit=4
-> Index Scan met gebruik van task_owner_id_task_date_id_idx op task t_2 (kosten=0.42..387.57 rijen=500 breedte=48) (werkelijke tijd=0.008..0.008 rijen=1 loops=1)
Index Conditie: (owner_id = 1)
Buffers: gedeeld hit=4"
InitPlan 4 (geeft $3 terug)
-> Limiet (kosten=0.42..1.19 rijen=1 breedte=48) (werkelijke tijd=0.009..0.009 rijen=1 loops=1)
Buffers: gedeeld hit=4
-> Index Scan met gebruik van task_owner_id_task_date_id_idx op task t_3 (kosten=0.42..387.57 rijen=500 breedte=48) (werkelijke tijd=0.009..0.009 rijen=1 loops=1)
Index Conditie: (owner_id = 1)
Buffers: gedeeld hit=4
Dezelfde record werd 4 keer 'gevonden'... Tot PostgreSQL 11 gebeurde dit regelmatig, en de oplossing is het 'omwikkelen' in een CTE, wat de onbetwistbare grens voor de optimizer in deze versies is.
Recursieve accumulator
In de vorige versie hebben we in totaal gelezen 200 rijen voor de benodigde 20. Niet meer 960, maar nog minder – kan dat?
Laten we proberen gebruik te maken van de kennis dat we slechts 20 records nodig hebben. Dat wil zeggen, we zullen de gegevens alleen tot het vereiste aantal ophalen.
Stap 1: startlijst
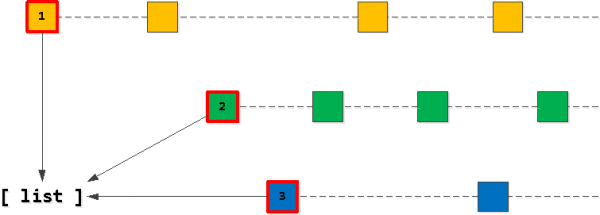
Het is duidelijk dat onze 'doel'-lijst van 20 records moet beginnen met de 'eerste' records van een van onze owner_id-sleutels. Dus laten we eerst de volgende vinden 'meest eerste' voor elke sleutel en deze aan de lijst toevoegen, gesorteerd in de volgorde die we willen — (task_date, id).
Stap 2: vinden van de 'volgende' records
Nu, als we de eerste record uit onze lijst nemen en verder gaan 'stappen' door de index met behoud van de owner_id-sleutel, dan zijn alle gevonden records precies de volgende in de resultaten. Natuurlijk, alleen maar totdat we de operationele sleutel kruisen tweede vermelding in de lijst.
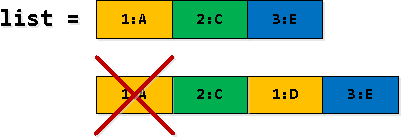
Als het zo is dat we de tweede vermelding "gekruist" hebben, dan moet de laatst gelezen vermelding aan de lijst worden toegevoegd in plaats van de eerste (met dezelfde owner_id), waarna de lijst opnieuw wordt gesorteerd.
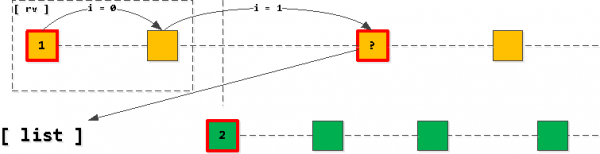
Dat betekent dat we altijd krijgen dat er in de lijst niet meer dan één vermelding per sleutel is (als de vermeldingen op zijn, en we hebben niet "gekruist", dan verdwijnt de eerste vermelding gewoon uit de lijst en wordt er niets toegevoegd), waarbij ze altijd gesorteerd zijn in oplopende volgorde van de operationele sleutel (task_date, id).
Stap 3: filteren en "uitvouwen" van vermeldingen
In een deel van de rijen van onze recursieve selectie worden sommige vermeldingen rv gedupliceerd — eerst vinden we die zoals "die de grens van de 2e vermelding in de lijst kruisen", en dan vervangen we ze als de 1e in de lijst. Dus het eerste voorkomen moet worden gefilterd.
Een verschrikkelijke uiteindelijke query
MET RECURSIVE T AS (
  -- #1 : voeg de "eerste" records per sleutel van de set toe
  WITH wrap AS ( -- "materialiseer" records, zodat toegang tot velden geen vermenigvuldiging van InitPlan/SubPlan veroorzaakt
    WITH T AS (
      SELECT
        (
          SELECT
            r
          FROM
            task r
          WHERE
            owner_id = unnest
          ORDER BY
            task_date, id
          LIMIT 1
        ) r
      FROM
        unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[])
    )
    SELECT
      array_agg(r ORDER BY (r).task_date, (r).id) list -- sorteert de lijst in de juiste volgorde
    FROM
      T
  )
  SELECT
    list
  , list[1] rv
  , FALSE not_cross
  , 0 size
  FROM
    wrap
UNION ALL
  -- #2 : lees records van de eerste sleutel totdat we over de record van de tweede sleutel heen gaan
  SELECT
    CASE
      -- als er niets is gevonden voor sleutel van het eerste record
      WHEN X._r IS NOT DISTINCT FROM NULL THEN
        T.list[2:] -- verwijder deze uit de lijst
      -- als we DE sleutel van het tweede record niet hebben gekruist
      WHEN X.not_cross THEN
        T.list -- sleep gewoon dezelfde lijst zonder wijzigingen
      -- als er in de lijst geen tweede record meer is
      WHEN T.list[2] IS NULL THEN
        -- geef gewoon een lege lijst terug
        '{}'
      -- hersorteer de lijst door het eerste record te verwijderen en het laatste gevonden toe te voegen
      ELSE (
        SELECT
          coalesce(T.list[2] || array_agg(r ORDER BY (r).task_date, (r).id), '{}')
        FROM
          unnest(T.list[3:] || X._r) r
      )
    END
  , X._r
  , X.not_cross
  , T.size + X.not_cross::integer
  FROM
    T
  , LATERAL(
      WITH wrap AS ( -- "materialiseer" record
        SELECT
          CASE
            -- als we toch "overgestapt" zijn naar het tweede record
            WHEN NOT T.not_cross
              -- dan is het benodigde record de eerste uit de lijst
              THEN T.list[1]
            ELSE ( -- als we niet zijn gekruist, is de sleutel zoals in het vorige record - we baseren ons daarop
              SELECT
                _r
              FROM
                task _r
              WHERE
                owner_id = (rv).owner_id AND
                (task_date, id) > ((rv).task_date, (rv).id)
              ORDER BY
                task_date, id
              LIMIT 1
            )
          END _r
      )
      SELECT
        _r
      , CASE
          -- als de tweede record al niet meer in de lijst staat, maar we nog iets hebben gevonden
          WHEN list[2] IS NULL AND _r IS DISTINCT FROM NULL THEN
            TRUE
          ELSE -- we hebben niets gevonden of "overgestapt"
            coalesce(((_r).task_date, (_r).id) < ((list[2]).task_date, (list[2]).id), FALSE)
        END not_cross
      FROM
        wrap
    ) X
  WHERE
    T.size < 20 AND -- beperkt hier het aantal
    T.list IS DISTINCT FROM '{}' -- of totdat de lijst op is
)
-- #3 : "ontvouw" records - volgorde is gegarandeerd op basis van constructie
SELECT
  (rv).*
FROM
  T
WHERE
not_cross; -- haal alleen "niet-kruisende" records op 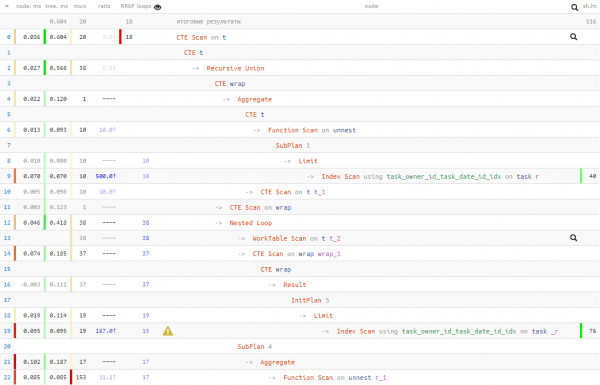
Dus, wij wisselden 50% van de gegevenslezen voor 20% computationele tijdMet andere woorden, als u redenen heeft om aan te nemen dat het lezen lang kan duren (bijvoorbeeld omdat gegevens vaak niet in de cache staan en er naar de schijf moet worden gegaan), dan kan dit een manier zijn om minder afhankelijk te zijn van het lezen.
In elk geval was de uitvoeringstijd beter dan in de 'naïeve' eerste versie. Maar welke van deze 3 opties u moet gebruiken, is aan u.
Bron: habr.com
