

Aankondiging
Collega's, halverwege de zomer ben ik van plan een nieuwe cyclus artikelen uit te brengen over het ontwerpen van systemen voor massale dienstverlening: “Experiment VTrade” — een poging om een framework voor handelsystemen te schrijven. In deze cyclus worden de theorie en praktijk van het bouwen van een beurs, veiling en winkel behandeld. Aan het einde van het artikel stel ik voor te stemmen op de onderwerpen die jullie het meest interessant vinden.
Dit is het laatste artikel van de cyclus over gedistribueerde reactieve toepassingen in Erlang/Elixir. In kan je de theoretische grondslagen van de reactieve architectuur vinden. illustreert de belangrijkste sjablonen en mechanismen voor het bouwen van dergelijke systemen.
Vandaag zullen we de vragen over de ontwikkeling van de codebasis en de projecten in het algemeen bespreken.
Organisatie van services
In de praktijk, bij het ontwikkelen van een service, moeten vaak meerdere interactiesjablonen in één controller worden samengevoegd. Bijvoorbeeld, de users-service, die verantwoordelijk is voor het beheer van de gebruikersprofielen van het project, moet reageren op req-resp verzoeken en updates van profielen bekendmaken via pub-sub. Dit geval is vrij eenvoudig: er is één controller verantwoordelijk voor messaging, die de logica van de service implementeert en updates publiceert.
De situatie wordt complexer wanneer we een failover-gedistribueerde service moeten implementeren. Stel je voor dat de eisen aan users zijn veranderd:
- nu moet de service verzoeken op 5 knooppunten van het cluster behandelen,
- in staat zijn om achtergrondtaken voor verwerking uit te voeren,
- en ook dynamisch de abonnementslijsten voor profielupdates beheren.
Opmerking: De kwestie van consistente opslag en replicatie van gegevens wordt niet behandeld. Laten we aannemen dat deze vragen eerder zijn opgelost en dat er al een betrouwbare en schaalbare opslaglaag in het systeem bestaat, en dat de handlers mechanismen hebben voor interactie daarmee.
De formele beschrijving van de users-service is complexer geworden. Vanuit het perspectief van de programmeur, door het gebruik van messaging, zijn de wijzigingen minimaal. Om aan de eerste eis te voldoen, moeten we de load balancing op het req-resp wisselpunt instellen.
De noodzaak om achtergrondtaken te verwerken komt vaak voor. In gebruikers kunnen dit documentcontroles, verwerking van geüploade media of synchronisatie van gegevens met sociale netwerken zijn. Deze taken moeten op de een of andere manier binnen het cluster worden verdeeld en de voortgang moet worden gecontroleerd. Daarom hebben we twee oplossingen: ofwel het gebruik van een taakverdelingssjabloon uit het vorige artikel, of, als dat niet geschikt is, het schrijven van een aangepaste taakplanner die op de benodigde manier het pool van verwerkers beheert.
Punt 3 vereist een uitbreiding van het pub-sub-sjabloon. En voor de uitvoering, na het creëren van een pub-sub-uitwisselingspunt, moeten we ook de controller van dit punt in ons dienst uitvoeren. Zo lijkt het alsof we de logica voor het abonneren en afmelden uit de messaging-laag halen naar de implementatie van gebruikers.
Uiteindelijk toonde de decompostion van de taak aan dat we om aan de vereisten te voldoen, 5 instanties van de dienst op verschillende knooppunten moeten starten en een extra entiteit moeten creëren - een pub-sub-controller die verantwoordelijk is voor de abonnementen.
Voor het starten van 5 verwerkers is het niet nodig om de code van de dienst te wijzigen. De enige extra stap is het instellen van de balanceringsregels op het uitwisselingspunt, waarover we later zullen praten.
Er kwam ook een extra complicatie: de pub-sub-controller en de aangepaste taakplanner moeten in een enkele instantie werken. Nogmaals, de messaging-service, als fundament, moet een mechanisme bieden voor het kiezen van een leider.
Kiezen van een leider
In gedistribueerde systemen is het kiezen van een leider een procedure voor het aanwijzen van één enkel proces dat verantwoordelijk is voor de planning van de gedistribueerde verwerking van een bepaalde belasting.
In systemen die niet geneigd zijn tot centralisatie, worden algemene algoritmen en consensus-gebaseerde algoritmen gebruikt, zoals Paxos of Raft.
Aangezien messaging de broker en het centrale element is, weet het van alle controllers van de service - kandidaten voor leiders. Messaging kan een leider aanwijzen zonder een stemming te houden.
Alle diensten ontvangen na de opstart en verbinding met het uitwisselingspunt een systeembericht #'$leader'{exchange = ?EXCHANGE, pid = LeaderPid, servers = Servers}. In geval dat LeaderPid overeenkomt met pid van het huidige proces, wordt hij aangewezen als leider, en de lijst Servers bevat alle knooppunten en hun parameters.
Bij de opkomst van een nieuwe en het uitschakelen van een werkende knooppunt in de cluster, ontvangen alle servicecontrollers #'$slave_up'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} en #'$slave_down'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} respectievelijk.
Zo weten alle componenten van alle wijzigingen, en is er te allen tijde gegarandeerd één leider in de cluster.
Intermediairs
Voor complexe gedistribueerde verwerkingsprocessen en bij het optimaliseren van bestaande architecturen is het handig om intermediairs te gebruiken.
Om de code van services niet te hoeven wijzigen en bijvoorbeeld extra verwerkings-, routerings- of logboekopdrachten uit te voeren, kan er een proxyverwerker voor de service worden ingeschakeld, die al het extra werk zal uitvoeren.
Een klassiek voorbeeld van pub-sub optimalisatie is een gedistribueerde applicatie met een bedrijfskern die gebeurtenissen genereert voor updates, zoals bijvoorbeeld een prijsverandering op de markt, en een toegangslayer — een aantal servers die een websocket API voor webklanten bieden.
Als we het 'frontaal' aanpakken, ziet het onderhoud van de klant er als volgt uit:
- de klant maakt verbinding met het platform. Aan de serverzijde, die het verkeer beëindigt, wordt een proces gestart dat deze verbinding onderhoudt.
- in de context van het onderhoudsproces vindt autorisatie en inschrijving voor updates plaats. Het proces roept de subscribe-methode voor de onderwerpen aan.
- na het genereren van een gebeurtenis in de kern, wordt deze afgeleverd aan de processen die de verbindingen onderhouden.
Stel je voor dat we 50.000 abonnees op het onderwerp "nieuws" hebben. De abonnees zijn gelijkmatig verdeeld over 5 servers. Elk update zal dus 50.000 keer worden gerepliceerd bij de ruilplaats: 10.000 keer op elke server, afhankelijk van het aantal abonnees daarop. Niet echt een efficiënte opzet, toch?
Om de situatie te verbeteren, introduceren we een proxy die dezelfde naam heeft als de ruilplaats. De globale naamregistrator moet in staat zijn om het dichtstbijzijnde proces op basis van de naam terug te geven; dit is belangrijk.
We starten deze proxy op de toegangservers en al onze processen die de websocket API onderhouden, zullen zich op deze proxy abonneren in plaats van op het oorspronkelijke pub-sub punt in de kern. De proxy abonneert zich alleen bij unieke inschrijvingen op de kern en repliceert het ontvangen bericht naar al zijn abonnees.
Uiteindelijk zullen er 5 berichten tussen de kern en de toegangservers worden verzonden in plaats van 50.000.
Routering en load balancing
Req-Resp
In de huidige implementatie van messaging zijn er 7 strategieën voor het verdelen van verzoeken:
default. Verzoeken worden naar alle controllers verzonden.ronddraaien. Het verzoek wordt doorgegeven en cyclisch verdeeld over de controllers.consensus. De controllers die de service bedienen, zijn verdeeld in een leider en volgers. Verzoeken worden alleen naar de leider gestuurd.consensus & round-robin. Er is een leider in de groep, maar verzoeken worden over alle leden verdeeld.sticky. Een hashfunctie wordt berekend en gekoppeld aan een specifieke handler. Vervolgverzoeken met deze handtekening komen bij dezelfde handler.sticky-fun. Bij de initialisatie van het wisselpunt wordt een functie voor het berekenen van de hash meegegeven voorstickybelastingspreiding.fun. Vergelijkbaar met sticky-fun, maar het is mogelijk om verder te doorsturen, af te wijzen of vooraf te verwerken.
De distributiestrategie wordt ingesteld bij de initialisatie van het wisselpunt.
Naast belastingspreiding stelt messaging in staat om entiteiten te taggen. Laten we de soorten tags in het systeem bekijken:
- Connectietag. Hiermee kan worden begrepen via welke verbinding gebeurtenissen zijn binnengekomen. Wordt gebruikt wanneer het controllerproces zich met verschillende routeringssleutels bij één wisselpunt aanmeldt.
- Servicetag. Hiermee kunnen handlers voor één service in groepen worden samengevoegd en de mogelijkheden voor routering en belastingspreiding worden uitgebreid. Voor het req-resp patroon is de routering lineair. We sturen een verzoek naar het wisselpunt, dat het vervolgens naar de service doorstuurt. Maar als we handlers in logische groepen willen splitsen, gebeurt dit met behulp van tags. Wanneer een tag is opgegeven, wordt het verzoek naar een specifieke groep controllers gestuurd.
- Verzoektag. Hiermee kunnen antwoorden worden onderscheiden. Aangezien ons systeem asynchroon is, moeten we bij het verzenden van een verzoek de mogelijkheid hebben om de RequestTag aan te geven voor het verwerken van de antwoorden van de service. Op basis daarvan kunnen we begrijpen op welk verzoek ons antwoord terugkomt.
Pub-sub
Voor pub-sub is het wat eenvoudiger. We hebben een wisselpunt waar berichten worden gepubliceerd. Het wisselpunt verdeelt berichten tussen de abonnees die zich hebben ingeschreven op de relevante routeringssleutels (je zou kunnen zeggen dat dit vergelijkbaar is met topics).
Schaalbaarheid en fouttolerantie
De schaalbaarheid van het systeem hangt in het algemeen af van de schaalbaarheid van de lagen en componenten van het systeem:
- Diensten kunnen worden opgeschaald door extra knooppunten met de handlers van deze dienst aan de cluster toe te voegen. Tijdens de operationele ervaring kan een optimale load balancing-strategie worden gekozen.
- De messaging service zelf wordt in het kader van een afzonderlijke cluster in het algemeen opgeschaald ofwel door zwaar belaste uitwisselingspunten naar afzonderlijke knooppunten van de cluster te verplaatsen, of door proxy-processen toe te voegen aan de zwaar belaste gebieden van de cluster.
- De schaalbaarheid van het hele systeem als kenmerk is afhankelijk van de flexibiliteit van de architectuur en de mogelijkheid om afzonderlijke clusters tot één logische entiteit te combineren.
Het succes van een project hangt vaak af van de eenvoud en snelheid van schaalvergroting. Messaging in de huidige uitvoering groeit mee met de applicatie. Zelfs als we 50-60 machines in de cluster missen, kunnen we federatie toepassen. Helaas valt het onderwerp federatie buiten de reikwijdte van dit artikel.
Redundantie
Bij het bespreken van load balancing hebben we al de reservatie van servicecontrollers behandeld. Echter, messaging moet ook worden gereserveerd. In geval van een knooppunt- of machine-uitval moet messaging automatisch worden hersteld, en dat in de kortst mogelijke tijd.
In mijn projecten gebruik ik extra knooppunten die de belasting overnemen in het geval van uitval. In Erlang is er een standaardimplementatie van de gedistribueerde modus voor OTP-applicaties. De gedistribueerde modus zorgt voor het herstel in geval van een storing door de crashe-aangevulde applicatie op een ander vooraf opgestart knooppunt te starten. Het proces is transparant, na een storing verhuist de applicatie automatisch naar het failover-knooppunt. Meer informatie over deze functionaliteit kan gevonden worden. .
Prestaties
Laten we proberen de prestaties van rabbitmq en onze aangepaste messaging ongeveer te vergelijken.
Ik heb gevonden van rabbitmq-testen door het openstack-team.
In sectie 6.14.1.2.1.2.2 van het originele document is het resultaat van RPC CAST gepresenteerd:
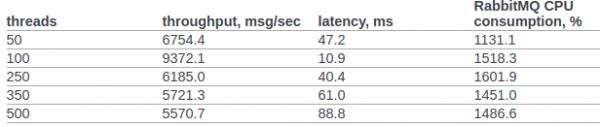
Voorlopig zullen we geen aanvullende instellingen aan de kernel van het besturingssysteem of de Erlang VM aanbrengen. Testvoorwaarden:
- erl opts: +A1 +sbtu.
- De test binnen één Erlang-knooppunt wordt uitgevoerd op een laptop met een oude i7 in mobiele uitvoering.
- De cluster tests worden uitgevoerd op servers met 10G netwerk.
- De code draait in Docker-containers. Netwerk in NAT-modus.
Testcode:
req_resp_bench(_) ->
  W = perftest:comprehensive(10000,
    fun() ->
      messaging:request(?EXCHANGE, default, ping, self()),
      receive
        #'$msg'{message = pong} -> ok
      after 5000 ->
        throw(timeout)
      end
    end
  ),
  true = lists:any(fun(E) -> E >= 30000 end, W),
  ok.
Scenario 1: De test wordt uitgevoerd op een laptop met een oudere i7 mobiele uitvoering. De test, messaging en service worden uitgevoerd op dezelfde node in één docker-container:
Sequentieel 10000 cycli in ~0 seconden (26987 cycli/s)
Sequentieel 20000 cycli in ~1 seconden (26915 cycli/s)
Sequentieel 100000 cycli in ~4 seconden (26957 cycli/s)
Parallel 2 100000 cycli in ~2 seconden (44240 cycli/s)
Parallel 4 100000 cycli in ~2 seconden (53459 cycli/s)
Parallel 10 100000 cycli in ~2 seconden (52283 cycli/s)
Parallel 100 100000 cycli in ~3 seconden (49317 cycli/s)
Scenario 2: 3 nodes draaiend op verschillende machines onder docker (NAT).
Sequentieel 10000 cycli in ~1 seconden (8684 cycli/s)
Sequentieel 20000 cycli in ~2 seconden (8424 cycli/s)
Sequentieel 100000 cycli in ~12 seconden (8655 cycli/s)
Parallel 2 100000 cycli in ~7 seconden (15160 cycli/s)
Parallel 4 100000 cycli in ~5 seconden (19133 cycli/s)
Parallel 10 100000 cycli in ~4 seconden (24399 cycli/s)
Parallel 100 100000 cycli in ~3 seconden (34517 cycli/s)
In alle gevallen overschreed de CPU-utilisatie niet 250%
Conclusies
Ik hoop dat deze cyclus niet overkomt als een dump van mijn gedachten en dat mijn ervaring een echte bijdrage zal leveren aan zowel onderzoekers van gedistribueerde systemen als aan praktijkmensen die aan het begin staan van het bouwen van gedistribueerde architecturen voor hun zakelijke systemen en geïnteresseerd kijken naar Erlang/Elixir, maar twijfelen of het de moeite waard is...
Foto
Alleen geregistreerde gebruikers kunnen deelnemen aan de enquête. , alstublieft.
Welke onderwerpen zou ik het meest gedetailleerd moeten belichten in de cyclus "Experiment VTrade"?
Theorie: Markten, orders en hun geldigheid: DAY, GTD, GTC, IOC, FOK, MOO, MOC, LOO, LOC
Orderboek. Theorie en praktijk van de implementatie van het boek met groeperingen.
Visualisatie van handel: ticks, bars, resoluties. Hoe op te slaan en hoe te plakken.
Backoffice. Planning en ontwikkeling. Controle van personeel en onderzoek naar incidenten.
API. We kijken naar welke interfaces nodig zijn en hoe deze te implementeren.
Opslag van informatie: PostgreSQL, Timescale, Tarantool in handelssystemen.
Reactiviteit in handelssystemen.
Overige. Ik zal het in de opmerkingen schrijven.
Er hebben 6 gebruikers gestemd. 4 gebruikers hebben zich onthouden.
Bron: habr.com
