

Voorwoord van de vertaler
Het materiaal interesseerde me vooral vanwege de onderstaande tabel:
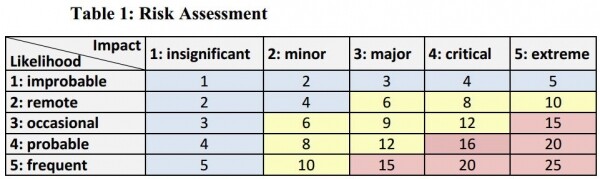
Gezien het feit dat statistici (en Russische, op genetisch niveau) alles wat afwijkt van lineaire afhankelijkheid, zachtjes gezegd, niet leuk vinden, is het deze jongens gelukt om het gebruik van activatiefuncties in parabolische vorm door te drukken voor het bepalen van het risico van het gebruik van BigData in officiële statistieken. Goed gedaan. Uiteraard hebben de statistici hun opmerking aan dit onderzoek toegevoegd: "1 Eventuele fouten en tekortkomingen zijn de exclusieve verantwoordelijkheid van de auteurs. De meningen die in dit document worden weergegeven, zijn persoonlijk en weerspiegelen niet noodzakelijk de officiële positie van de Europese Commissie." Maar het werk is gepubliceerd. Ik denk dat dit vandaag voldoende is, en ze (de auteurs) hebben niemand verboden om hun schalen in deze aspecten te vinden.
In het werk is het duidelijk gestructureerd waar en op welke manier statistische methoden verschillen van onderzoeksmethoden voor BigData. Naar mijn mening is het grootste voordeel van dit onderzoek dat het gesprek met de opdrachtgever kan vergemakkelijken en het kan helpen om zijn uitspraken te weerleggen, zoals:
— Maar wij verzamelen zelf de statistieken, wat wilt u nog onderzoeken?
— Geef ons uw resultaten op zo'n manier dat we deze met onze statistieken kunnen vergelijken. In deze kwestie stellen de auteurs voor om dit onderzoek te lezen (3 )
In dit onderzoek hebben de auteurs hun visie op het risiconiveau aangegeven. Deze parameter staat tussen haakjes, niet te verwarren met de bronvermeldingen.
Tweede observatie. De auteurs gebruiken de term BDS – dit is een gelijkwaardig begrip voor BigData. (waarschijnlijk een buiging naar de officiële statistiek).
Voorwoord van de auteurs
Steeds meer statistische bureaus onderzoeken de mogelijkheid om grote gegevensbronnen te gebruiken voor het opstellen van officiële statistieken. Momenteel zijn er slechts enkele voorbeelden waarbij deze bronnen volledig zijn geïntegreerd in het daadwerkelijke statistische productieproces. Daarom is de volledige impact van hun integratie nog niet vastgesteld. Ondertussen zijn er de eerste pogingen ondernomen om de voorwaarden en de invloed van big data op verschillende aspecten van statistische producten, zoals kwaliteit of methodologie, te analyseren. Onlangs heeft een werkgroep een kwaliteitsbasis ontwikkeld voor de voorbereiding van statistische gegevens op basis van big data in het kader van het big data-project van de Economische Commissie voor Europa van de Verenigde Naties (ECE-UN). Volgens de Europese statistische praktijkcode is het verstrekken van hoogwaardige statistische informatie de belangrijkste taak van statistische bureaus. Aangezien risico wordt gedefinieerd als de impact van onzekerheid op doelstellingen (bijvoorbeeld door de internationale organisatie voor standaardisatie ISO 31000), hebben we het nuttig geacht om risico's te categoriseren op basis van de kwaliteitsdimensies waarop ze van invloed zijn.
De voorgestelde kwaliteitsstructuur voor statistische gegevens verkregen uit grote gegevensbronnen biedt een gestructureerde weergave van de kwaliteit die verband houdt met alle fasen van het statistische bedrijfsproces en kan dus dienen als basis voor een uitgebreide beoordeling en risicobeheer met betrekking tot deze nieuwe gegevensbronnen. Het introduceert nieuwe kwaliteitsdimensies die specifiek zijn voor het gebruik van big data voor officiële statistieken, zoals de institutionele/zakelijke omgeving of complexiteit. Door deze nieuwe kwaliteitsdimensies te gebruiken, kunnen risico's die verband houden met het gebruik van grote gegevensbronnen in officiële statistieken systematischer worden geïdentificeerd.
In dit werk streven we ernaar de risico's te identificeren die gepaard gaan met het gebruik van big data in de context van officiële statistieken. We hanteren een systematische benadering voor het definiëren van risico's in het kader van de voorgestelde kwaliteitsstructuur. Door ons te concentreren op de nieuw voorgestelde kwaliteitsmetingen, kunnen we risico's beschrijven die momenteel afwezig zijn of geen invloed hebben op de productie van officiële statistieken. Tegelijkertijd kunnen we de huidige risico's identificeren die volledig anders beoordeeld zullen worden bij het gebruik van big data voor statistische doeleinden. Vervolgens gaan we verder in de risicobeheercyclus en bieden we een beoordeling van de waarschijnlijkheid en impact van deze risico's. Aangezien risicobeoordeling subjectiviteit in hun toewijzing met zich meebrengt, meten we de overeenkomst tussen tientallen verschillende belanghebbenden, die onafhankelijk zijn verstrekt. Vervolgens bieden we opties voor het verminderen van deze risico's aan volgens vier hoofdcategorieën: vermijden, verminderen, delen en behouden. Volgens ISO moet een van de principes van risicobeheer waardecreatie zijn, dat wil zeggen dat de middelen voor het verminderen van risico's lager moeten zijn dan die voor inactie. In overeenstemming met dit principe zullen we uiteindelijk de mogelijke invloed van enkele risicobeperkende maatregelen op de kwaliteit van de uiteindelijke resultaten beoordelen, zodat we tot een meer omvattende beoordeling van het gebruik van big data voor officiële statistieken kunnen komen.
1. Inleiding
1.1. Achtergrond
De ontwikkeling van 'big data' werd beschreven door Kenneth Neil Cukier en Viktor Mayer-Schönberger in hun artikel 'De opkomst van big data' (2. ) aangeduid met de term 'dataficatie'. Dataficatie wordt beschreven als het proces van 'alle aspecten van het leven omzetten in gegevens'. Bijvoorbeeld, Facebook biedt persoonlijke netwerken, sensoren voor allerlei omgevingscondities, smartphones voor persoonlijke communicatie en verplaatsingen, en draagbare gegevens voor persoonlijke omstandigheden. Dit leidt tot bijna alomtegenwoordige verzameling en beschikbaarheid van gegevens.
Zoals in veel andere sectoren, is de officiële statistiek pas recentelijk begonnen met het bespreken van het probleem van big data op strategisch niveau. Er is nog geen algemene en breed gedragen consensus over de weg vooruit, of het nu een uitdaging of een kans is, of deze groot of klein is, enzovoort. In het kader van de Hoge Groep voor de Modernisering van Statistische Productie en Diensten (3 Hoe groot is Big Data? De rol van Big Data in Officiële Statistieken: ), is de eerste SWOT-analyse, vergezeld van een ruwe risico-/voordeelanalyse, uitgevoerd. Er werd opgemerkt dat 'een volledige risico-analyse ook aspecten zoals waarschijnlijkheid en impact zal omvatten en mogelijk ook zal worden uitgebreid om strategieën voor risicobeperking en -beheer te definiëren'.
Hoewel dit document nog ver verwijderd is van een volledige risicoanalyse, is het gericht op het verbeteren van de situatie door het creëren van het eerste gestructureerde overzicht. We willen benadrukken dat dit overzicht moet worden gezien als een startpunt voor het stimuleren van een algemene discussie binnen de Officiële Statistische Gemeenschap (OSC).
1.2. Omvang
Dit artikel richt zich uitsluitend op risico's, waarbij niet alleen voordelen, maar ook sterke en zwakke punten, kansen en bedreigingen worden uitgesloten. Dit betekent dat 'risico's van inactiviteit' (bijvoorbeeld het risico dat de OSC niet concurrerend is met andere spelers als deze niet wordt gemoderniseerd), niet binnen de reikwijdte vallen; dit zijn eerder bedreigingen. In plaats daarvan proberen we risico's te benadrukken die kunnen ontstaan (a) als de OSC de kansen benut die big data biedt en begint met de ontwikkeling of verbetering van een specifiek 'product van officiële statistiek op basis van big data' (BOSP); (b) risico's voor het nieuwe 'normale bedrijfsleven', dat wil zeggen risico's voor officiële statistiek gebaseerd op de productie van 'big data'. (Aangezien alle productie van officiële statistiek met risico's is verbonden, beperken we ons tot (b) specifiek voor 'big data risico's', d.w.z. risico's die niet bestaan of onbelangrijk zijn voor het 'traditionele' proces van het verzamelen van officiële statistiek.)
1.3. Structuur
In sectie 2 presenteren we de basisprincipes die verband houden met deze taak, te beginnen met de duidelijk noodzakelijke basis voor risicobeheer en risk management (sectie 2.1). We introduceren ook een voorlopige kwaliteitsstructuur voor statistische gegevens, verkregen op basis van big data (sectie 2.2), aangezien het koppelen van de kwaliteitsstructuur aan risico's twee doelen dient:
- Het stelt de context vast voor het definiëren van risico's. Bepaalde kwaliteitsindicatoren samen met de besproken kenmerken drukken de waarden van het object uit die als belangrijk en beslissend worden beschouwd voor het leveren van diensten aan klanten en gebruikers.
- Dit maakt het mogelijk om specifieke risico's toe te wijzen aan kwaliteitsmetingen, die zijn ingebed in algemene hyperruimten en zijn gekoppeld aan bepaalde fasen in het proces van het produceren van statistische producten.
In secties 3, 4, 5 en 6 presenteren we de risico's die tot nu toe zijn geïdentificeerd in verschillende contexten (4 De businesscase-documenten van het ESS (https://www.europeansocialsurvey.org/about/structure_and_governance.html) Big Data-project, evenals in de Big Data ESSnets, bevatten een lijst van risico's die gedeeltelijk verband houden met het project en gedeeltelijk met het gebruik van big data-bronnen voor statistische doeleinden. Het document 'Een voorgestelde structuur voor de kwaliteit van big data' noemt enkele risico's die verband houden met kwaliteitsdimensies. / De businesscase-documenten van het ESS Big Data-project en de ESS Big Data-netwerken bevatten een lijst van risico's die gedeeltelijk gerelateerd zijn aan het project en gedeeltelijk aan het gebruik van bronnen van big data voor statistische doeleinden. In het document 'Een voorgestelde structuur voor de kwaliteit van big data' worden enkele risico's genoemd die verband houden met kwaliteitsindicatoren.). Hier gebruiken we de classificatie van gegevensaccess, de juridische omgeving, de privacy en de gegevensbeveiliging, evenals vaardigheden; reorganisatie volgens de kwaliteitsstructuur van statistieken, verkregen uit big data (sectie 2.2), moet onmiddellijk worden overwogen zodra deze structuur een meer afgerond statuut heeft bereikt. Voor elk van de geïdentificeerde risico's bieden we (i) een beoordeling van de waarschijnlijkheid en impact (volgens sectie 2.1.3), en (ii) stellen we risicomitigatiestrategieën en -beheer voor (zie sectie 2.1.4).
Aan het einde bespreken we onze conclusies en schetsen we enkele vervolgstappen in Sectie 7.
2. Grondslagen
2.1. Risico's en risicobeheer
Volgens ISO 31000: 20095 wordt risico gedefinieerd als "de impact van onzekerheid op de gestelde doelen". Dit betekent dat de doelen gedefinieerd of bekend moeten zijn voordat risico's kunnen worden vastgesteld. Deze doelen worden meestal bepaald in de context van de betreffende organisatie. Een ander belangrijk punt is dat risico's inherent zijn aan onzekerheid, dat wil zeggen dat het niet duidelijk is of het beschreven evenement zal plaatsvinden. Risico's worden dus gemeten in termen van de waarschijnlijkheid van het optreden van het evenement en de gevolgen ervan, dat wil zeggen de impact die dit evenement heeft op het bereiken van de gestelde doelen. Risicobeoordeling moet objectieve informatie bieden die uiteindelijk een juiste balans mogelijk maakt tussen het realiseren van winstgevende kansen en het minimaliseren van nadelige gevolgen. Risicomanagement is een integraal onderdeel van de managementpraktijk en een belangrijk aspect van goed ondernemerschap (6 Statistics Canada: 2014-2015 report on Plans and Priorities, ). Het is een iteratief proces dat idealiter continu verbetert en bijdraagt aan de voortdurende verbetering van de prestaties.
Risico's zijn ook gerelateerd aan kwaliteit. Toepassing van een kwaliteitsysteem zou in staat moeten stellen om de kansen die verschillende bronnen en methodologieën bieden te benutten, om een resultaat van een bepaald kwaliteitsniveau te bereiken in die zin dat dit resultaat voldoet aan de behoeften van de gebruikers. Net als risico's kunnen kwaliteitsniveaus voortkomen uit de institutionele omgeving en de doelen van bepaalde instellingen. In deze context bepaalt de institutionele omgeving het algemene risiconiveau dat de organisatie bereid is te accepteren om haar doelen te bereiken.
Het proces van risico-evaluatie en -beheer kan worden opgedeeld in verschillende fasen, waaronder het vaststellen van de context, het identificeren van risico's, het analyseren van risico's in termen van waarschijnlijkheid en impact, het beoordelen van risico's en ten slotte het behandelen van risico's.
2.1.1. Institutionele context
Als eerste stap is het noodzakelijk om de strategische, organisatorische context en het risicobeheercontext vast te stellen, waarin de rest van het proces zal plaatsvinden. Dit omvat het opstellen van criteria waartegen de risico's zullen worden geëvalueerd en het bepalen van de analystructuur.
2.1.2. Risico-identificatie
In de tweede stap moeten gebeurtenissen worden geïdentificeerd die invloed kunnen hebben op het bereiken van de gestelde doelen. De identificatie moet vragen omvatten met betrekking tot het type risico's, het tijdsbestek van de gebeurtenis, de locatie of hoe gebeurtenissen het behalen van doelstellingen kunnen voorkomen, verergeren, vertragen of verbeteren.
2.1.3. Risicobeoordeling
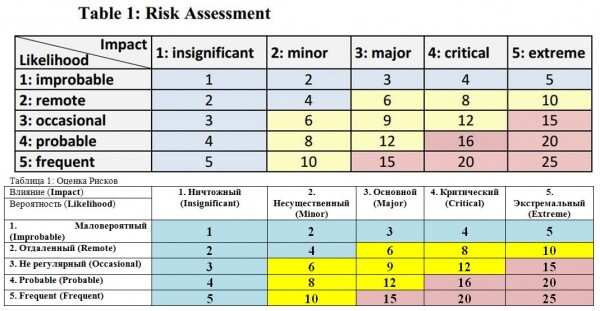
De volgende stap bestaat uit het identificeren van bestaande controlemechanismen en het analyseren van risico's vanuit het perspectief van waarschijnlijkheid, evenals vanuit het perspectief van de potentiële gevolgen. In de context van dit artikel wordt de waarschijnlijkheid of kans op het optreden van risico's gemeten op een schaal van 1 (onwaarschijnlijk) tot 5 (vaak). De impact van gebeurtenissen wordt gemeten op een schaal van 1 (onbeduidend) tot 5 (extreem). Zoals weergegeven in tabel 1, geeft het product van waarschijnlijkheid en impact het 'risiconiveau' aan, dat varieert van 1 tot 25.
De geanalyseerde risiconiveaus kunnen worden vergeleken met vooraf gedefinieerde criteria om een evenwicht te vinden tussen potentiële voordelen en ongunstige uitkomsten. Dit stelt ons in staat om oordelen te vellen over prioriteiten in het beheer.
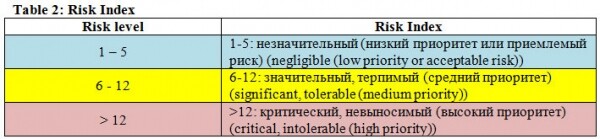
Prioriteit voor actie moet worden gegeven aan kritieke risico's (zie tabel 2), dat wil zeggen de risico's die zich kunnen voordoen en ernstige of extreme gevolgen hebben voor de doelstellingen van de organisatie.
2.1.4. Reactie op risico's
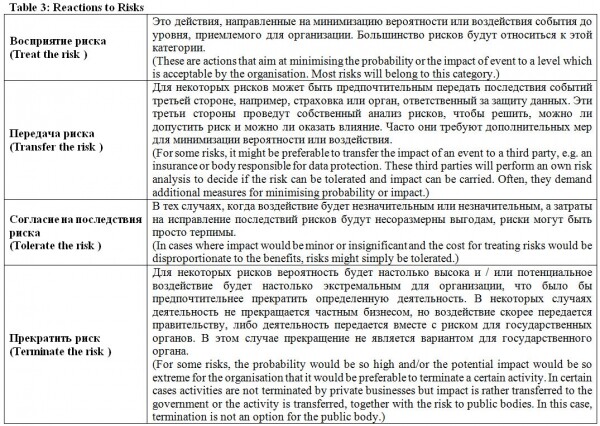
De laatste stap bestaat uit beslissingen over hoe te reageren op risico's. Sommige risico's die onder een vooraf bepaald risiconiveau liggen, kunnen worden genegeerd of geaccepteerd. Voor andere risico's kunnen de kosten om deze te neutraliseren zo hoog zijn dat ze de potentiële voordelen overschrijden. In dat geval kan de organisatie besluiten om de betreffende activiteit te staken. Risico's kunnen ook worden overgedragen aan derden, zoals verzekeringen die de gemaakte kosten compenseren. De laatste optie is om risico's mee te nemen bij het bepalen van strategieën en acties die de kosten in evenwicht brengen met de potentiële voordelen. Zo neemt de organisatie een beslissing over het implementeren van strategieën om de voordelen te maximaliseren en de potentiële kosten te minimaliseren.
2.2. Kwaliteitssystemen
Een doelgroep, bestaande uit vertegenwoordigers van nationale en internationale statistische organisaties, heeft in 2014 een voorlopig kwaliteitsraamwerk ontwikkeld voor statistieken verkregen uit big data. De doelgroep werkte onder de vlag van het UNECE/HLG-project ‘De rol van big data in de modernisering van de statistische productie’. Het heeft bestaande kwaliteitssystemen uitgebreid, die zijn ontwikkeld voor de evaluatie van statistieken verkregen uit administratieve gegevensbronnen, met kwaliteitsindicatoren die als relevant werden beschouwd voor grote gegevensbronnen.
Binnen dit systeem wordt een onderscheid gemaakt tussen drie fasen van het bedrijfsproces: invoer, productiviteit en uitvoer. De invoerfase komt overeen met de fasen 'ontwerp' en 'verzameling' van GSBP, productiviteit met de fasen 'proces' en 'analyse', terwijl de uitvoer overeenkomt met de fase 'verspreiding'.
In de structuur wordt een hiërarchische opbouw toegepast die is afgeleid van de structuur van administratieve gegevens, ontwikkeld door het Centraal Bureau voor de Statistiek van Nederland (7 Daas, P., S. Ossen, R. Vis-Visschers, en J. Arends-Toth, (2009), Checklist voor de Kwaliteitsbeoordeling van Administratieve Gegevensbronnen. Statistics Netherlands, Den Haag/Heerlen). Kwaliteitsdimensies zijn ingebed in een hiërarchische structuur die hyperruimtes wordt genoemd. De drie specifieke hyperdimensies zijn ‘bron’, ‘metadata’ en ‘gegevens’. Kwaliteitsdimensies worden in deze hyperdimensies ingebed en aan elke fase van productie toegewezen. Voor de invoerfase zijn aanvullende aspecten voorgesteld zoals ‘privacy en vertrouwelijkheid’, ‘complexiteit’ (volgens de datastructuur), ‘volledigheid’ van metadata en ‘connectiviteit’ (de mogelijkheid om gegevens met andere gegevens te koppelen), om toe te voegen aan het model voor standaardkwaliteit. Voor elk van de kwaliteitsindicatoren worden factoren aangeboden die gerelateerd zijn aan hun beschrijving, evenals mogelijke indicatoren.
In de context van dit artikel kunnen risico's van deze factoren worden uitgesloten. Bijvoorbeeld, factoren die in overweging moeten worden genomen voor het meten van de kwaliteit van de ‘institutionele / zakelijke omgeving’ zijn de duurzaamheid van de gegevensleverancier. Het bijbehorende risico kan zijn dat de gegevens in de toekomst niet beschikbaar zijn bij de gegevensleverancier. Een ander voorbeeld heeft betrekking op de recent voorgestelde kwaliteitsaspecten, privacy en veiligheid. Een van de belangrijke factoren is ‘perceptie’, wat betekent mogelijke negatieve perceptie van het vermeende gebruik van specifieke gegevensbronnen door verschillende belanghebbenden.
3. Risico's verbonden aan gegevensaccess.
3.1. Onbeschikbaarheid van toegang tot gegevens.
3.1.1. Beschrijving.
Dit risico bestaat uit een project dat verband houdt met het ontwikkelen van BOSP, en niet toegang krijgt tot de benodigde bron van big data (BDS).
Tot nu toe heeft de OSC de moeilijke weg geleerd dat zelfs het uit de startblokken komen en toegang verkrijgen soms een onoverkomelijke hindernis vormt. Soms is het gemakkelijk om toegang te krijgen tot een bepaalde bron – zoals gegevens over oproepregistraties (CDR), voor test-/onderzoeksdoeleinden, maar veel moeilijker (om juridische of commerciële redenen) om toegang te krijgen voor productie doeleinden.
3.1.2. Kansen.
De kans hangt in hoge mate af van de kenmerken van BDS. Wanneer het gaat om grote administratieve gegevens, kan dit slechts 1 zijn, vooral als er (zoals bij de verkeersloopgegevens onderzocht door Daas et al. 8 Daas, P., M. Puts, B. Buelens en P. van den Hurk. 2015. 'Big Data as a Source for Official Statistics'. Journal of Official Statistics 31 (2). (Voorspeld publicatiedatum in juni 2015.)) geen problemen zijn met de bescherming van persoonlijke gegevens. Als de BDS van een particulier komt, vooral als deze gevoelig (bijvoorbeeld op het gebied van gegevensbescherming) of waardevol (commercieel) is, kan de kans zeer hoog zijn (5).
3.1.3. Impact
De impact hangt af van BOSP en de manier waarop BDS wordt gebruikt. Als BDS centraal staat, kan de impact zeer hoog zijn (4 = het is helemaal onmogelijk om BOSP te produceren), terwijl deze lager kan zijn als het nog steeds mogelijk is om BOSP te produceren (zij het met een lagere kwaliteit), afhankelijk van andere URB, waardoor de impact in de range van 2-3 ligt.
3.1.4. Preventie
Om het risico van het ontbreken van toegang te verlagen, moeten er vooraf contacten worden gelegd met de gegevensleverancier en moet er een langetermijnovereenkomst voor toegang tot de gegevens worden gesloten. Bovendien moet er een grondige juridische analyse worden uitgevoerd met betrekking tot de specifieke combinatie van BDS en BOSP. Ook moet er gekeken worden naar de mogelijkheden voor gegevensaccess met huidige of toekomstige wetgeving.
3.1.5. Mildering
Als er alternatieve BDS zijn die gebruikt kunnen worden voor BOSP, dan zouden deze in plaats daarvan onderzocht kunnen worden. Als het onmogelijk is om BOSP te produceren zonder BDS, en als het niet mogelijk is om het ontbreken van toegang te overwinnen, moeten de inspanningen worden stopgezet en zal er geen nieuwe BOSP zijn.
3.2. Verlies van toegang tot gegevens
3.2.1. Beschrijving
Dit risico houdt in dat de statistische autoriteit BDS verliest die ten grondslag ligt aan BOSP.
3.2.2. Kans
Als BOSP al wordt geproduceerd, is er meestal een bepaalde stabiliteit, en in sommige gevallen kan het risico zeer laag zijn (1). In het bijzonder bij particuliere entiteiten waarvoor onvoldoende harde afspraken zijn gemaakt, staat echter niets het nieuwe management in de weg om het beleid voor gegevensverstrekking te veranderen, wat kan leiden tot een gematigd risico op onderbreking (3). Bovendien, als BDS gerelateerd is aan onbetrouwbare activiteiten, bestaat altijd het risico dat de provider gewoon failliet gaat, en kan het risico zelfs verhoogd zijn (4).
3.2.3. Impact
Aangezien het bestaande BOSP misschien niet te produceren is, is er vaak een zeer sterke impact (5). In andere gevallen, wanneer BDS ondersteunend van aard is, kan de impact eerder een kwaliteitsverlies zijn met een impact in de range van 2-3.
3.2.4. Preventie
De preventiestrategie is vergelijkbaar met de strategie voor gebrek aan toegang tot gegevens, maar met een verhoogde nadruk op voortdurende waakzaamheid ook in productieomstandigheden.
Al je eieren in één mand leggen (d.w.z. meerdere BDS achter elk BSOP hebben) kan ook een strategie zijn, maar het kan ofwel onpraktisch of te kostbaar zijn.
3.2.5. Mitigatie
Als BDS het resultaat is van onbetrouwbare activiteiten, kan er geleidelijk een nieuwe BDS beschikbaar komen die hetzelfde sociale fenomeen weerspiegelt. Het zou echter te laat zijn om 'de markt te scannen' zodra het BSOP faalt; voortdurende waakzaamheid is vereist — en dat kan moeilijk te bereiken zijn.
4. Risico's verbonden aan de juridische omgeving
4.1. Niet-naleving van relevante wetgeving
4.1.1. Beschrijving
Dit risico bestaat uit een project gerelateerd aan de ontwikkeling van BOSP, waarbij de relevante wetgeving niet in acht wordt genomen, waardoor BOSP niet voldoet aan de aangegeven wetgeving. Dit kan betrekking hebben op wetgeving inzake gegevensbescherming, regelgeving met betrekking tot de reactielasten, enz.
4.1.2. Kans
Gezien de onwetendheid van OSC over big data, is het niet uitgesloten dat er incidentele (3) niet-nalevingen plaatsvinden. De kans hangt meestal samen met BDS, aangezien hoe minder 'gevoelig' de bron is, hoe kleiner de kans op niet-naleving.
4.1.3. Impact
De impact is doorgaans kritiek (4) in die zin dat voor niet-conforme productie het noodzakelijk is om de BOSP stop te zetten (of als deze nog niet is bereikt in de implementatiefase, moet de ontwikkeling worden stopgezet). Dit kan zelfs extreem zijn (5), aangezien de reputatierisico's die voortvloeien uit niet-conforme ('illegale') officiële statistieken gevolgen kunnen hebben.
4.1.4. Preventie
Voor elke BOSP is een grondige juridische analyse vereist — en dit gebeurt in verschillende fasen (wat acceptabel is in de ontwikkelings- of verkenningsfase, is dat wellicht niet in de implementatiefase of productie). Dit kan op zijn beurt leiden tot herengineering van de BOSP om deze compatibel te maken.
4.1.5. Mitigatie
Afhankelijk van de ernst van de niet-naleving, kan de eerste stap zijn om de BOSP in de offline modus te zetten.
Herengineering van de BOSP om deze compatibel te maken, kan een optie zijn, maar of de BOSP op deze manier 'gered' kan worden, hangt sterk af van de aard van de niet-naleving.
4.2. Ongunstige veranderingen in de wettelijke omgeving
4.2.1. Beschrijving
Er kan nieuwe wetgeving worden ingevoerd die betrekking heeft op de ontwikkelde BOSP, waardoor de BOSP feitelijk incompatibel wordt.
4.2.2. Kans
Het is niet uitgesloten dat voorstanders van verbeterde gegevensbescherming erin slagen nieuwe vereisten in te voeren die direct of indirect invloed hebben op de mogelijkheid om specifieke BOSP te creëren. Een kans in het bereik van 2-3 lijkt een realistische schatting.
4.2.3. Impact
De impact is doorgaans kritisch (4), in die zin dat niet-conforme productie zal vereisen dat de BOSP wordt stopgezet.
4.2.4. Preventie
Bepaalde bedrijfsinformatie moet regelmatig worden bijgehouden om de ontwikkeling van de wetgeving te monitoren — mogelijk ook om deze te beïnvloeden door argumenten voor officiële statistieken naar voren te brengen op relevante (bijvoorbeeld advies-)forums.
4.2.5. Mitigatie
Op voorwaarde dat er proactieve monitoring heeft plaatsgevonden, kan er tijd zijn voor herengineering van de BOSP om deze vanaf de eerste dag van inwerkingtreding in overeenstemming te brengen met de nieuwe wetgeving.
Als er aan de andere kant geen monitoring plaatsvond, waardoor de nieuwe wetgeving een 'verrassing' werd — of als de wetgeving zo radicaal is dat er geen manier is om BOSP incompatibel te maken — kan de enige optie zijn om BOSP uit te schakelen.
5. Risico's met betrekking tot privacy en gegevensbeveiliging
5.1. Gegevensbeveiligingsinbreuken
5.1.1. Beschrijving
Dit risico heeft betrekking op ongeautoriseerde toegang tot gegevens die zijn opgeslagen in statistische beheersystemen. Derden kunnen toegang krijgen tot gegevens die onder embargo staan, bijvoorbeeld als gevolg van de release van een schema (9 Voor elke BOSP die volledig gebaseerd is op een enkele BDS, is het onvermijdelijk dat de gegevens impliciet bekend zijn bij de oorspronkelijke eigenaar van de gegevens, en als de methodologie transparant is, zullen ook de afgeleide statistieken bekend zijn. Deze situatie wordt hier niet besproken, maar in plaats daarvan het risico dat samenhangt met machtsmisbruik door de eigenaren.) (10 Bovendien kunnen deze gegevens privacyrisico's met zich meebrengen. Dit risico zal afzonderlijk worden behandeld.). Dit kunnen bijvoorbeeld gegevens zijn die investeerders op de aandelenmarkt verwachten.
5.1.2. Waarschijnlijkheid
Wat betreft de technische aspecten van de bescherming van de IT-omgeving in de statistische divisie, is het risico vergelijkbaar voor BDS's als voor traditionele bronnen. Er zijn echter twee extra aspecten die moeten worden overwogen.
Ten eerste kan bij sommige BDS de algemene kans op risico's licht toenemen omdat de gegevensbeveiliging van de oorspronkelijke eigenaar bedreigd kan worden. Dit kan bijvoorbeeld het gevolg zijn van industrieel spionage of hacking.
Ten tweede, zodra potentieel waardevolle gegevens in het kantoor worden opgeslagen, neemt het risico op kwade bedoelingen toe. Als de opgeslagen gegevens van zeer hoge waarde zijn voor een bedrijf, moet men zich voorbereiden op een zeer hoge waarschijnlijkheid van aanvallen op de IT-infrastructuur, waardoor de kans op een hack potentieel hoger kan zijn (4).
Als de opgeslagen gegevens niet als waardevol worden beschouwd, lijkt de algemene waarschijnlijkheid niet erg hoog te zijn — tussen (1) en (3), afhankelijk van de gegevensbron.
5.1.3. Invloed
De potentiële reputatieschade kan aanzienlijk zijn (5). Wat belangrijk is in het geval van BDS, is dat als een beveiligingsinbreuk plaatsvindt bij de oorspronkelijke eigenaar, de impact op de reputatie van de statistische autoriteit naar verwachting lager zal zijn dan wanneer de inbreuk zou plaatsvinden met gegevens in hun beheer.
Aan de andere kant kan een inbreuk in de statistische autoriteit negatieve gevolgen hebben voor de oorspronkelijke eigenaar. In dat geval is er opnieuw een grote kans op negatieve impact als gevolg van schade aan het vertrouwen tussen de leverancier en de statistische autoriteit (5).
5.1.4. Preventie
Wat kenmerkend is voor het geval BDS, is dat de beveiligingsprocedures van de oorspronkelijke eigenaar relevant kunnen zijn. Het is onwaarschijnlijk dat statistische autoriteiten toezicht krijgen op deze procedures. Eigenaren wiens gegevens worden gebruikt om records met vertrouwelijke publicatieplanningen te maken, moeten worden geïnformeerd over de gevolgen voor de officiële statistieken van een mogelijke beveiligingsinbreuk in hun gebouwen en moeten een officiële garantie ontvangen dat de juiste beveiligingsprocedures worden toegepast.
Een directe manier om de ernstige impact van een beveiligingsinbreuk in het gebouw van de eigenaar op de statistische autoriteit te voorkomen, is ervoor te zorgen dat meerdere bronnen worden gebruikt voor hetzelfde product, zodat één gecompromitteerde bron niet genoeg is om tot een definitief cijfer te komen. Het voordeel van deze benadering is dat de controle in handen van de statistische autoriteit blijft.
Een manier om de negatieve gevolgen van een beveiligingsinbreuk in een statistisch bureau voor de oorspronkelijke eigenaar van de gegevens te voorkomen, is door een manier te vinden om te werken die geen overdracht van gegevens impliceert die potentieel gevoelig zijn vanuit het perspectief van de eigenaar, in ruwe vorm. Een mogelijke preventieve benadering is het gebruik van geaggregeerde gegevens. Het moet echter worden opgemerkt dat sommige vormen van aggregatie, zoals die bedoeld zijn om de identificatie van individuele leden van de populatie te voorkomen, in dit geval misschien niet geschikt zijn. Een van de redenen hiervoor kan zijn dat het risico voor de eigenaar verband houdt met de commerciële waarde van de gegevens, die aanzienlijk kan zijn, zelfs na het bereiken van anonimiteit.
5.1.5. Vermindering
In het geval van een inbreuk op gegevens die onder het beheer van het statistisch bureau vallen, zullen de maatregelen om de gevolgen te verzachten dezelfde zijn als bij traditionele bronnen, tenzij er een negatieve impact op de oorspronkelijke eigenaar heeft plaatsgevonden.
In het geval van negatieve gevolgen voor de oorspronkelijke eigenaar, moet het statistisch bureau zijn veiligheidsprocedures herzien en versterken en duidelijk zijn toewijding aan deze maatregelen communiceren en aantonen.
Als de inbreuk heeft plaatsgevonden in de ruimtes van de oorspronkelijke eigenaar, moet de betreffende statistische dienst duidelijk informeren over de situatie en aandringen op verbeteringen in de beveiligingsprocedures van de eigenaar. Indien nodig kan gezocht worden naar een alternatieve leverancier.
5.2. Inbreuken op de privacy van gegevens
5.2.1. Beschrijving
Dit is het risico dat de privacy van een of meer personen uit de statistische populatie wordt geschonden. Dit kan verband houden met aanvallen op de IT-infrastructuur als gevolg van druk van andere overheidsinstellingen of als gevolg van onvoldoende maatregelen ter controle van de onthulling van statistische gegevens.
5.2.2. Kans
Net als bij het risico van een beveiligingsinbreuk veranderen de technische voorwaarden voor de opslag van microgegevens niet veel bij de toevoeging van BDS. Er zijn echter ook hier waarschuwingen.
Microgegevens uit bepaalde gegevensbronnen kunnen een hoge zakelijke waarde hebben, waardoor de opslag ervan de kans op aanvallen vergroot.
Bovendien kunnen sommige microdata potentieel zeer waardevol zijn voor andere overheidsinstanties, zoals de wetshandhaving, belastingdiensten of de gezondheidszorg. Onder bepaalde omstandigheden kan de toewijding aan het principe van statistische vertrouwelijkheid onder grote druk komen te staan.
Wat betreft tekortkomingen in de controle op de openbaarmaking van statistische informatie, is er inmiddels een gevestigde praktijk. BDS kan het mogelijk maken om statistieken voor kleine subgroepen van de bevolking te produceren of de mogelijkheid te bieden om geaggregeerde gegevens uit verschillende BDS te koppelen, wat het risico kan verhogen. Bovendien vereisen nieuwe bronnen echter nieuwe methodologische ontwikkelingen, zodat het echte gevaar ligt in het feit dat de methodologie voor het controleren van de openbaarmaking van informatie niet goed wordt bijgewerkt.
Over het algemeen kan, met redelijke preventieve maatregelen, de waarschijnlijkheid op een redelijk niveau worden behouden, maar aangezien er veel verschillende en diverse factoren zijn, lijkt de relevante beoordeling hier te zijn dat de waarschijnlijkheid hoog is (4).
5.2.3. Invloed
De potentiële reputatieschade kan groot zijn (5). Net als bij het risico van een datalek, kan een tekortkoming in statistisch beheer negatieve gevolgen hebben voor de oorspronkelijke eigenaar. Hier kan de impact van zo'n gebeurtenis zelfs potentieel groter zijn, vooral als de huidige trends in de publieke opinie aanhouden. Verwacht wordt dat de schade aan de relatie tussen gegevensleverancier en statistisch beheer ook zeer groot zal zijn.
5.2.4. Preventie
Een foutloze manier om het risico te voorkomen, is door helemaal geen microdata uit BDS te hebben (hoewel het bewaren van andere microdata ook gepaard gaat met een bijbehorend risico, zij het met een andere waarschijnlijkheid en impact). Deze route, net als bij het risico op datalekken, zal de noodzaak met zich meebrengen om andere manieren van gegevensgebruik voor statistische doeleinden te ontwikkelen. Bovendien betekent de verschillende aard van de bronnen dat nieuwe methodologieën ontwikkeld moeten worden met concurrerende doelstellingen om zoveel mogelijk nuttige informatie te extraheren en privacy te beschermen tegen gevaar.
Bij het opslaan van microdata moeten de IT-beveiligingsmechanismen en toegangscontroles op het vereiste niveau zijn en constant worden gecontroleerd. Bijzondere aandacht moet worden besteed aan de beveiliging van nieuwe manieren om gegevens te verkrijgen. Ironisch genoeg kan zo'n nieuwe manier de fysieke transportatie van opslagapparaten zijn (bijvoorbeeld harde schijven). Als deze methode wordt gebruikt, moet de levering fysiek beveiligd zijn en moet codering worden toegepast.
5.2.5. Verzachtende maatregelen
De verzachtende maatregelen hier zijn in principe dezelfde als bij datalekken. Als de oorzaak van de inbreuk druk is van een andere overheidsinstantie, moet de kans worden benut om de onafhankelijkheid van het beheer te versterken, zodat dergelijke schendingen in de toekomst nog moeilijker worden.
5.3. Manipulatie van de gegevensbron
5.3.1. Beschrijving
Derde partij gegevensleveranciers, zoals sociale media gegevens of vrijwillig verstrekte gegevens, lopen het risico op manipulatie. Dit kan worden gedaan door de gegevensleverancier zelf of door derden. Veel valse berichten op sociale media kunnen bijvoorbeeld worden gegenereerd om de statistische index, berekend op basis van deze gegevens, op een bepaalde manier te beïnvloeden, als bekend is dat de index op basis van deze gegevens wordt berekend.
Bij vrijwillig verstrekte gegevens kan het geval zich voordoen dat vrijwilligers een bepaalde belangengroep vertegenwoordigen met een bepaalde agenda.
5.3.2. Waarschijnlijkheid
Voor gegevens waarvan manipulatie aanzienlijke voordelen kan opleveren, is de kans groter. Dit kunnen gegevens zijn waarvoor statistieken interessant zijn, zoals de aandelenmarkt. In het licht van recente schandalen met betrekking tot LIBOR en Forex kan worden aangenomen dat, zolang er een stimulans is, pogingen tot gegevensmanipulatie waarschijnlijk zullen zijn.
Voor statistieken die zijn gebaseerd op vrijwillig verstrekte gegevens, hoeft men alleen maar te kijken naar de recente PR-praktijk van het aannemen van mensen die doen alsof ze een bepaalde mening hebben en die betaald worden voor hun publieke uitingen (bijvoorbeeld op internetfora), om te concluderen dat de kans niet onwaarschijnlijk is. In het algemeen lijkt een cijfer tussen de 3 en 4 adequaat.
5.3.3. Invloed
Een groot probleem met manipulaties is dat ze lange tijd kunnen voortduren zonder ontdekt te worden. Als manipulaties gedurende een lange periode aanhouden, kan de invloed op de kwaliteit aanzienlijk worden. Bovendien kan de schade aan het publieke vertrouwen in officiële statistieken ook groot zijn, vooral als de rol van statistische bureaus als leveranciers van kwalitatieve gegevens openbaar wordt benadrukt. Aan de andere kant, als manipulaties tijdig worden ontdekt en vervolgens gepubliceerd, kan dit feitelijk de publieke perceptie verbeteren. Behalve in extreem slechte gevallen kan de maximale impact worden voorgesteld (3).
5.3.4. Preventie
Het uitvoeren van regelmatige controleoefeningen met alternatieve bronnen is een van de mogelijke preventieve benaderingen. Deze alternatieve bronnen kunnen traditioneel of anderszins zijn. Het gebruik van statistieken op basis van een combinatie van bronnen kan helpen om significante invloeden van manipulaties te voorkomen. In gevallen waarin men zich zorgen maakt over door de aanbieder geïnitieerde manipulaties, kunnen juridische overeenkomsten ook een manier zijn om dergelijke praktijken te voorkomen.
5.3.5. Verzachting
Vanuit het perspectief van schade aan de openbare relaties verschillen de verzachtende maatregelen die hier moeten worden genomen nauwelijks van de maatregelen om met elke crisis om te gaan.
Vanuit het perspectief van gegevenskwaliteit zou het nuttig zijn als historische gegevens konden worden gecorrigeerd, zodat zelfs met grote vertraging de juiste reeks beschikbaar kon zijn.
wordt geproduceerd. Regelmatig benchmarken kan hierbij nuttig zijn. Houd er rekening mee dat het doel van de vergelijkende analyse in dit geval iets verschilt van het doel van preventie. Voor preventie is het belangrijk om snel verdachte afwijkingen tussen de referentietestgegevens en BDS te signaleren en te onderzoeken. Voor het verzachten van de gevolgen zijn oude nuttige gegevens altijd nuttig.
Daarnaast moet ervoor gezorgd worden dat dergelijke manipulaties in de toekomst worden voorkomen — in bijzonder gevoelige gevallen kan dit betekenen dat er potentieel overbodige gegevens van meerdere leveranciers worden verkregen voor een vergelijkende analyse.
5.4. Ongunstige publieke perceptie van het gebruik van big data door officiële statistieken
5.4.1. Beschrijving
De media en het brede publiek zijn zeer gevoelig voor privacykwesties en het gebruik van persoonlijke gegevens uit grote databronnen, vooral in de context van het secundair gebruik van gegevens door overheidsinstanties die administratieve of juridische maatregelen nemen tegen burgers. Ongunstig waargenomen gebruik kan zich manifesteren als het positioneren van snelheidscamera's op basis van de analyse van navigatiegegevens (11 Zie ).
Een specifiek geval van TomTom Nederland leidde tot een significante daling van de vraag naar TomTom-apparaten en resulteerde in een besluit van het bedrijf om de toegang tot de gegevens te beperken. In dit specifieke geval waren de gegevens gerelateerd aan individuele personen, maar aan snelheidsniveaus over bepaalde wegsegmenten.
Desondanks kunnen er toepassingen met big data zijn die positief worden ervaren door het publiek. Een voorbeeld kan zijn van toepassingen die misdrijven zoals inbraak voorkomen op basis van big data-methoden.
Zowel positieve als negatieve publieke opinie kan een sterke invloed hebben op het gebruik van BDS in de context van het produceren van officiële statistieken.
Een gevolg van een negatieve publieke perceptie kan zijn dat:
- BDS niet langer beschikbaar zal zijn voor statistische bureaus, hetzij door besluiten van de gegevensleverancier of overheidsbesluiten om de gegevens niet te gebruiken, of
- het gebruik van gegevens zal beperkt zijn, wat productie kan belemmeren als bepaalde BOSP.
5.4.2. Kans
Factoren die de kans op een dergelijk evenement of de impact ervan op het produceren van statistieken kunnen beïnvloeden:
- gegevensprivacy, dat wil zeggen hoe gemakkelijk mensen te identificeren zijn;
- de hoeveelheid informatie die de gegevens over natuurlijke personen onthullen, bijvoorbeeld door gegevens uit verschillende bronnen te koppelen;
- soort gegevens, bijvoorbeeld financiële transacties worden als vertrouwelijker beschouwd dan andere gegevens;
- type potentiële actie die tegen burgers kan worden ondernomen, bijvoorbeeld mensen boetes opleggen voor snelheidsovertredingen;
- ondoorzichtige juridische omgeving waarin gegevensleveranciers en gebruikers opereren, of wanneer juridische voorwaarden in tegenspraak zijn met publieke ethische opvattingen / normen;
- de mate van afhankelijkheid van een bepaalde gegevensbron voor het verkrijgen van statistieken; in de verkenningsfase kan deze factor van weinig belang zijn. Echter, het kan de verkregen statistieken op een later tijdstip sterk beïnvloeden en moet derhalve ook in de verkenningsfase in overweging worden genomen. Een van de problemen kan zijn dat het uiteindelijke gebruik van gegevens in het begin onbekend is, aangezien gegevensbronnen mogelijk meer dan één statistisch gebied kunnen bedienen.
Het inschatten van de tijd van ongewenste gebeurtenissen is onmogelijk, aangezien de mobilisatie van het publiek vaak wordt geïnitieerd door de berichtgeving over gebeurtenissen die een negatieve impact op burgers hebben. Niettemin, met de toenemende inzet van big data door overheden en bedrijven, en vooral met de actieve marketing van gegevens voor andere doeleinden dan die welke leidden tot hun oorspronkelijke verzameling, is het waarschijnlijker dat dergelijke gebeurtenissen zich zullen voordoen.
Gebeurtenissen die een sterke impact hebben op de publieke perceptie zijn niet frequent, maar eerder willekeurig (3) en verre (2). Met de toename van het gebruik van grote gegevensbronnen zal de kans ook toenemen.
5.4.3. Impact
De impact van een gebeurtenis hangt sterk af van de hierboven genoemde factoren. Over het algemeen is de invloed aanzienlijker voor reeds bestaande producties van statistische gegevens, aangezien de actie mogelijk moet worden stopgezet. De impact hangt ook af van de beschikbaarheid van alternatieve gegevensbronnen, hoewel het kan voorkomen dat het publiek geen onderscheid maakt tussen verschillende gegevensbronnen bij de materialisatie van een gebeurtenis. In de huidige staat van het gebruik van big data lijkt het erop dat deze bronnen de traditionele gegevensbronnen niet volledig kunnen vervangen, maar eerder de bestaande statistieken aanvullen. Dit zal de impact van gebeurtenissen verminderen. Daarom wordt de impact van een gebeurtenis beoordeeld op een schaal van 2 (onbelangrijk) tot 3 (belangrijk). In de productiefase kan de impact toenemen tot 4 (kritieke waarde).
5.4.4. Preventie
Preventieve maatregelen kunnen het vaststellen van ethische principes voor big data in officiële statistiek inhouden. Ethische richtlijnen moeten zijn gebaseerd op principes zoals de gedragscode voor Europese statistiek of de fundamentele principes van officiële statistiek (12 ). Een volgende maatregel kan het vaststellen van een communicatiestrategie zijn die de resultaten van de ethische richtlijnen aan het publiek publiceert en kan worden gebruikt om belanghebbenden te informeren over het ethisch gebruik van BDS voor BOSP.
Een afzonderlijke risicobeoordeling voor een specifieke BDS kan worden uitgevoerd om risico's te identificeren en preventieve of verzachtende maatregelen voor te stellen op basis van ethische principes. Een afzonderlijke risicobeoordeling kan ook belanghebbenden omvatten, zoals gegevensbeschermingsagentschappen, om ervoor te zorgen dat alle risico's worden geïdentificeerd en dat de acties gerechtvaardigd zijn.
5.4.5. Verzachting
De communicatiestrategie moet ook maatregelen opnemen voor het geval het negatieve publiek sentiment toeneemt. Een aparte risbeoordeling moet positieve voorbeelden van gegevensgebruik en maatregelen ter voorkoming van misbruik van gegevens verzamelen, die op politiek niveau verplicht kunnen worden aangenomen, en de statistische gemeenschap blijkt mogelijk niet in staat te zijn om daar effectief invloed op uit te oefenen.
5.5. Verlies van vertrouwen - verkregen niet door observatie
5.5.1. Beschrijving
Gebruikers van officiële statistieken hebben doorgaans een hoog vertrouwen in de nauwkeurigheid en betrouwbaarheid van statistische gegevens. Dit is gebaseerd op het feit dat de productie van statistische gegevens ingebed is in een betrouwbare en toegankelijke methodologische basis, evenals documentatie over de kwaliteit van het statistische product. Bovendien zijn de meeste statistische gegevens gebaseerd op observaties, dat wil zeggen verkregen uit enquêtes of volkstellingen, die een gemakkelijk te begrijpen relatie tussen observatie en statistische gegevens tot stand brengen. Het gebruik van BDS die niet zijn verzameld voor het primaire doel van statistiek, brengt het risico met zich mee dat deze relaties verloren gaan, waardoor gebruikers het vertrouwen in de officiële statistische gegevens verliezen. Een voorbeeld dat betrekking heeft op de laatste ronde (2010) van de volkstelling, betreft het feit dat in sommige landen statistische gegevens zijn verkregen met behulp van verschillende bronnen en statistische modellen. In een aantal gevallen betwistten belanghebbenden de statistische gegevens.
5.5.2. Waarschijnlijkheid
De waarschijnlijkheid van het optreden van een risico hangt af van factoren zoals de complexiteit van het statistische / methodologische model, de betrouwbaarheid van de relaties tussen BSD en BOSP of de overeenstemming met andere statistische gegevens. De waarschijnlijkheid moet liggen tussen 3 (toeval) en 4 (waarschijnlijk), wat betekent dat het enkele keren of vaak kan gebeuren.
5.5.3. Impact
De impact van het optreden van risico zal grotendeels afhangen van de vraag of NSO's erin slagen de nauwkeurigheid en betrouwbaarheid van de statistische gegevens te bewijzen. Als dit niet kan worden bereikt, kan de impact in termen van verlies van vertrouwen en geloofwaardigheid ook andere statistische gebieden raken, wat betekent dat niet alleen sommige statistische gegevens betrouwbaar zijn, maar ook de organisatie zelf in twijfel kan worden getrokken. NSO's zouden hun concurrentievoordeel verliezen ten opzichte van andere particuliere organisaties die op dit gebied actief zijn.
5.5.4. Preventie
Preventieve acties zullen bestaan uit de ontwikkeling en publicatie van een wetenschappelijk onderbouwde methodologie die erkend wordt door de wetenschappelijke gemeenschap, het aanvullen van gegevens met kwaliteitsmetadata, het waarborgen van de consistentie van BOSP met niet-BOSP, en het uitvoeren van strikte kwaliteitscontroles.
Voordat statistische productie begint, zou BOSP als experimenteel gepubliceerd kunnen worden, en belanghebbenden zou worden aanbevolen om BOSP aan te vechten om BOSP te bevestigen of te verbeteren.
5.5.5. Mitigatie
Er zijn twee gevallen om te onderscheiden. In het geval dat de statistische gegevens worden betwist, maar van hoge / voldoende kwaliteit zijn (correct / nauwkeurig), zou het voldoende zijn om de statistische gegevens uit te leggen en aan het publiek over te brengen, waarbij eenvoudige en begrijpelijke voorbeelden worden gegeven.
6. Risico's met betrekking tot vaardigheden
6.1. Gebrek aan specialisten
6.1.1. Beschrijving
De analyse van digitale sporen die mensen achterlaten tijdens hun activiteiten vereist specifieke data-analysetools, die momenteel niet de meest gebruikelijke zijn in officiële statistieken. Ten eerste vereist het gebruik van indirecte gegevens over menselijke activiteiten in plaats van directe enquêtes het gebruik van statistische modellen en bijgevolg vaardigheden in redeneren en machine learning. Ten tweede bestaan deze digitale registraties uit gegevens die vaak geen gebruikelijk tabelformaat hebben dat normaal is voor enquête-resultaten, met rijen die overeenkomen met statistische eenheden en kolommen met specifieke kenmerken van deze statistische eenheden. Digitale sporen worden ook gepresenteerd in de vorm van tekst, geluid, afbeeldingen en video. Het extraheren van relevante statistische informatie uit deze datatypes vereist vaardigheden in natuurlijke taalverwerking, audiobewerking en beeldverwerking. Ten derde hebben deze gegevensbronnen de neiging om enorme datasets te leveren, waarvan de verwerking een goed begrip vereist van de methodologieën voor gedistribueerde computing.
Het risico van een tekort aan experts ligt in het verkrijgen van gegevens uit een van deze nieuwe grote databronnen, omdat de statistische dienst niet in staat is deze adequaat te verwerken en te analyseren vanwege het ontbreken van de vereiste vaardigheden bij het personeel.
6.1.2. Kans
De kans op dit risico zal afhangen van drie factoren: 1) de specifieke soorten vaardigheden die nodig zijn voor elk type bron van grote gegevens en de waarschijnlijkheid dat de statistische dienst de mogelijkheid vindt om zo'n bron te onderzoeken; 2) de huidige beschikbaarheid van de benodigde vaardigheden binnen de statistische dienst; en 3) de organisatiecultuur van de statistische dienst.
Wat betreft de soorten vaardigheden die nodig kunnen zijn, moet worden opgemerkt dat niet alle bronnen alle bovengenoemde vaardigheden vereisen. Sommige (bijvoorbeeld gegevens van Google Trends) vereisen geen gedistribueerde computing, omdat ze al vooraf zijn verwerkt door de gegevenshouder of signaalverwerkingsvaardigheden hebben, en ze hebben voornamelijk vaardigheden in statistische modellering nodig. Er is echter een grote diversiteit aan big data-bronnen, waarvan de meeste gedistribueerde computing, signaalverwerking en machine learning-vaardigheden vereisen. Tegelijkertijd vereist het juiste onderzoek naar deze digitale sporen de verwerking van meerdere bronnen. Er is dus een grote kans dat de grote databronnen die beschikbaar komen voor statistisch beheer, deze ongebruikelijke vaardigheden vereisen, en de kans op dit risico is zeer hoog (5).
Wat betreft de huidige beschikbaarheid van de benodigde vaardigheden, zal dit afhangen van het specifieke statistische beheer. Zelfs als de enquête-methodologie minder gebruikelijk is dan de enquête-methodologie, wordt deze ook gebruikt in de officiële statistiek op bepaalde gebieden. Daarom, zelfs als dit enige herschikking van human resources kan vereisen, kunnen statistische beheerscapaciteiten een oplossing vinden met eigen middelen. Wat betreft vaardigheden in gedistribueerde computing, voornamelijk gerelateerd aan IT, zullen ze afhankelijk zijn van hoe de IT-infrastructuur in de organisatie wordt beheerd. Afhankelijk van hoe ver de IT-afdeling op afstand staat, kunnen oplossingen worden gevonden in de context van bestaande afspraken. Echter, vaardigheden in signaalverwerking en machine learning bestaan doorgaans niet binnen de meeste officiële statistische beheersorganen, en het toepassen van deze vaardigheden kan niet worden uitbesteed, omdat ze door statistici moeten worden toegepast. Vandaar dat de kans op dit risico vanuit dit gezichtspunt ook zeer hoog lijkt (5).
De organisatorische cultuur zal ook invloed hebben op de waarschijnlijkheid van dit risico. Het hebben van personeel dat bereid is om de nodige vaardigheden aan te leren door middel van zelfstudie, kan de organisatie in staat stellen te reageren op een nieuwe gegevensbron die vaardigheden vereist die anders zijn dan gebruikelijk. Dit zal afhangen van de organisatorische cultuur van statistisch beheer, namelijk of het medewerkers aanmoedigt om nieuwe vaardigheden te verwerven en of het hen tijd biedt voor zelfstudie.
Daarom zal de waarschijnlijkheid dat statistisch beheer niet in staat is om nieuwe gegevensbronnen te verwerken en te analyseren vanwege een gebrek aan vaardigheden bij zijn medewerkers, tussen waarschijnlijk (4) en vaak (5) liggen, afhankelijk van de cultuur van zelfstudie binnen de organisatie.
6.1.3. Invloed
Statistisch beheer dat niet in staat is om grote gegevensbronnen te verwerken en te analyseren vanwege een gebrek aan vaardigheden bij zijn personeel, kan twee mogelijke negatieve gevolgen hebben: 1) de gegevensbron zal niet worden bestudeerd, althans niet volledig; 2) de bron zal verkeerd worden gebruikt.
Het ontbreken van de mogelijkheid om het volledige potentieel van een waardevolle grote dataset te onderzoeken, zal een geringe invloed (2) hebben op de korte termijn, aangezien statistische diensten inderdaad beschikken over statistische hulpmiddelen om aan de huidige behoeften te voldoen. Echter, op de lange termijn (en mogelijk zelfs op de middellange termijn) zullen de gevolgen van het verlies van deze mogelijkheid van cruciaal belang zijn (4), aangezien statistische diensten steeds vaker worden geconfronteerd met concurrentie van particuliere aanbieders die niet over dezelfde institutionele structuur beschikken die hen in staat stelt de onafhankelijkheid van statistische gegevens aan de maatschappij te waarborgen.
Echter, verkeerd gebruik van de bron zal uiterst negatieve gevolgen hebben voor statistische diensten, aangezien officiële statistieken in grote mate afhankelijk zijn van hun reputatie bij het uitvoeren van hun missie. Niettemin kunnen we stellen dat de belangrijkste vaardigheid die, indien deze ontbreekt, kan leiden tot onjuiste resultaten, statistische inference is, in het bijzonder inference gebaseerd op modellen, welke ook minder waarschijnlijk afwijkend zal zijn. Daarom zal de verwachte impact eerder kritisch (4) zijn dan extreem.
6.1.4. Preventie
Statistische diensten kunnen dit risico actief vermijden op twee manieren: 1) training; en 2) aanwerving.
Statistische diensten kunnen het personeel de nodige vaardigheden bieden door gedetailleerd te definiëren welke vaardigheden vereist zijn om grote databronnen in de statistische productie te gebruiken, door een lijst op te stellen van bestaande vaardigheden van het personeel, de opleidingsbehoeften vast te stellen en vervolgens cursussen te organiseren.
Statistische diensten kunnen ook nieuwe medewerkers aantrekken met de vereiste vaardigheden. Dit lijkt echter ernstige beperkingen te hebben, omdat statistische diensten niet in staat zullen zijn om een kritische massa van personeel aan te trekken voor een situatie waarin het gebruik van grote databronnen wijdverspreid zal zijn binnen de afdeling, terwijl nieuwe medewerkers nog enkele jaren nodig hebben om het ervaringsniveau van bestaande medewerkers te bereiken. Echter, tenminste sommige van de nieuwe medewerkers die worden aangeworven in het kader van reguliere personeelsvernieuwing, kunnen vaardigheden met betrekking tot big data bezitten.
6.1.5. Verzachting
In een situatie waarin nieuwe bronnen van big data beschikbaar zijn zonder medewerkers met de vereiste vaardigheden, kunnen statistische diensten de negatieve gevolgen verzachten op twee manieren: 1) uitbesteding; en 2) samenwerking.
Statistische bureaus kunnen contracten sluiten voor gegevensverwerking en analyse van nieuwe bronnen van big data met andere organisaties die deze diensten aanbieden. Dit lijkt een levensvatbare oplossing, aangezien er een nieuwe sector is ontstaan die zich richt op de verwerking van dergelijke data. Echter, deze oplossing brengt bepaalde risico's met zich mee, omdat het statistische bureau minder controle zal hebben over de productie van potentieel gevoelige statistische producten. Tevens heeft deze oplossing het nadeel dat het medewerkers van het statistische bureau niet in staat stelt om te leren en de benodigde vaardigheden te verwerven.
Samenwerking met andere organisaties, waarin medewerkers met de benodigde vaardigheden aanwezig zijn en die ook geïnteresseerd zijn in het verkennen van de bron van big data, lijkt een veelbelovende oplossing. Deze samenwerking kan de vorm aannemen van gezamenlijke projecten met medewerkers van het statistische bureau en collega's van andere organisaties op gelijke voet, waarbij kennis wordt gedeeld. Dit zou niet alleen het risico van een tekort aan vaardigheden verminderen, maar ook de medewerkers van het statistische bureau in staat stellen om deze vaardigheden te verwerven.
6.2. Verlies van experts aan andere organisaties
6.2.1. Beschrijving
Dit risico houdt in dat statistische bureaus hun personeel aan andere organisaties verliezen nadat zij vaardigheden hebben verworven die verband houden met big data.
6.2.2. Kans
De kans op dit risico zal afhangen van twee factoren: 1) de bestaande aantrekkelijke mogelijkheden in organisaties buiten de officiële statistieken; 2) de arbeidsomstandigheden in statistische bureaus.
Wat betreft de mogelijkheden in organisaties buiten de officiële statistieken lijkt de kans op dit risico waarschijnlijk (4). Er is een grote vraag naar mensen met vaardigheden in big data in de particuliere sector, evenals in andere organisaties in de publieke sector. Na het verwerven van vaardigheden in big data zullen officiële statistieken een comparatief voordeel hebben door ervaren specialisten in het vakgebied te zijn. Naast specifieke vaardigheden in big data hebben andere organisaties ook behoefte aan datadeskundigen met meer traditionele vaardigheden, zoals het beoordelen van gebruikersbehoeften en het ontwikkelen van kernprestatie-indicatoren (KPI), die algemeen zijn voor officiële statistici. Bovendien wordt verwacht dat medewerkers die meer geneigd zijn om nieuwe vaardigheden te verwerven, ook diegenen zullen zijn die meer openstaan voor veranderingen in hun carrière en de statistische dienst zullen verlaten.
Wat betreft de arbeidsomstandigheden in statistische diensten, zal dit duidelijk voornamelijk afhangen van het specifieke kantoor. Desalniettemin bieden statistische diensten over het algemeen nog steeds aantrekkelijke professionele kansen voor mensen met een kwantitatieve achtergrond. Statistische diensten bieden het grootste bereik aan mogelijke domeinen om in te werken en de grootste keuze aan gegevens om mee te werken. Dit zal de kans verkleinen dat statistische diensten hun personeel verliezen door onvoorziene omstandigheden (3).
6.2.3. Impact
De impact van dit risico zal hetzelfde zijn als het risico van het ontbreken van personeel met de juiste vaardigheden. Daarom zal de impact kritiek zijn (4), zoals hierboven aangegeven.
6.2.4. Preventie
Blijkbaar is de enige mogelijkheid voor statistische bureaus om dit risico te voorkomen, het bieden van aantrekkelijke arbeidsvoorwaarden voor hun medewerkers. Dit geldt in het algemeen voor al het personeel. In specifieke gevallen, wanneer medewerkers openstaan voor het aanleren van nieuwe vaardigheden, vooral op het gebied van big data, kunnen de arbeidsvoorwaarden verbeterd worden door hen opleidingsmogelijkheden te bieden waarin ze hun professionele interesses kunnen ontwikkelen. Statistische bureaus kunnen ook extra aandacht besteden aan het openstaan voor nieuwe innovatieve projecten en ideeën die verband houden met nieuwe bronnen van big data, afkomstig van statistici die in verschillende statistische domeinen werken. Ten slotte zal het voorkomen van verlies van personeel aan andere organisaties, afhankelijk van hun vaardigheden met big data, afhangen van een goede identificatie van personeel dat in staat en bereid is om met dergelijke data te werken, en van het bieden van goede mogelijkheden voor hun professionele ontwikkeling.
6.2.5. Vermindering
Het verminderen van dit risico zal betrekking hebben op het risico van gebrek aan personeel met de juiste vaardigheden: 1) onderaanneming; en 2) samenwerking.
7. Discussie
Uit deze eerste analyse blijkt duidelijk dat het onmogelijk is om een enkele waarschijnlijkheid of impact vast te stellen voor dit 'big data-risico' - doorgaans zijn beide maatstaven in belangrijke mate afhankelijk van de bron van de big data, evenals van de 'officiële statistiek op basis van big data'.
product ‘.
Daarom concluderen we dat een logische volgende stap in deze richting het aangaan van een aantal mogelijke pilotprojecten is (elk project omvat een combinatie van een of meerdere BDS's en een of meerdere BDOS's) als uitgangspunt en - voor elke pilot - de ambitie om de waarschijnlijkheid en impact van elk risico te evalueren.
Met dit doel zijn we op het punt om een enquête onder belanghebbenden te lanceren, met als doel de inschatting van OSC omtrent de waarschijnlijkheid, impact (en mogelijke preventieve/minderende acties) met betrekking tot een aantal mogelijke pilotprojecten te evalueren - en om voorstellen van OSC aan te vragen over risico's die we niet in dit document hebben opgenomen.
8. REFERENTIESUNECE (2014), «Een voorgestelde structuur voor de kwaliteit van Big Data», Leveringen van de UNECE Big Data Kwaliteit Task Team,
a%20Quality%20Framework%20-%20final-%20Jan08-2015.pdf?version=1&modificationDate=1420725063663&api=v2
UNECE (2014), «Hoe groot is Big Data? De rol van Big Data in officiële statistieken verkennen»,
Daas, P., S. Ossen, R. Vis-Visschers en J. Arends-Toth, (2009), Checklist voor de kwaliteitsbeoordeling van administratieve gegevensbronnen, Statistiek Nederland, Den Haag/Heerlen
Dorfman, Mark S. (2007), Inleiding tot Risicomanagement (e ed.), Cambridge, VK, Woodhead-Faulkner, p. 18, ISBN 0-85941-332-22)
Eurostat (2014), «Accreditatieprocedure voor statistische gegevens uit niet-officiële bronnen» in Analyse van methodologieën voor het gebruik van het internet voor de verzameling van informatie over de samenleving en andere statistieken,
Reimsbach-Kounatze, C. (2015), “De proliferatie van ‘Big Data’ en implicaties voor officiële statistieken en statistische agentschappen: een voorlopige analyse”, OECD Digital Economy Papers, No. 245, OECD Publishing.
Reis, F., Ferreira, P., Perduca, V. (2014) «Het gebruik van bewijs van webactiviteit om de tijdigheid van officiële statistiekindicatoren te verhogen», paper gepresenteerd op de IAOS 2014-conferentie,
Zelfs wanneer risico's niet expliciet worden genoemd, benadert dit artikel in feite de vele risico's die gepaard gaan met het gebruik van gegevens over webactiviteit voor officiële statistieken. Eurostat (2007), Handboek voor de beoordeling van gegevenskwaliteitsmethoden en -tools,
Bron: habr.com
