

Goedendag! Mijn naam is Daniil Lipovoy, ons team bij Sbertech is begonnen HBase te gebruiken als opslag voor operationele gegevens. Tijdens het bestuderen ervan hebben we ervaringen opgedaan die we wilden systematiseren en beschrijven (we hopen dat het voor velen nuttig zal zijn). Alle onderstaande experimenten zijn uitgevoerd met de versies HBase 1.2.0-cdh5.14.2 en 2.0.0-cdh6.0.0-beta1.
- Algemene architectuur
- Gegevens schrijven naar HBASE
- Gegevens lezen uit HBASE
- Gegevens cachen
- Batchverwerking van gegevens MultiGet/MultiPut
- Strategie voor het splitsen van tabellen in regio's (splitting)
- Fouttolerantie, compactie en data-localiteit
- Instellingen en prestaties
- Belastingstest
- Conclusies
1. Algemene architectuur
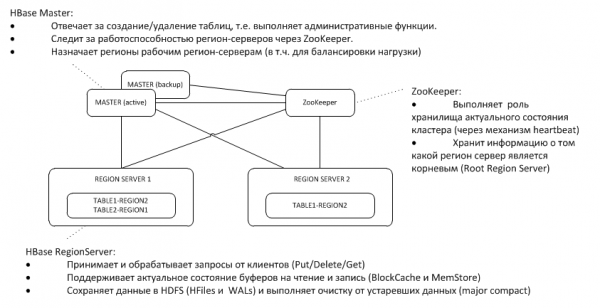
De back-up Master luistert naar de heartbeat van de actieve op de ZooKeeper-knoop en neemt in geval van uitval de functies van de master over.
2. Gegevens schrijven naar HBASE
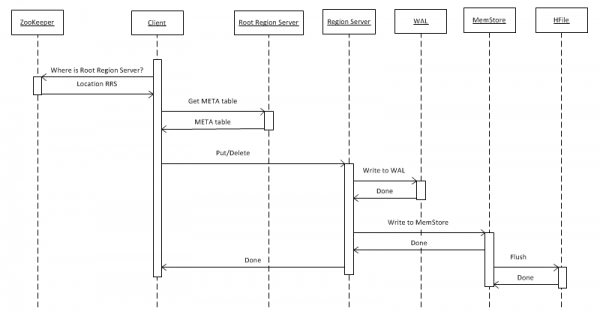
Laten we eerst de eenvoudigste zaak bekijken – het schrijven van een sleutel-waarde-object naar een tabel met behulp van put(rowkey). De cliënt moet eerst vaststellen waar de root region server (Root Region Server — RRS) is gelegen, die de hbase:meta-tabel opslaat. Deze informatie verkrijgt hij van ZooKeeper. Vervolgens wendt hij zich tot de RRS en leest de hbase:meta-tabel, waarvan hij informatie haalt over welke RegionServer (RS) verantwoordelijk is voor het opslaan van gegevens op basis van de opgegeven rowkey in de tabel van zijn interesse. Voor later gebruik wordt de meta-tabel gecached door de cliënt, zodat volgende verzoeken sneller gaan, rechtstreeks naar de RS.
Daarna schrijft de RS, na het ontvangen van het verzoek, het eerst naar de WriteAheadLog (WAL), wat nodig is voor herstel in geval van een crash. Vervolgens slaat hij de gegevens op in MemStore. Dit is een buffer in het geheugen die een gesorteerde verzameling sleutels voor deze regio bevat. Een tabel kan in regio's (partities) worden verdeeld, waarbij elke regio een niet-overlapend aantal sleutels bevat. Dit stelt ons in staat om, door regio's op verschillende servers te plaatsen, hogere prestaties te behalen. Ondanks de voor de hand liggende aard van deze bewering, zullen we echter zien dat dit niet in alle gevallen werkt.
Na het plaatsen van de opname in MemStore ontvangt de cliënt een antwoord dat de opname succesvol is opgeslagen. In werkelijkheid wordt deze echter alleen in de buffer opgeslagen en komt op de schijf terecht pas nadat er een bepaalde tijdsduur is verstreken of wanneer deze wordt gevuld met nieuwe gegevens.
Bij het uitvoeren van de operatie 'Delete' vindt er geen fysieke verwijdering van gegevens plaats. Ze worden gewoon gemarkeerd als verwijderd, en de daadwerkelijke vernietiging gebeurt op het moment dat de functie major compact wordt aangeroepen, waarvan meer details zijn geschreven in sectie 7.
Bestanden in het HFile-formaat accumuleren in HDFS en af en toe wordt er een minor compact proces gestart, dat gewoon kleine bestanden aan elkaar plakt in grotere, zonder iets te verwijderen. In de loop van de tijd wordt dit een probleem dat zich alleen bij het lezen van gegevens manifesteert (hier komen we binnenkort op terug).
Naast het hierboven beschreven uploadproces is er een veel efficiënter proces, dat naar mijn mening de sterkste kant van deze database vormt - BulkLoad. Dit houdt in dat we zelf HFiles aanmaken en op de schijf plaatsen, wat een uitstekende schaalbaarheid mogelijk maakt en behoorlijk redelijke snelheden bereikt. In feite is de beperking hier niet HBase, maar de mogelijkheden van de hardware. Hieronder zijn de uploadresultaten weergegeven op een cluster, bestaande uit 16 RegionServers en 16 NodeManager YARN (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 threads), versie HBase 1.2.0-cdh5.14.2.
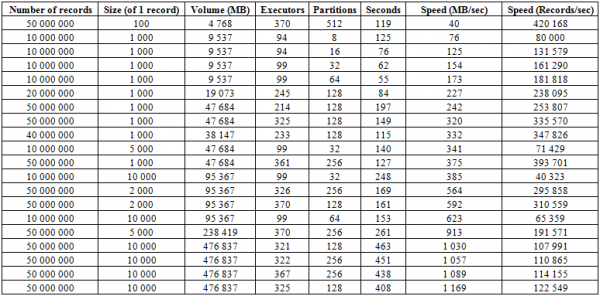
Hieruit blijkt dat door het aantal partities (regio's) in de tabel, evenals de Spark-executors te verhogen, we een snelheidstoename in de upload verkrijgen. Ook hangt de snelheid af van het volume van de records. Grote blokken geven een toename in MB/sec, terwijl kleine blokken een toename in het aantal ingevoegde records per tijdseenheid opleveren, bij gelijkblijvende omstandigheden.
Ook kan het mogelijk zijn om de upload naar twee tabellen tegelijkertijd uit te voeren en zo de snelheid te verdubbelen. Hieronder is te zien dat het schrijven van blokken van 10 KB direct naar twee tabellen gaat met een snelheid van ongeveer 600 Mb/sec naar elke tabel (totaal 1275 Mb/sec), wat overeenkomt met de schrijfsnelheid naar één tabel van 623 MB/sec (zie nr. 11 hierboven).
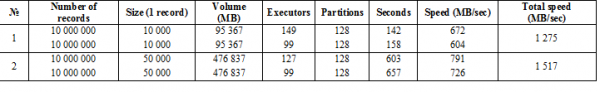
Hier laat de tweede run met het schrijven van 50 KB zien dat de upload snelheid nauwelijks toeneemt, wat wijst op een benadering van de limietwaarden. Hierbij moet opgemerkt worden dat er praktisch geen belasting op HBASE zelf wordt veroorzaakt, alles wat het nodig heeft, is eerst de gegevens uit hbase:meta terug te geven, en na het plaatsen van HFiles, de gegevens van BlockCache te flushen en de MemStore-buffer op de schijf te bewaren, als deze niet leeg is.
3. Gegevens lezen uit HBASE
Als we aannemen dat de klant alle informatie uit hbase:meta al heeft (zie punt 2), dan gaat de aanvraag direct naar de RS waar de benodigde sleutel is opgeslagen. Eerst wordt er in MemCache gezocht. Ongeacht of daar gegevens aanwezig zijn of niet, wordt er ook in de BlockCache-buffers gezocht en indien nodig in de HFiles. Wanneer de gegevens in het bestand worden gevonden, worden ze in de BlockCache geplaatst en bij de volgende aanvraag sneller teruggegeven. De zoekopdracht in HFile verloopt redelijk snel dankzij het gebruik van de Bloom-filter, dat wil zeggen dat het, door een kleine hoeveelheid gegevens te lezen, onmiddellijk bepaalt of dit bestand de benodigde sleutel bevat en als dat niet zo is, gaat het naar de volgende.
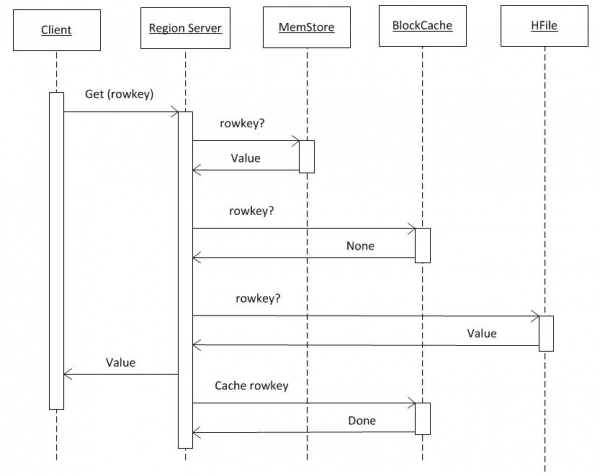
Nadat gegevens uit deze drie bronnen zijn verkregen, vormt de RS een antwoord. In het bijzonder kan het meerdere gevonden versies van een object tegelijk doorgeven als de klant om versiebeheer heeft gevraagd.
4. Gegevenscaching
De buffers MemStore en BlockCache nemen tot 80% van het aangewezen on-heap geheugen van de RS in beslag (de rest is gereserveerd voor service-taken van de RS). Als de typische gebruiksmodus zo is dat processen deze gegevens schrijven en vervolgens direct lezen, is het logisch om BlockCache te verkleinen en MemStore te vergroten, omdat de gegevens bij het schrijven niet naar de leescache gaan, waardoor gebruik van BlockCache minder vaak voorkomt. De BlockCache-buffer bestaat uit twee delen: LruBlockCache (altijd on-heap) en BucketCache (meestal off-heap of op SSD). BucketCache moet worden gebruikt wanneer er veel leesaanvragen zijn en deze niet in LruBlockCache passen, wat leidt tot actieve werking van de Garbage Collector. Hoewel we geen dramatische prestatiewinst van gebruik van de leescache mogen verwachten, komen we hier later op terug in punt 8.
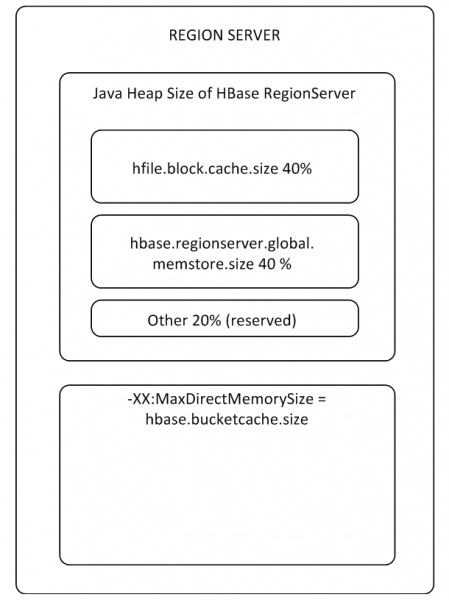
BlockCache is één voor de hele RS, terwijl MemStore voor elke tabel specifiek is (één voor elke Column Family).
Zoals in theorie komen gegevens bij het schrijven niet in de cache en inderdaad zijn parameters zoals CACHE_DATA_ON_WRITE voor de tabel en “Cache DATA on Write” voor de RS ingesteld op false. Echter in de praktijk, als je gegevens in MemStore schrijft, het vervolgens naar de schijf reset (hierdoor opruimende), en dan het resulterende bestand verwijdert, dan zullen we, na het uitvoeren van een get-aanroep, succesvol gegevens ontvangen. Zelfs als we BlockCache helemaal uitschakelen en de tabel met nieuwe gegevens vullen, en vervolgens een reset van MemStore naar de schijf afdwingen, deze verwijderen en op een andere sessie aanvragen, dan zullen ze alsnog ergens vandaan gehaald worden. Dus HBase slaat niet alleen gegevens op, maar ook mysterieuze raadsels.
hbase(main):001:0> create 'ns:magic', 'cf'
Created table ns:magic
Took 1.1533 seconds
hbase(main):002:0> put 'ns:magic', 'key1', 'cf:c', 'try_to_delete_me'
Took 0.2610 seconds
hbase(main):003:0> flush 'ns:magic'
Took 0.6161 seconds
hdfs dfs -mv /data/hbase/data/ns/magic/* /tmp/trash
hbase(main):002:0> get 'ns:magic', 'key1'
 cf:c      timestamp=1534440690218, value=try_to_delete_me
De parameter 'Cache DATA on Read' is ingesteld op false. Als je ideeën hebt, laat het ons weten in de reacties.
5. Batchverwerking van gegevens MultiGet/MultiPut
Het verwerken van enkele verzoeken (Get/Put/Delete) is een vrij dure operatie, dus het is aan te raden ze indien mogelijk te groeperen in een List of List, wat kan leiden tot een aanzienlijke prestatieverbetering. Dit geldt vooral voor schrijfoperaties, maar bij lezen is er een volgende valkuil. In de onderstaande grafiek is de leertijd van 50.000 records uit MemStore weergegeven. Het lezen gebeurde in één thread en op de horizontale as is het aantal sleutels in het verzoek weergegeven. Hieruit blijkt dat bij een toename tot duizend sleutels in één verzoek de uitvoeringstijd daalt, dat wil zeggen, de snelheid toeneemt. Echter, bij de standaard MSLAB-modus begint na deze drempel een drastische daling van de prestaties, en hoe groter de hoeveelheid gegevens in de registratie, hoe groter de verwerkingstijd.
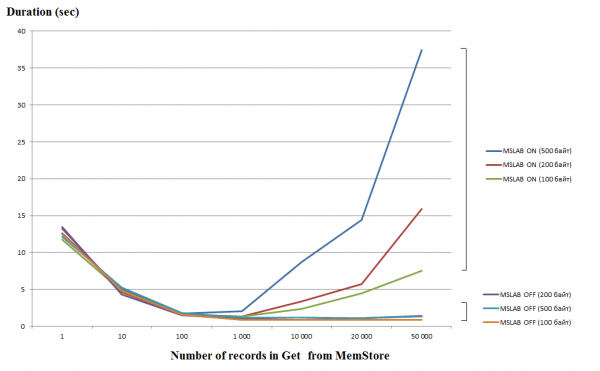
De tests werden uitgevoerd op een virtuele machine, 8 cores, versie HBase 2.0.0-cdh6.0.0-beta1.
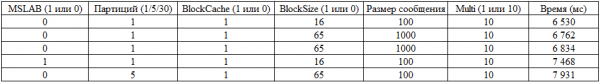
De MSLAB-modus is bedoeld om de fragmentatie van de heap te verminderen die ontstaat door de vermenging van nieuwe en oude generaties gegevens. Als oplossing voor dit probleem worden bij inschakeling van MSLAB gegevens in relatief kleine cellen (chunk) geplaatst en in batches verwerkt. Dit resulteert erin dat wanneer de hoeveelheid in het gevraagde datapakket de toegewezen grootte overschrijdt, de prestaties scherp dalen. Aan de andere kant is het uitschakelen van deze modus ook niet wenselijk, omdat dit leidt tot onderbrekingen door GC tijdens intensieve gegevensverwerking. Een goede oplossing is het vergroten van de cellengrootte, wanneer er actief wordt geschreven via put samen met lezen. Het is belangrijk te vermelden dat het probleem zich niet voordoet als na het schrijven het flush-commando wordt uitgevoerd dat MemStore naar de schijf wegschrijft of als er een upload plaatsvindt via BulkLoad. In de onderstaande tabel wordt getoond dat verzoeken vanuit MemStore met grotere hoeveelheden gegevens (en hetzelfde aantal) leiden tot vertraging. Door de chunksize te verhogen, kunnen we de verwerkingstijd weer naar normaal terugbrengen.
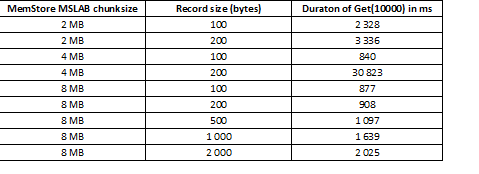
Naast het vergroten van de chunksize helpt het splitsen van gegevens op regio's, d.w.z. het splitsen van tabellen. Dit zorgt ervoor dat er minder verzoeken naar elke regio komen en als ze in een cel worden geplaatst, blijft de respons goed.
6. Strategie voor het splitsen van tabellen op regio's (splitting)
Aangezien HBase een key-value opslag is en de partitionering plaatsvindt op basis van de sleutel, is het cruciaal om de gegevens gelijkmatig over alle regio's te verspreiden. Bijvoorbeeld, partitionering van een dergelijke tabel in drie delen leidt ertoe dat de gegevens worden verdeeld over drie regio's:
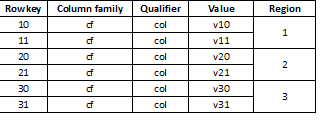
Het kan namelijk leiden tot een sterke vertraging, als de later te laden gegevens voornamelijk lange waarden zijn die in wezen beginnen met hetzelfde cijfer, zoals:
1000001
1000002
…
1100003
Aangezien sleutels worden opgeslagen als een byte-array, zullen ze allemaal hetzelfde beginnen en behoren tot regio #1 die dit bereik van sleutels opslaat. Er zijn verschillende partitioneringsstrategieën:
HexStringSplit – Zet de sleutel om in een string met hexadecimale codering in het bereik '00000000' => 'FFFFFFFF' en vult aan de linkerkant met nullen.
UniformSplit – Zet de sleutel om in een byte-array met hexadecimale codering in het bereik '00' => 'FF' en vult aan de rechterkant met nullen.
Bovendien kan een willekeurig bereik of een set sleutels voor splitsing worden opgegeven en kan automatische splitsing worden ingesteld. Een van de eenvoudigste en efficiëntste benaderingen is echter UniformSplit en het gebruik van hash-concatenering, bijvoorbeeld de hogere paar bytes van het doorgeven van de sleutel via de functie CRC32(rowkey) en de eigenlijke rowkey:
hash + rowkey
Dan worden alle gegevens gelijkmatig verdeeld over de regio's. Bij het lezen worden eenvoudig de eerste twee bytes weggegooid en blijft de oorspronkelijke sleutel over. Ook controleert RS het aantal gegevens en sleutels in de regio en splitst deze automatisch in delen zodra de limieten worden overschreden.
7. Fouttolerantie en lokale gegevens
Aangezien elke set van sleutels slechts door één regio wordt beheerd, is de oplossing voor problemen met RS-storingen of uitschakeling het opslaan van alle noodzakelijke gegevens in HDFS. Wanneer een RS uitvalt, detecteert de master dit door het ontbreken van heartbeat op de ZooKeeper-node. Dan wijst hij de beheerste regio toe aan een andere RS en omdat de HFiles in het gedistribueerde bestandssysteem worden opgeslagen, kan de nieuwe eigenaar deze uitlezen en de gegevens blijven bedienen. Echter, omdat een deel van de gegevens mogelijk in MemStore kan zitten en nog niet in HFiles is opgenomen, wordt voor het herstellen van de operationele geschiedenis WAL gebruikt, dat ook in HDFS wordt opgeslagen. Na het toepassen van de wijzigingen kan de RS reageren op verzoeken, maar de verhuizing leidt ertoe dat een deel van de gegevens en de processen die deze bedienen zich op verschillende nodes bevinden, wat de localiteit vermindert.
De oplossing voor dit probleem is major compaction – deze procedure verplaatst bestanden naar de nodes die ervoor verantwoordelijk zijn (waar hun regio's zich bevinden), waardoor de belasting op het netwerk en de schijven tijdens deze procedure sterk toeneemt. Echter, de toegang tot de gegevens wordt daarna aanzienlijk versneld. Daarnaast voert major_compaction het samenvoegen van alle HFiles tot één bestand binnen een regio uit, en maakt het gegevens vrij op basis van de tabelleninstellingen. Bijvoorbeeld, het aantal versies van een object dat moet worden behouden of de levensduur ervan, na dewelke het object fysiek wordt verwijderd, kan worden ingesteld.
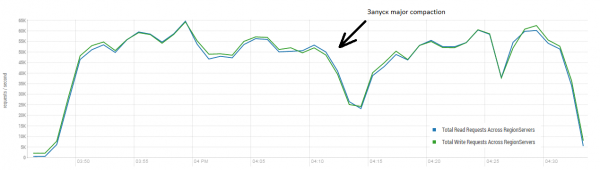
Deze procedure kan een zeer positieve invloed hebben op de werking van HBase. In de afbeelding hieronder is te zien hoe de prestaties zijn verslechterd door actieve gegevensschrijvingen. Hier is te zien hoe 40 streams naar één tabel schreven en 40 streams tegelijkertijd gegevens lazen. De schrijvende streams vormen steeds meer HFiles, die door andere streams worden ingelezen. Als gevolg hiervan moeten er steeds meer gegevens uit het geheugen worden verwijderd en uiteindelijk begint de GC, wat de gehele werking praktisch paralytisch maakt. Het starten van major compaction leidde tot het opruimen van de opgestapelde files en het herstellen van de prestaties.
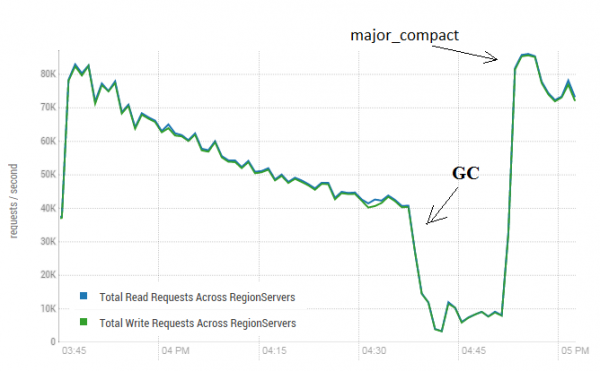
De test werd uitgevoerd op 3 DataNodes en 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 threads). Versie HBase 1.2.0-cdh5.14.2
Het is belangrijk op te merken dat de major compaction werd uitgevoerd op een 'live' tabel waarin actief gegevens werden geschreven en gelezen. Er werd in de gemeenschap beweerd dat dit kan leiden tot onjuiste antwoorden bij het lezen van gegevens. Om dit te verifiëren werd een proces opgestart dat nieuwe gegevens genereerde en deze in de tabel schreef. Daarna werd onmiddellijk gelezen en vergeleken of de verkregen waarde overeenkwam met hetgeen was geschreven. Tijdens het uitvoeren van dit proces werd major compaction ongeveer 200 keer uitgevoerd en er zijn geen storingen geregistreerd. Mogelijk manifesteert het probleem zich zelden en alleen tijdens hoge belasting, daarom is het verstandiger om de schrijf- en leesprocessen gepland te stoppen en de opruiming uit te voeren om dergelijke GC-dalingen te voorkomen.
Bovendien heeft major compaction geen invloed op de status van MemStore; om het op schijf te legen en te compactifiëren moet flush worden gebruikt (connection.getAdmin().flush(TableName.valueOf(tblName))).
8. Instellingen en prestaties
Zoals al eerder is vermeld, toont HBase het meeste succes waar het niets hoeft te doen, bij het uitvoeren van BulkLoad. Dit geldt echter voor de meeste systemen en mensen. Dit hulpmiddel is meer geschikt voor het massaal inleggen van gegevens in grote blokken, terwijl, als het proces veel concurrerende lees- en schrijfverzoeken vereist, de hierboven beschreven Get- en Put-opdrachten worden gebruikt. Om de optimale parameters te bepalen zijn er tests uitgevoerd met verschillende combinaties van tabelparameters en instellingen:
- Er werden 10 threads tegelijkertijd 3 keer achter elkaar gestart (we noemen dit een block van threads).
- De tijd die alle threads in het block werkten werd gemiddeld en was het eindresultaat van het block.
- Alle threads werkten met dezelfde tabel.
- Voor elke start van de thread-block werd een major compaction uitgevoerd.
- Elk block voerde slechts een van de volgende bewerkingen uit:
— Put
— Get
— Get+Put
- Elk block voerde 50.000 herhalingen van zijn operatie uit.
- De recordgrootte in het block was 100 bytes, 1000 bytes of 10.000 bytes (random).
- Blocks werden gestart met een verschillende hoeveelheid opgevraagde sleutels (of één sleutel of 10).
- Blocks werden gestart met verschillende tabelinstellingen. De parameters werden gewijzigd:
— BlockCache = in- of uitgeschakeld
— BlockSize = 65 Kb of 16 Kb
— Partities = 1, 5 of 30
— MSLAB = in- of uitgeschakeld
Dus ziet het block er als volgt uit:
a. De modus MSLAB werd in- of uitgeschakeld.
b. Er werd een tabel gemaakt waarvoor de volgende parameters werden ingesteld: BlockCache = true/none, BlockSize = 65/16 Kb, Partities = 1/5/30.
c. GZ-compressie werd ingesteld.
d. Er werden 10 threads gelanceerd die gelijktijdig 1/10 put/get/get+put operaties op deze tabel uitvoerden met records van 100/1000/10000 bytes, waarbij 50.000 verzoeken achter elkaar werden uitgevoerd (sloten waren willekeurig).
e. Punt d werd drie keer herhaald.
f. De rekentijd van alle threads werd gemiddeld.
Alle mogelijke combinaties werden gecontroleerd. Zoals te verwachten was, zou de snelheid afnemen bij een toename van de recordgrootte, of zou het uitschakelen van caching leiden tot vertraging. Het doel was echter om de mate en betekenis van de impact van elk parameter te begrijpen, daarom werden de verzamelde gegevens ingevoerd in de lineaire regressiefunctie, die de mogelijkheid biedt om de betrouwbaarheid te beoordelen met behulp van t-statistieken. Hieronder staan de resultaten van de blokken die put-operaties uitvoeren. De volledige set combinaties is 2*2*3*2*3 = 144 varianten + 72, omdat sommige twee keer zijn uitgevoerd. Dus in totaal 216 runs:
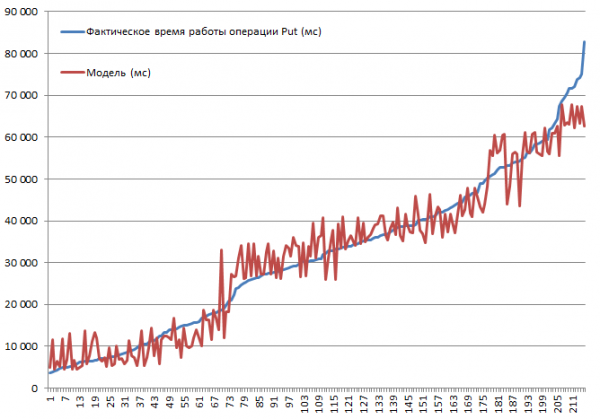
De testen werden uitgevoerd op een mini-cluster bestaande uit 3 DataNodes en 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 threads). Versie HBase 1.2.0-cdh5.14.2.
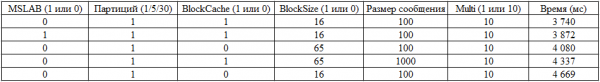
De hoogste invoersnelheid van 3,7 seconden werd behaald bij uitgeschakeld MSLAB-modus, op een tabel met één partition, met ingeschakelde BlockCache, BlockSize = 16, records van 100 bytes in batches van 10.
De laagste invoersnelheid van 82,8 seconden werd behaald bij ingeschakelde MSLAB-modus, op een tabel met één partition, met ingeschakelde BlockCache, BlockSize = 16, records van 10000 bytes per stuk.
Laten we nu naar het model kijken. We zien een goede kwaliteit van het model op basis van R2, maar het is volkomen duidelijk dat extrapolatie hier niet wordt aanbevolen. Het daadwerkelijke gedrag van het systeem bij parameterwijzigingen zal niet lineair zijn; dit model is niet bedoeld voor voorspellingen, maar om te begrijpen wat er binnen de aangegeven parameters is gebeurd. Bijvoorbeeld hier zien we op basis van de Student-criteria, dat de parameters BlockSize en BlockCache geen invloed hebben op de Put-operatie (wat in het algemeen vrij voorspelbaar is):
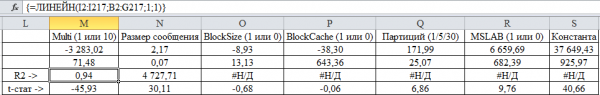
Het is verrassend dat het verhogen van het aantal partities leidt tot een verminderde prestaties (we hebben reeds de positieve invloed van het verhogen van het aantal partities bij BulkLoad gezien), hoewel het te verklaren is. Ten eerste moeten voor de verwerking aanvragen voor 30 regio's in plaats van één worden opgesteld, terwijl de hoeveelheid gegevens niet significant is om winst te behalen. Ten tweede wordt de totale werktijd bepaald door de traagste RS, aangezien het aantal DataNodes kleiner is dan het aantal RS, hebben sommige regio's een nul-lokaliteit. Laten we eens kijken naar de top vijf leiders:
Laten we nu de uitvoering van de Get-blokken evalueren:
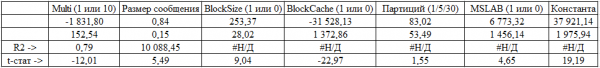
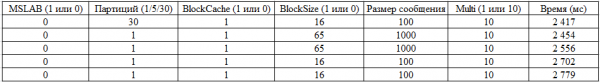
Het aantal partities heeft aan betekenis verloren, wat waarschijnlijk te verklaren is door het feit dat de gegevens goed worden gecached en de cache voor lezen de meest significante (statistisch) parameter is. Het is vanzelfsprekend dat een toename van het aantal berichten in de aanvraag ook zeer nuttig is voor de prestaties. De beste resultaten:
Laten we ten slotte kijken naar het model van de blok dat eerst get uitvoerde en daarna put:
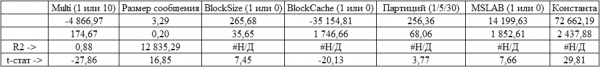
Hier zijn alle parameters significant. En de resultaten van de leiders:
9. Belastingtijd
Laten we tenslotte een min of meer behoorlijke belasting uitvoeren, maar het is altijd interessanter wanneer er iets is om mee te vergelijken. Op de website van DataStax - de belangrijkste ontwikkelaar van Cassandra - zijn er NT van verschillende NoSQL-opslagplaatsen, waaronder HBase versie 0.98.6-1. De lading werd uitgevoerd met 40 threads, gegevensgrootte 100 bytes, SSD-schijven. Het resultaat van het testproces van de Read-Modify-Write-operaties toonde dergelijke resultaten.
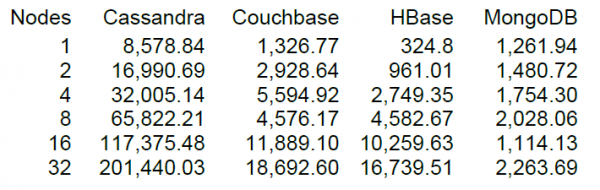
Voor zover ik begrijp, was het lezen in blokken van 100 records en voor 16 nodes toonde de DataStax-test van HBase een prestatie van 10.000 bewerkingen per seconde.
Het is gelukkig dat ons cluster ook 16 nodes heeft, maar niet zo 'gelukkig' dat elke node 64 cores (threads) heeft, terwijl er in de DataStax-test slechts 4 zijn. Aan de andere kant hebben zij SSD-schijven, terwijl wij HDD hebben, en we hebben een nieuwere versie van HBase, en de CPU-utilisatie tijdens belasting steeg praktisch niet significant (visueel met 5-10 procent). Desondanks proberen we deze configuratie te starten. De standaard tabelinstellingen, lezen gebeurt in het bereik van sleutels van 0 tot 50 miljoen willekeurig (dat wil zeggen, in feite elke keer nieuw). De tabel bevat 50 miljoen records, verdeeld over 64 partities. De sleutels zijn gehasht met crc32. De tabelinstellingen zijn standaard, MSLAB is ingeschakeld. We starten 40 threads, elke thread leest een set van 100 willekeurige sleutels en schrijft onmiddellijk 100 gegenereerde bytes terug naar die sleutels.
Stand: 16 DataNodes en 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 threads). Versie HBase 1.2.0-cdh5.14.2.
Het gemiddelde resultaat ligt dichterbij de 40 duizend bewerkingen per seconde, wat aanzienlijk beter is dan in de DataStax-test. Echter, voor experimentele doeleinden kunnen we de voorwaarden iets aanpassen. Het is vrij onwaarschijnlijk dat al het werk uitsluitend op één tabel zal plaatsvinden, en ook alleen met unieke sleutels. Laten we aannemen dat er een bepaalde 'hete' set sleutels is die de meeste belasting genereert. Daarom proberen we grotere records (10 KB) te creëren, ook in batches van 100, in 4 verschillende tabellen, en beperken we het bereik van gevraagde sleutels tot 50 duizend. In de onderstaande grafiek wordt de uitvoering weergegeven van 40 threads, elke thread leest een set van 100 sleutels en schrijft onmiddellijk willekeurige 10 KB terug naar die sleutels.
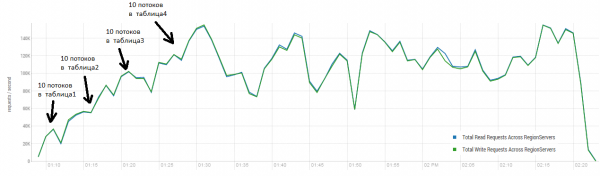
Stand: 16 DataNodes en 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 threads). Versie HBase 1.2.0-cdh5.14.2.
Tijdens de belasting werd verschillende keren major compaction uitgevoerd, zoals hierboven getoond; zonder deze procedure zal de prestatie geleidelijk afnemen, maar tijdens de uitvoering ontstaat ook extra belasting. Het verminderen van prestaties wordt door verschillende redenen veroorzaakt. Soms beëindigden threads hun werk en terwijl ze opnieuw opstartten, ontstond er een pauze; soms creëerden externe applicaties belasting op het cluster.
Lezen en meteen schrijven is een van de meest uitdagende werkscenario's voor HBase. Als je alleen kleine put-aanvragen doet, bijvoorbeeld van 100 bytes, en deze bundelt in pakketten van 10.000 tot 50.000 stuks, kun je honderdduizenden operaties per seconde behalen, en hetzelfde geldt voor aanvragen die alleen lezen. Het is vermeldenswaard dat de resultaten radicaal beter zijn dan die van DataStax, vooral dankzij blokaanvragen van 50.000.
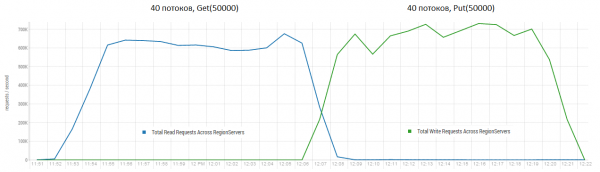
Stand: 16 DataNodes en 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 threads). Versie HBase 1.2.0-cdh5.14.2.
10. Conclusies
Dit systeem is vrij flexibel aan te passen, maar de invloed van een groot aantal parameters blijft nog steeds onbekend. Een deel daarvan is getest, maar is niet opgenomen in de resulterende testset. Bijvoorbeeld, voorlopige experimenten toonden een geringe significantie aan van de parameter DATA_BLOCK_ENCODING, die informatie codeert met waarden uit aangrenzende cellen, wat heel begrijpelijk is voor willekeurig gegenereerde gegevens. In het geval van een groot aantal herhaalde objecten kan de winst aanzienlijk zijn. Over het algemeen kan worden gezegd dat HBase indruk maakt als een serieuze en doordachte database die bij operaties met grote datablocks behoorlijk efficiënt kan zijn. Vooral als er de mogelijkheid is om lees- en schrijfprocessen over tijd te spreiden.
Als iets naar jouw mening niet voldoende is toegelicht, ben ik bereid om meer details te geven. We moedigen je aan om je ervaringen te delen of een discussie te voeren als je het ergens niet mee eens bent.
Bron: habr.com
